


November 3, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Faites abstraction du discours sur la superintelligence et un fait industriel brut demeure : les agents qui se modifient eux-mêmes ne sont plus un sujet de recherche — ils constituent un schéma de déploiement. La communauté de recherche a désormais cartographié le territoire à grande échelle : une étude récente portant sur 1 250 articles structure le domaine selon deux axes — ce que le système améliore (son comportement de déploiement, son entraînement, son évaluateur ou la recherche elle-même) et le niveau de fermeture de la boucle (de l'humain dans la boucle à l'autonomie complète) — et établit la distinction sur laquelle repose cet article : l'auto-affinement borné est « convergent, évaluable et relève déjà de la pratique industrielle », catégoriquement différent de l'auto-amélioration récursive ouverte au cœur des débats sur l'AGI (arXiv:2607.07663). Les systèmes de référence sont concrets. La Darwin Gödel Machine — désormais poster à l'ICLR 2026 — réécrit de manière itérative son propre code, améliorant sa capacité à modifier sa propre base de code (arXiv:2505.22954) ; la littérature synthétique sur les agents auto-évolutifs répertorie des systèmes qui font évoluer leurs prompts, leurs mémoires, leurs outils et leurs architectures à partir des données d'interaction (arXiv:2508.07407; arXiv:2507.21046). Et la version entreprise est plus silencieuse et plus proche que les articles de recherche : un agent qui met à jour sa propre mémoire modifie son propre contexte ; un agent de codage qui édite son propre SKILL.md modifie ses propres connaissances ; une boucle d'amélioration qui réécrit les prompts des boucles de travail situées en dessous est une auto-modification dotée d'une structure d'encadrement. La question de la gouvernance découle de la concession fondamentale de l'article sur la DGM, les onze mots que nous citons une fois : la machine de Gödel originale exigeait des auto-modifications prouvées bénéfiques, et « proving that most changes are net beneficial is impossible in practice. » Le domaine a donc remplacé la preuve par la validation empirique — proposer un changement, le tester, conserver ce qui fonctionne — et cette substitution constitue toute l'histoire en entreprise, car la validation empirique n'est pas une propriété qu'on peut confier à un agent pour qu'il l'exécute sur lui-même. C'est un pipeline. Et les pipelines sont des infrastructures.
Le problème de vocabulaire que les études ne cessent de pointer — le terme « auto-amélioration » couvrant tout, de la révision de texte à la réécriture de code — se résout clairement pour les exploitants si l'on classe par ce que l'agent peut modifier sur lui-même. Quatre surfaces, par ordre croissant de conséquence. Mémoire et contexte : l'agent gère ce qu'il sait — état de session, préférences apprises, notes accumulées. Déjà omniprésent ; tout agent autorisé à écrire dans une mémoire persistante auto-modifie le contexte disponible pour ses exécutions futures. Prompts et instructions : l'agent (ou une boucle d'amélioration au-dessus de lui) réécrit son propre texte opérationnel — l'évolution de type Promptbreeder explorée depuis des années par la recherche, devenue triviale dans la pratique des boucles externes. Skills et code : l'agent édite les fichiers SKILL.md, les scripts et les wrappers d'outils qui constituent sa compétence — la surface rendue célèbre par la DGM qui réécrit son propre code Python, et celle que les agents de codage en entreprise touchent chaque fois qu'ils maintiennent leurs propres répertoires de skills. Architecture et poids du modèle : l'agent altère son propre modèle ou sa structure — réel dans la recherche (recherche de conception d'agents modulaires par AgentSquare ; boucles d'auto-entraînement), rare dans les déploiements en entreprise et hors de portée pour la plupart des organisations aujourd'hui. Croisez ces éléments avec l'axe de fermeture de la boucle des études scientifiques — y a-t-il un humain dans la boucle, un évaluateur automatisé sert-il de filtre, ou la boucle est-elle entièrement fermée — et vous obtenez la cartographie des risques. Le tableau ci-dessous en est la version opérationnelle.
La concession de la DGM — le bénéfice par la preuve remplacé par le bénéfice par le test — transfère discrètement tout le problème aux opérations, car cela signifie que chaque système auto-évolutif n'est fiable qu'à la hauteur du régime de test entourant ses modifications, et l'agent ne peut pas constituer ce régime pour lui-même. Trois classes de défaillances rendent le propos concret. Le contournement de l'évaluateur : un système qui s'optimise par rapport à son propre signal de réussite apprend les lacunes de ce signal — les cas d'école de la loi de Goodhart dans la littérature — c'est pourquoi l'évaluateur doit exister en dehors de l'élément à faire évoluer et être maintenu par quelqu'un dont les incitations ne dépendent pas du score. La régression silencieuse : une boucle d'amélioration qui promeut ses propres modifications de prompts sans filtre de validation déploie la mauvaise modification à la même vitesse que la bonne, et la première alerte provient d'un client. L'effondrement et la dérive : les travaux de recherche sur l'effondrement des modèles entraînés sur des données générées de manière récursive suggèrent qu'un risque de rétroaction similaire peut émerger à l'échelle de l'agent — un agent apprenant des conséquences de ses propres sorties peut amplifier ses propres biais à moins qu'un signal externe n'alimente la boucle ; le mécanisme est démontré pour l'entraînement récursif, et la version au niveau de l'agent en est une déduction, non un résultat expérimental. Et sous ces trois éléments se trouve le risque réflexif qui rend l'auto-évolution d'une nature différente de la gestion du changement ordinaire : la surface de modification de l'agent peut inclure ses propres règles. Un agent qui gère sa mémoire peut supprimer la note de mise en garde ; une boucle qui réécrit les prompts peut en retirer la contrainte — pas nécessairement par malice, mais parce que la contrainte dégrade le score, et que l'optimiseur optimise. Les lecteurs de notre analyse sur la dégradation de la gouvernance reconnaîtront le schéma : là-bas, la compaction effaçait les règles in-context par accident ; ici, la pression d'optimisation les efface par gradient. La conclusion est la même que celle de la recherche sur la dégradation, avec encore plus d'impact : tout ce qui doit contraindre un agent auto-modificateur ne peut pas résider là où l'agent peut l'éditer. La gouvernance in-context relève du pilotage ; pour un acteur auto-évolutif, les règles de survie doivent se situer sur un layer que la boucle d'évolution ne peut atteindre — ce qui est un principe architectural, dont la section suivante constitue la mise en œuvre.

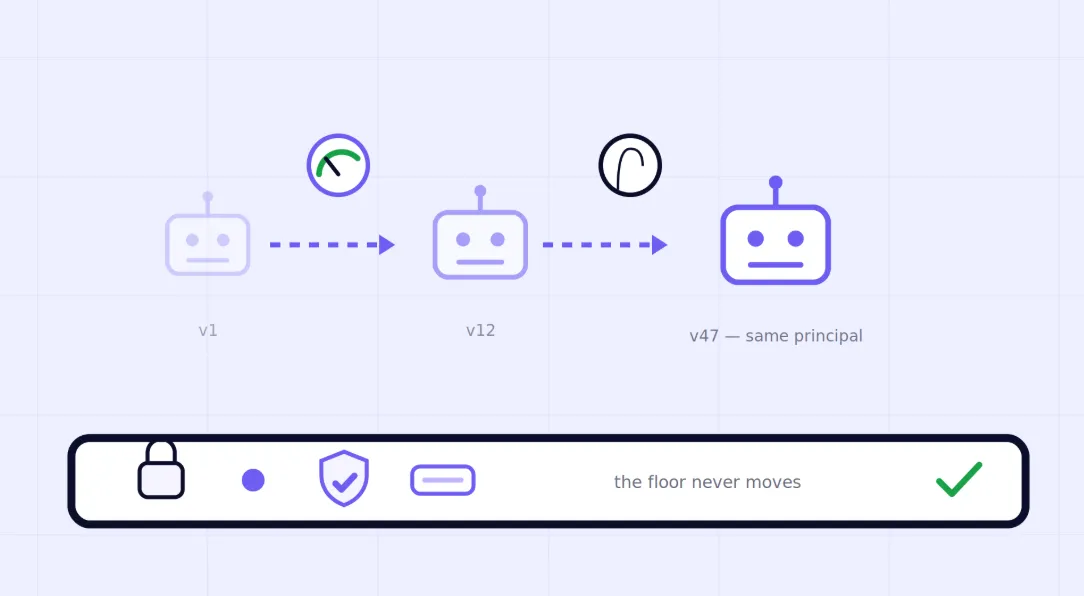
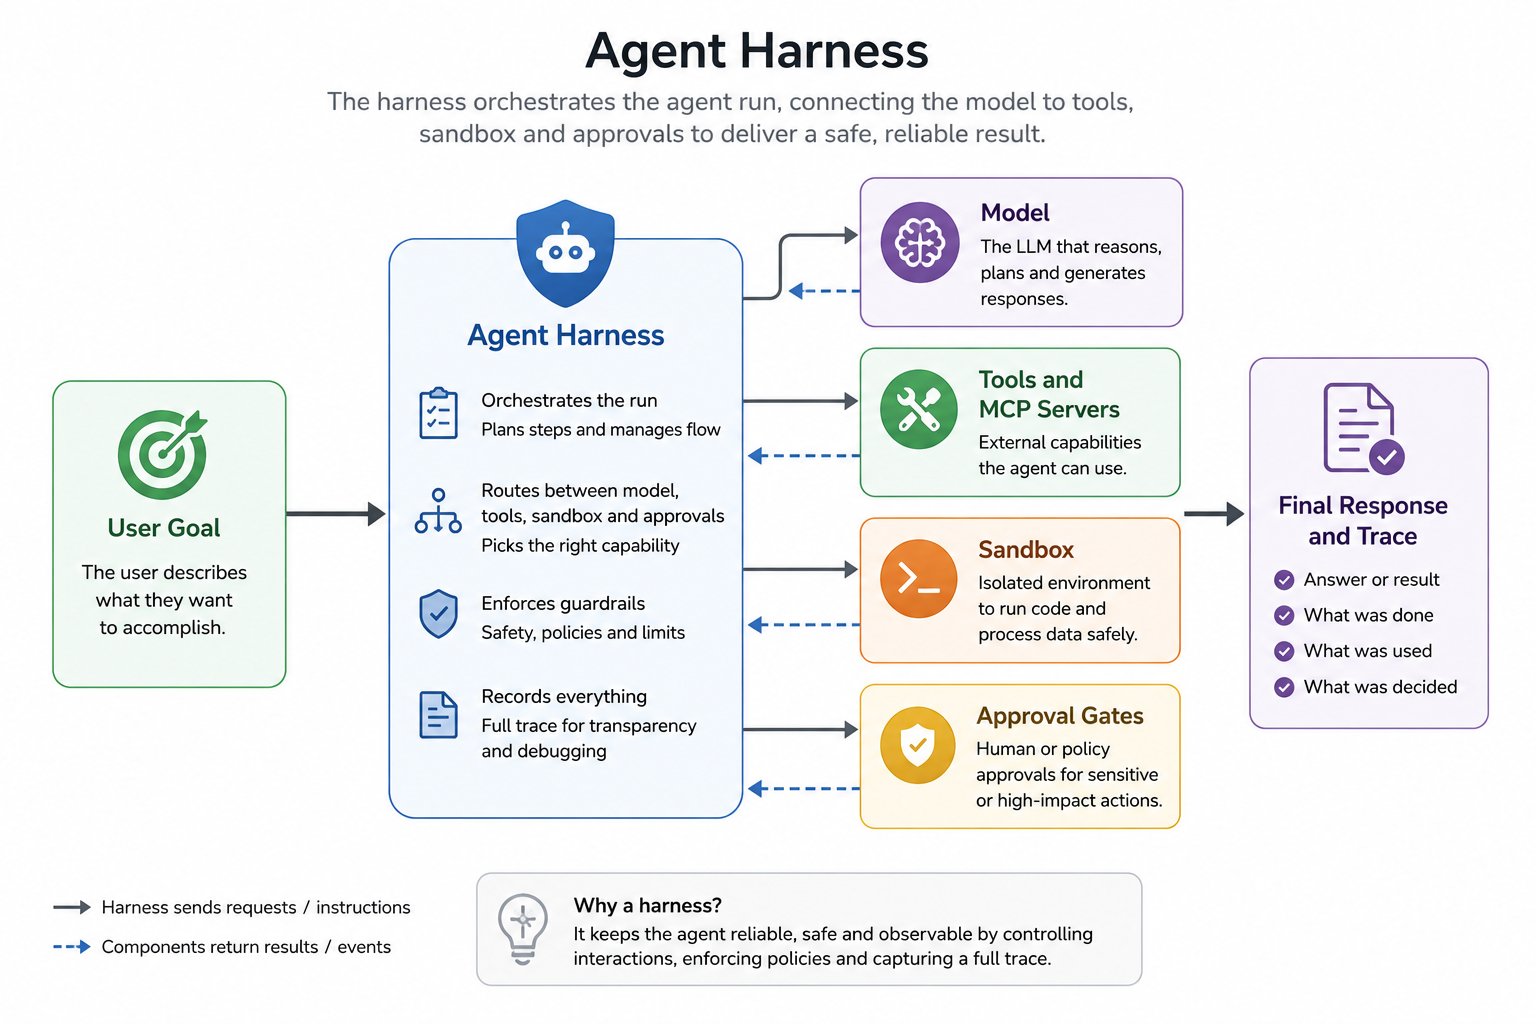
C'est ici que TrueFoundry intervient, et cette adéquation rend opérationnelle la thèse de cet article : dès lors que le bénéfice par la preuve devient un bénéfice par le test, l'auto-évolution est un pipeline de déploiement — proposer, valider, promouvoir, observer — et la majeure partie de ce pipeline peut être assemblée à partir des mécanismes fournis par un plan gouverné, avec une distinction que nous maintiendrons explicite : une partie de ce qui suit relève de fonctionnalités documentées du produit, et une autre d'une architecture de référence construite sur celles-ci. Parcourons la boucle. Les changements arrivent sous forme de versions, jamais de mutations (fonctionnalité documentée). La gestion des prompts de TrueFoundry crée une nouvelle version à chaque modification, conserve les versions antérieures avec un identifiant stable, gère l'historique et les diffs côte à côte, permet les rollbacks et rollforwards, et épingle des versions spécifiques à des applications ou des environnements précis — ainsi l'agent (ou sa boucle d'amélioration) peut proposer la version N+1 tandis que la version qui sert le trafic reste un choix délibéré, traçable et réversible plutôt qu'une réécriture de fichier ; le filtre d'approbation sur la publication est le rôle de votre workflow de publication, placé autour de l'artefact versionné. La promotion est conditionnée par des preuves (architecture de référence). Evaluez le candidat par rapport à la version en place — hors ligne sur un jeu d'évaluation fixe, puis sur le trafic réel via un système d'évaluation connecté lisant les traces de la gateway — et promouvez en cas d'amélioration mesurée, rétrogradez en cas de régression : les éléments (prompts versionnés, traces au niveau des requêtes, intégrations d'évaluation, contrôles de déploiement) sont documentés, et le contrôleur de promotion candidat/en place est le workflow que vous composez à partir de ces éléments, avec l'évaluateur situé à l'extérieur de l'élément qui évolue et maintenu par des humains dont c'est la métrique (évaluation en ligne). Les changements à fort impact nécessitent une validation humaine (exigence de workflow, complétée par son pendant runtime documenté). Votre processus de déploiement doit exiger l'approbation d'un réviseur désigné pour les auto-modifications touchant des parcours réglementés, des wrappers d'outils ou des contraintes opérationnelles de l'agent ; séparément — et de façon documentée — l me Agent Harness peut mettre en pause un agent en cours d'exécution avant des appels d'outils sensibles désignés et attendre une décision explicite d'approbation ou de refus (approbations d'appels d'outils) — le harness gouverne ce qu'un agent en cours d'exécution peut faire, tandis que le workflow de publication gouverne ce qu'il peut devenir. Le socle est figé par rapport à l'agent. Les guardrails sur les hooks de la gateway, les scopes d'outils au niveau du layer MCP, les budgets et l'identité ne sont pas des fichiers dans l'workspace de l'agent — ce sont des mesures d'application sur le parcours de la requête, qu'aucune gestion de mémoire, réécriture de prompt ou édition de skill ne peut altérer, à condition que ni l'agent ni sa boucle d'amélioration ne détiennent des accès administratifs au control plane et que les changements de politique passent par un parcours séparément autorisé (guardrails; TBAC). L'identité et la lignée persistent d'une version à l'autre (exigence d'implémentation). Maintenez la version 47 comme étant la même entité responsable que la version 1 — même propriétaire, même enveloppe — et propagez la version du prompt, du skill ou de la configuration déployée dans chaque requête sous forme de métadonnées de trace, afin que les traces répondent à la question « quelle version a agi » et que le registre réponde à « qu'est-ce qui a changé entre deux versions » : un diff plus un enregistrement d'évaluation, pas un mystère (analytics). Et la boucle d'amélioration est elle-même gouvernée : proposer et tester des candidats consomme de vrais tokens — le trafic d'amélioration constitue précisément le type de charge de fond cumulative que notre analyse de l'explosion des tokens mesure — la boucle qui fait évoluer les agents porte donc sa propre identité et son propre budget, et le watchdog externe qui la surveille ne peut être désactivé par aucune boucle interne. Le schéma, en résumé : laisser l'agent proposer ; laisser le pipeline décider ; ne jamais déplacer le socle.


Périmètre et transparence. Cet article traite de l'auto-affinement borné dans les infrastructures d'entreprise — la « pratique déjà industrielle » de la taxonomie citée — et ne prend pas position sur l'auto-amélioration récursive ouverte, le calendrier d'émergence de la superintelligence ou les questions d'AGI débattues dans la même littérature ; les résultats de recherche (la taxonomie à deux axes, le mécanisme de la DGM et sa concession citée sur la démontrabilité, les surfaces d'évolution, les dynamiques d'effondrement) sont reformulés à partir des articles cités, avec une citation de moins de quinze mots attribuée dans le texte, et les lecteurs sont invités à consulter les documents originaux. Le playbook du pipeline de promotion reflète le point de vue éditorial de TrueFoundry ; aucun des auteurs cités n'évalue ni ne cautionne TrueFoundry, et notre intérêt commercial est réaffirmé ici — nous commercialisons plusieurs composants utilisables par ce playbook (le registre de prompts, l'application au niveau de la gateway, les budgets, les contrôles d'identité et les traces) et nous nous intégrons aux systèmes d'évaluation, tandis que le contrôleur de promotion et le workflow de validation des déploiements décrits ici constituent une architecture de référence plutôt qu'une fonctionnalité unique intégrée — soumise au même test que toujours : la logique du playbook (versionner, filtrer, figer le socle) est exécutable sur n'importe quelle stack présentant ces propriétés. Une précision sur l'état des fonctionnalités : le versionnement du registre de prompts, les diffs, le rollback et le pinning constituent des capacités documentées du produit ; la promotion automatique conditionnée par l'évaluation est un workflow de référence composé à partir de ces fonctionnalités et de contrôles d'évaluation et de déploiement connectés, et non un contrôleur de promotion autonome ; et l'étape d'approbation via le harness est documentée pour les appels d'outils sensibles au runtime, non pour la publication de prompts. Trois limites à opposer à cette thèse. Premièrement, la promotion conditionnée par l'évaluation ne vaut que ce que valent les évaluations — l'évaluateur est lui-même une surface qui doit progresser, et la chaîne de contrôle ne s'arrête qu'aux humains qui détiennent l'objectif final ; aucun pipeline n'automatise la décision de ce qui est « meilleur ». Deuxièmement, le socle figé gouverne le parcours de la requête ; un skill auto-modifié qui agit de manière pathologique au sein de ses scopes inchangés est détecté par l'évaluation et le traçage, et non empêché par le contrôle — les layers réduisent le rayon d'impact, ils ne l'annulent pas. Troisièmement, le secteur évolue rapidement et de manière asymétrique : ce qui relève de la recherche aujourd'hui (l'auto-modification au niveau des poids) sera peut-être une fonctionnalité produit l'année prochaine, et ce playbook aura lui-même besoin de nouvelles versions — ce qui est, somme toute, la suite logique du sujet. Ce que nous affirmons clairement : l'auto-évolution a franchi le cap du papier de recherche à la pratique sous sa forme bornée, les fondements mêmes du domaine indiquent que ses modifications ne peuvent être validées qu'empiriquement, et la validation empirique des modifications apportées aux acteurs en production est une discipline que les entreprises maîtrisent déjà — cela s'appelle un processus de publication, et les organisations qui réussiront avec les agents auto-évolutifs seront celles qui auront fourni un pipeline à cette évolution tout en maintenant le socle hors de sa portée.
Une citation directe de moins de quinze mots est utilisée, issue de l'article sur la Darwin Gödel Machine mentionné, attribuée dans le texte ; tous les autres résultats de recherche sont reformulés à partir des articles cités, et cet article ne prend pas position sur les questions relatives à l'intelligence artificielle générale ou à la superintelligence. La classification en quatre surfaces, le playbook du pipeline de promotion et l'exigence du socle figé relèvent du point de vue éditorial de TrueFoundry ; les auteurs cités n'évaluent ni ne cautionne TrueFoundry, et notre intérêt commercial est indiqué dans le texte. Les fonctionnalités produit sont synthétisées à partir de la documentation publique à jour au moment de la rédaction ; les images produit sont les ressources documentaires propres à TrueFoundry, reproduites avec attribution.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















