


août 31, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
À mesure que les entreprises développent leurs applications d'AI, savoir ce que font vos modèles en production est tout aussi important que de les mettre en service. Les ingénieurs ont besoin d'une visibilité sur chaque requête d'inférence latence, utilisation des tokens, comportement du modèle, raison de fin mais connecter des outils d'observabilité à chaque modèle et fournisseur implique un travail d'instrumentation complexe et répétitif pour chaque intégration.
La grande question : comment obtenir une visibilité full-stack sur l'ensemble des modèles utilisés par vos équipes sans ingénierie sur mesure pour chacun d'eux ?
Chez Middleware, l'objectif est de rendre l'observabilité aussi simple que puissante. C'est pourquoi nous sommes ravis d'annoncer l'intégration de Middleware avec le TrueFoundry AI Gateway. Cette intégration offre à votre organisation une visibilité complète sur chaque requête d'inférence d'AI corrélée avec les métriques d'infrastructure, les traces d'application et les logs le tout depuis une plateforme unique et centralisée, permettant de garantir que vos opérations d'AI sont transparentes et sous contrôle.
Le TrueFoundry AI Gateway est un moyen puissant pour les développeurs et les équipes plateforme de gérer, surveiller et faire évoluer leurs applications d'AI. Il rassemble un accès unifié à des centaines de grands modèles de langage, un routage intelligent et l'application centralisée des règles au même endroit. Un seul pod de gateway gère plus de 250 requêtes par seconde tout en n'ajoutant qu'environ 3 ms de latence, ce qui le rend prêt pour la production dès le premier jour.
Alors que l'adoption de l'AI s'accélère, le véritable défi n'est pas d'accéder aux modèles c'est de gérer la complexité qui en découle. Les multiples fournisseurs, les API en constante évolution et les exigences de conformité strictes peuvent rapidement ralentir les équipes. Le TrueFoundry AI Gateway apporte de l'ordre dans cette complexité, servant de plan de contrôle pour l'AI d'entreprise. Il unifie l'accès, applique les règles et offre une observabilité conforme à OpenTelemetry sur chaque modèle et environnement sans nécessiter aucune modification des applications qui appellent le gateway.
Middleware est une plateforme d'observabilité full-stack basée sur OpenTelemetry comme standard d'instrumentation central. Elle accepte les traces, les logs, les métriques d'infrastructure et les données de suivi des utilisateurs réels via OTEL Collector, en les stockant dans une couche de données corrélées unique qui donne aux équipes d'ingénierie une vue complète de leurs systèmes en un seul endroit.
Ce qui distingue Middleware, c'est ce qu'il fait après l'arrivée d'une trace. Plutôt que de stocker les spans de manière isolée, Middleware les corrèle avec les signaux d'infrastructure de l'hôte ou du cluster où le service s'exécute. Un ingénieur recherchant un pic de latence dans un span de gateway peut naviguer directement de la vue de trace vers les métriques CPU et mémoire de ce pod sans changer de tableau de bord. Middleware construit également une carte de topologie de service en direct à partir des données de span entrantes, rendant chaque service instrumenté visible en tant que nœud dans la carte de service, avec la latence et le taux d'erreur calculés automatiquement à partir de ses spans.
L'intégration de Middleware et du TrueFoundry AI Gateway simplifie et renforce votre observabilité de l'AI. Cette combinaison facilite l'intégration directe d'une visibilité de niveau production dans votre workflow d'AI, garantissant que vos systèmes sont observables dès le moment du déploiement.
Avec cette solution intégrée, chaque requête d'inférence qui passe par le TrueFoundry AI Gateway génère automatiquement un ensemble structuré de spans OpenTelemetry. Ces spans transportent le contenu du prompt, le contenu de complétion, le nombre de tokens, le nom du modèle, la latence et la raison de fin en tant qu'attributs interrogables puis circulent de manière asynchrone vers Middleware via OTLP/HTTP. Middleware les ingère aux côtés du reste de la télémétrie de votre infrastructure, rendant le trafic du gateway immédiatement visible en tant que service de premier ordre dans la carte de topologie et les vues APM aux côtés des services applicatifs qui l'appellent.
Pour un contrôle total sur les données sensibles, l'option Exclude Request Data du gateway TrueFoundry supprime le contenu du prompt et de la complétion des attributs de span avant l'exportation. Le nombre de tokens, la latence et les métadonnées du modèle sont conservés dans tous les cas, ce qui vous permet de maintenir une visibilité opérationnelle complète sans exposer les entrées des utilisateurs à des systèmes externes. Pour les organisations ayant des exigences strictes en matière d'égress réseau, l'exportateur du gateway peut également être orienté vers un OpenTelemetry Collector géré en propre qui transfère vers Middleware ne nécessitant aucune autre modification que l'URL de l'endpoint.
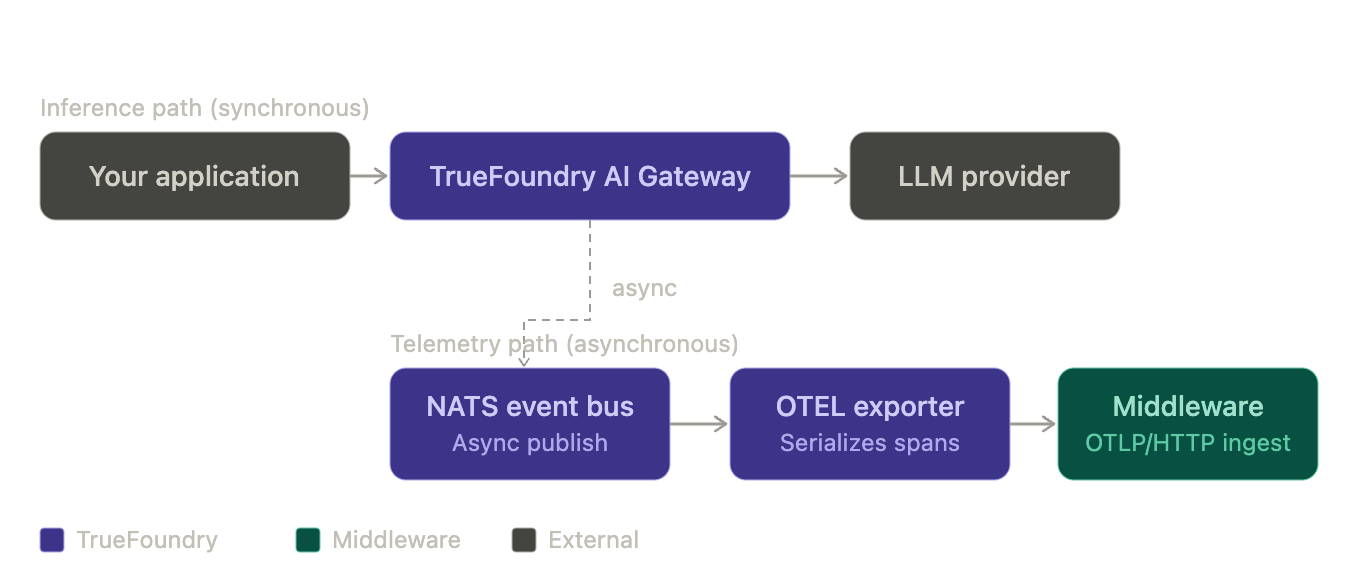
Intégration de Middleware et du TrueFoundry AI Gateway
Middleware et le TrueFoundry AI Gateway travaillent ensemble pour offrir de l'observabilité sans ajouter de complexité à votre parcours d'inférence.
La configuration est tout aussi simple. Naviguez vers AI Engineering → Settings → OTEL Config dans le tableau de bord TrueFoundry, saisissez l'endpoint de votre tenant Middleware et votre clé API, définissez le protocole sur HTTP avec codage protobuf, et vous êtes prêt à démarrer.
L'observabilité de l'AI n'a pas besoin de signifier un travail d'instrumentation complexe. Avec Middleware intégré dans le TrueFoundry AI Gateway, l'ensemble de votre trafic d'inférence devient visible corrélé avec les signaux d'infrastructure, filtrable par nom de modèle ou nombre de tokens, et cartographié dans une topologie de service en direct dès que la configuration est enregistrée. C'est une observabilité complète et de niveau production facile à configurer, s'apparentant davantage à l'activation un interrupteur qu'à un projet d'ingénierie sur mesure.
Pour en savoir plus, visitez la documentation de Middleware et la référence d'intégration TrueFoundry pour voir à quel point il est simple d'obtenir une visibilité full-stack sur vos applications d'AI.
Prêt à commencer ? Connectez votre gateway TrueFoundry à Middleware dès aujourd'hui et transformez chaque requête d'inférence en un événement d'observabilité structuré et interrogable.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





















