



November 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Une présentation détaillée de l'architecture d'authentification au cœur de la TrueFoundry MCP Gateway — trois plans, deux flux OAuth, un coffre-fort d'identifiants — racontée du point de vue d'un client la déployant en production.
Un lundi matin chez Northwind. À 8 h 47 un lundi matin, l'ingénieur d'astreinte chez Northwind Logistics — une plateforme de chaîne d'approvisionnement de 50 ingénieurs, fictive mais malheureusement très plausible — reçoit une notification Slack. Leur assistant IA interne, Cargo Copilot, renvoie des erreurs 401 pour chaque appel d'outil vers Jira et GitHub. La cause racine est l'ordinateur portable d'un développeur, perdu à l'aéroport au cours du week-end. Le service informatique a révoqué la session SSO de l'ordinateur portable. Mais cet ordinateur portable contenait également des jetons OAuth pour GitHub, Slack, Jira et un service d'analyse interne, chacun copié dans les paramètres de l'éditeur du développeur et dans ses fichiers de configuration (dotfiles). L'équipe de sécurité ne peut pas affirmer avec certitude quels périmètres (scopes) ont été exposés, sur quelles autres machines ces jetons ont également été dupliqués (car les développeurs s'entraident), ni comment tous les révoquer sans perturber le travail de chacun dès le matin.
L'incident de Northwind n'a rien d'exotique. C'est à cela que ressemble la gestion des identifiants dans la plupart des entreprises six mois après une adoption enthousiaste de MCP. La suite de cet article est l'histoire architecturale de la manière dont Northwind — et d'autres clients de TrueFoundry — évitent de reproduire cet incident.
Northwind compte environ cinquante ingénieurs utilisant activement des IDE compatibles MCP connectés à huit serveurs — GitHub, Slack, Google Workspace, Jira, un service d'analyse interne, une API Logistics interne, Zendesk et un service propriétaire de planification d'itinéraires. Cela représente quatre cents connexions actives selon un calcul arithmétique simple, et en pratique nettement plus d'emplacements d'identifiants si l'on compte les entrées du trousseau d'accès, les paramètres de l'éditeur, les fichiers d'environnement du shell, les variables de CI et les copies faites lors de l'intégration d'un coéquipier.
Le rayon d'impact d'un poste de travail compromis ne se limite pas à un seul jeton. C'est un jeton multiplié par les périmètres (scopes) associés à ce fournisseur, la durée de vie du jeton (souvent 90 jours ou plus pour les jetons d'accès personnels), le nombre de machines qui l'ont dupliqué et l'absence de révocation centralisée. Si un jeton OAuth Slack permet la lecture de l'historique des canaux et qu'un jeton GitHub situé au même endroit permet la lecture des dépôts, une simple exfiltration se transforme en incident multi-systèmes avant même que l'équipe de sécurité n'ait la possibilité d'intervenir. Les identifiants MCP locaux sont également inopérants sur le plan opérationnel : aucune piste d'audit unifiée, aucune rotation imposée, aucune vérification de politique avant l'exécution d'un outil, aucun moyen rapide de savoir qui peut appeler quoi.
Le modèle de passerelle (gateway pattern) comble cette lacune. Les développeurs s'authentifient une seule fois auprès de la passerelle, et la passerelle gère l'authentification en aval selon le modèle configuré pour chaque serveur — ce qui correspond exactement à la conception décrite dans la présentation de la TrueFoundry MCP Gateway et dans la documentation sur l'authentification et la sécurité. L'avantage ne réside pas seulement dans la consolidation. Il réside dans le fait que l'authentification devient une propriété de l'infrastructure plutôt qu'une propriété de chaque ordinateur portable de l'entreprise.
La première décision de conception consiste à séparer trois plans que les configurations locales de développeurs confondent systématiquement. La documentation sur l'authentification et la sécurité de TrueFoundry décrit cela comme un système en trois parties : l'authentification entrante, le contrôle d'accès et l'authentification sortante. La documentation indique explicitement que les couches entrantes et sortantes sont indépendantes, ce qui constitue l'avancée architecturale majeure.
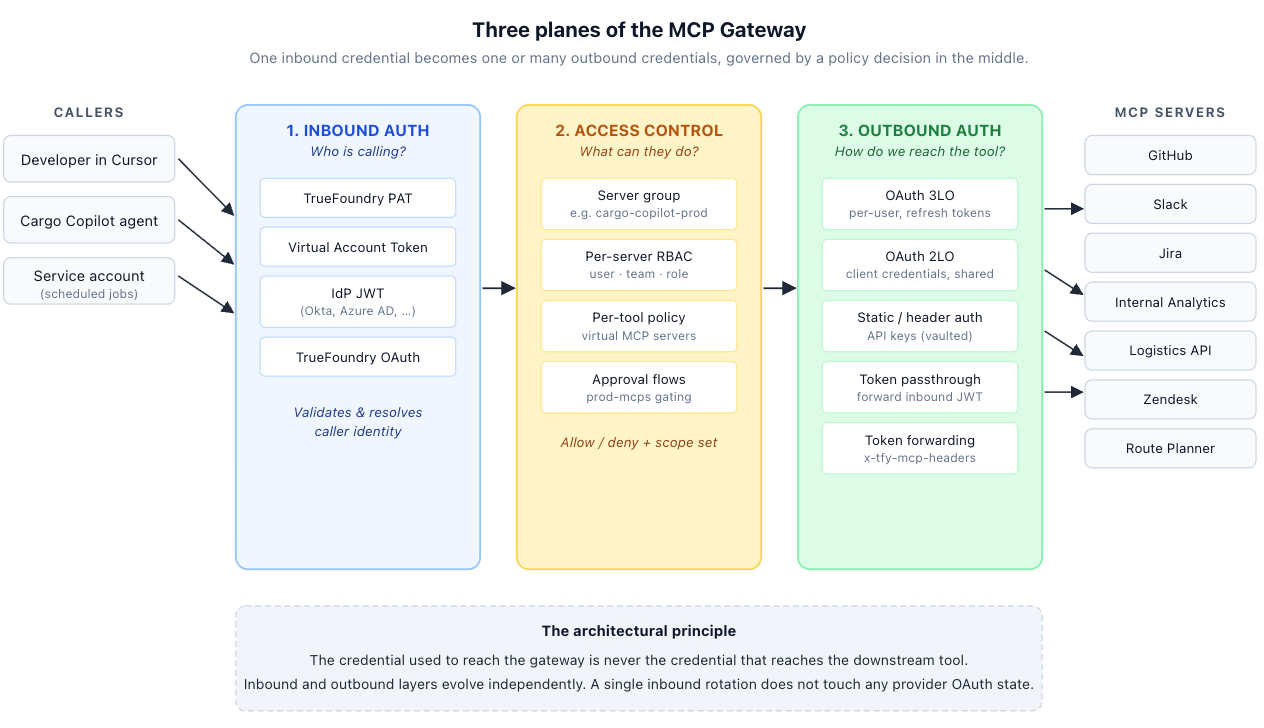
Le principe de conception est simple : l'identifiant utilisé pour atteindre la passerelle n'est jamais l'identifiant qui atteint l'outil en aval. La rotation entrante n'impacte aucun état OAuth du fournisseur. Un serveur MCP GitHub peut utiliser un OAuth par utilisateur tandis que le service d'analyse interne utilise Client Credentials — au sein du même agent, dans le même flux de requêtes. La passerelle est à la fois le point d'application des politiques et le courtier d'identifiants.
Dans le jargon d'entreprise, 2LO et 3LO font référence à deux types d'octroi issus de la norme RFC 6749 (OAuth 2.0), appliqués à la manière dont les utilisateurs finaux interviennent.
Le OAuth à deux jambes (2LO) utilise l'octroi Client Credentials. La passerelle détient un client_id et un client_secret, envoie une requête grant_type=client_credentials au point de terminaison de jetons du fournisseur, reçoit un access_token à courte durée de vie et utilise ce jeton sur chaque requête vers le serveur MCP. Aucun navigateur, aucune autorisation utilisateur. C'est le choix idéal pour les intégrations de serveur à serveur : API d'analyse internes, microservices backend, services de données internes.
Le OAuth à trois jambes (3LO) utilise l'octroi Authorization Code. Chaque utilisateur final est redirigé vers le fournisseur (GitHub, Slack, Google) pour autoriser l'accès à ses ressources spécifiques. La passerelle stocke un refresh_token par utilisateur, maintient une correspondance chiffrée de user_id → {access_token, expires_at, refresh_token, scopes, provider_metadata} et effectue la rotation du jeton d'accès automatiquement.
Comment Northwind a fait son choix
Les huit serveurs MCP de Northwind se répartissent approximativement en deux groupes. GitHub, Slack, Jira, Google Workspace et Zendesk sont tous des outils centrés sur l'utilisateur — la valeur de « l'exécuter en tant qu'Alice » l'emporte sur la charge opérationnelle d'un jeton par utilisateur. Ceux-ci utilisent le 3LO. Le service d'analyse interne, l'API Logistics et le service de planification d'itinéraires exposent tous des données à l'échelle de l'entreprise ; aucun OAuth par utilisateur n'est justifié, et un octroi Client Credentials partagé unique est à la fois plus simple et plus facile à auditer. Ceux-ci utilisent le 2LO.
Remarque sur cette vue de configuration
TrueFoundry enregistre les serveurs MCP via l'interface utilisateur (Settings → MCP Servers → Add MCP Server) plutôt qu'à travers un fichier YAML géré par le client, bien que la configuration puisse également être appliquée de manière déclarative via tfy apply. Le YAML ci-dessous illustre le modèle de configuration par serveur — les mêmes champs que vous remplissez dans l'interface utilisateur — en utilisant le schéma vérifié de TrueFoundry (provider-account/mcp-server-group avec des éléments integrations imbriqués).
La commande pour appliquer le yaml ci-dessus est :
Trois éléments sont à noter. Premièrement, tfy-secret:// est le schéma de référence FQN canonique utilisé par TrueFoundry pour les secrets stockés dans un groupe de secrets TrueFoundry, avec le format séparé par des deux-points tfy-secret://<tenant>:<secret-group>:<secret-key> documenté dans le guide des variables d'environnement et des secrets. La valeur réside dans votre gestionnaire de secrets (AWS SSM, GCP Secret Manager, HashiCorp Vault, Azure Key Vault) ; TrueFoundry résout le FQN au moment de l'exécution, de sorte que le fichier ci-dessus peut être conservé en toute sécurité dans un dépôt Git. Deuxièmement, authorized_subjects est la liste RBAC par serveur — un mélange d'équipes et de comptes virtuels — qui permet au même serveur MCP de desservir des développeurs humains (dont les PAT se résolvent en appartenance à une équipe) et des tâches planifiées basées sur des comptes de service (dont les jetons de compte virtuel s'associent à des sujets virtualaccount:) sans dérive de configuration. Troisièmement, l'entrée 3LO définit code_challenge_methods_supported: [S256] — PKCE est recommandé pour chaque client Authorization Code aujourd'hui et obligatoire dans la spécification MCP plus récente du 25-11-2025.
Du côté client, l'agent n'énumère jamais les modes d'authentification. Il se connecte à une URL de passerelle unique, présente un identifiant entrant unique, et la passerelle injecte le bon identifiant sortant par serveur :
La validité d'OAuth ne consiste pas seulement à obtenir des jetons. Il s'agit de les exploiter en toute sécurité sous une charge concurrente. La conception simpliste procède à l'actualisation lorsque le fournisseur renvoie une erreur 401, ou lorsque now ≥ expires_at. Cette conception fonctionne dans les démonstrations et échoue dès le premier lundi où elle est confrontée à la réalité.
Rejouons l'incident de Northwind avec une actualisation simpliste : à 8 h 47 le lundi, cinquante ingénieurs se connectent, chaque processus découvre indépendamment le même jeton GitHub expiré, cinquante appels POST /token parallèles frappent GitHub depuis la même passerelle, et GitHub applique une limitation de débit (rate limit) sur l'ensemble. Cargo Copilot renvoie des erreurs 401 à tout le monde jusqu'à ce que la file d'attente se vide.
Le modèle qui tient la route en production repose sur deux éléments : actualiser de manière proactive à 80 % du TTL, et sérialiser l'actualisation par (utilisateur, serveur) à l'aide d'un verrou distribué.
L'actualisation à 80 % du TTL laisse une marge pour le décalage d'horloge, les tentatives de rejeu, les points de terminaison de jetons lents des fournisseurs et les requêtes déjà en cours d'acheminement. Le verrou par (utilisateur, serveur) évite l'effet de ruée (thundering herd) contre le fournisseur. La double vérification de lecture à l'intérieur du verrou n'est pas cosmétique : elle permet à la première requête d'effectuer l'actualisation pendant que les autres réutilisent le jeton fraîchement écrit.
Deux subtilités sont cruciales à grande échelle. Premièrement, pour les intégrations Client Credentials, la clé de cache est (server_id, provider_account) ; pour les intégrations Authorization Code, la clé doit inclure user_id. Deuxièmement, les fournisseurs qui renouvellent le jeton d'actualisation à chaque actualisation — Google et Microsoft le font, selon la configuration — nécessitent que l'écriture soit atomique. Si le nouveau access_token est validé avant le nouveau refresh_token, une panne laisse l'utilisateur bloqué avec un ancien jeton d'actualisation invalidé et une réauthentification forcée.
Une fois les plans séparés et le parcours d'actualisation défini, une requête MCP de bout en bout traversant la passerelle adopte une structure précise. Traçons un appel de Cargo Copilot — « résumer les tickets ouverts de sévérité critique dans le dépôt northwind/logistics-core » — de l'agent vers GitHub et inversement :
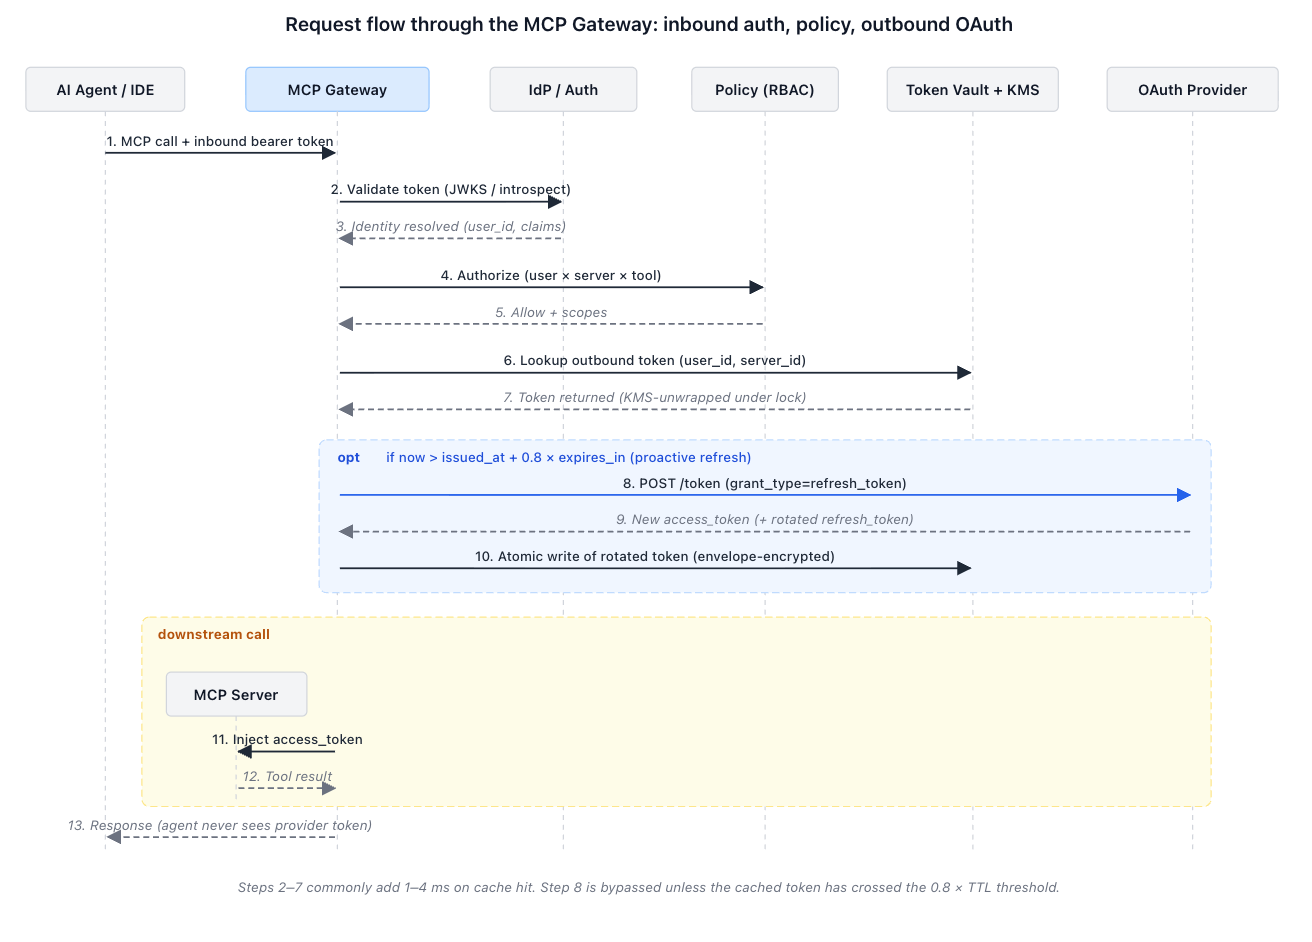
Trois propriétés de ce flux méritent d'être soulignées. L'agent ne reçoit jamais le jeton d'accès GitHub ; seule la passerelle le détient. Le serveur MCP ne voit jamais l'identifiant TrueFoundry entrant de Northwind, sauf si le Token Passthrough est explicitement configuré (plus d'informations à ce sujet au §7). Et l'équipe de sécurité de Northwind bénéficie d'un parcours de requête gouverné unique avec identité, autorisation et audit enregistrés en un seul endroit — la propriété même qui leur aurait permis de répondre en moins d'une minute à la question du lundi matin : « quels périmètres étaient présents sur cet ordinateur portable ? ».
La spécification d'autorisation MCP renforce une partie de ce schéma : les jetons d'accès Bearer doivent être envoyés dans l'en-tête de requête Authorization et jamais dans une chaîne de requête URI. Cette norme est essentielle précisément parce qu'elle évite que les jetons n'apparaissent dans les journaux d'accès, l'historique du navigateur et les traces de proxy.
Une passerelle en production ne doit pas traiter les jetons d'actualisation OAuth comme de simples lignes d'application ordinaires. Les secrets clients et les jetons d'actualisation sont des clés d'accès à longue durée de vie — fuiter un jeton d'actualisation Slack équivaut, dans la plupart des cas, à fuiter l'espace de travail Slack tout entier.
Le modèle standard est le chiffrement enveloppe (envelope encryption). La passerelle génère une clé de chiffrement de données (DEK) aléatoire pour chaque enregistrement de jeton, chiffre le secret OAuth avec cette DEK, chiffre la DEK avec une clé maître située dans un KMS ou un gestionnaire de secrets, et stocke la DEK chiffrée à côté du texte chiffré. Lors de la lecture, la passerelle demande au coffre-fort de déchiffrer uniquement la DEK, puis déchiffre le jeton dans un parcours de code strictement restreint qui évite de journaliser ou de sérialiser le texte clair.
Dans les déploiements plus stricts, l'échange de jetons lui-même peut être déplacé dans un sidecar ou une opération de transit au sein du coffre-fort, de sorte que le code de l'application ne reçoive jamais le matériel client_secret brut. Même avec un chiffrement enveloppe classique, le rayon d'impact change considérablement : un simple vidage de la base de données ne suffit pas (les DEK ne sont pas stockées déchiffrées), et un vidage de la mémoire d'un processus de traitement de requêtes est beaucoup moins susceptible de contenir un ensemble étendu d'identifiants (seules les clés récemment demandées sont déchiffrées, et uniquement pendant la durée de la requête).
Le déploiement de Northwind utilise AWS KMS comme magasin de clés maître et le magasin de secrets TrueFoundry pour le matériel chiffré. La passerelle ne lit jamais directement un client_secret de fournisseur ; elle lit un FQN de secret TrueFoundry, récupère le texte chiffré et demande à KMS de le déchiffrer. Le travail spécifique au déploiement qui subsiste — politique de rotation des clés KMS, conservation des audits, procédures opérationnelles — relève de la responsabilité de chaque entreprise qui exécute la passerelle, et mérite un examen dédié.
Deux modèles semblent similaires mais ont des implications de sécurité très différentes. Il convient de les distinguer soigneusement, car une mauvaise utilisation de l'un ou l'autre annule la majeure partie de la valeur de la passerelle.
Le Token Passthrough est approprié pour les serveurs MCP internes qui valident la même identité d'entreprise que celle que la passerelle a déjà validée en entrée. L'API Logistics de Northwind en est un exemple : la passerelle et l'API font toutes deux confiance au tenant Okta de l'entreprise, de sorte que la transmission du JWT Okta conserve l'identité de l'appelant intacte de bout en bout. Le risque est la confusion d'audience de jeton : un jeton créé pour la passerelle ne doit pas être automatiquement valide pour n'importe quel serveur MCP. La norme RFC 8707 (Resource Indicators) existe précisément pour lier les jetons à une ressource destinée, et la spécification d'autorisation MCP exige désormais que les clients incluent un paramètre resource et que les serveurs vérifient que les jetons présentés ont bien été émis pour eux.
Le Token Forwarding fonctionne différemment. L'en-tête x-tfy-mcp-headers de TrueFoundry transporte un JSON sous forme de chaîne indexé par l'identifiant du serveur MCP distant au format <group>/<server>. Voici le format mot pour mot tiré de la documentation des serveurs MCP virtuels :
Considérez le Token Forwarding comme une issue de secours, et non comme un choix par défaut. La valeur de la passerelle réside précisément dans la gestion des jetons qu'elle permet d'éviter de faire manuellement.
Une passerelle ajoute du traitement avant l'appel MCP en aval : validation de l'authentification entrante, recherche de politique, recherche de jeton et, occasionnellement, actualisation. Dans un déploiement sain, le cas général est un accès réussi au cache (hit) — les métadonnées du jeton sont valides, la référence du jeton chiffré est disponible en mémoire.
En combinant les coûts des composants ci-dessus, la passerelle ajoute environ :
Deux enseignements principaux. Premièrement, le cas général est un accès réussi au cache (hit) et, avec quelques millisecondes, il est imperceptible par rapport à l'appel LLM global (généralement de plusieurs centaines de millisecondes à plusieurs secondes) et au serveur MCP en aval (généralement de quelques dizaines à plusieurs centaines de millisecondes). Deuxièmement, le cas du manque dans le cache avec actualisation est rare mais suffisamment coûteux pour impacter les performances lorsqu'il s'accumule sous une forte charge — c'est exactement pourquoi le §4 préconise une actualisation proactive à 80 % du TTL avec un verrou par (utilisateur, serveur). Grâce à l'actualisation proactive, les utilisateurs réels ne subissent pratiquement jamais la latence d'actualisation sur le parcours de la requête ; la passerelle a déjà récupéré un nouveau jeton au préalable.
Chaque équipe doit néanmoins instrumenter séparément les en-têtes Server-Timing, la durée du point de terminaison de jeton, le temps d'attente des verrous, le temps de déchiffrement du coffre-fort et la latence MCP en aval. L'objectif est de vérifier que la gestion des jetons ne constitue pas le coût principal dans l'appel d'outil de l'agent de bout en bout — les ordres de grandeur ci-dessus suggèrent que c'est presque jamais le cas, mais il convient de le valider avec la combinaison de fournisseurs qui vous est propre.
La solution opérationnelle pour le cas de manque dans le cache est l'actualisation en arrière-plan. Lorsque la passerelle détecte qu'un jeton dépasse le seuil de 80 %, elle effectue une actualisation sur le parcours de la requête une fois, puis planifie les actualisations suivantes avant que les utilisateurs ne s'en rendent compte. Pour les intégrations Client Credentials partagées à fort volume, cela élimine presque totalement la latence d'actualisation visible par l'utilisateur. Pour les intégrations Authorization Code par utilisateur, le système peut donner la priorité aux utilisateurs actifs et aux serveurs MCP fréquemment utilisés.
Non. La spécification d'autorisation MCP rend l'autorisation optionnelle, mais les implémentations basées sur HTTP qui la prennent en charge doivent se conformer à la spécification. En pratique, les entreprises disposant d'un parc d'outils conséquent devraient centraliser l'authentification bien avant de la considérer comme strictement obligatoire.
Non. Utilisez le code d'autorisation (3LO) lorsque l'agent agit sur les ressources d'un utilisateur humain — Slack, GitHub, Gmail, outils CRM. Utilisez les identifiants client (2LO) lorsque le serveur en aval authentifie l'application ou la passerelle en tant qu'elle-même. Mélanger les deux au sein d'un même Virtual MCP Server est normal et attendu.
Non. Elle les complète. Slack, GitHub, Google et les API internes appliquent toujours leurs propres périmètres et autorisations de ressources. La passerelle ajoute une couche de politique plus globale et plus rapide par-dessus — au niveau du serveur, de l'outil, de l'équipe — ainsi qu'une piste d'audit uniforme sur l'ensemble d'entre eux.
La passerelle TrueFoundry gère les types d'octroi OAuth 2.0 pris en charge par les fournisseurs actuels : code d'autorisation (avec PKCE), identifiants client et jetons de rafraîchissement. La spécification d'autorisation MCP elle-même cible OAuth 2.1, qui est largement OAuth 2.0 plus les meilleures pratiques de sécurité déjà considérées comme obligatoires dans les déploiements modernes (PKCE partout, pas d'octroi implicite, pas d'octroi par mot de passe). À des fins pratiques, les deux convergent ; nous suivons les recommandations d'OAuth 2.1 là où elles renforcent la sécurité.
La révision de novembre 2025 ajoute l'obligation du PKCE pour tous les clients, formalise les documents de métadonnées d'ID client (CIMD) comme méthode d'enregistrement de client privilégiée, et introduit l'autorisation échelonnée pour le consentement incrémentiel de périmètre. Cela renforce la sécurité sans invalider l'architecture de cet article. Nous suivons ces évolutions et intégrons leur prise en charge au fur et à mesure de leur maturité dans l'écosystème.
TrueFoundry MCP Gateway est une implémentation de production de cette architecture : un registre centralisé de serveurs, une authentification entrante configurable, un contrôle d'accès, plusieurs modes d'authentification sortante et la gestion du cycle de vie des jetons. Cet article décrit la conception ; la documentation sur l'authentification et la sécurité constitue la référence opérationnelle. Pour les modèles d'implémentation abordés ici, consultez également la documentation sur les Auth Overrides et le Virtual MCP Server.
Si vous dirigez la plateforme, la sécurité ou l'infrastructure AI en exploitant MCP à grande échelle, l'action à plus fort impact consiste à inventorier chaque serveur MCP en cours d'utilisation, à associer chacun d'eux au modèle d'authentification entrante, de politique et d'authentification sortante adéquat, et à décider où la centralisation apporte une vraie valeur. La cartographie de Northwind a pris deux après-midis ; la migration elle-même a pris un seul sprint. Nous serons ravis d'effectuer cet exercice avec votre équipe.
Consultez l'architecture : Authentification et sécurité de TrueFoundry MCP Gateway. Ou réservez une revue d'architecture de sécurité d'entreprise avec notre équipe.
Toutes les citations de cet article sont intégrées sous forme de liens. Les références ci-dessous regroupent ces mêmes URL pour faciliter l'impression et prévenir les liens morts.
Remarque : Northwind Logistics est une entreprise fictive utilisée pour ancrer la conception dans un déploiement concret. Le modèle de configuration présenté au §3 est illustratif ; les serveurs MCP de production sont enregistrés via l'interface utilisateur TrueFoundry ou appliqués via tfy apply.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















