October 1, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: September 11, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Modèle de données, métadonnées d'authentification, découverte dynamique d'outils et isolation multi-locataire pour la couche entre vos agents et vos outils.
Lorsque vingt développeurs maintiennent chacun leur propre ~/.cursor/mcp.json, vous n'avez pas construit d'infrastructure MCP. Vous avez construit un système de post-it distribué qui se bloque à chaque rotation d'identifiant.
02:47 UTC, mardi. Continental Aerospace Systems — un fournisseur de plateformes avioniques de 240 ingénieurs, fictif mais malheureusement plausible — fait pivoter sa clé privée d'application GitHub comme prévu. À 09h00, #platform-help compte 23 fils de discussion de chefs d'équipe, chacun une variante de "MCP est cassé dans Cursor." La solution est identique à chaque fois — coller le nouveau jeton dans ~/.cursor/mcp.json, redémarrer l'IDE — mais cela doit être fait 187 fois, et l'équipe plateforme perd une demi-journée avant d'avoir terminé.
Ce matin-là n'est pas un problème MCP. C'est un problème de registre . Le protocole fonctionne ; ce qui manque, c'est la couche entre l'agent et le protocole qui sait quels serveurs existent, qui peut utiliser quels outils, et comment informer chaque IDE de l'organisation d'un identifiant renouvelé sans 187 commits Git. Cet article porte sur cette couche, en utilisant le MCP Gateway de TrueFoundry comme implémentation de référence.
La nature du problème est la multiplication. Les 240 ingénieurs de Continental, répartis en 14 équipes, utilisent Claude Code, Cursor et VS Code avec huit serveurs MCP : GitHub, Sentry, Atlassian, Linear, Slack, un serveur interne basé sur Postgres pour la télémétrie de flotte , un serveur de base de connaissances sur la navigabilité serveur soutenu par leurs directives FAA, et Exa pour la recherche. À la base, chaque ingénieur maintient un ~/.cursor/mcp.json comme ceci.
~/.cursor/mcp.json — configuration MCP locale, par développeur
{
  "mcpServers": {
    "github": {
      "url": "https://api.githubcopilot.com/mcp",
      "headers": { "Authorization": "Bearer ghp_..." }
    },
    "sentry": {
      "url": "https://mcp.sentry.dev/mcp",
      "headers": { "Authorization": "Bearer sntrys_..." }
    },
    "linear":    { "url": "https://mcp.linear.app/mcp" },
    "atlassian": { "url": "https://mcp.atlassian.com/v1/mcp" },
    "slack":     { "url": "https://mcp.slack.com/mcp" },
    "fleet-telemetry": {
      "url": "https://fleet-mcp.internal.example/mcp",
      "headers": { "Authorization": "Bearer eyJ..." }
    },
    "airworthiness-kb": { "url": "https://kb-mcp.internal.example/mcp" },
    "exa": {
      "url": "https://mcp.exa.ai/mcp",
      "headers": { "Authorization": "Bearer exa_..." }
    }
  }
}
Huit serveurs par développeur, 240 développeurs, donnent à l'équipe plateforme environ 1 920 entrées de configuration implicites à maintenir correctement. Les coûts se répartissent en cinq catégories.
L'aperçu de la passerelle MCP décrit le monde pré-registre comme quatre pathologies qui se chevauchent — infrastructure fragmentée, prolifération des identifiants, visibilité nulle, absence de gouvernance :
Un registre regroupe les cinq lignes en une seule primitive architecturale : un enregistrement de ressource par serveur MCP, détenu par un plan de contrôle, que chaque IDE et chaque agent référence par ID. Le reste de cet article explique ce que contient cet enregistrement et ce que le système qui l'entoure doit faire.
Avant la découverte, l'authentification ou l'isolation, nous devons être précis sur ce qu'une entrée de registre est. La forme sur laquelle nous nous sommes accordés :
Entrée de registre de serveur MCP — modèle conceptuel (interface TypeScript)
// Conceptual model. The on-the-wire schema is exposed through
// the TrueFoundry UI and CLI, not as a public DDL.
interface McpServerRegistryEntry {
  server_id:        string;            // stable, tenant-scoped identifier
  display_name:     string;
  transport_type:   "streamable_http" | "sse" | "stdio";

  // Connectivity (one of, by transport)
  base_url?:        string;            // remote
  command?:         string;            // stdio: e.g. "npx"
  args?:            string[];          // stdio: argv beyond command

  auth_config:      AuthConfig;                // §4
  collaborators:    Collaborator[];            // §5
  tenant_id:        string;            // always present, always filtered on
  cached_tool_schema?:   ToolSchema[];         // last successful tools/list
  cached_schema_at?:     string;
  health_status:    "healthy" | "degraded" | "unhealthy" | "circuit_open";

  created_at:       string;
  updated_at:       string;
}
Schéma conceptuel — pas un DDL déployableLe plan de contrôle TrueFoundry expose la structure du registre via l'interface utilisateur et les manifestes YAML vérifiés pour les serveurs stdio (voir la documentation stdio). L'interface ci-dessus énumère les responsabilités qu'une entrée de registre doit couvrir ; la disposition du stockage est un détail d'implémentation.
Quatre champs assurent le travail structurel. server_id + tenant_id est la clé primaire sur laquelle tout est filtré. auth_config sépare « où se trouve le serveur » de « comment communiquer avec lui » — la mesure qui rend la rotation des identifiants peu coûteuse (§4). collaborators est le point d'attachement de la politique d'accès. cached_tool_schema est ce qui rend la découverte dynamique suffisamment rapide pour être utilisable.
À quoi ressemblent les entrées de registre de Continental
Les huit serveurs de Continental deviennent huit entrées. Le fleet-telemetry-readonly est un streamable_http serveur utilisant le Passthrough de jetons — le JWT Okta de l'ingénieur SRE d'astreinte est transmis en amont, ce qui valide l'audience et applique la sécurité au niveau des lignes par revendication d'équipe. Linear est enregistré comme un stdio serveur via mcp-remote, avec un per_user modèle d'authentification afin que chaque ingénieur autorise son propre compte Linear, par la documentation du serveur stdio. Les manifestes complets se trouvent dans le fichier compagnon mcp-registry-manifests.yaml.
Une fois le registre alimenté, la deuxième tâche consiste à le rendre interrogeable. Le cas intéressant n'est pas celui d'un développeur dans Cursor — Cursor a un fichier de configuration — mais celui d'un agent autonome, fonctionnant comme un service, sans liste d'outils statique. L'agent se réveille avec un jeton d'accès ; la passerelle doit transformer cela en « voici les outils que vous, spécifiquement, êtes autorisé à utiliser actuellement », sans que l'agent ne connaisse aucun des serveurs à l'avance.
Le processus utilise la méthode standard MCP tools/list méthode comme point d'entrée, mais la passerelle intercepte et réécrit la réponse. Le diagramme ci-dessous présente l'architecture à trois plans.
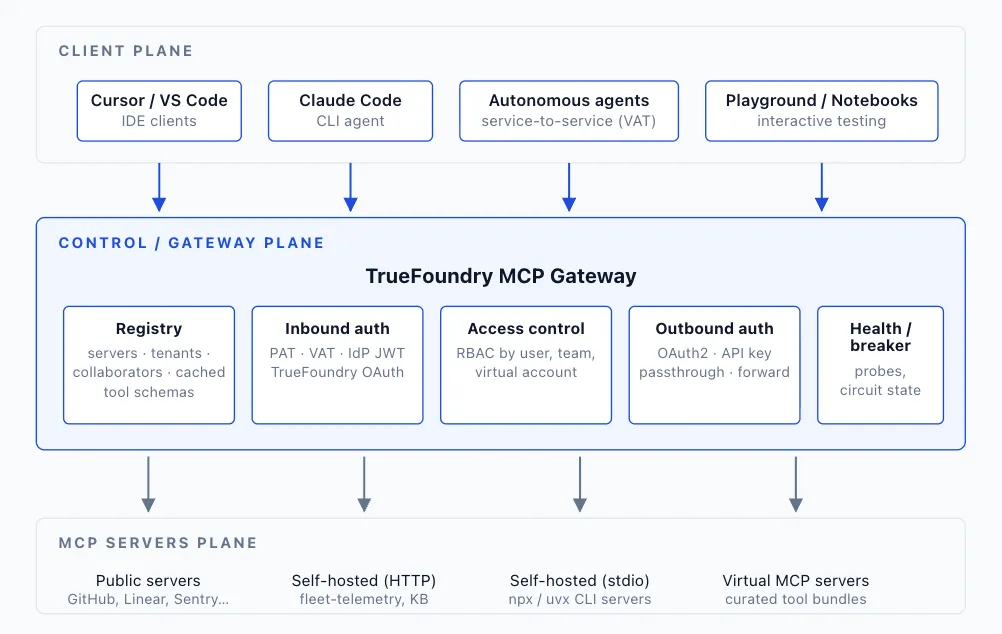
En parcourant le chemin de découverte étape par étape :
tools/list à la passerelle avec son jeton d'accès. Il n'énumère pas les serveurs ; il ne connaît pas les serveurs.cached_tool_schema lorsqu'il est actuel — le chemin qui s'exécute en état stable — et se rabat sur un flux en amont frais tools/list uniquement en cas d'échec du cache ou après une listChanged invalidation (§7). Une diffusion synchrone vers chaque système en amont à chaque requête de l'appelant serait opérationnellement intenable.fleet-telemetry-readonly mais se voit toujours refuser les outils d'écriture — ceux-ci nécessitent un rôle distinct.tools/list. Le câblage de l'agent n'a pas besoin de savoir de quel serveur en amont chaque outil provient — bien que les noms d'outils, les descriptions et les messages d'erreur puissent encore télégraphier l'origine en pratique, c'est pourquoi les passerelles nomment souvent les outils par serveur.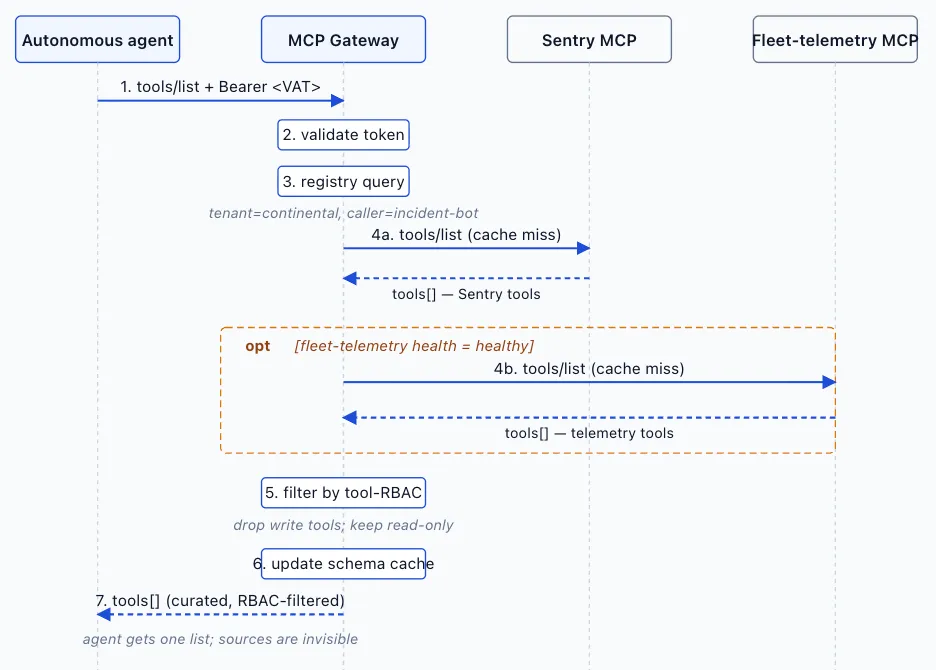
Deux conséquences méritent d'être mentionnées. Premièrement, un agent peut être déployé sur un locataire avec une configuration spécifique à MCP nulle — donnez-lui un jeton de compte virtuel, pointez-le vers l'URL de la passerelle, et il découvre ce qu'il est autorisé à utiliser. L'agent de réponse aux incidents d'astreinte de Continental est livré sous forme d'un conteneur avec une seule variable d'environnement. Deuxièmement, l'extension de la surface d'outils de l'agent est un changement de registre, et non un redéploiement de l'agent : l'ajout de airworthiness-kb à la liste collaborateurs rend ses outils visibles dans la prochaine tools/list réponse — même binaire, même configuration.
L'opération la plus coûteuse dans le monde pré-registre est la rotation des identifiants. La moins coûteuse dans le monde post-registre est cette même rotation. La raison en est un choix architectural : les métadonnées d'authentification sont stockées sur l'entrée du registre, et non sur le client.
Les documents d'authentification présentent cela comme une séparation entre l'authentification entrante (comment le client prouve son identité à la passerelle) et l'authentification sortante (comment la passerelle prouve son identité à chaque serveur en aval). L' auth_config de chaque entrée gère le côté sortant :
Deux propriétés de auth_config sont importantes sur le plan opérationnel : elle référence les identifiants, elle ne les stocke pas ; et elle est gérée par l'équipe plateforme, et non par l'équipe application.
La première propriété est ce que l'intégration de TrueFoundry avec le gestionnaire de secrets vise à simplifier. Les identifiants dans une entrée de registre sont stockés comme des références utilisant tfy-secret://<tenant>:<secret-group>:<secret-key>. Le matériel réel réside dans le magasin de secrets du locataire — natif TrueFoundry, AWS SSM, GCP Secret Manager, HashiCorp Vault ou Azure Key Vault — et la passerelle résout la référence à l'exécution. Pour les plans de contrôle auto-hébergés, l'équivalent est tfy-k8s-secret://<KEY_NAME>, soutenu par un secret Kubernetes.
Comment la rotation de Continental s'est déroulée après le registre
Même rotation à 02:47 UTC. Vault dépose la nouvelle clé à tfy-secret://continental-aerospace:github-app:GITHUB_APP_PRIVATE_KEY. La prochaine invocation de l'outil GitHub déréférence le secret, obtient la nouvelle valeur et transmet la requête. Zéro modification de configuration pour le développeur. Zéro ticket. L'équipe plateforme est informée de la rotation via un tableau de bord le lendemain matin.
Un registre qui héberge des serveurs pour un seul locataire est simple. Un registre qui héberge des serveurs pour des centaines — ou, sur un plan de contrôle auto-hébergé, pour plusieurs unités commerciales au sein de la même entreprise — doit offrir une garantie plus solide : les serveurs de l'organisation A doivent être invisibles pour l'organisation B, et pas seulement inaccessibles. « Inaccessible » est un 403 que le mauvais agent pourrait voir. « Invisible » est une tools/list réponse qui ne suggère pas l'existence d'un autre locataire.
Locataire dans l'URL. La modification de l'URL v0.130 a déplacé l'URL de la passerelle de /api/llm/mcp/<server>/server à /api/llm/<tenant>/mcp/<server>/server. Le locataire fait désormais partie du chemin adressable — ce qui permet au chaînage OAuth de MCP de fonctionner, et ce qui permet à une passerelle physique de servir plusieurs locataires sans état ambiant.
Locataire dans chaque requête. À l'intérieur du registre, chaque lecture est paramétrée par tenant_id. Il n'y a pas de chemin "lister tous les serveurs" ; seulement "lister tous les serveurs dans ce locataire." Le codage en dur du filtre au niveau de la couche d'accès aux données n'élimine pas les fuites inter-locataires en tant que catégorie de bugs — la mise en cache, la propagation de contexte asynchrone, les tâches de fond, les index de recherche et les jointures de télémétrie peuvent tous encore fuir — mais cela supprime le vecteur le plus important et le plus probable, celui où une clause manquante WHERE dans une vérification RBAC renvoie les lignes du mauvais locataire.
Locataire dans l'identité. Les collaborateurs sont résolus via le modèle d'identité du plan de contrôle. Les utilisateurs appartiennent à des locataires ; les équipes sont limitées aux locataires ; les comptes virtuels sont créés au sein des locataires. La première vérification du moteur RBAC est que le locataire de l'appelant corresponde au locataire de la ressource.
Parcours de requête conceptuel — le filtrage par locataire est impératif
// Tenant filter applied before the access-policy check.
// This shrinks the blast radius of an RBAC bug — the wrong tenant's
// rows aren't loaded — but caching, async context, and indexers
// still need their own tenant-scoping discipline.
function listAccessibleServers(caller: Identity): McpServerRegistryEntry[] {
  const rows = registry.query({
    tenant_id: caller.tenant_id,
    health_status: { $ne: "circuit_open" },
  });
  return rows.filter(server => rbac.canRead(caller, server));
}
Services partagés entre les unités commerciales chez Continental
Les divisions d'avionique et de systèmes terrestres de Continental fonctionnent comme des locataires distincts sur le même plan de contrôle. La plupart du temps, c'est tout à fait exact — le serveur de télémétrie de flotte n'est pas pertinent, et n'est pas légalement autorisé, pour les ingénieurs en systèmes terrestres. Mais un serveur, un MCP de documentation d'entreprise, devrait être visible par les deux. Le schéma est une attribution explicite de collaborateur inter-locataires : le tenant_id de l'entrée reste chez le locataire propriétaire, mais la liste des collaborators inclut un principal de l'autre. La visibilité partagée est une attribution délibérée et auditée — jamais un accident.
L'enregistrement d'un serveur MCP public et l'enregistrement d'un serveur auto-hébergé sont la même opération conceptuelle — produire une entrée de registre — mais les flux de travail sont différents, et le registre doit prendre en charge les deux.
Pour les serveurs publics (GitHub, Linear, Sentry, Atlassian, Slack, Exa, Playwright MCP, DeepWiki, Context7), l'opération se résume à quelques clics. Le flux « Ajouter un serveur MCP » de la passerelle MCP propose cinq parcours d'enregistrement : Connecter des serveurs MCP distants officiels, Connecter n'importe quel serveur MCP distant, Créer un serveur MCP virtuel, Importer depuis une spécification OpenAPI, et Serveur MCP hébergé basé sur Stdio. Le premier permet de choisir dans un catalogue sélectionné avec les métadonnées d'authentification pré-remplies ; vous fournissez l'ID/secret client OAuth et le reste de l'entrée est généré.
Serveurs auto-hébergés — les systèmes internes de Continental fleet-telemetry-readonly, par exemple — utilisent Connect any Remote MCP Server (pour les points de terminaison HTTPS) ou Hosted Stdio-based MCP Server (pour les serveurs de type CLI). Le chemin stdio est intéressant car la passerelle devient responsable de l'exécution du processus, et non pas seulement de son appel. La documentation stdio définit la structure vérifiée du manifeste YAML : command, args, et un auth_data bloc avec soit auth_level: per_user (le secret de chaque appelant étant substitué dans {{API_KEY}}) ou auth_level: global (une valeur partagée à travers le locataire). Le document d'accompagnement mcp-registry-manifests.yaml comprend quatre exemples concrets couvrant les deux niveaux d'authentification et le modèle de serveur MCP virtuel.
Quel que soit le chemin, le registre valide qu'un serveur nouvellement enregistré est accessible avant de le publier. Pour les serveurs HTTPS distants, il s'agit d'une sonde tools/list. Pour stdio, la passerelle démarre un processus éphémère, envoie initialize, et s'assure que le serveur répond correctement. Un serveur qui ne peut pas être sondé est rejeté lors de l'enregistrement — il n'est pas ajouté dans un état défectueux qui se manifesterait par des erreurs 503 lorsque les développeurs tenteraient de l'utiliser.
La mise en cache du schéma d'outil fait la différence entre un registre utilisable et un registre inutilisable. Une implémentation naïve qui appelle tools/list sur chaque serveur amont à chaque requête d'agent multiplie la latence de la passerelle par le nombre de serveurs amont et ajoute un mode de défaillance par serveur. Le cache résout le problème de latence et en crée un nouveau : la dérive de schéma.
La passerelle maintient un cached_tool_schema par entrée, actualisé de deux manières.
Actualisation pilotée par les événements. La spécification MCP définit une listChanged notification que les serveurs déclarant { "tools": { "listChanged": true } } peuvent émettre lorsque la liste de leurs outils change. Pour les serveurs qui déclarent cette capacité et émettent de manière fiable sur leur connexion persistante, la passerelle traite la notification comme un signal d'invalidation et récupère des données fraîches avant que l'appelant suivant ne voie des données périmées. C'est la voie rapide lorsqu'elle est disponible — mais elle n'est pas universelle : de nombreux serveurs MCP n'implémentent pas listChanged du tout, et certains déclarent la capacité mais émettent de manière incohérente à travers les transports.
Actualisation périodique. Pour tout le reste, la passerelle relance une sonde à une cadence configurable (quelques minutes pour les serveurs actifs, plus longue pour ceux réputés calmes). La sonde réutilise le pool de connexions existant. En pratique, la plupart des déploiements en production s'appuient sur l'actualisation périodique comme mécanisme principal et considèrent listChanged comme opportuniste lorsqu'il fonctionne.
Le registre doit savoir ce qui est actif. Sinon, il fait la pire chose : il annonce un outil dont le serveur renvoie des erreurs 503 depuis une heure, et chaque agent du tenant subit un timeout en essayant de l'appeler.
Le sous-système de santé exécute trois boucles.
Sonde. Un processus en arrière-plan appelle tools/list sur chaque serveur à une cadence configurable. Le succès promeut le serveur à l'état sain et rafraîchit le schéma mis en cache ; l'échec (erreur réseau, 5xx, charge utile mal formée) incrémente un compteur.
Seuil. Une fois que le compteur dépasse un seuil — ajusté par classe de serveur, étant donné que le SaaS public bénéficie de plus de marge de manœuvre que l'interne — le serveur passe à l'état non sain et ses outils sont marqués. Après un second seuil, le disjoncteur s'ouvre (circuit_open). La plupart des déploiements choisissent de masquer entièrement un serveur en circuit ouvert des tools/list réponses afin que les agents voient une liste d'outils plus courte plutôt qu'une liste avec des entrées défectueuses ; certains gardent les outils visibles mais les marquent, partant du principe que les planificateurs d'agents peuvent mieux s'adapter à "indisponible" qu'à "manquant". La meilleure approche dépend de la manière dont vos agents gèrent l'absence.
Récupération. Le disjoncteur est semi-ouvert après une période de refroidissement : une seule sonde ; en cas de succès, il se ferme ; en cas d'échec, la période de refroidissement double. Application standard du recul exponentiel.
La raison pour laquelle cela importe n'est pas la latence, mais la composition de la fiabilité. Sans coupe-circuit, un agent qui dépend de sept serveurs en amont échoue si l'un d'entre eux tombe en panne. Avec lui, l'agent perd les outils d'un serveur et continue avec les six autres. Pour l'agent de réponse aux incidents d'astreinte de Continental, c'est la différence entre "nous continuons le triage pendant que Sentry est hors service" et "l'assistant IA est lui-même hors service parce que Sentry est hors service".
Les différences se répartissent en six dimensions.
Il n'est pas nécessaire , mais la colocation avec la passerelle de modèle offre des avantages cumulatifs — le même moteur RBAC, l'intégration du gestionnaire de secrets, le pipeline d'audit et le modèle d'identité servent à la fois le trafic de modèle et le trafic d'outils. La passerelle MCP de TrueFoundry fait intentionnellement partie du même plan de contrôle que la passerelle IA pour cette raison.
Cela ne se produit pas, car la configuration de l'IDE ne contient plus de justificatifs — seulement une URL de passerelle. Après la v0.130, la configuration Cursor ou VS Code pour un serveur MCP se réduit à une URL de passerelle à portée locataire, plus tout mécanisme d'amorçage OAuth ou IdP que votre organisation exige déjà — la passerelle gère la résolution des identifiants de l'autre côté. Il n'y a pas de secret par serveur dans la configuration de l'IDE susceptible de dériver par rapport au registre.
Grâce au transfert de jetons. Le client définit x-tfy-mcp-headers avec l'authentification requise par le système en amont, et la passerelle la transmet. C'est la solution de repli pour les serveurs dont les schémas ne correspondent à aucun modèle intégré — courant pour les services internes hérités.
Oui, via un serveur MCP virtuel. La fonctionnalité de serveur virtuel assemble un ensemble d'outils sélectionnés provenant d'un ou plusieurs serveurs enregistrés et accorde un accès indépendant à cet ensemble. La boîte à outils de réponse aux incidents de Continental est un serveur virtuel exposant des outils Sentry en lecture seule ainsi que des outils de télémétrie de flotte en lecture seule à l'équipe d'astreinte — aucune des opérations destructrices n'est accessible.
La passerelle suit le serveur. Depuis la v0.130, elle préserve le transport du système en amont plutôt que de le normaliser en HTTP en flux continu. Les clients qui suivent le modèle de la spécification (HTTP en flux continu d'abord, puis repli sur SSE) continuent de fonctionner sans aucune modification de configuration.
C'est l'objet du §3. Un agent s'authentifie une seule fois auprès de la passerelle, appelle tools/list, et reçoit une liste d'outils sélectionnée et filtrée par RBAC. Il peut ensuite appeler tools/call avec n'importe quel élément de cette liste. Pas d'inventaire préétabli, pas de redéploiements.
Enregistrez un serveur que vous utilisez déjà — Linear, GitHub ou Sentry sont généralement les premiers choix car les processus d'authentification sont éprouvés — et dirigez la configuration IDE d'une équipe vers l'URL de la passerelle. N'essayez pas de migrer 240 développeurs et 8 serveurs en une seule fois ; migrez un serveur et 10 développeurs, tirez les leçons du déploiement, puis étendez.
Si ~/.cursor/mcp.json la dérive a commencé à coûter du temps à votre équipe plateforme, c'est le signal pour centraliser. Le TrueFoundry MCP Gateway est la couche de registre et de politique que nous avons conçue pour cette transition ; vous pouvez lire la documentation d'architecture ou l'essayer gratuitement.
tfy-secret:// format de référencetools/list, tools/call, listChanged notification
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception