



November 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Le masquage des données (data masking) remplace une valeur sensible par un substitut sans danger, tout en maintenant les données environnantes exploitables. Il provient du monde des bases de données : donnez à l'équipe QA une copie de la production où chaque numéro de carte devient 4111-****-****-1234 et ils pourront tester des structures réalistes sans détenir de vraies PII. Appliquez cela à une passerelle LLM et le contexte change — vous masquez du texte libre, en transit vers un tiers, au sein d'une conversation qui doit continuer à avoir du sens.
Ces termes sont constamment utilisés comme synonymes. Ils ne le sont pas.
La distinction réversible vs irréversible est celle qui importe. La tokenisation, le FPE et le chiffrement permettent un aller-retour (round-trip) — quelqu'un détient un coffre-fort ou une clé, un nouvel actif à protéger. Le masquage, le caviardage et l'anonymisation sont à sens unique : plus simples, plus sûrs, et inutiles dès qu'un composant en aval a besoin de la valeur réelle.
La pseudonymisation n'est pas l'anonymisation. Selon le RGPD, les données pseudonymisées restent des données à caractère personnel et entrent dans son champ d'application ; seules les données véritablement anonymisées sortent du cadre réglementaire (Considérant 26). Remplacer chaque nom par un identifiant stable comme User-8812 est une pseudonymisation, et prétendre le contraire ne tiendra pas lors d'un audit.
Un troisième axe est facile à négliger : la cohérence est distincte de la réversibilité. Un outil de masquage peut être déterministe — une même entrée produit toujours le même espace réservé (placeholder) — sans être réversible, et c'est le déterminisme qui permet à un modèle de raisonner sur « la même personne » tout au long d'une conversation.
C'est la partie que la plupart des articles passent sous silence, et elle détermine si votre conception tiendra la route.
La qualité de sortie du modèle se dégrade, de manière inégale. Transformez « Appelez notre bureau au 312-555-1234 » en « Appelez notre bureau au ************ » et le modèle ne sait plus qu'il s'agissait d'un numéro de téléphone — les astérisques ne transportent aucune information de type. Les placeholders étiquetés comme [PHONE_NUMBER] conservent le type, mais révèlent la nature du contenu à quiconque voit le prompt. Le résumé s'en aperçoit à peine ; l'extraction échoue bruyamment ; la corrélation entre deux entités échoue silencieusement, ce qui est pire.
Les appels d'outils (tool calls) ont besoin de la vraie valeur. C'est l'échec le plus brutal. Un agent qui masque customer@acme.com à l'entrée ne peut pas ensuite exécuter lookup_account(email=...). Masquer le parcours vers le modèle tout en laissant le parcours vers l'outil ouvert crée la faille inverse : le modèle n'a jamais vu l'adresse, mais les arguments de l'outil la transmettent à un serveur MCP tiers. Déterminez, pour chaque outil, quel niveau de confiance accorder.
Les sorties structurées et les schémas JSON cassent. Si vous utilisez des sorties structurées avec JSON Schema, le masquage peut produire une valeur qui ne satisfait plus son propre champ : un champ format: email ne peut pas contenir [REDACTED EMAIL], et un champ entier ne peut pas contenir d'astérisques. Le masquage préservant la longueur est plus adapté car il conserve la forme. Masquer la phase de sortie est pire — le modèle a produit du JSON valide, l'outil de masquage a réécrit une valeur à l'intérieur, et votre parser lève une erreur sur une réponse que le modèle avait correctement générée.
La cohérence multi-tours. Tour 1 : « Priya Raman est le propriétaire du compte. » Tour 4 : « En est-elle toujours propriétaire ? » Si le tour 1 a été remplacé par des astérisques, le modèle n'a plus de fil conducteur à suivre. La pseudonymisation déterministe résout ce problème, mais seulement si le système de masquage conserve l'état entre les tours — ce qu'un guardrail stateless ne fait pas.
La recherche RAG sur du texte masqué. Masquez les documents avant l'indexation et l'embedding ne contiendra plus l'entité ; une requête ciblant cette entité ne récupérera donc pas le segment (chunk). Indexez sans masquer puis masquez lors de la recherche, et votre vector store contiendra le corpus non masqué — la situation exacte que vous cherchiez à éviter.
Appliqué de manière ciblé, le masquage apporte une vraie valeur. Appliqué de manière globale, il dégrade silencieusement le produit sans que personne ne fasse le lien entre les deux.
Supposer que le masquage est réversible. Une équipe masque les PII envoyées au modèle, suppose qu'un processus les démasquera au retour, et développe son application sur cette hypothèse. À moins d'avoir choisi un schéma réversible et de gérer des clés, l'appelant verra également la valeur masquée.
Masquer le prompt en oubliant le parcours des outils. Les données circulent à quatre endroits : vers le modèle, depuis le modèle, vers un outil, depuis un outil. N'en couvrir qu'un seul est fréquent. La fuite se produit alors via le résultat d'un outil que personne n'inspectait.
Traiter le caviardage des journaux comme un contrôle de flux de données. Caviarder les journaux stockés limite l'accès interne à la lecture des prompts. Le fournisseur, lui, a tout de même reçu le texte original.
Choisir un masquage irréversible pour un problème réversible. Si un composant en aval doit récupérer la valeur d'origine, le masquage n'est pas la bonne technique. Il vous faut de la tokenisation ou du FPE, ce qui implique la gestion d'un coffre-fort ou d'une clé.
Le masquage n'est pas un produit séparé ici. Chaque guardrail comporte deux paramètres — Operation Mode et Enforcement Strategy — le masquage étant une valeur du premier.
La priorité définit l'ordre d'exécution du masquage. Trois guardrails de mutation sur un même hook s'exécutent dans l'ordre, chacun recevant le résultat du précédent : un masqueur de secrets à la priorité 1 et un masqueur Regex à la priorité 2 signifient que le guardrail Regex analysera un texte contenant déjà ***REDACTED***.
La mutation des entrées est bloquante et s'exécute en premier — la requête au modèle ne peut pas démarrer tant que le prompt n'est pas finalisé. La validation des entrées s'exécute ensuite en arrière-plan en parallèle, et si elle échoue en cours de route, la gateway annule la requête au modèle afin d'éviter des coûts inutilement. La mutation et la validation des sorties s'exécutent de manière synchrone après la réception de la réponse, moment où le coût du modèle est déjà engagé.

Les appels d'outils MCP ajoutent deux hooks synchrones : pre-invoke, où un échec empêche l'exécution de l'outil, et post-invoke, où un échec retient le résultat. Les guardrails s'exécutent séparément sur chaque appel d'outil — cinq outils génèrent cinq séries de vérifications.

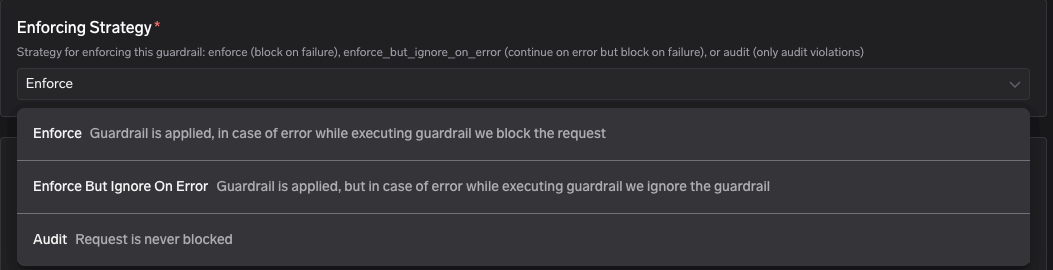
Le second paramètre distingue deux types d'échecs : le guardrail a détecté une anomalie vs le guardrail est tombé en erreur.
Stratégie
En cas de violation
En cas d'erreur du guardrail
Enforce
Bloquer
Bloquer (fail-closed)
Enforce But Ignore On Error
Bloquer
Laisser passer (dégradation progressive)
Audit
Laisser passer, journaliser uniquement
Laisser passer
La documentation qualifie Enforce But Ignore On Error de « valeur par défaut la plus sûre » et recommande une progression : Audit → Enforce But Ignore On Error → Enforce.
Déclarer « Nous avons un guardrail PII » ne dit rien sur sa capacité à masquer.
Le guardrail PII / PHI Detection est un cas particulier : il ne peut pas bloquer, seulement masquer. Si votre exigence est de « rejeter toute requête contenant un numéro de sécurité sociale », ce n'est pas le guardrail adapté.
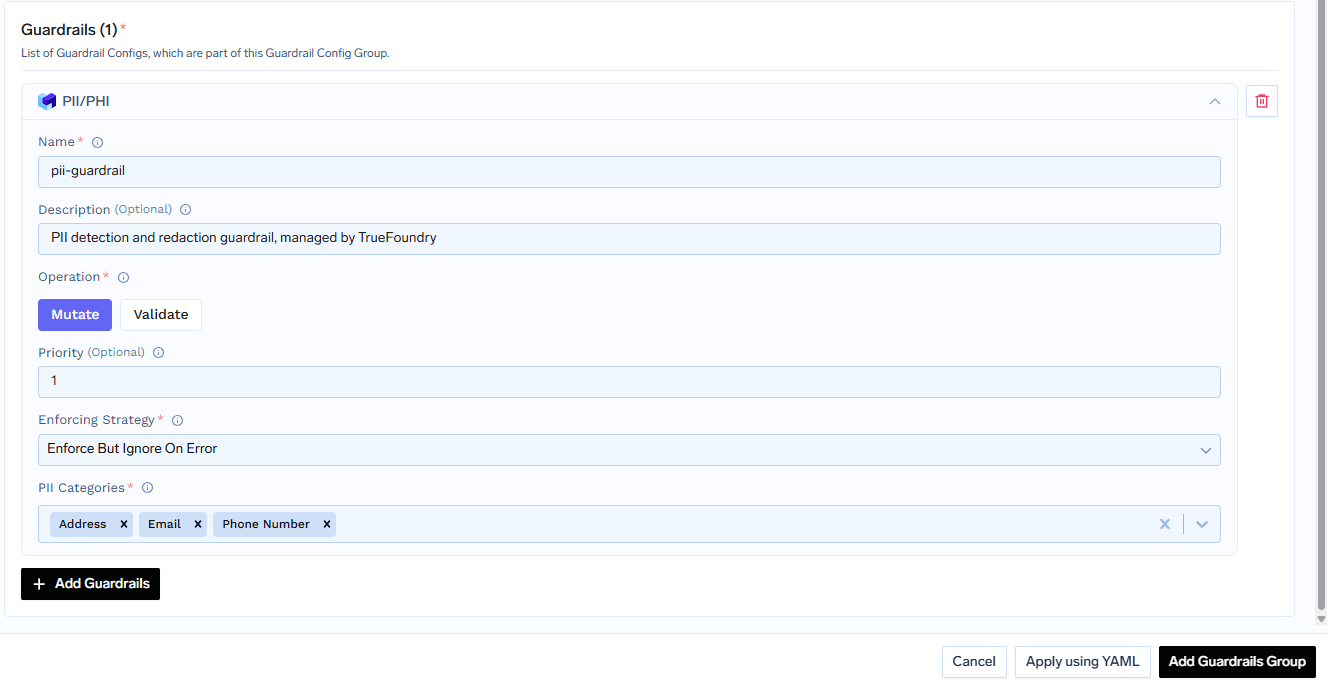
Ses options de stratégie d'application documentées sont uniquement enforce et enforce_but_ignore_on_error — audit n'est pas répertorié, contrairement à Secrets, Regex et SQL Sanitizer. Le déploiement progressif en commençant par Audit n'est pas uniforme sur tous les modules intégrés. [À VÉRIFIER] s'il s'agit d'une réelle restriction ou d'un manque dans la documentation.
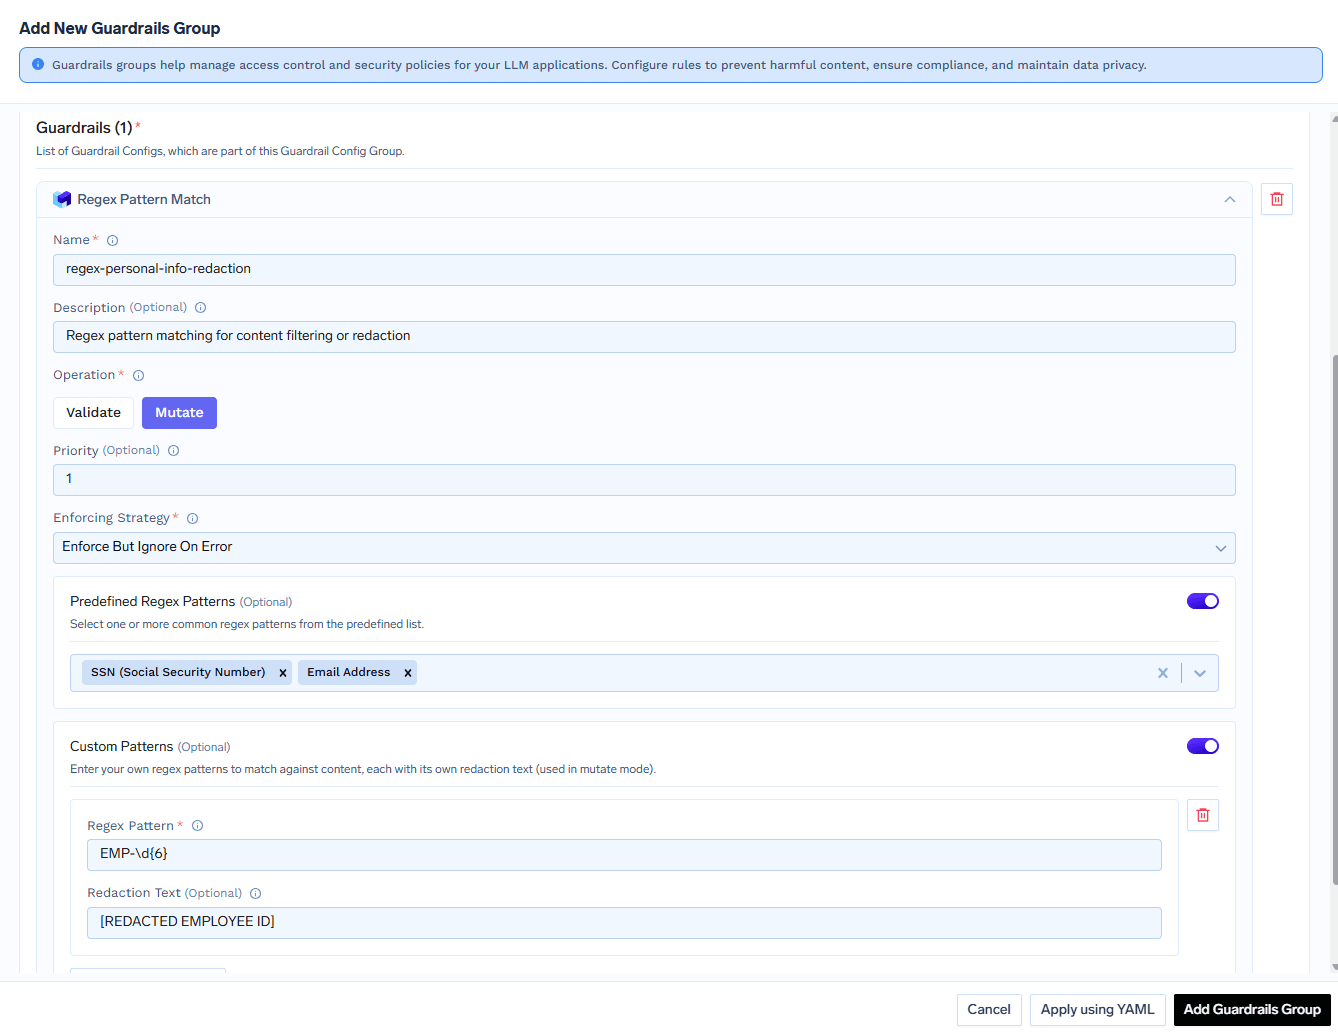
Le guardrail Regex Pattern Matching fournit des placeholders étiquetés plutôt que des astérisques. Il inclut 46 préconfigurations — numéros de sécurité sociale, cartes de crédit, passeports pour dix pays, clés cloud, jetons GitHub et Slack, adresses IP — ainsi que des motifs personnalisés, comme EMP-\d{6} → [REDACTED EMPLOYEE ID].
Parmi les intégrations de guardrails tiers, celles supportant le mode Mutate incluent Google Model Armor, CrowdStrike AIDR, F5 AI Security, TrojAI, Enkrypt AI, Pillar Security, Lasso (classifix), HiddenLayer (/redact-*), DeepKeep et Noma — les deux dernières exigeant le mode Mutate. Les intégrations exclusivement en Validate sont : Cisco AI Defense, Gray Swan Cygnal, Patronus, NVIDIA NeMo, Guardrails AI, Arthur AI. Demander du masquage à un fournisseur uniquement Validate est une impasse.
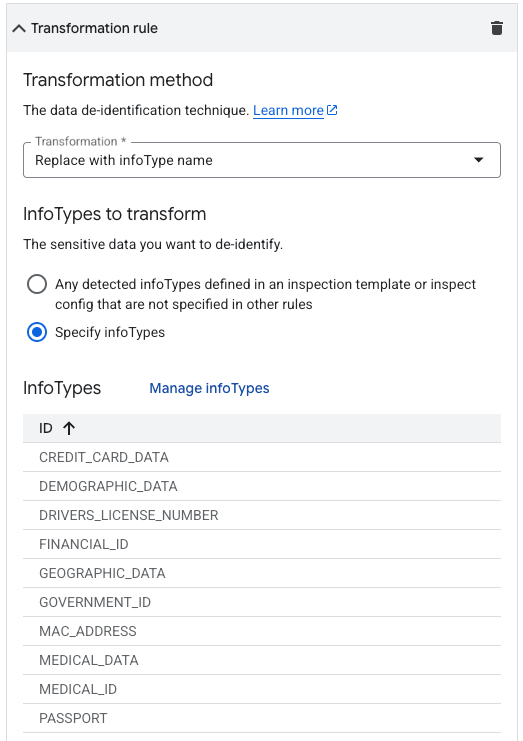
Google Model Armor présente une particularité de configuration : le mode Mutate nécessite à la fois un modèle d'inspection SDP et un modèle de dé-identification dans Google Cloud, reliés au modèle Model Armor, avec une transformation réglée sur « Replace with infoType name ». Sans ces deux éléments, le mode Mutate échoue.
Les guardrails de masquage natifs de TrueFoundry sont à sens unique. Le modèle voit la valeur masquée, tout comme l'appelant. PII / PHI Detection, Secrets Detection et Regex Pattern Matching ne proposent aucun moyen documenté de restaurer la valeur originale, et il n'y a pas de coffre-fort de jetons ou d'étape de réhydratation au niveau de la gateway dans la documentation à ce jour.
Il existe exactement un aller-retour documenté, et il repose sur une solution tierce. CrowdStrike AIDR gère le chiffrement préservant le format (FPE) : lorsque l'Operation est positionnée sur Mutate et que la phase d'entrée a chiffré les valeurs avec FPE, la gateway transmet le fpe_context résultant à AIDR lors de la phase de sortie sous le nom input_fpe_context et appelle POST {baseUrl}/v1/unredact, permettant l'utilisation des mêmes clés de bout en bout. C'est un vrai parcours réversible — mais il nécessite CrowdStrike, le mode Mutate et un fpe_context issu de la phase d'entrée.
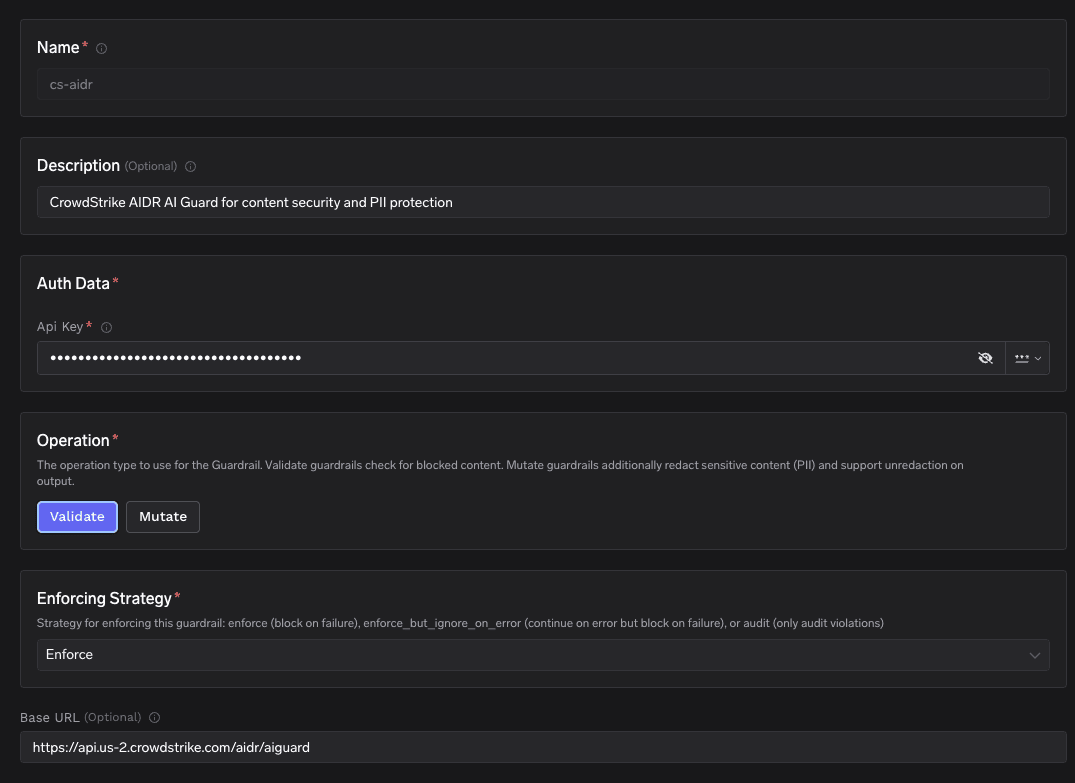
Si votre application a besoin de récupérer la valeur réelle, ne comptez pas sur la gateway pour le faire. Conservez-la dans votre application, transmettez la version masquée et réassociez les données via un identifiant que vous contrôlez. Un comportement lié d'AIDR prend souvent les utilisateurs au dépourvu : lorsqu'il lève une violation, Mutate ne la transforme pas en simple caviardage — la requête renvoie tout de même une erreur 400.
Un copilot de support analyse le texte de tickets d'assistance et interroge des données de comptes via un serveur MCP. Les tickets contiennent régulièrement des adresses e-mail de clients, des numéros de téléphone et des identifiants d'employés.
Déterminez ce qui ne doit jamais atteindre le fournisseur. E-mails et numéros de téléphone : masquer. Identifiants d'employés : masquer avec une étiquette, afin que le modèle puisse toujours différencier deux employés dans un même ticket. Identifiants collés par erreur : masquer également à la sortie.
Sélectionnez les modes et les priorités. PII / PHI Detection sur LLM Input, Mutate (son seul mode), priorité 1. Regex Pattern Matching sur LLM Input, Mutate, priorité 2, motif personnalisé EMP-\d{6} → [REDACTED EMPLOYEE ID]. Secrets Detection sur LLM Output, Mutate. Démarrez chaque guardrail avec la stratégie la plus souple disponible.
Définissez le parcours des outils avec précision. La recherche de compte nécessitant l'e-mail réel, la règle de masquage doit cibler le modèle, et non le serveur MCP. Secrets Detection s'exécute plutôt sur MCP Post-Invoke, permettant de intercepter des identifiants renvoyés dans le résultat d'un outil. Formalisez la raison : le serveur MCP est situé dans votre VPC, contrairement au fournisseur du modèle. Cette distinction constitue le contrôle réel.
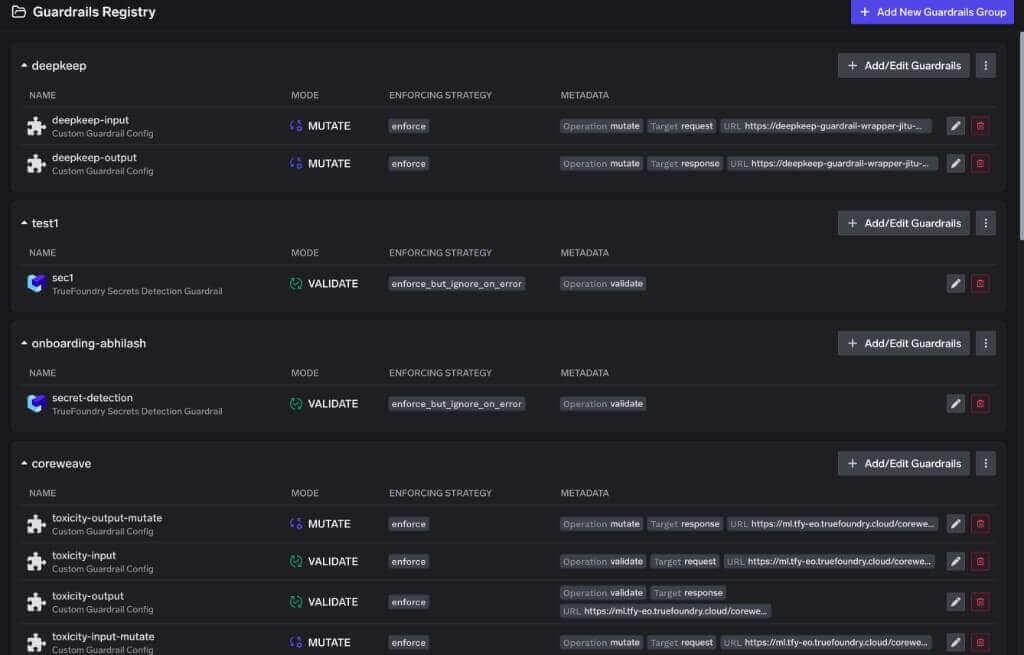
Associez le tout via une politique. Enregistrer un guardrail ne l'applique pas automatiquement au trafic. Rendez-vous dans AI Gateway → Policies → Guardrails → Add Rule et définissez le périmètre par cibles (modèles, serveurs MCP, optionnellement par outil), sujets (utilisateurs, équipes, comptes virtuels avec IN / NOT IN), métadonnées et hooks. Les règles correspondantes sont fusionnées par hook.
Surveillez avant de faire confiance. Chaque guardrail apparaît comme un span dédié dans Monitor → Request Traces, avec son temps d'exécution, son résultat, son périmètre, son entrée, sa sortie et ses mutations. Un taux de mutation proche de zéro sur un hook très sollicité indique des motifs incorrects ; un taux proche de 100 % signifie que vous allez rapidement constater l'impact du masquage sur la qualité des réponses.

Le masquage ne s'exécute pas sur les flux de réponse (streamed output). Les guardrails de sortie sont ignorés lorsque "stream": true, car l'évaluation d'une réponse nécessite le texte complet. Les guardrails d'entrée ne sont pas impactés. La plupart des interfaces de chat utilisant le streaming par défaut, le masquage côté sortie est inactif sur l'interface vue par les utilisateurs.
Les prompts système ne sont jamais masqués. La gateway les extrait avant d'envoyer le contenu aux guardrails, ils ne sont donc jamais inspectés, bloqués ou caviardés. La seule exception est CrowdStrike AIDR, qui accède au prompt système sans jamais le modifier. Placer une clé dans un prompt système annule l'effet des guardrails de masquage.
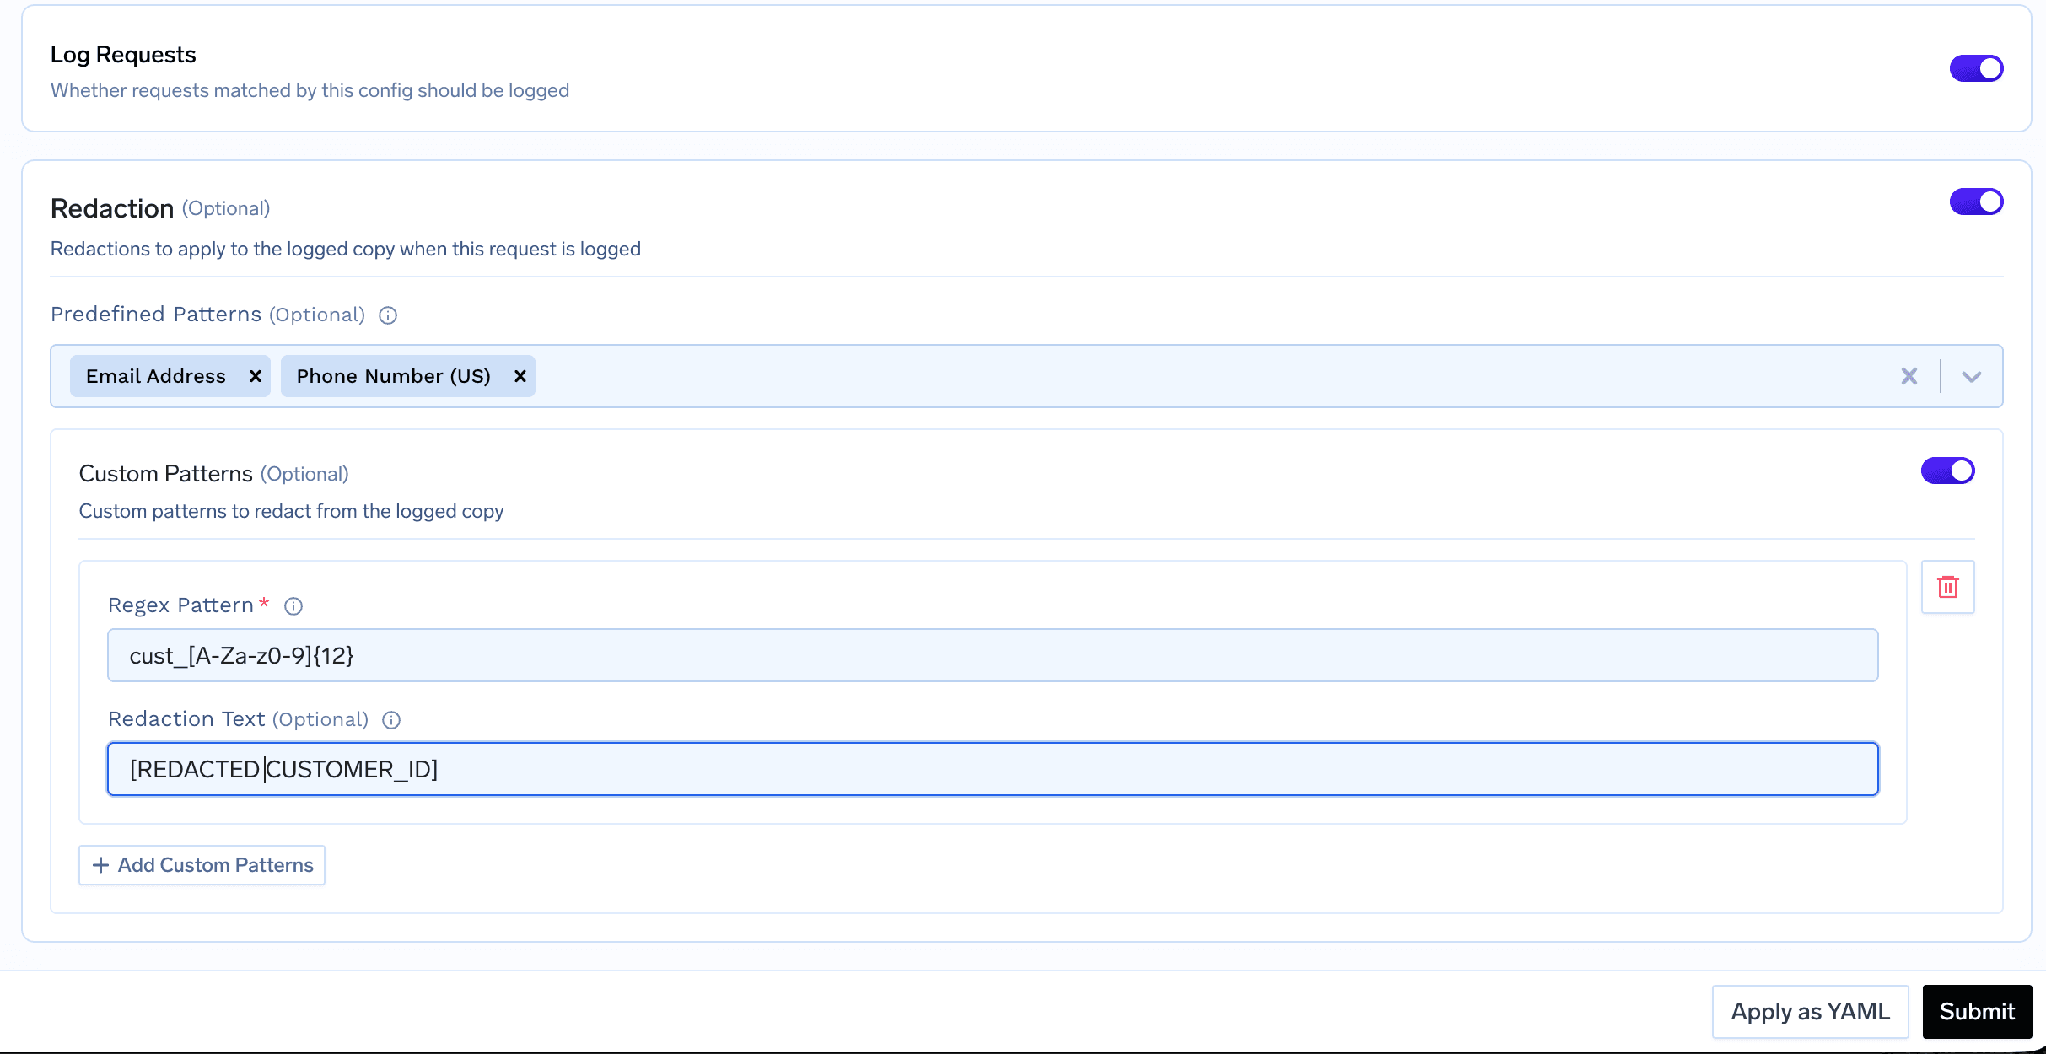
Le caviardage des journaux est un contrôle distinct de Mutate. La Logging Configuration basée sur des règles de TrueFoundry caviarde les motifs des corps stockés avec une logique où le refus l'emporte — une règle correspondante avec Log désactivé supprime entièrement le corps. Mais la documentation est explicite : « Redaction is applied only to the logged copy… The live request forwarded to the model provider is never modified. » Cela régit l'accès interne aux prompts au sein de votre entreprise, pas les données qui en sortent. Notre article complémentaire sur la prevention de la fuite de données pour le trafic LLM traite de la fuite d'informations (egress).
L'ordre d'exécution peut transformer un blocage en une autorisation. DeepKeep le documente concrètement : il applique la priorité du premier élément listé parmi les règles déclenchées, et non l'action la plus sévère. « Si PII est listé avant Adversarial, une tentative d'injection (jailbreak) déclenchant aussi PII sera caviardée et autorisée au lieu d'être bloquée. » Cela s'applique à toute chaîne de mutation — placez les règles devant bloquer avant celles qui masquent.
PII / PHI Detection est disponible uniquement en version hébergée par TrueFoundry. S'appuyant sur Azure AI Language, il n'est pas disponible sur les déploiements auto-hébergés ou hybrides (« Gateway Plane uniquement »). Utilisez Azure PII avec votre propre clé, ou CrowdStrike.
Le masquage des données est un bon mécanisme de contrôle, mais il est plus souvent mal appliqué que bien mis en œuvre. L'échec provient rarement du masqueur lui-même — il découle des hypothèses sous-jacentes : penser que le masquage est réversible, que le parcours des outils est couvert, que le caviardage des journaux équivaut à un filtrage, ou que le modèle raisonne aussi bien avec des astérisques.
Quatre décisions méritent d'être formalisées au préalable. Quelles entités ne doivent absolument pas sortir. Sur quels hooks s'exécute chaque règle. Si un composant en aval a besoin de la valeur initiale (cette réponse déterminant le choix entre masquage et tokenisation). Et quel impact sur la qualité de sortie vous acceptez, mesuré et non supposé.
Déployez ensuite progressivement : commencez en mode Audit là où le guardrail le permet, analysez une semaine de traces, passez en Enforce But Ignore On Error, puis appliquez Enforce strict sur les routes nécessitant un comportement fail-closed. La gateway est l'emplacement idéal pour cette gestion — l'unique point de passage de chaque modèle, équipe et agent. Mais une règle de masquage non observée en production est une règle dont vous ne maîtrisez pas l'impact.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




Remplacer les valeurs sensibles d'un prompt, d'une réponse ou de la charge utile d'un outil par un substitut, directement dans le chemin de la requête, avant que les données n'atteignent un fournisseur de modèles ou un outil externe. Dans TrueFoundry, c'est le mode de fonctionnement Mutate : le garde-fou réécrit les segments correspondants et la version réécrite poursuit son chemin. Les garde-fous Mutate s'exécutent par priorité, les valeurs les plus basses d'abord, et peuvent tout de même bloquer.
Le masquage remplace des caractères tout en conservant souvent le format — 4111-****-****-1234 garde la forme d'un numéro de carte — tandis que le caviardage supprime entièrement la valeur, en laissant généralement une étiquette comme [REDACTED SSN]. Les deux sont irréversibles. Fiez-vous aux exemples, pas au terme : le garde-fou PII de TrueFoundry produit des astérisques de même longueur, son garde-fou Regex des jetons étiquetés.
Pas par défaut. Les garde-fous PII, Secrets et Regex de TrueFoundry sont à sens unique : le modèle comme l'appelant voient la valeur masquée, et aucune étape de restauration n'est documentée. Le seul aller-retour documenté est le chiffrement préservant le format de CrowdStrike AIDR, où la passerelle transmet un fpe_context de l'étape d'entrée vers le point de terminaison /v1/unredact d'AIDR à l'étape de sortie. Si vous avez besoin de la valeur réelle en aval, conservez-la dans votre application.
Oui. TrueFoundry s'exécute dans votre VPC, on-premise, en environnement air-gapped ou en hybride, de sorte que les prompts et les réponses ne quittent jamais votre domaine, même lorsque vous routez vers de nombreux fournisseurs.
Oui. Il comprend une MCP Gateway, une Agent Gateway et un MCP & Agents Registry avec un contrôle d'accès au niveau des outils. Les agents construits avec LangGraph, CrewAI, AutoGen ou un framework maison peuvent tous être gouvernés de manière centralisée.
Oui. La passerelle est compatible OpenTelemetry et s'intègre à Grafana, Datadog, Prometheus, ou à votre pile technologique préférée. Elle trace chaque requête, du prompt à l'exécution de l'outil et du modèle, vous offrant ainsi une journalisation unifiée sans avoir à remplacer ce que vous utilisez déjà.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















