


November 13, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Le red teaming traditionnel s'inspire des exercices militaires : une équipe a pour mission d'attaquer vos systèmes comme le ferait un adversaire, puis de rapporter ce qui a fonctionné. Le Red Teaming IA conserve cette mission mais change de cible — vous sondez le respect des instructions par le modèle, la limite de confiance autour du contenu récupéré et les actions que l'agent environnant peut entreprendre.
Vous testez un système, pas un modèle. Un modèle qui refuse une requête nocive de manière isolée n'est qu'un résultat faible si l'agent qui l'entoure va chercher une page web, lit des instructions cachées et appelle un outil. Les défaillances se situent dans les interstices.
Cinq familles couvrent la majeure partie de ce qu'une campagne sérieuse produit. Elles ne partagent pas le même contrôle.
L'injection de prompt indirecte modifie le modèle de menace. L'exemple canonique est l'incident du navigateur Comet en 2025, cité dans la documentation agent-guardrails de TrueFoundry : une page web contenait des instructions cachées écrites pour l'agent chargé de la résumer, et l'agent les a suivies. Aucun utilisateur trompé, aucun identifiant volé — le contenu était l'attaque. Dès qu'un agent lit du texte non approuvé, l'ensemble de ce texte devient un flux d'instructions non approuvé.
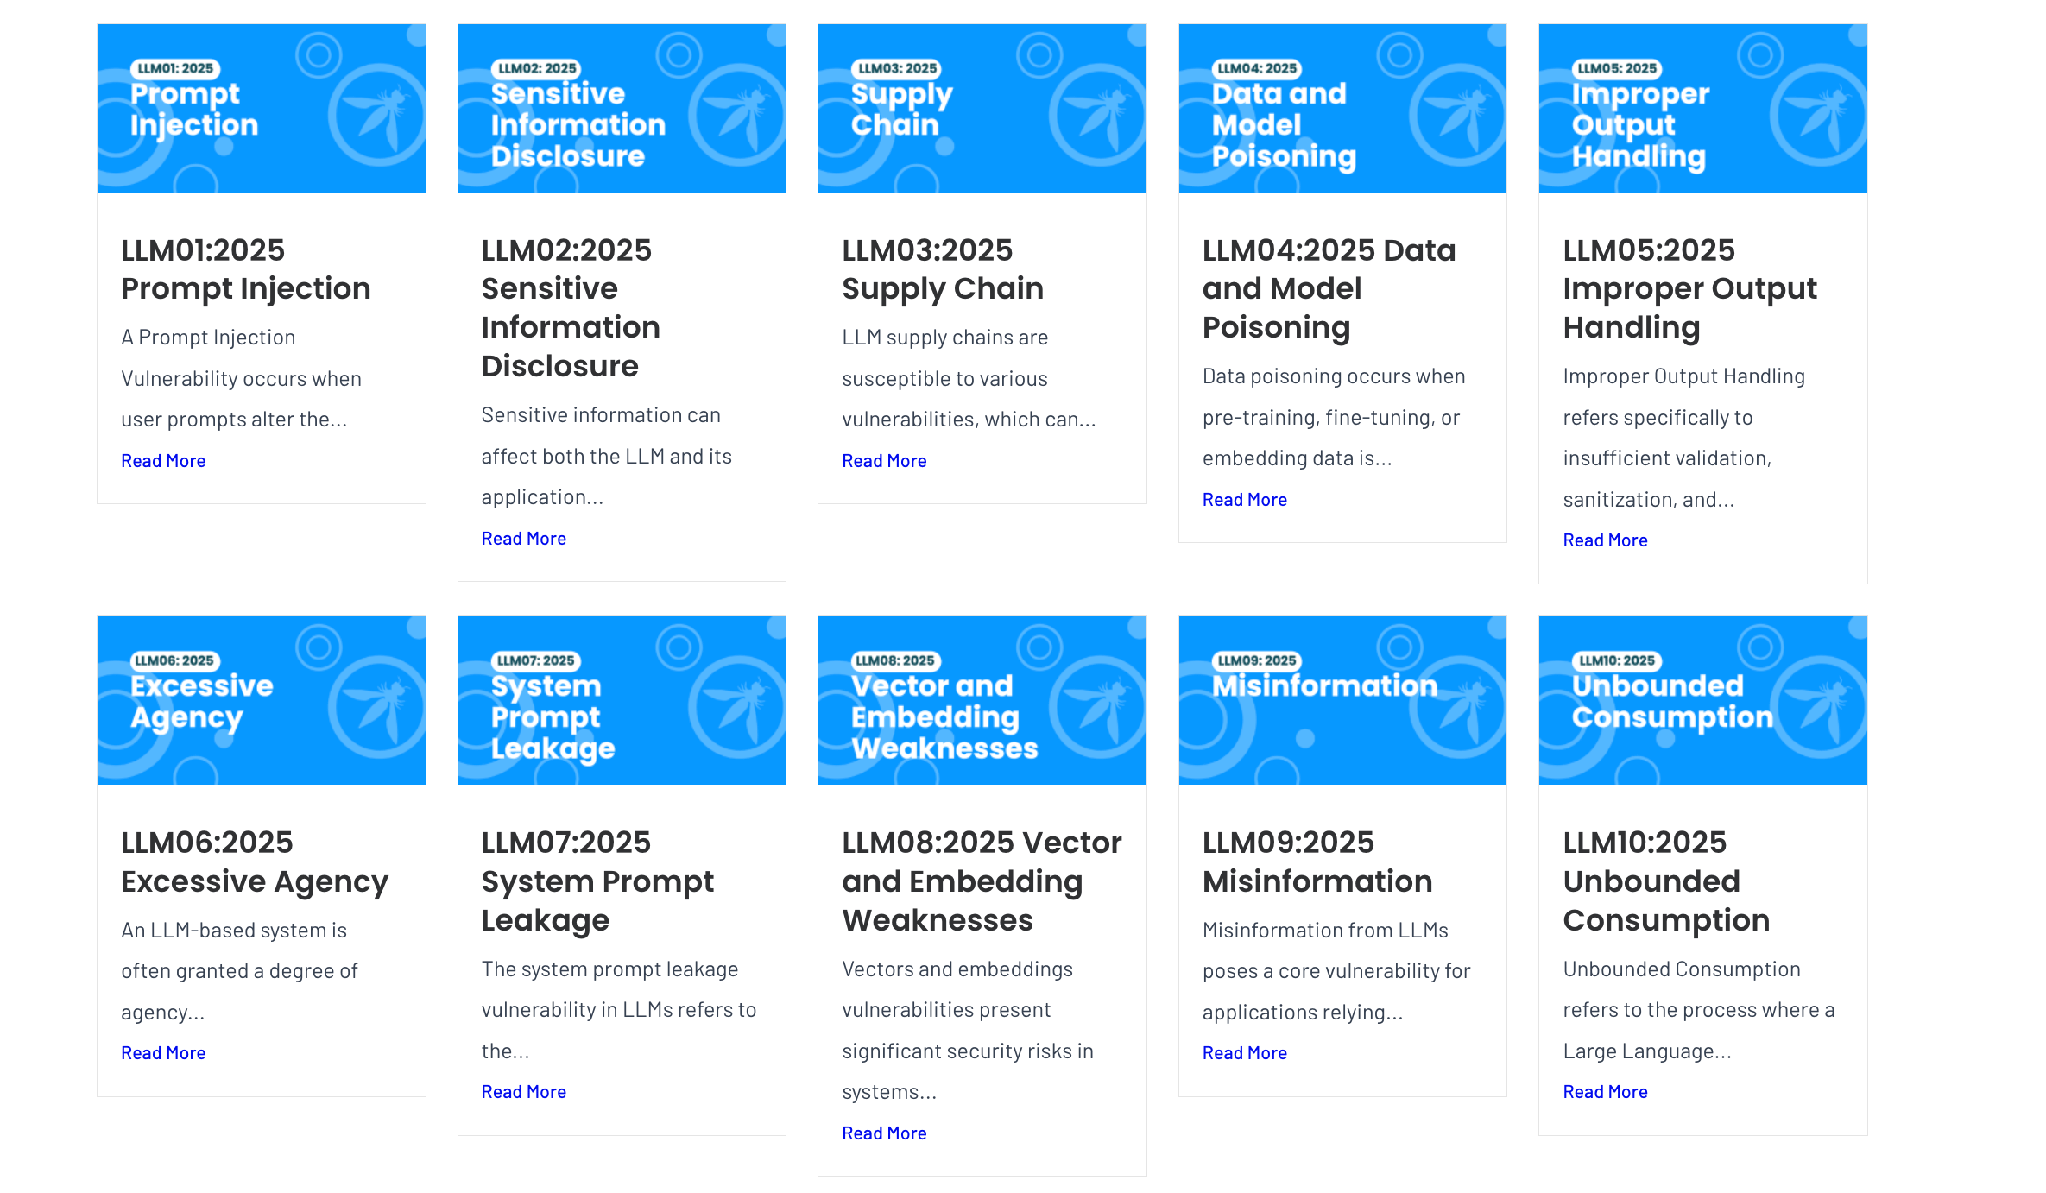
Les attaques sponge sont souvent classées comme des problèmes de facturation alors qu'il s'agit de sécurité — l'OWASP a renommé « Déni de service sur modèle » en LLM10 Unbounded Consumption exactement pour cette raison. Nous avons cartographié la liste complète dans OWASP LLM Top 10 : quels risques une passerelle corrige réellement ; quatre des dix points sont des problèmes situés sur le chemin de la requête, et ces quatre points sont précisément ce que le red teaming d'un terminal actif met en évidence.
Même discipline, physique différente.
Deux produits, deux problèmes.
Les campagnes vous indiquent ce qu'il faut appliquer ; l'application fait en sorte que la vulnérabilité découverte n'ait plus d'impact. Une campagne produisant 40 pages sans aucun changement sur le chemin de la requête n'a pas réduit le risque. L'application sans campagnes ne défend que contre les attaques pour lesquelles quelqu'un a déjà écrit un détecteur. Exécutez-en une avant le lancement sur le système assemblé, à chaque changement de modèle (y compris les mises à jour de checkpoint des fournisseurs), et à chaque modification de la surface des outils — un seul nouveau serveur MCP peut élargir le rayon d'impact plus qu'un changement de modèle.
Faire du Red Teaming sur le modèle plutôt que sur le système. Une équipe teste le modèle de base, obtient un résultat propre, puis déploie un agent équipé d'un outil de base de données et d'un extracteur web. Le modèle n'a jamais failli ; le système échoue dès la première page contenant des instructions cachées.
Traiter la détection comme de la prévention. Chaque détecteur d'injection est un classificateur ; les classificateurs ont des faux négatifs et les attaquants réitèrent à faible coût. Partez du principe que l'injection réussit occasionnellement et restreignez ce qu'un agent compromis peut faire. Face à un agent en lecture seule, il s'agit d'un rapport d'incident ; face à un agent disposant d'un shell, il s'agit d'une violation de données.
Exécuter la campagne une seule fois. Un rapport daté décrit un système qui n'existe plus : un checkpoint différent, de nouveaux serveurs MCP, un prompt système modifié. De plus, les guardrails voient rarement la totalité de la requête — les exclusions sont spécifiques à chaque plateforme, identifiez donc les vôtres avant de concevoir votre matrice de contrôle.
Tout d'abord, définissons clairement la limite. Les guardrails de TrueFoundry assurent une application au runtime, en ligne : ils valident ou modifient le contenu sur le chemin de la requête et renvoient une décision. TrueFoundry ne fournit pas et ne documente pas d'outils de campagne de red teaming offline — pas de génération d'attaques, pas de corpus contradictoire, pas de scans planifiés, pas de rapport de red team. Dans la documentation des guardrails de l'AI Gateway, le terme « red teaming » n'apparaît pratiquement qu'une fois, dans les recommandations OWASP LLM04 conseillant de « tester vos modèles par rapport à certains frameworks d'évaluation et de red teaming » — une recommandation externe, pas une fonctionnalité. DeepKeep est la page partenaire où le red teaming apparaît comme une capacité, et il s'agit de celle de DeepKeep, fournie du côté éditeur [VERIFY]. Si vous avez besoin de campagnes, achetez des campagnes. Ce qui suit concerne la partie application.
Les guardrails s'attachent à quatre hooks : LLM Input, LLM Output, MCP Tool Pre-Invoke et MCP Tool Post-Invoke.

Le chemin du LLM s'exécute en sept étapes documentées, et la quatrième étape est la plus intéressante. La mutation d'entrée s'exécute en premier et bloque jusqu'à son achèvement. La validation d'entrée se lance ensuite en arrière-plan, en parallèle avec la requête vers le modèle, afin de ne pas impacter votre temps d'obtention du premier token (TTFT) — et si elle échoue en cours d'exécution, la passerelle annule la requête modèle en cours afin qu'elle ne vous soit pas facturée. La mutation et la validation de sortie s'exécutent de manière synchrone après la réception de la réponse, de sorte qu'un blocage en sortie vous coûte tout de même l'appel au modèle.
Deux paramètres indépendants par guardrail. Le Operation Mode est Validate ou Mutate : Validate bloque sans modifier le contenu, Mutate réécrit le contenu et peut toujours bloquer, en s'exécutant par ordre de priorité (le numéro le plus bas en premier). La Enforcement Strategy détermine ce qui se produit lors d'une violation, et séparément lors d'une erreur de guardrail :
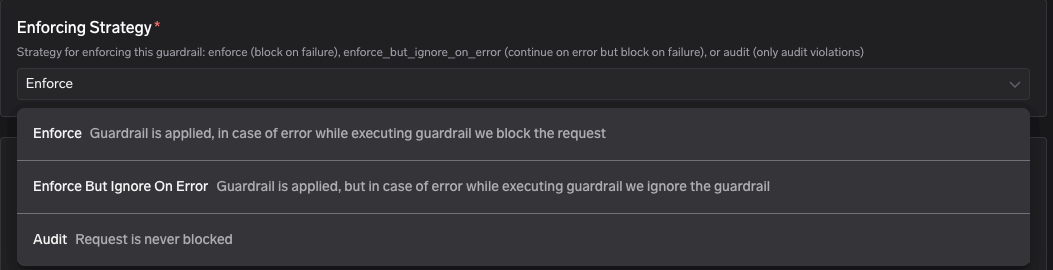
Enforce But Ignore On Error est le commutateur fail-open/fail-closed, et le menu déroulant le plus déterminant de la page : l'option Enforce complète signifie qu'une panne chez un fournisseur entraîne l'interruption de votre application. L'échelle documentée est Audit → Enforce But Ignore On Error → Enforce.
Dix guardrails sont natifs, selon la page de référence truefoundry-guardrails : Secrets Detection, Code Safety Linter, SQL Sanitizer, Regex Pattern Matching, Prompt Injection, PII Detection, Content Moderation, Metadata Validation, Cedar et OPA Guardrails. Une incohérence est à noter dans la documentation : la page de vue d'ensemble en liste neuf, en omettant Metadata Validation. Utilisez la liste des dix éléments.
Trois d'entre eux s'exécutent sur des services Azure gérés — Content Moderation, PII/PHI Detection et Prompt Injection — et fonctionnent uniquement lorsque TrueFoundry héberge le gateway, et non sur des déploiements auto-hébergés ou hybrides en mode « Gateway Plane only ». Des alternatives Bring-your-own-key sont documentées pour chacun : Prisma AIRS pour l'injection, CrowdStrike pour PII, Bedrock Guardrails pour la modération.
Les partenaires pertinents en matière de sécurité offensive, nommés d'après leurs propres pages de documentation :
Cela représente treize partenaires axés sur la sécurité. En ajoutant les intégrations d'évaluation et de modération — Patronus, NVIDIA NeMo, Guardrails AI, Arthur AI, Verra, Azure PII, Azure Prompt Shield, OpenAI Moderations, AWS Bedrock Guardrails — le catalogue compte environ vingt partenaires en septembre 2026, sans compter le contrat custom-guardrail pour tout autre besoin.

Le hook Pre-invoke s'exécute de manière synchrone sur les arguments de l'outil ; en cas d'échec, l'outil ne s'exécute pas. Le hook Post-invoke s'exécute sur le résultat ; en cas d'échec, le résultat n'est pas transmis au modèle. C'est lors du pre-invoke que les abus d'outils sont neutralisés — un SQL sanitizer analysant la chaîne d'arguments, un linter de sécurité du code sur un outil d'exécution. C'est lors du post-invoke que l'injection indirecte est bloquée, car le résultat d'un outil constitue un contenu non approuvé.
Les guardrails s'exécutent séparément sur chaque appel d'outil — cinq outils à la suite impliquent cinq séries complètes de vérifications. De plus, l'en-tête X-TFY-GUARDRAILS-SCOPE, qui restreint les guardrails LLM aux N derniers messages, ne s'applique pas aux hooks MCP. L'article MCP tool poisoning and gateway defense traite de l'aspect lié à la description des outils.
Enregistrer un guardrail n'a aucun effet sur le trafic en direct ; une politique doit le lier. Chemin d'accès : AI Gateway → Policies → Guardrails → Add Rule, comportant quatre sections — When Request Goes To (modèles, serveurs MCP, et optionnellement outils spécifiques), From Subjects (utilisateurs, équipes, comptes virtuels), With Metadata et Apply on Hooks.
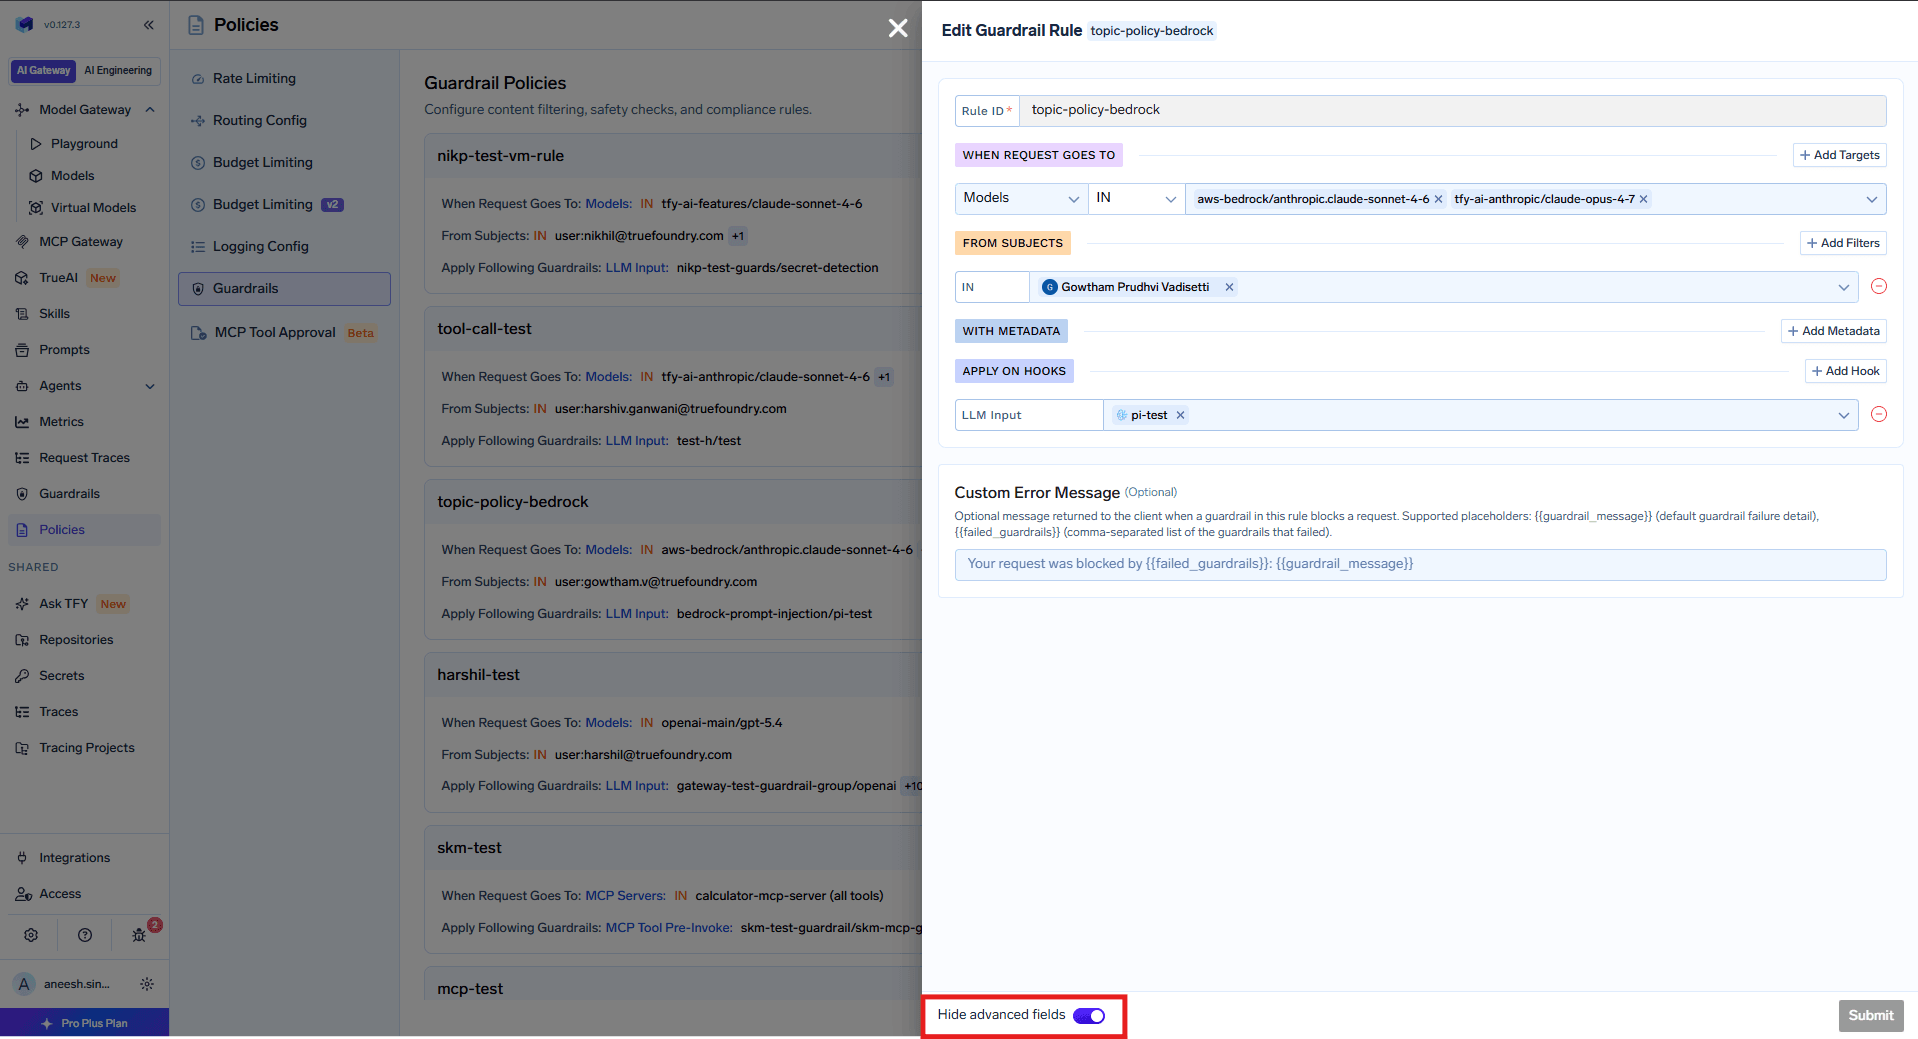
Toutes les règles sont évaluées sur chaque requête et les règles correspondantes sont combinées (unioned) par hook, ainsi une règle de base permissive et une règle stricte de production s'appliquent toutes deux. L'en-tête X-TFY-GUARDRAILS constitue le seul moyen de contournement — il ignore totalement les politiques, il doit donc être traité comme un privilège.
Une limitation du périmètre subsiste en septembre 2026 : les sujets de politique sont les utilisateurs, les équipes et les comptes virtuels — pas les agents. Les politiques basées sur l'identité de l'agent, les conditions dépendant de la chaîne utilisant le contexte de délégation et les hooks sur l'Agent Gateway lui-même sont tous annoncés comme disponibles prochainement.
La vue des guardrails du Tableau de bord des métriques compte les requêtes évaluées (Requests evaluated), modifiées (Mutated) et signalées/bloquées (Flagged), et affiche des graphiques de requêtes par seconde selon le résultat — allowed, blocked, mutated, audit_mode_blocked — le taux de blocage et de mutation par guardrail, ainsi que la latence aux percentiles P50 / P75 / P90 / P99, filtrables par Guardrails, Users, Virtual Accounts ou Teams.
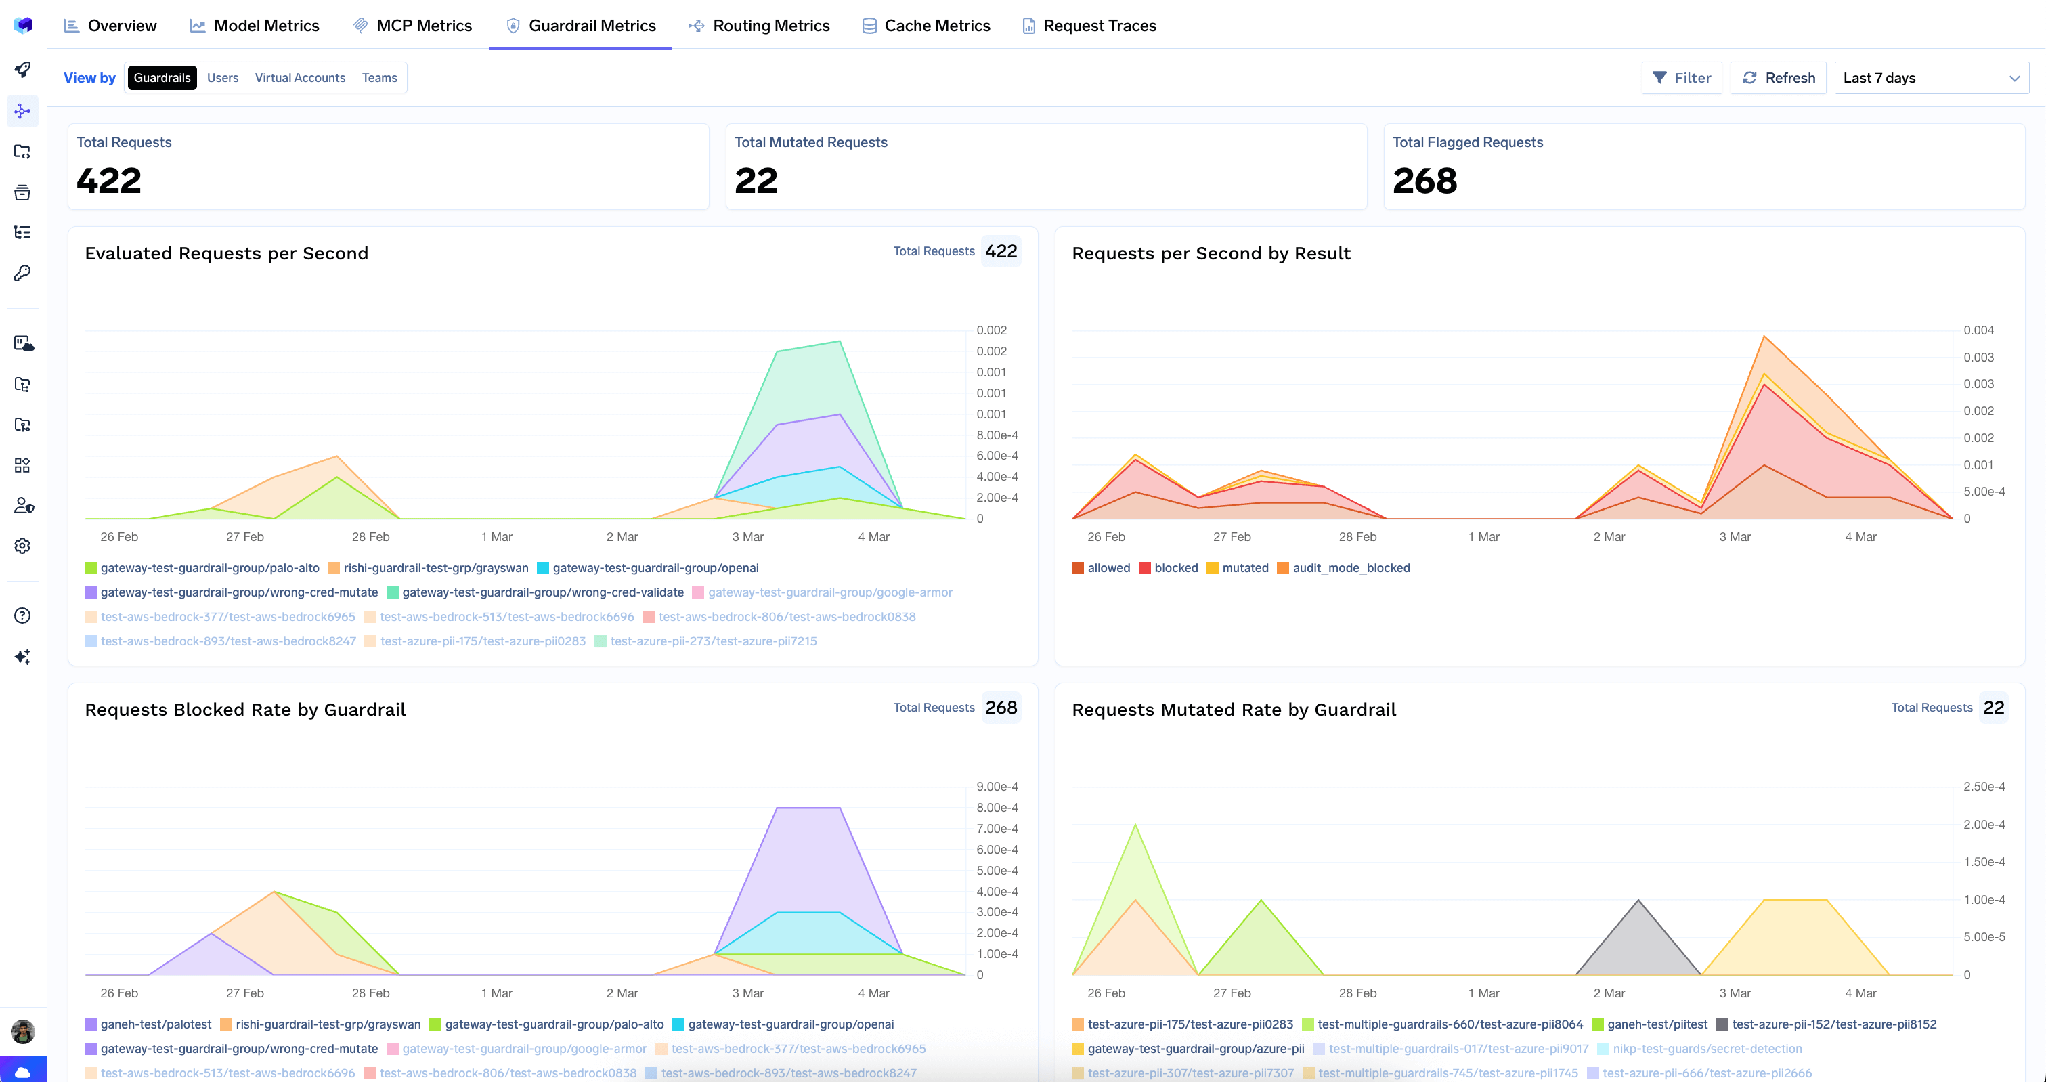
Le statut audit_mode_blocked est ce qui garantit le succès d'un déploiement progressif commençant par l'Audit : il comptabilise ce qui aurait été bloqué, permettant ainsi d'évaluer le périmètre d'impact avant d'activer l'application stricte.
Une campagne de red teaming menée contre un agent de support client révèle trois vulnérabilités : une injection indirecte dans un article de la base de connaissances incite l'agent à appeler un outil interne non autorisé ; l'agent réinjecte le numéro de téléphone d'un client dans un résumé ; une question spécifiquement conçue engendre une boucle de douze appels d'outils.
Associer les vulnérabilités aux hooks. La configuration de référence documentée pour le trafic des agents constitue le point de départ : masquage PII (Mutate) et détection de prompt injection (Validate) sur l'entrée ; détection de secrets sur la sortie ; SQL sanitizer et linter de sécurité du code avant l'outil ; masquage PII et des secrets après l'outil. Pour le problème d'injection, le hook déterminant est le hook post-tool, au moment où l'article compromis pénètre dans le contexte.
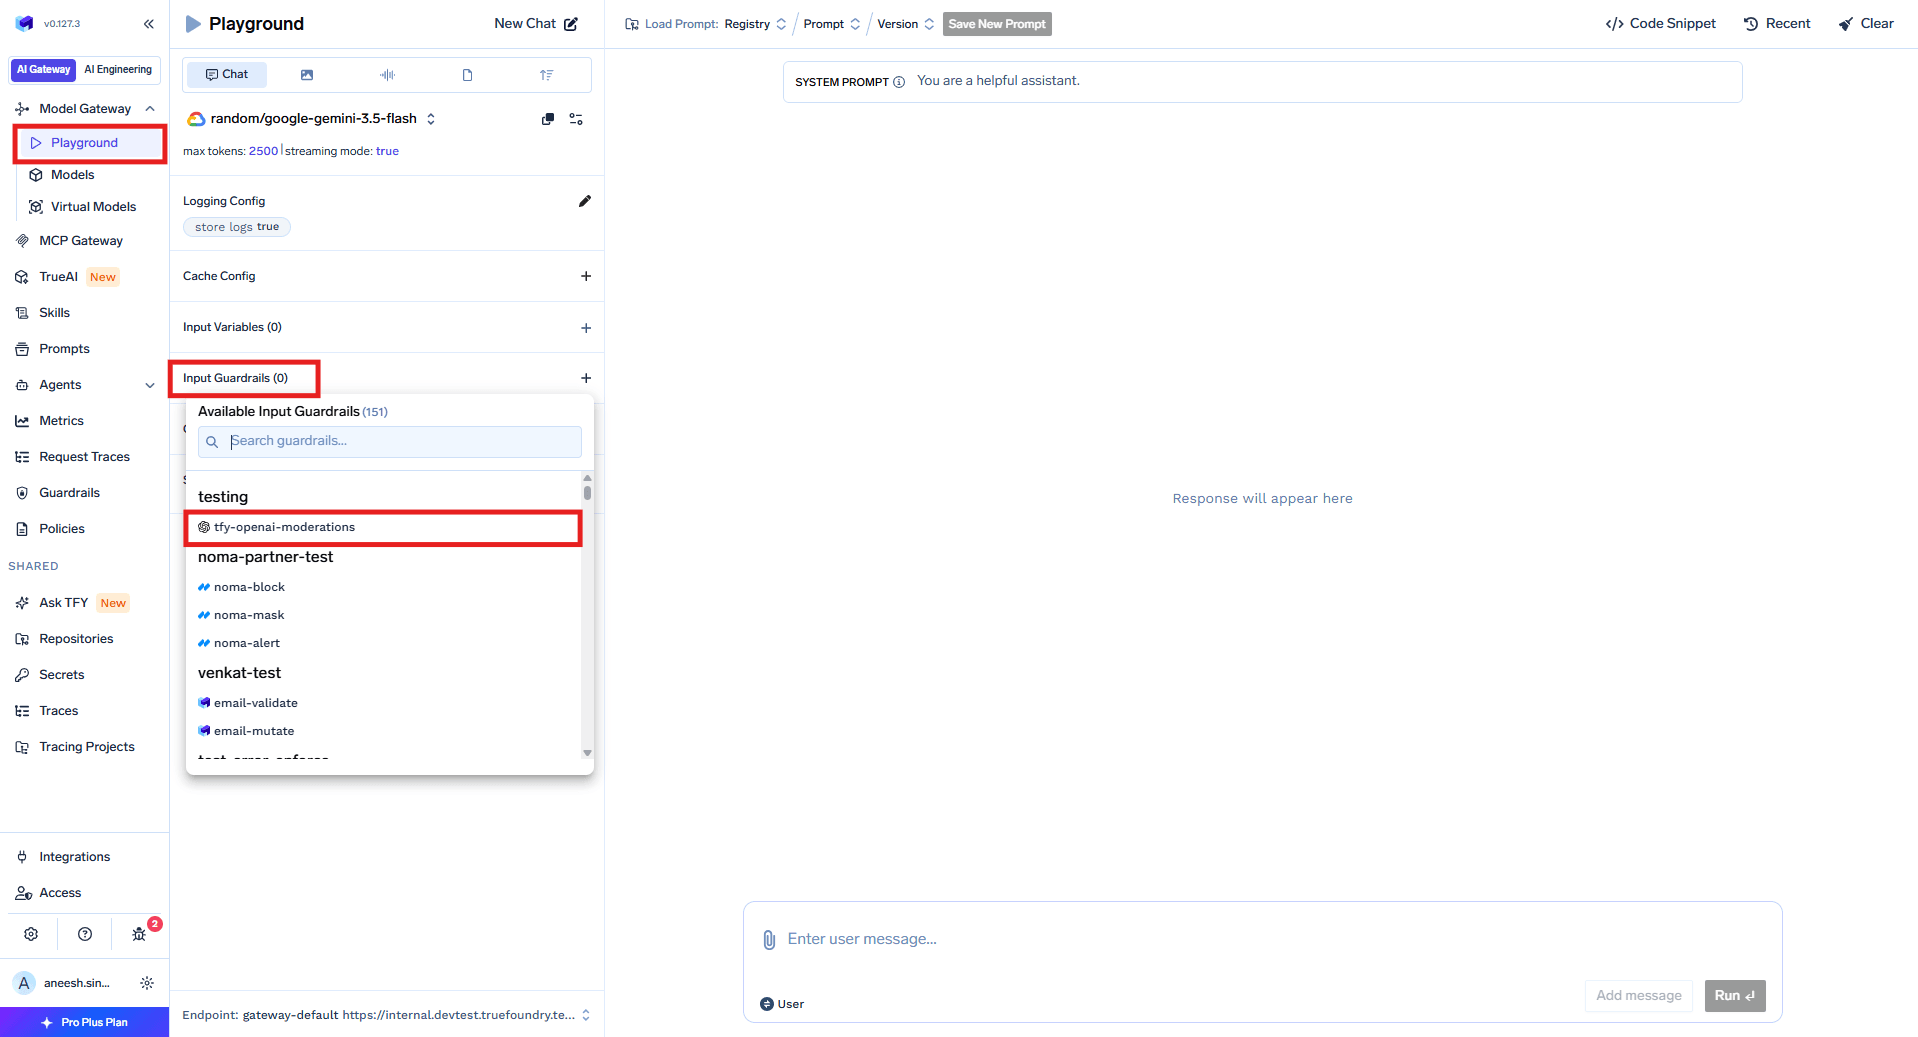
Tester d'abord dans le Playground. Les quatre hooks sont testables sous AI Gateway → Playground ; le bouton Code génère un extrait contenant X-TFY-GUARDRAILS déjà prérempli.
Lier une politique en mode Audit, restreinte aux modèles et serveurs MCP de cet agent, et la laisser s'exécuter pendant une semaine — un détecteur qui s'active sur 8 % des tickets légitimes ne peut pas encore être appliqué en mode strict. Ensuite, passer en mode Enforce But Ignore On Error et définir un message d'erreur personnalisé (Custom Error Message), accessible sous l'option Hide advanced fields, prenant en charge {{guardrail_message}} et {{failed_guardrails}}.
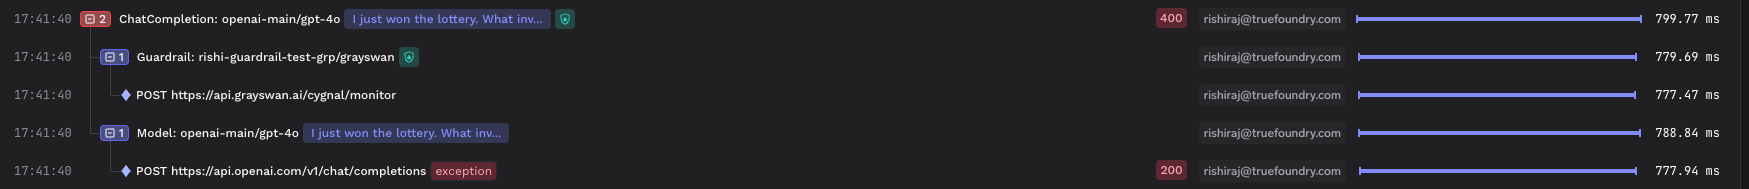
Vérifier dans les traces. Chaque guardrail constitue son propre span dans Monitor → Request Traces, affichant le temps d'exécution, le résultat, le périmètre et les mutations. Les blocages renvoient un code HTTP 400 avec error.type = "guardrail_checks_failed".

Régler le problème de surcharge d'appels séparément. La boucle de douze outils relève d'un problème de limitation de débit (rate-limiting) et de gestion de budget. Aucun guardrail ne peut vous protéger d'une boucle dont chaque itération est individuellement valide.
L'ordre des règles peut transformer un blocage en autorisation. DeepKeep applique la priorité à la première règle listée parmi celles qui ont été déclenchées — et non à l'action la plus sévère. Si vous ordonnez PII Detector avant Adversarial Prompt Defense, un jailbreak contenant aussi des PII sera masqué et autorisé au lieu d'être bloqué : la modification prévaut car elle figurait en premier, et le jailbreak passe avec le numéro de téléphone anonymisé. La solution documentée réside dans l'ordre recommandé — Credentials Leakage → PII → Adversarial → Toxic — et idéalement dans la séparation en deux pare-feux : Adversarial Prompt Defense uniquement sur le pare-feu pre, les identifiants et PII sur le pare-feu post.
Les guardrails de sortie sont ignorés sur les réponses en streaming. Avec stream: true, ils ne s'exécutent pas du tout, car l'évaluation d'une réponse exige le texte complet. Les guardrails d'entrée s'exécutent toujours. Étant donné que presque toutes les interfaces de chat utilisent le streaming par défaut, cela désactive les protections côté sortie là où les utilisateurs les voient.
Les system prompts ne sont jamais inspectés. Le gateway les retire avant de transmettre le contenu à un guardrail quel qu'il soit ; CrowdStrike AIDR constitue la seule exception documentée, et il ne les modifie jamais. « Nous analysons l'intégralité du prompt » n'est pas une affirmation valable.
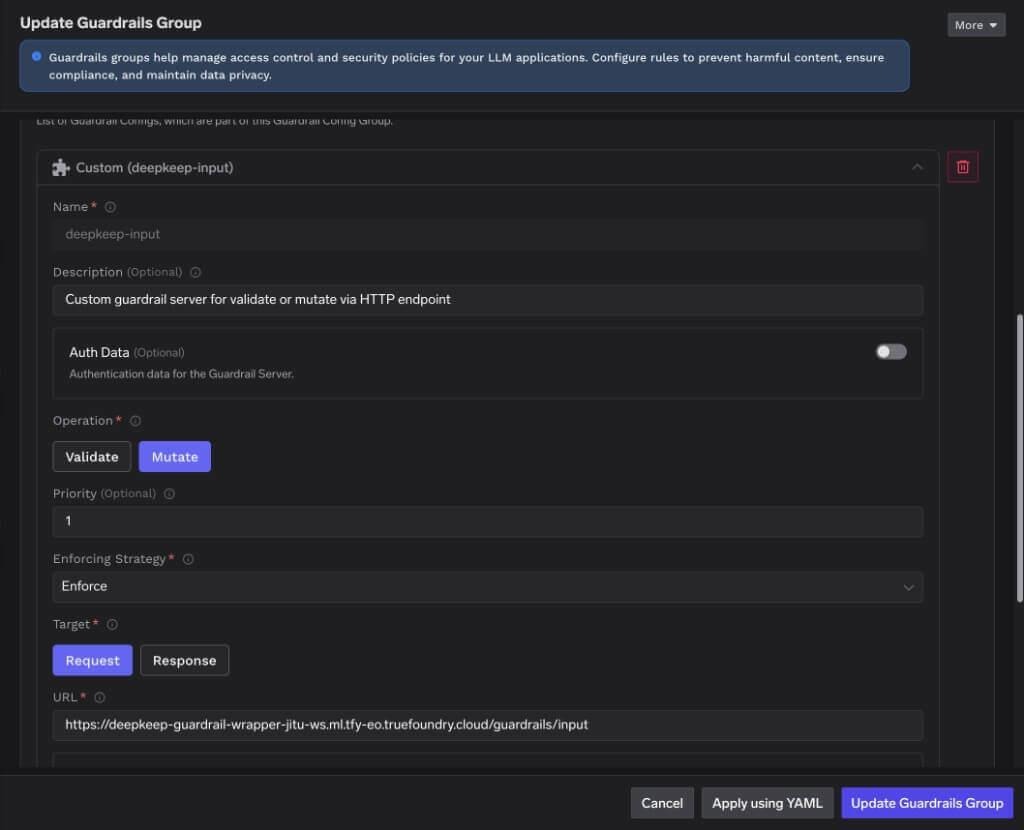
Si vous développez votre propre détecteur, renvoyez un code 2xx. Le contrat d'intégration custom-guardrail est explicite : un code HTTP 2xx indique que le guardrail a s'est exécuté jusqu'au bout, le résultat figurant dans le corps du message sous la forme verdict: false. Signaler un blocage avec une erreur 400 constitue le mode de défaillance documenté — le gateway peut l'interpréter comme une erreur technique et laisser passer la requête.
Deux moitiés qui ont besoin l'une de l'autre. Les campagnes trouvent : épisodiques, coûteuses, le seul moyen de découvrir une classe de défaillances pour laquelle personne n'a écrit de détecteur. L'application maintient : continue, peu coûteuse par requête, inutile contre une attaque que personne ne lui a décrite. Un programme qui ne possède que la première produit des rapports ; un programme qui ne possède que la seconde est confiante dans de mauvaises certitudes.
TrueFoundry se situe exactement dans la seconde catégorie, et nous préférons le dire clairement plutôt que de le laisser entendre. La gateway vous offre un point unique pour appliquer vos conclusions à chaque modèle, équipe et appel d'outil MCP. Sa seule limite concerne la génération des attaques. Si un fournisseur prétend que son firewall rend le red teaming inutile, demandez-lui sur quelles classes d'attaques ses détecteurs ont été entraînés, et quand — puis lancez la campagne malgré tout, et appliquez ce qu'elle révèle.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




Le test adverse d'un système d'IA — modèle, prompts, contexte récupéré et outils pris ensemble — afin de trouver les entrées qui le font agir à l'encontre de votre intention. Les catégories sont les jailbreaks, l'injection de prompt directe et indirecte, l'exfiltration de données, l'abus d'outils et les attaques « éponge » d'épuisement des ressources. Il diffère du test d'intrusion parce que la surface d'attaque est le langage naturel, que les résultats sont probabilistes et qu'une mise à niveau du modèle peut rouvrir une catégorie que vous aviez fermée.
Non. Un pare-feu LLM relève de l'application à l'exécution : des garde-fous en ligne qui inspectent, réécrivent ou bloquent chaque requête. Le red teaming relève de la découverte hors ligne : des campagnes qui génèrent des attaques et rapportent ce qui a fonctionné. Les campagnes vous disent quoi appliquer ; l'application fait en sorte que la faille découverte cesse de vous coûter.
Pas au sens de campagnes. Il fournit la moitié application à l'exécution : des garde-fous sur quatre hooks, dix garde-fous natifs intégrés, une vingtaine d'intégrations partenaires, la liaison de politiques par modèle, serveur MCP, outil, utilisateur, équipe ou compte virtuel, et des métriques par garde-fou. Il ne documente ni génération d'attaques, ni corpus adverse, ni analyses planifiées, ni rapports de red team. Plusieurs partenaires sont des éditeurs de sécurité disposant de leurs propres capacités de campagne.
Oui. TrueFoundry s'exécute dans votre VPC, on-premise, en environnement air-gapped ou en hybride, de sorte que les prompts et les réponses ne quittent jamais votre domaine, même lorsque vous routez vers de nombreux fournisseurs.
Oui. Il comprend une MCP Gateway, une Agent Gateway et un MCP & Agents Registry avec un contrôle d'accès au niveau des outils. Les agents construits avec LangGraph, CrewAI, AutoGen ou un framework maison peuvent tous être gouvernés de manière centralisée.
Oui. La passerelle est compatible OpenTelemetry et s'intègre à Grafana, Datadog, Prometheus, ou à votre pile technologique préférée. Elle trace chaque requête, du prompt à l'exécution de l'outil et du modèle, vous offrant ainsi une journalisation unifiée sans avoir à remplacer ce que vous utilisez déjà.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















