



November 14, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Toutes les autres charges de travail IA s'exécutent sur une infrastructure qui vous appartient — votre cluster, votre politique réseau, un identifiant que vous pouvez renouveler. Codex est un processus CLI sur l'ordinateur portable d'un développeur qui lit un fichier TOML dans son répertoire personnel et communique directement avec un fournisseur de modèles. Cinq propriétés en font une classe de problème différente :
Le réflexe habituel est de rédiger un document de politique. Il échoue pour une raison simple : tout ce qu'il demande réside dans un fichier que le développeur peut modifier.
Quatre propriétés doivent être vérifiées sur chaque requête :
Une passerelle vous offre ces quatre éléments — mais seulement si le client pointe vers elle et continue de pointer vers elle. Il existe trois postures pour cela, et une seule constitue une application réelle :
Verrouiller le fichier sans renouveler le jeton traite les altérations mais ignore le vol d'identifiants ; renouveler sans verrouiller fait l'inverse. Vous avez besoin des deux.
Considérer le compte du fournisseur de modèles comme le point de contrôle. L'identité, le SSO, l'appartenance à l'espace de travail et les politiques de la console d'administration pour Codex résident dans la console d'OpenAI, pas dans votre passerelle — tout comme la rétention des invites et des résultats, qui « est régie par votre accord avec OpenAI ». Une passerelle contrôle le routage, les dépenses, les garde-fous et sa propre journalisation, pas votre contrat fournisseur.
Supposer qu'un déploiement MDM unique équivaut à une application permanente. Les clients modifient la priorité des configurations entre les versions. Codex v0.149.0 a totalement abandonné managed_config.toml sur Windows — il ignore désormais le fichier avec un avertissement au démarrage (Ignoring deprecated managed config file), sans équivalent dans le registre. Une flotte configurée avant cette version n'est pas appliquée et ne signale aucune erreur.
Fournir une clé API partagée. C'est le moyen le plus rapide de faire travailler trente développeurs, et cela détruit tous les contrôles en aval simultanément. Vous ne pouvez pas limiter le débit d'une personne ni répondre à la question « qui a envoyé cette invite » à partir d'un identifiant à l'échelle du tenant.
Codex traite la TrueFoundry AI Gateway comme un fournisseur de modèles ; tout le reste découle de l'arrivée du trafic dans un endroit que vous contrôlez. Les détails de la passerelle proviennent de l'extrait de code dans l'interface utilisateur.
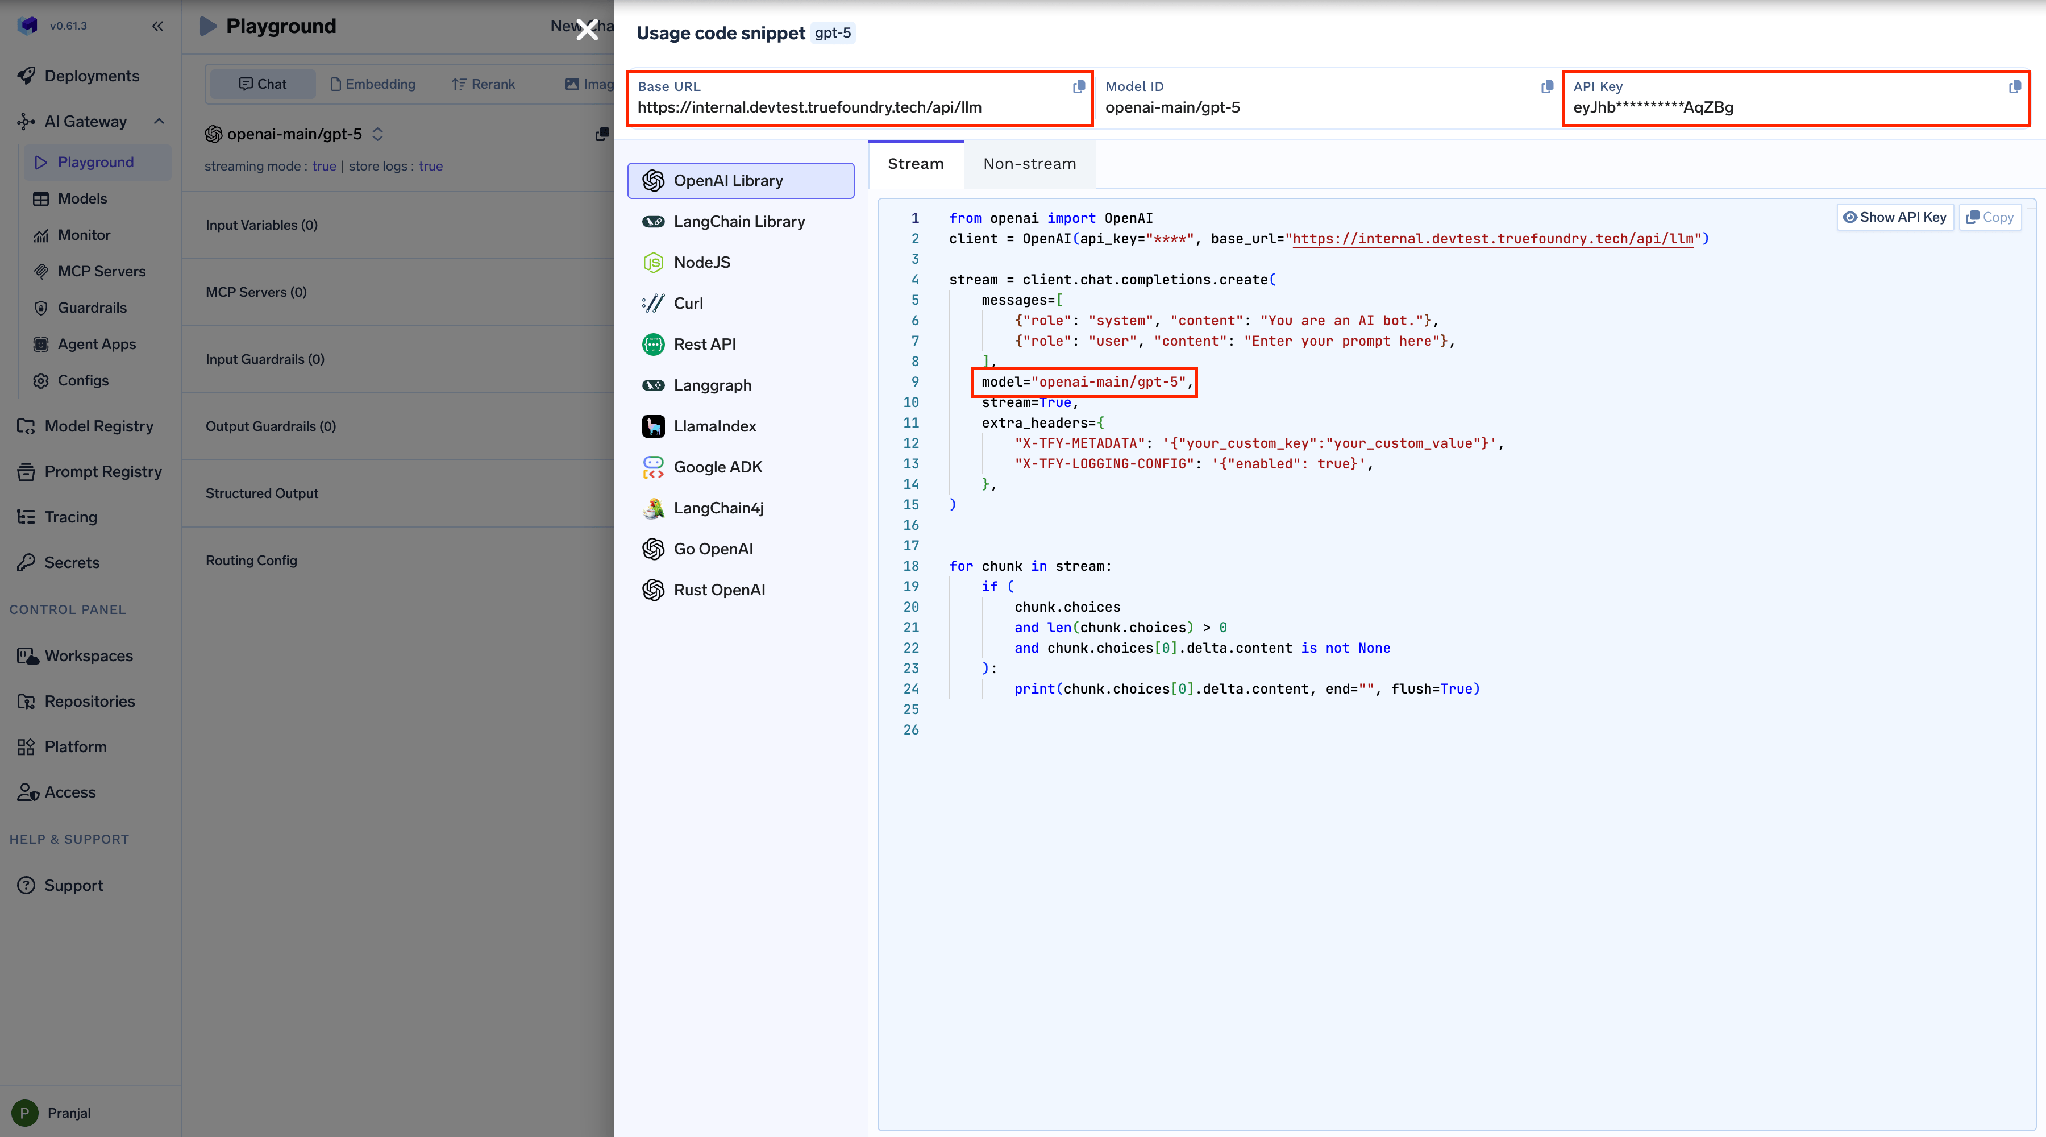
La forme pour un développeur unique : le jeton va dans Authorization et la passerelle l'associe à une personne.
model = "gpt-5.2-codex"
model_provider = "truefoundry"
[model_providers.truefoundry]
name = "TrueFoundry AI Gateway"
base_url = "{GATEWAY_BASE_URL}"
wire_api = "responses"
[model_providers.truefoundry.http_headers]
Authorization = "Bearer TFY_API_KEY"
L'abonnement ChatGPT du développeur paye l'inférence et la passerelle gouverne toujours le trafic. Deux éléments changent : requires_openai_auth = true est requis, et l'identifiant TrueFoundry passe de Authorization à x-tfy-api-key, car Codex a besoin de Authorization pour son propre jeton OAuth ChatGPT.
model = "gpt-5.2-codex"
model_provider = "truefoundry"
[model_providers.truefoundry]
name = "TrueFoundry AI Gateway"
base_url = "{GATEWAY_BASE_URL}"
wire_api = "responses"
requires_openai_auth = true
[model_providers.truefoundry.http_headers]
x-tfy-api-key = "TFY_API_KEY"
Du côté de la passerelle, créez un fournisseur sous Integrations → Providers de type OpenAI, avec l'URL de base https://chatgpt.com/backend-api/codex, et laissez le champ de la clé API vide.
Le champ vide est le signal, pas un oubli. Si une clé enregistrée est présente, la passerelle l'utilise à la place des identifiants ChatGPT du développeur — ce qui interrompt le flux d'abonnement et peut router le trafic sous le mauvais compte. Un administrateur qui remplit « utilement » ce champ transforme trente développeurs attribués individuellement en un tenant anonyme à clé API unique, sans qu'aucune erreur ne soit levée.
Laissez-le vide pour obtenir une double attribution : TrueFoundry enregistre le développeur à partir de x-tfy-api-key, et OpenAI attribue l'utilisation à son siège ChatGPT. Les ID de modèle ressemblent à chatgpt-codex/gpt-5.2-codex.
Deux contraintes découlent du fait que l'identifiant est lié à un seul compte ChatGPT. Seul l'un des cibles d'un modèle virtuel peut être un compte de modèle sous abonnement ChatGPT ; les cibles adossées à une clé API coexistent à ses côtés. De plus, un code 401, 403 ou 429 par développeur ne place pas la cible partagée en période de refroidissement du répartiteur de charge, ainsi le quota épuisé d'un développeur n'affecte personne d'autre.
(La documentation est contradictoire concernant l'éligibilité des forfaits : la page sur la sécurité entreprise indique Business ou Enterprise, la page CLI liste également Personal. [VERIFY] avant de promettre un niveau d'accès.)
C'est la ligne que les équipes copient mal et débuggent ensuite pendant toute une après-midi. La passerelle ajoute le point de terminaison /responses uniquement pour le protocole Responses. Si vous définissez wire_api = "chat", la requête est envoyée à /chat/completions sur la même URL de base, ce qui n'est pas un point de terminaison valide pour le trafic Codex. C'est également ce qui permet aux jetons de réflexion de gpt-5.x-codex de fonctionner correctement.
La page CLI de Codex le formule de manière plus souple — responses pour gpt-5.x-codex, chat pour les autres modèles. Elles se rejoignent : pour les modèles de la famille Codex, le protocole Responses est obligatoire.
Codex envoie des jetons de réflexion à certains modèles et les identifie en faisant correspondre la chaîne du modèle. Les noms pleinement qualifiés — openai-main/gpt-5, azure-openai/gpt-5 — ne correspondent pas, de sorte que la détection des fonctionnalités échoue.
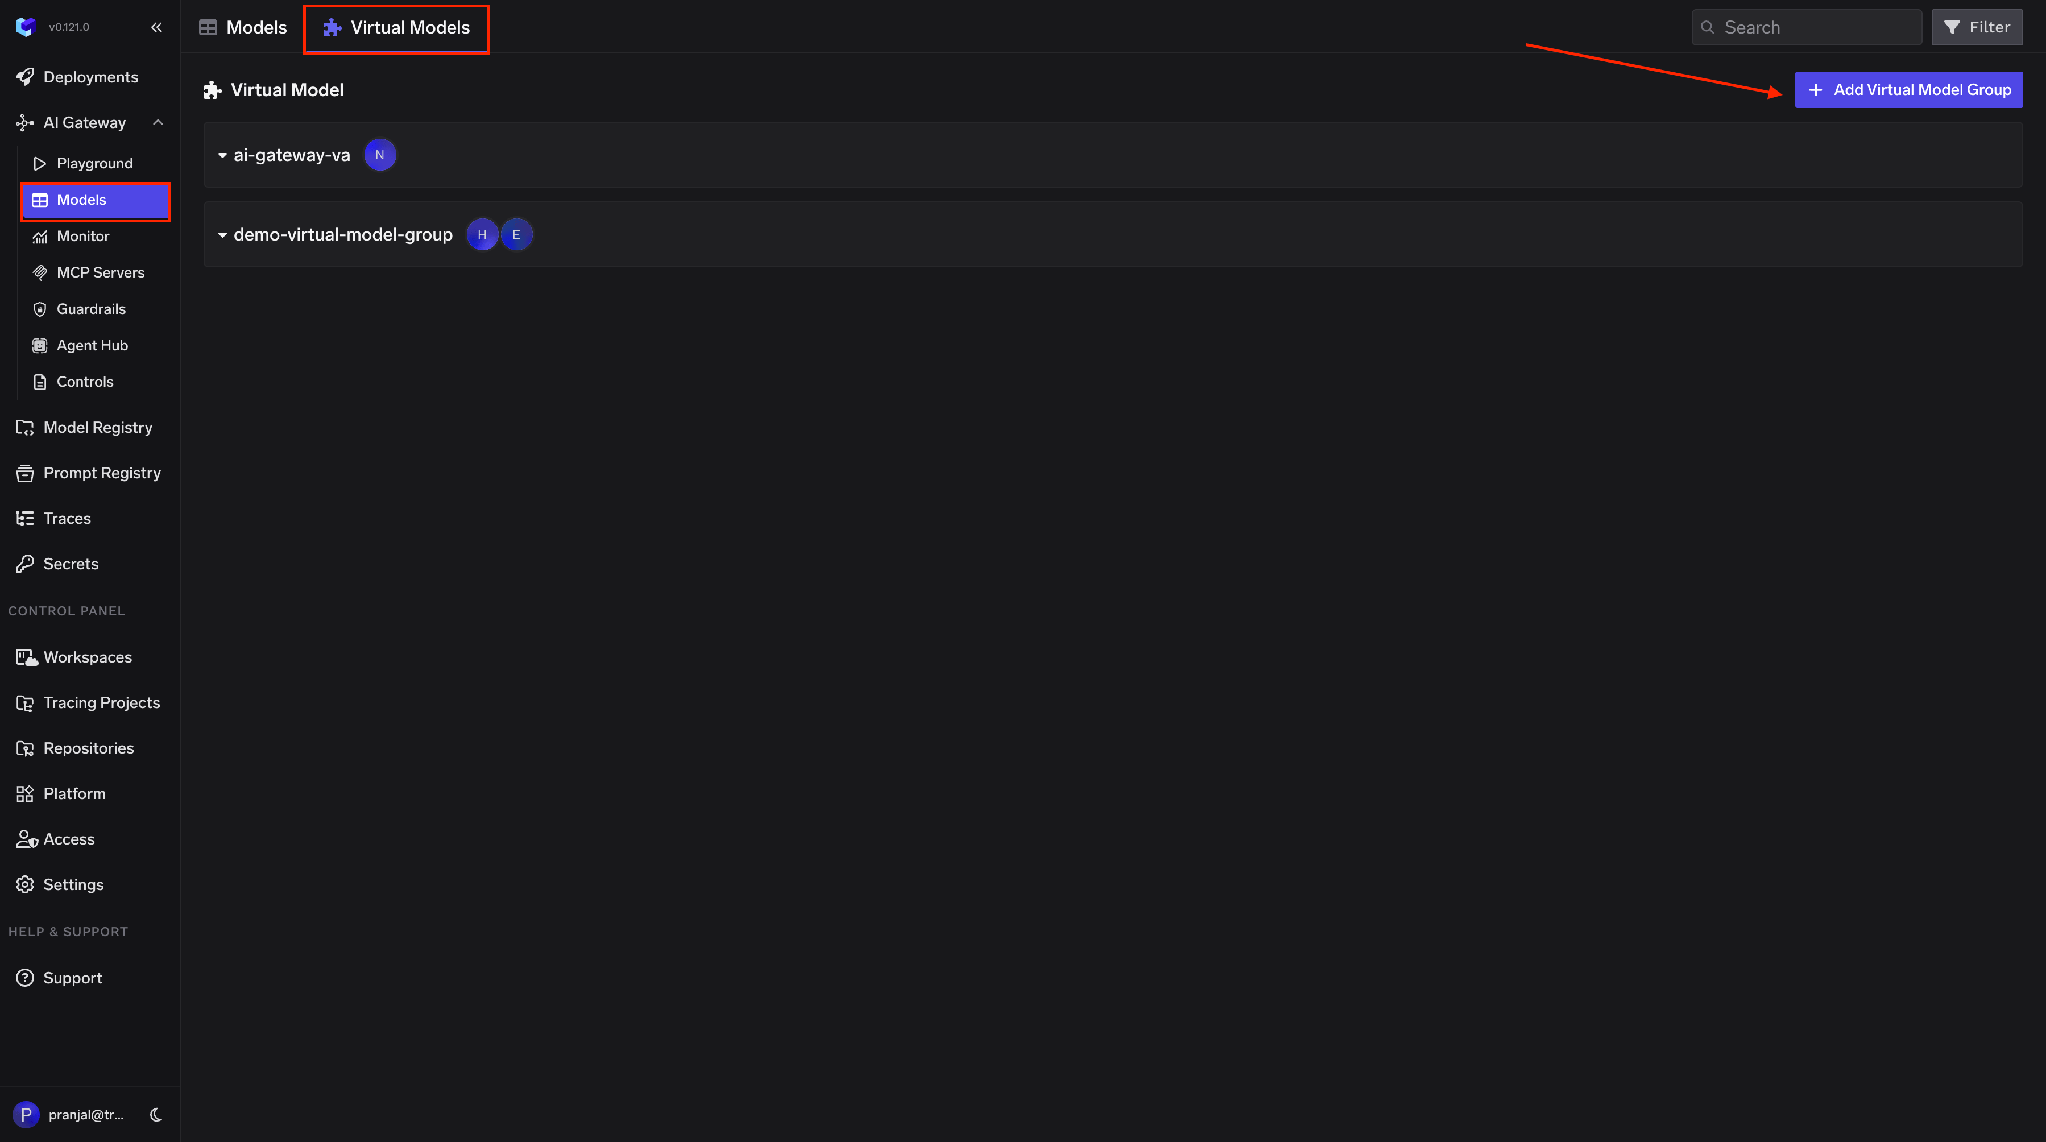
La règle : utilisez un slug qui correspond à l'ID réel du modèle, par exemple gpt-5.2-codex. Codex reconnaît ces ID et active les bonnes fonctionnalités. Ne mettez pas le nom pleinement qualifié dans la configuration Codex.
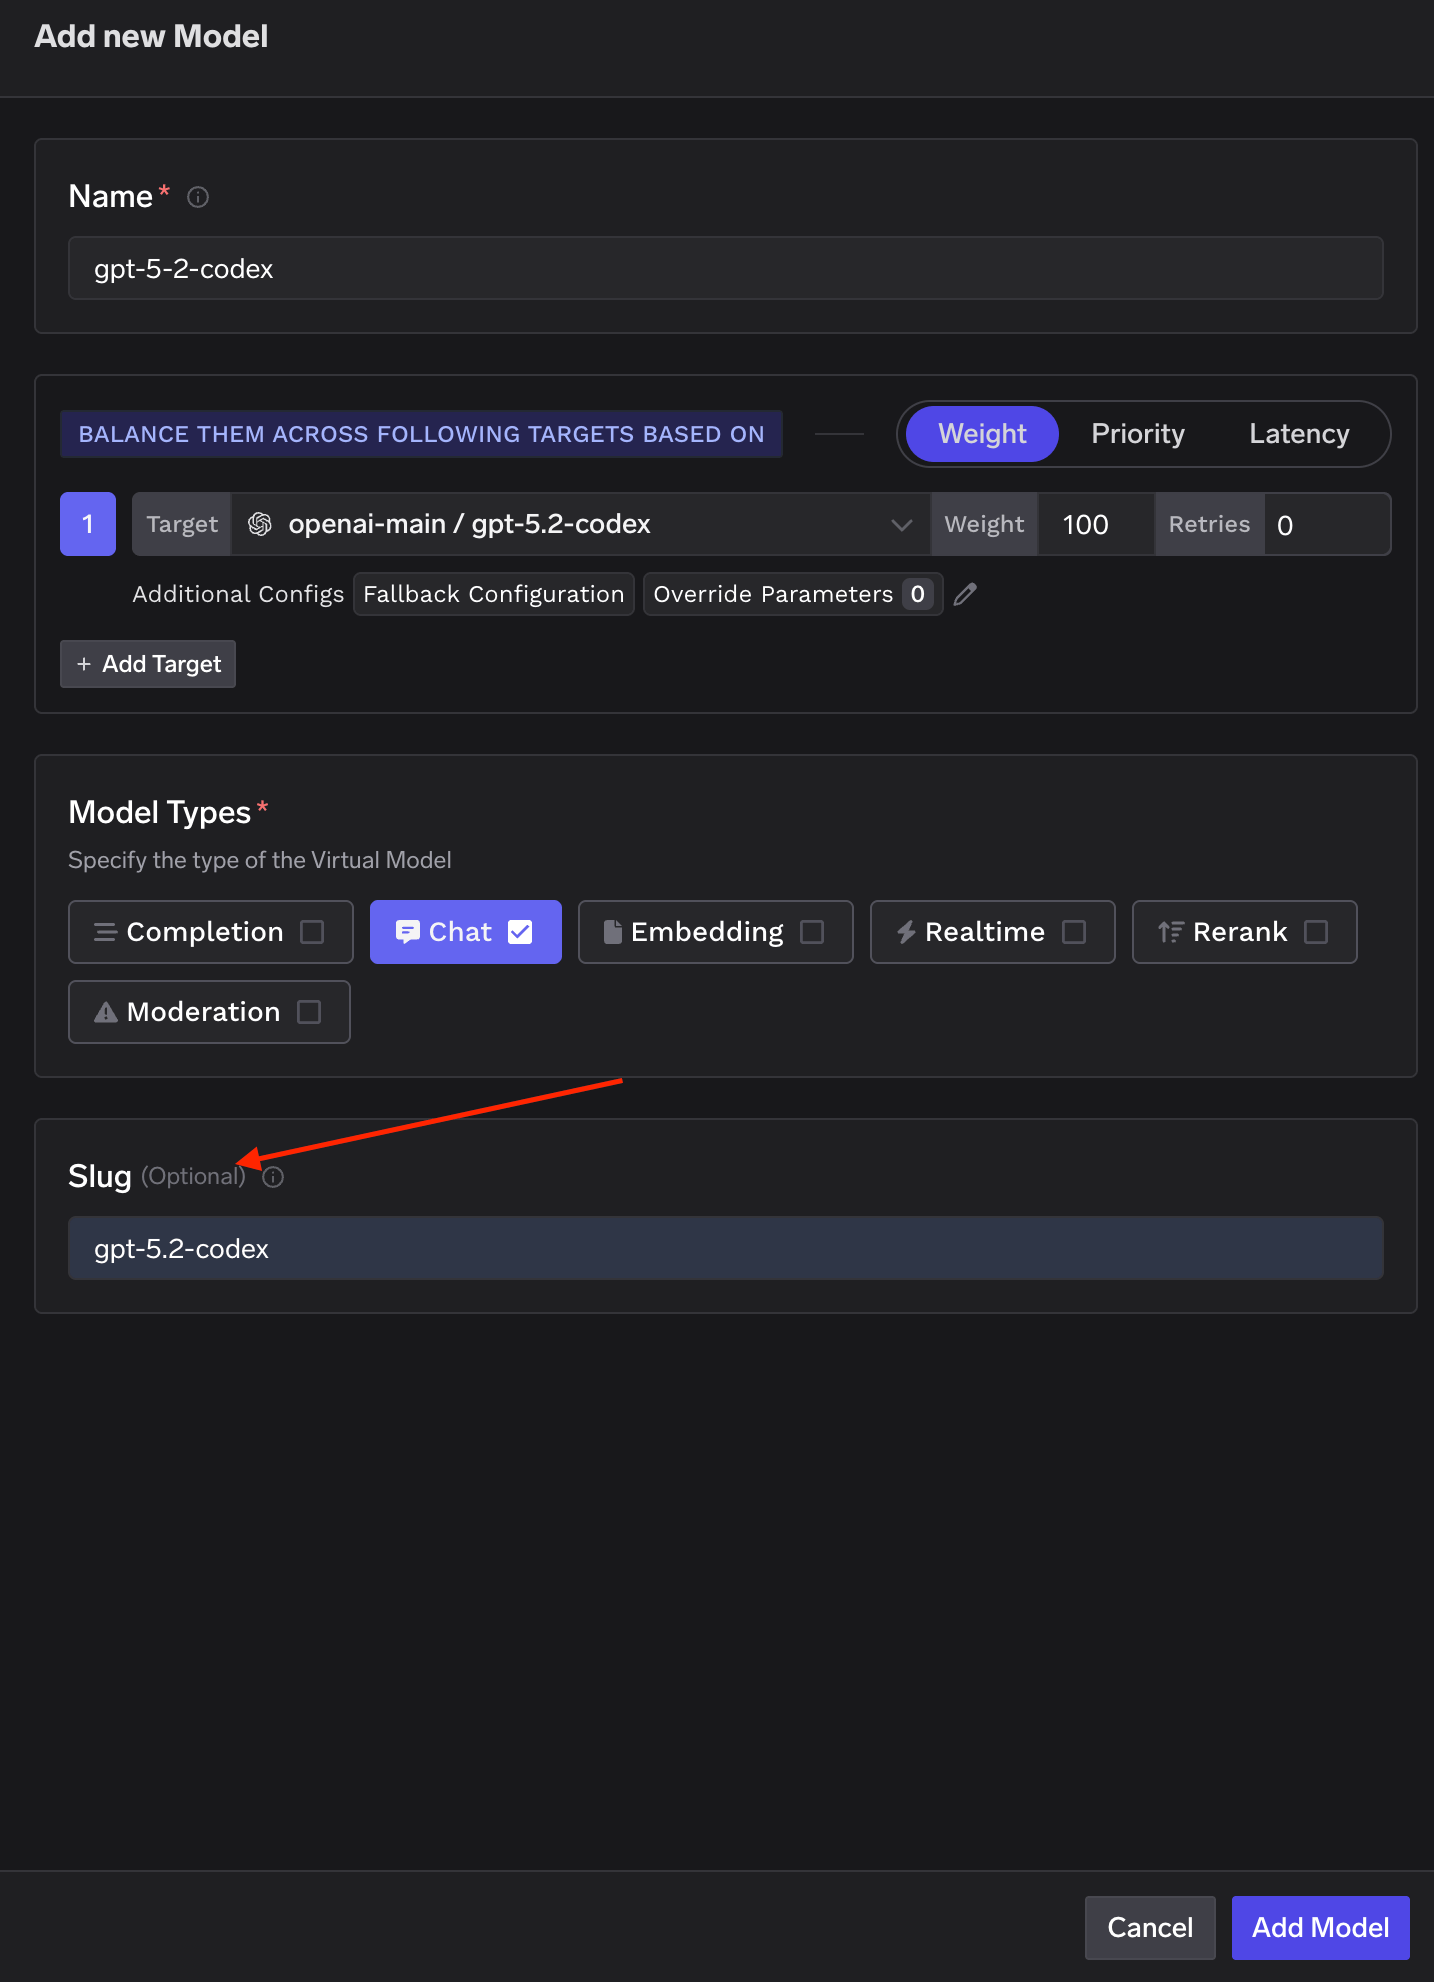
Les slugs sont uniques sur l'ensemble du tenant et sont définis dans les paramètres des Virtual Model Provider Groups. Le slug ainsi que le chemin complet groupe/modèle fonctionnent dans le corps d'une requête ; Codex a besoin de la forme slug.
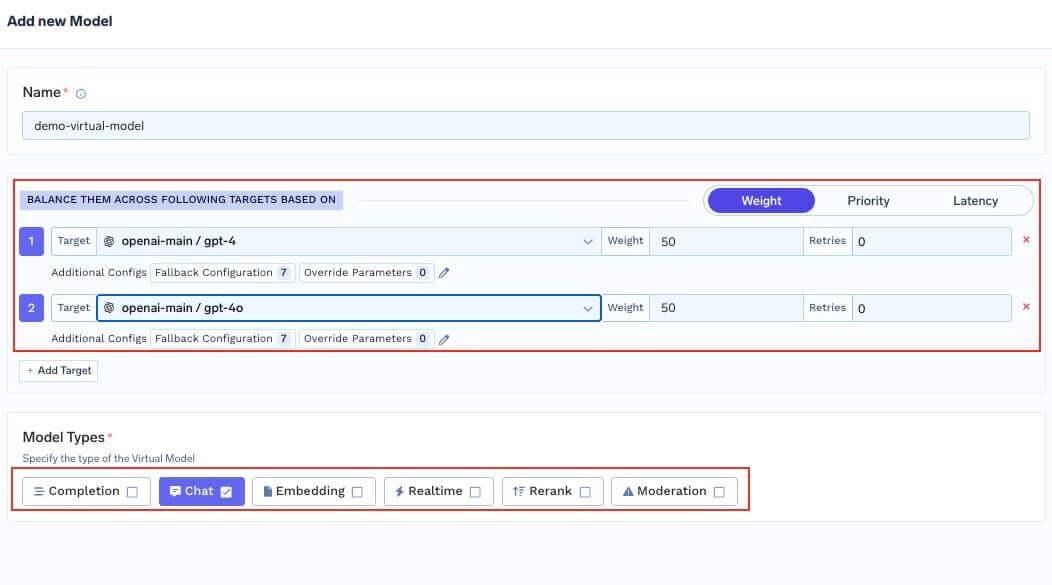
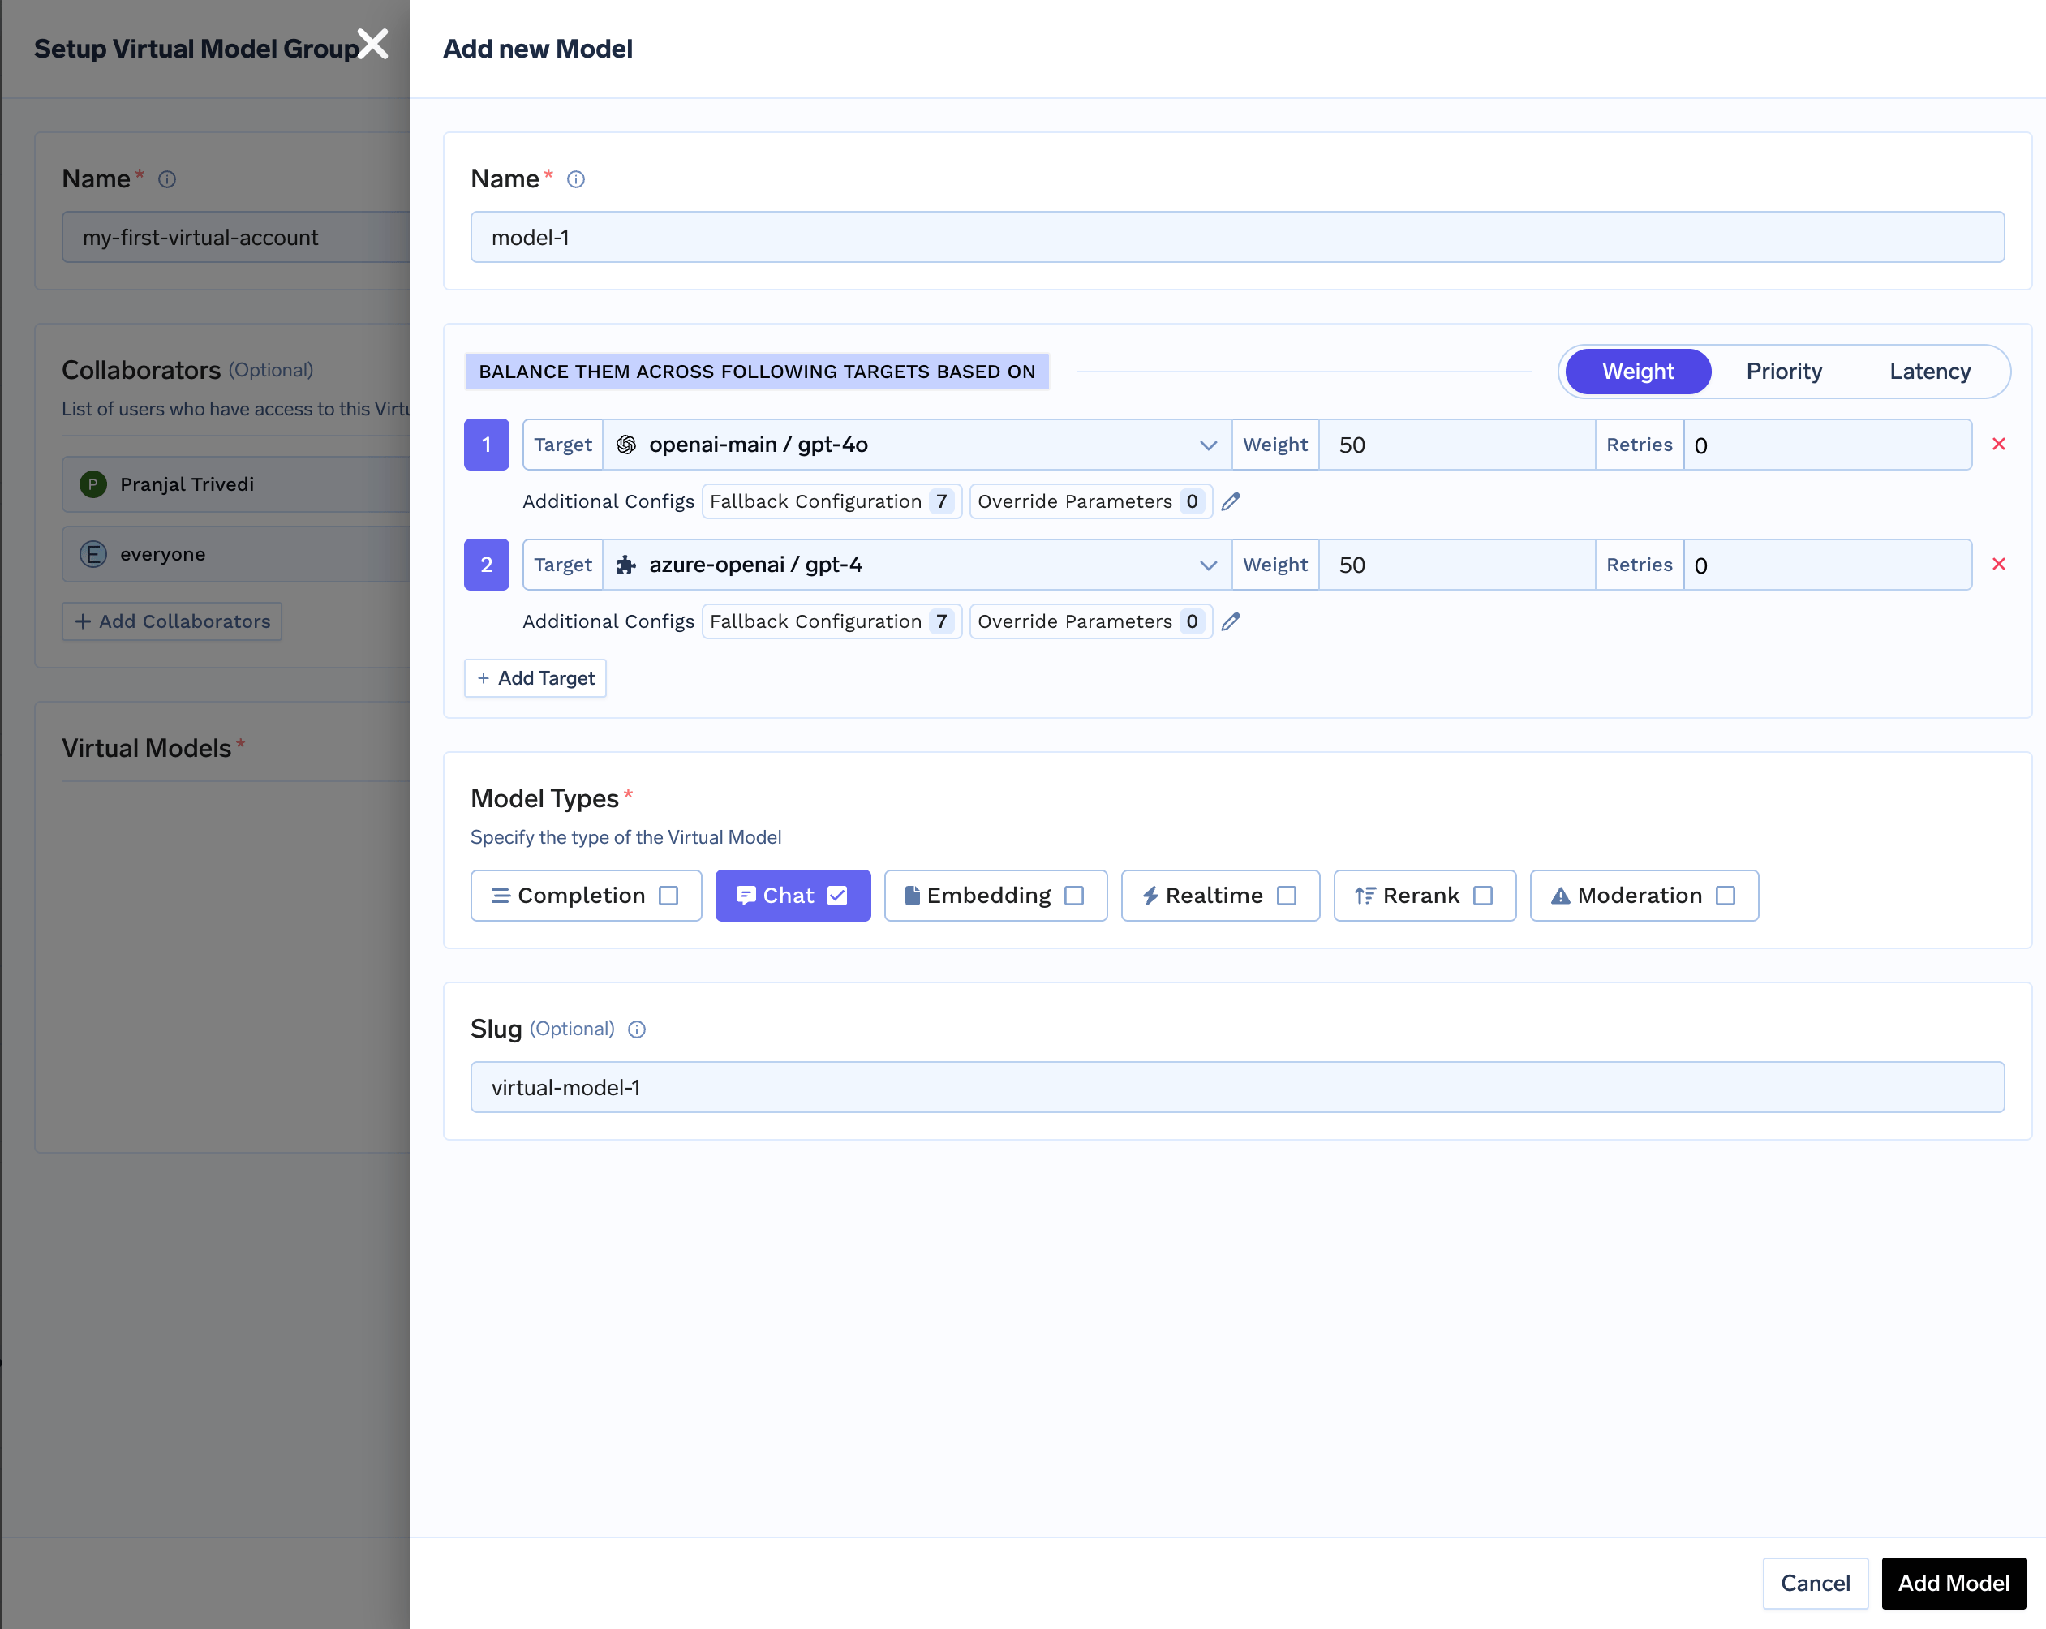
Derrière un seul slug, vous pouvez pondérer les cibles — openai-main/gpt-5 à 70, azure-openai/gpt-5 à 30 — et modifier la répartition sans toucher à un ordinateur portable, comme expliqué dans model deprecations and staged cutovers.
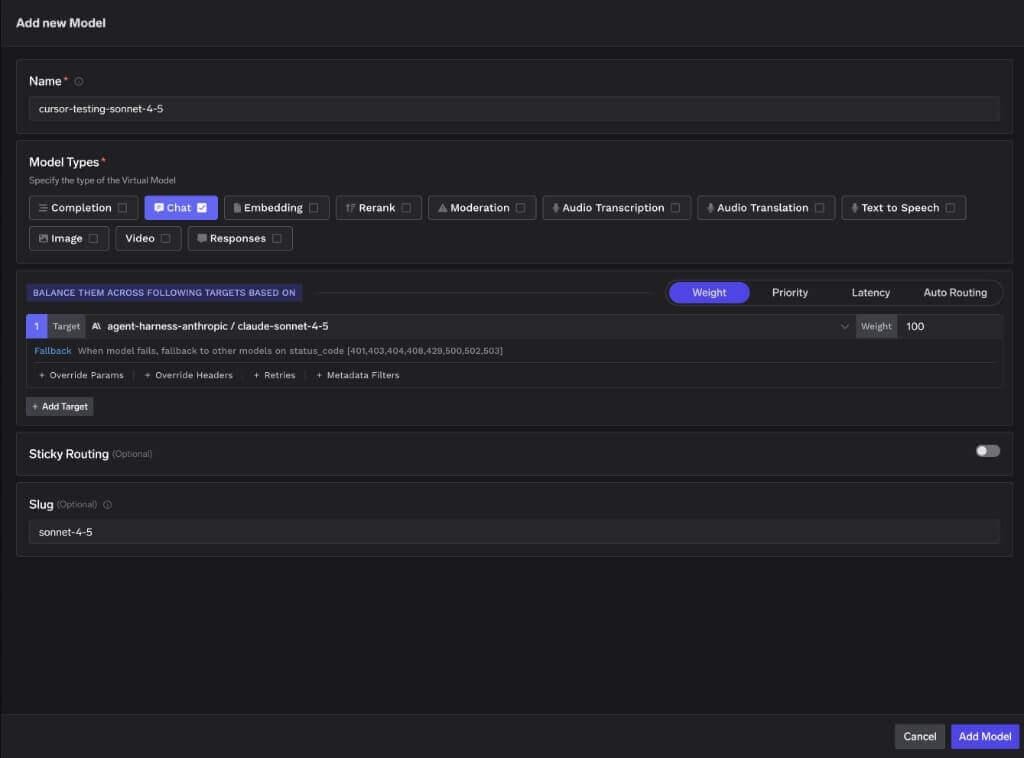
Le nommage des slugs est aussi l'endroit où les clients diffèrent fortement. Cursor choisit son format de requête à partir des mots-clés du slug et change de format silencieusement si le slug contient anthropic, claude, openai, gpt, gemini ou vertex. Codex exige l'ID du modèle dans le slug ; Cursor exige que ces mots-clés en soient exclus.
Une configuration par développeur est une installation documentée, pas un contrôle. L'application sur la flotte utilise tfy-local-ai-setup, un binaire déployé par votre MDM et exécuté en tant que root (Administrateur sur Windows) à une fréquence horaire recommandée, depuis github.com/truefoundry/tfy-local-ai-setup/releases ; les scripts Codex verrouillent RELEASE_TAG="v1.3.5". Chaque exécution réalise quatre actions :
La troisième étape est la plus importante. L'ordinateur portable ne détient jamais de jeton de passerelle à longue durée de vie : le jeton de rafraîchissement est valide 30 jours à compter de sa dernière émission, chaque exécution réussie le révoque et le remplace, et l'identifiant dans la configuration gérée est fraîchement récupéré et limité à l'identité de cet utilisateur.
Configuration requise : GATEWAY_URL, CONTROL_PLANE_URL, TENANT_NAME. En option : CODEX_GATEWAY_URL, CODEX_AUTH_MODE, CODEX_DEFAULT_MODEL, CODEX_SETTINGS_FILE. CODEX_AUTH_MODE="api-key" est la valeur par défaut ; "chatgpt-subscription" indique au binaire d'écrire requires_openai_auth = true et de déplacer le jeton vers x-tfy-api-key. Les machines sans Codex ne subissent aucune modification — le binaire les ignore et s'arrête.
Sur macOS et Linux, le fichier administrateur l'emporte, réappliqué à chaque lancement :
/etc/codex/managed_config.toml → ~/.codex/config.toml → fanions CLI
model_provider = "truefoundry"
model = "gpt-5.2-codex"
[model_providers.truefoundry]
name = "TrueFoundry Gateway"
base_url = "https://<your-truefoundry-gateway-url>"
wire_api = "responses"
[model_providers.truefoundry.http_headers]
Authorization = "Bearer <freshly-fetched-tfy-token>"
La clé model de premier niveau est écrite uniquement lorsque CODEX_DEFAULT_MODEL est défini ; si elle n'est pas définie, le choix du modèle reste à la discrétion du développeur tandis que le fournisseur demeure appliqué.
Sur Windows, le fichier, l'ordre et le schéma changent tous.
C:\ProgramData\OpenAI\Codex\requirements.toml → ~/.codex/config.toml → fanions CLI → C:\ProgramData\OpenAI\Codex\config.toml
Notez la dernière position : config.toml sur Windows est le fichier par défaut de la machine avec la priorité la plus basse des quatre, de sorte que le fichier propre au développeur prévaut sur celui-ci. requirements.toml prévaut sur tout. Le bloc fournisseur correspond à celui de macOS ; ce n'est pas le cas de la fixation du modèle :
# C:\ProgramData\OpenAI\Codex\requirements.toml
model_provider = "truefoundry"
# ... mêmes blocs [model_providers.truefoundry] et http_headers ...
[models.new_thread]
model = "gpt-5.2-codex"
Le schéma de requirements n'a pas de clé model de premier niveau. CODEX_DEFAULT_MODEL se place sous [models.new_thread] à la place. Copiez le bloc macOS sur Windows sans modification et la fixation du modèle n'aura silencieusement aucun effet.
Deux numéros de version déterminent si tout cela est effectif sur Windows. La version v0.149.0 y a supprimé managed_config.toml. La version v0.156.0 est le minimum requis pour l'application des règles — Codex n'honore model_provider dans requirements.toml qu'à partir de cette build ; les versions plus anciennes s'appuient sur config.toml qui a la priorité la plus basse et qu'un développeur peut redéfinir depuis son répertoire personnel. Vérifiez codex --version avant de considérer Windows comme contrôlé. La gestion de Codex Windows dans le binaire d'installation arrive avec tfy-local-ai-setup v1.3.5.
Le verrouillage transforme le fichier en un outil de contrôle :
Sur macOS, /etc/codex/ appartient à root:wheel en 755 et le fichier est en root:wheel 644 avec schg — root lui-même doit exécuter chflags noschg pour le modifier.
L'avertissement concernant l'ACL Windows mérite sa propre ligne. C:\ProgramData\OpenAI\Codex\ appartient aux Administrateurs avec l'héritage supprimé : SYSTEM et Admins en accès total, Utilisateurs en lecture ; les deux fichiers TOML en SYSTEM accès total, Admins lecture, Utilisateurs lecture. La raison est simple — ProgramData permet à n'importe quel utilisateur authentifié de créer des répertoires, et Codex charge la configuration qu'il y trouve au lieu de rejeter une configuration modifiable par l'utilisateur. Ne relâchez pas cette ACL ; un répertoire permissif transforme une configuration appliquée en une simple suggestion, silencieusement.
Codex accède au web ouvert de deux manières. La recherche hébergée par le fournisseur envoie l'outil web_search de l'API Responses, y compris sur les modèles pris en charge sur AWS Bedrock Mantle — rapide, mais le comportement varie selon le fournisseur et ce n'est pas un appel d'outil que vous contrôlez. La recherche web MCP — Tavily ou Exa derrière la TrueFoundry MCP Gateway — est recommandée pour garantir la cohérence, car les outils MCP s'exécutent côté client dans le processus Codex quel que soit le modèle vers lequel la passerelle achemine les requêtes.
[mcp_servers.web-search]
url = "https://<gateway>/<tenant>/mcp/<mcp-server-name>/server"
http_headers = { Authorization = "Bearer TFY_API_KEY" }
Utilisez bearer_token_env_var = "TFY_API_KEY" plutôt que d'intégrer le jeton en clair. Pour désactiver la recherche hébergée par le fournisseur, définissez web_search = "disabled" dans ~/.codex/config.toml — cela désactive uniquement la voie hébergée par le fournisseur ; le serveur MCP continue de fonctionner jusqu'à ce que vous supprimiez son bloc [mcp_servers.<name>]. L'enregistrement de la recherche en tant que serveur MCP est également ce qui rend le trafic de cet outil gouvernable via le MCP gateway access control.
Puisque chaque complétion passe par la passerelle, l'historique existe, que le développeur le veuille ou non — chaque requête apparaît dans Request Traces avec l'utilisateur identifié, le modèle servi, les jetons et la latence.
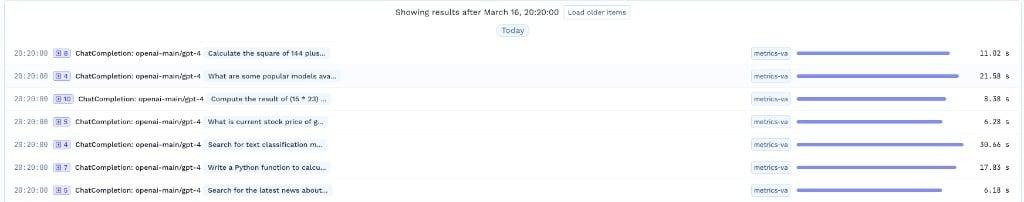
Au-dessus de cela, le tableau de bord des métriques agrège les données de la flotte : dépenses et volumes par utilisateur, par équipe et par modèle.
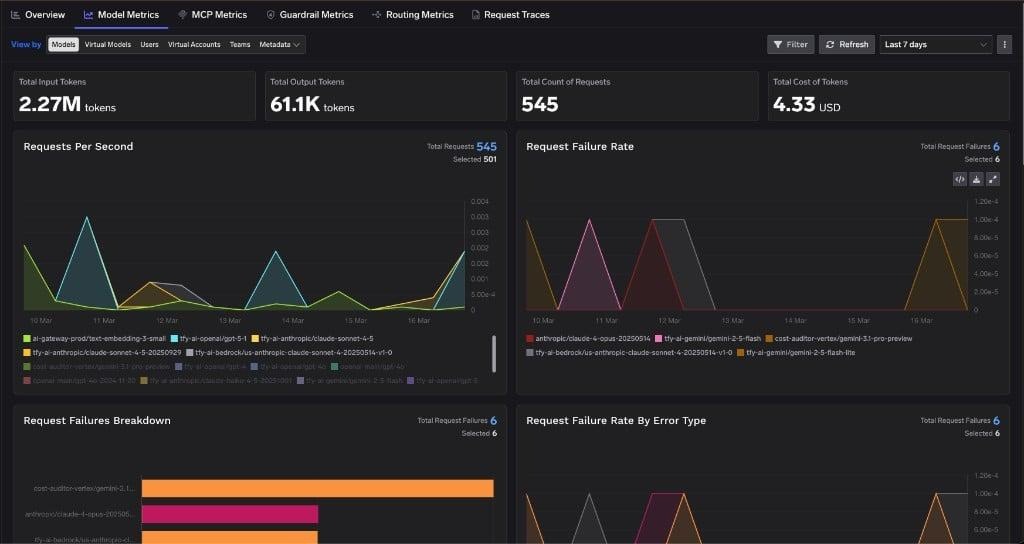
Chaque client de codage sur la passerelle apparaît dans la même vue — une vision unique des coûts au lieu de quatre, comme expliqué dans centralising cost control across AI coding IDEs.
Deux cents ingénieurs, macOS et Windows, ChatGPT Enterprise déjà acheté. Les développeurs conservent Codex ; la sécurité obtient l'attribution ; la finance obtient un chiffre par équipe.
1. Créez le fournisseur. Integrations → Providers → OpenAI, URL de base https://chatgpt.com/backend-api/codex, champ de clé API vide — notez-le dans la procédure opérationnelle afin que le prochain administrateur ne le « corrige » pas.
2. Créez le Virtual Model. Slug gpt-5.2-codex — l'ID réel du modèle, pas le nom pleinement qualifié. Une cible sous abonnement ChatGPT, plus des cibles adossées à une clé API pour le basculement.
3. Définissez la configuration MDM. GATEWAY_URL, CONTROL_PLANE_URL, TENANT_NAME, ainsi que CODEX_AUTH_MODE="chatgpt-subscription" et CODEX_DEFAULT_MODEL="gpt-5.2-codex".
4. Déployez le script toutes les heures, en tant que root. Il installe tfy-local-ai-setup v1.3.5, rafraîchit le jeton de chaque utilisateur, écrit managed_config.toml sur macOS et requirements.toml sur Windows, et verrouille les deux.
5. Conditionnez le déploiement Windows à codex --version. Toute version inférieure à v0.156.0 n'est pas soumise aux contrôles ; vérifiez la distribution des versions de la flotte avant de confirmer la couverture.
6. Vérifiez. ls -lO pour schg, lsattr pour i, icacls pour le propriétaire Administrators et Users:(RX). Ouvrez ensuite Request Traces et confirmez que le nom d'un développeur, et non un compte de service, figure sur la requête.
7. Fermez l'accès à la recherche web directe. Enregistrez Tavily ou Exa derrière la passerelle MCP, puis définissez web_search = "disabled".
La limite honnête : ces étapes gouvernent le fournisseur de modèles, l'authentification et les dépenses. Elles ne contrôlent pas quels serveurs MCP un développeur est autorisé à activer.
Le script MDM ne contrôle pas les serveurs MCP. Il gère managed_config.toml, qui couvre le fournisseur de modèles et l'authentification. Le contrôle par Codex des serveurs MCP qu'un développeur peut activer réside dans un fichier séparé /etc/codex/requirements.toml sur macOS et Linux, que tfy-local-ai-setup n'écrit pas. Déployez-le aux côtés du script — et ne dites pas à un auditeur que la configuration MDM couvre la liste d'autorisation MCP.
Deux scripts MDM, un seul fichier de configuration, des versions épinglées différentes. Les scripts Codex épinglent tfy-local-ai-setup v1.3.5 ; les scripts Claude Code épinglent la version v1.3.4. Les deux décrivent un seul binaire partageant un fichier de configuration enregistré sur la même machine, de sorte qu'une flotte exécutant les deux réinstallerait une version différente chaque heure — et la prise en charge de Codex sur Windows n'existe qu'à partir de la v1.3.5. [VERIFY] la version épinglée avant d'activer les deux.
Décalage de version de modèle dans la documentation. La page Codex annonce GPT-5.3-Codex alors que chaque exemple de configuration, les instructions relatives aux slugs et la valeur par défaut du MDM utilisent gpt-5.2-codex. Épinglez explicitement dans CODEX_DEFAULT_MODEL ; [VERIFY] l'ID du modèle actuel avant le déploiement.
Cursor ne peut pas être contrôlé de la même manière. Ses politiques MDM couvrent les hooks, pas les modèles : l'URL de base, la clé API et la liste des modèles ne sont pas applicables par MDM, un développeur peut donc les réinitialiser à tout moment. Copilot CLI ne dispose pas non plus de chemin settings.json pour le BYOK. Codex et Claude Code sont les deux seuls qui maintiennent ces contraintes — la section Cursor security couvre ce manque.
La plupart des conseils sur la gouvernance d'OpenAI Codex se limitent à « l'acheminer via un proxy ». C'est la partie facile. La partie difficile consiste à déterminer si ce routage résiste à une véritable flotte : un champ de clé API vide qui ressemble à une erreur mais n'en est pas une, un protocole de communication obligatoire, un slug qui doit correspondre exactement à l'ID d'un modèle, un fichier Windows avec son propre schéma, une version minimale en deçà de laquelle le contrôle ne fait silencieusement rien, et une ACL que vous ne devez pas relâcher.
Aucun de ces éléments n'est une question de politique générale. Ce sont des faits de configuration, chacun étant associé à une commande que vous pouvez exécuter pour le vérifier. C'est la différence entre un document de gouvernance et une flotte réellement gouvernée : quelqu'un s'approche de n'importe quel ordinateur portable, exécute ls -lO ou icacls, et obtient un oui ou un non immédiat.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




Quatre contrôles qui tiennent sans la coopération des développeurs : une identité par développeur sur chaque requête, le contrôle par l'administrateur des modèles accessibles, des dépenses attribuées à une personne et à une équipe, et un audit produit sur le chemin réseau. En pratique : un fichier de configuration détenu par l'administrateur et lu avec une priorité supérieure à celui du développeur, un verrouillage de fichier et des identifiants à courte durée de vie.
Oui. Définissez requires_openai_auth = true, déplacez l'identifiant de la passerelle vers x-tfy-api-key afin que Codex puisse utiliser Authorization pour son propre jeton OAuth ChatGPT, et créez le fournisseur de la passerelle avec le champ de clé API vide — une clé enregistrée remplace les identifiants ChatGPT du développeur et interrompt le flux. Vous obtenez l'identité du développeur côté passerelle et sa licence ChatGPT côté OpenAI.
Uniquement à partir de Codex v0.156.0. La v0.149.0 a supprimé la prise en charge de managed_config.toml sans équivalent dans le registre ; l'application des règles est passée à requirements.toml, un schéma différent sans clé model de premier niveau. En dessous de la v0.156.0, seul config.toml, de priorité la plus basse, s'applique, et la configuration du développeur le remplace.
Oui. TrueFoundry s'exécute dans votre VPC, on-premise, en environnement air-gapped ou en hybride, de sorte que les prompts et les réponses ne quittent jamais votre domaine, même lorsque vous routez vers de nombreux fournisseurs.
Oui. Il comprend une MCP Gateway, une Agent Gateway et un MCP & Agents Registry avec un contrôle d'accès au niveau des outils. Les agents construits avec LangGraph, CrewAI, AutoGen ou un framework maison peuvent tous être gouvernés de manière centralisée.
Oui. La passerelle est conforme à OpenTelemetry et se connecte à Grafana, Datadog ou Prometheus. Chaque appel au classifieur LLM produit son propre span, de sorte que la latence du classifieur est visible séparément de celle du modèle servi.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception


















