



November 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
La limitation de débit d'API classique suppose que les requêtes sont fongibles : un GET /users/42 coûte à peu près la même chose que le suivant, donc compter les requêtes est un bon indicateur de la charge. Tous les limiteurs de débit que vous avez configurés sont basés sur ce principe.
Le trafic LLM brise ce modèle. Même endpoint, même minute, même utilisateur : « résume ceci en une ligne » représente environ 50 tokens aller-retour ; un contrat de 150 pages envoyé à un modèle de raisonnement est proche de 200 000. Les deux constituent une seule requête, et une limite de 1 000 requêtes par minute autorise l'un comme l'autre.
Cette variance est la forme normale du trafic de production dès que des agents sont impliqués, car un tour d'agent réinjecte l'intégralité de la conversation, les résultats des outils et le contexte récupéré dans le prompt à chaque étape. Le nombre de requêtes reste stable tandis que le nombre de tokens augmente d'un ordre de grandeur — la mécanique derrière l'explosion des tokens liés aux agents dans le CI/CD.
Il faut donc changer d'unité. Comptez les tokens, car les tokens sont ce que vous achetez. Le nombre de requêtes compte toujours — il protège la passerelle et la connexion au fournisseur — appliquez donc les deux.
La majeure partie de la confusion vient du vocabulaire. Quatre problèmes, quatre mécanismes, et les équipes en installent fréquemment un en pensant en avoir installé un autre :
Les limites de débit sont un contrôle de disponibilité ; les budgets sont un contrôle financier. Ils échouent différemment et ont des propriétaires différents — la plateforme possède le premier, la finance le second.
L'erreur courante consiste à installer une limite de débit de tokens et à l'appeler contrôle des coûts. 20 000 tokens par minute sur un modèle bon marché représentent quelques dollars par jour ; sur un modèle de raisonnement de pointe, c'est un chiffre très différent, et il évolue à chaque changement de tarif d'un fournisseur. Le débit de tokens n'est pas de l'argent.
Les limites des fournisseurs méritent un avertissement, car les équipes s'appuient dessus involontairement. Votre limite d'organisation OpenAI ou Anthropic est un pool partagé unique : lorsqu'un traitement par lots le sature, votre produit destiné aux clients est ralenti par un système incapable d'exprimer que « l'assistant prime toujours ». D'où la nécessité d'une passerelle que vous contrôlez.
L'algorithme détermine le volume de pic (burst) qui passe — un détail non négligeable pour les agents.
Pour le trafic de chat humain, la fenêtre fixe convient — les gens ne se coordonnent pas. Les agents le font, accidentellement. Ils réessayent en cas d'échec, s'exécutent en parallèle et suivent des plannings, de sorte que de nombreux appelants frappent exactement au même instant, et le cas de doublement cesse d'être théorique. Les fenêtres glissantes résolvent cela en éliminant le moment de réinitialisation. Le seau de jetons répond à une question différente — il convient au trafic où vous souhaitez de courts pics — au prix d'un paramètre supplémentaire à régler.
La dégradation est la méthode la moins utilisée : si une limite au niveau du modèle est atteinte, une chaîne de secours peut servir la requête depuis un second fournisseur plutôt que de renvoyer une erreur 429 à un utilisateur — le mécanisme de basculement détaillé dans notre article sur les routeurs LLM, où la 429 est un code d'état déclencheur. Un dépassement de budget est différent : si l'argent est épuisé, il est épuisé, et le dépenser discrètement sur un service moins cher n'est pas ce que la finance a demandé.
Placer une règle générique au-dessus de la règle spécifique. En application basée sur le premier match gagnant (first-match-wins), une règle large en haut absorbe le trafic qui aurait dû correspondre à une règle plus étroite située plus bas. La règle étroite ne se déclenche jamais.
Traiter un compteur partagé comme une limite par utilisateur. « 20 000 tokens par minute » sans portée définie constitue un seul compteur pour tout le monde. Le premier appelant le consomme entièrement.
Supposer que les requêtes échouées sont gratuites. Pour les limites basées sur les requêtes, elles ne le sont pas — et pour les limites de tokens, la réponse est différente.
Deux objets de politique, délibérément séparés : la limitation de débit régit le débit, les budgets régissent l'argent.
Les règles de limitation de débit acceptent six unités — l'ensemble complet :
requests_per_minute · requests_per_hour · requests_per_day · tokens_per_minute · tokens_per_hour · tokens_per_day
Il n'y a pas d'unité par seconde ; une seule requête LLM peut prendre des dizaines de secondes, donc les limites par seconde mesureraient du bruit. La configuration se trouve dans l'onglet Config :
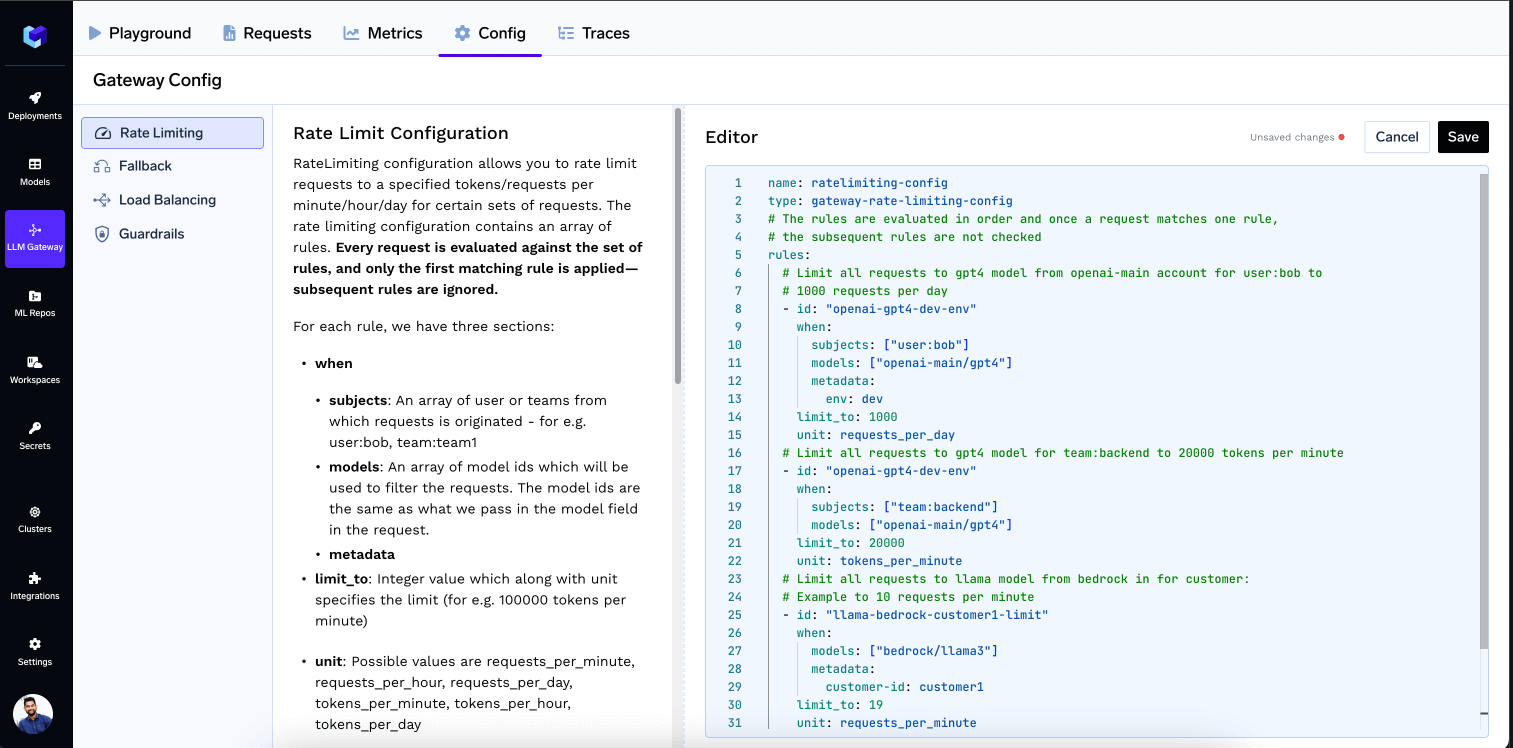
Un ensemble de règles est de type : gateway-rate-limiting-config avec une liste de règles. Chaque règle possède un id statique, un bloc when dont les conditions de sujets, modèles et métadonnées se combinent avec AND, un entier limit_to, une unité, et optionnellement rate_limit_applies_per. Les sujets sont préfixés — user:, team:, virtualaccount: — et les métadonnées lisent l'en-tête X-TFY-METADATA.
Puisque l'unité minimale est par minute, la passerelle maintient une fenêtre de 60 secondes, conserve des compartiments temporels toutes les 10 secondes pour chaque utilisateur, modèle, équipe ou segment personnalisé, et additionne les 6 derniers compartiments pour évaluer le compteur. Les compartiments plus anciens sont éliminés. La résolution de 10 secondes est le chiffre à retenir : un pic est lissé sur six sous-intervalles au lieu d'être autorisé deux fois à une limite de réinitialisation.
Sans cette option, une règle constitue un seul compteur partagé pour tout ce qu'elle fait correspondre. Avec elle, le compteur se divise par entité. Les valeurs autorisées sont user, virtualaccount, model, et metadata.* avec votre propre clé. Maximum deux valeurs par règle.
['user'] donne à chaque utilisateur son propre quota et ['model'] à chaque modèle le sien. La dernière règle est le modèle que la plupart des équipes finissent par adopter : un plafond par projet basé sur les métadonnées que l'application envoie déjà, sans modification de règle lorsqu'un nouveau projet apparaît.
Cela a remplacé un format d'ID de règle dynamique. La migration est mécanique — {user}-daily-limit devient id: 'user-daily-limit' plus ['user'], et project-{metadata.project_id}-limit devient id: 'project-limit' plus ['metadata.project_id'] :
Tableau de documentation associant les ID de règles dynamiques obsolètes aux ID statiques avec les valeurs rate_limit_applies_per
Chaque requête est évaluée par rapport à chaque règle, mais seule la première règle correspondante est appliquée. Les correspondances ultérieures ne la bloquent jamais. L'utilisation, en revanche, est comptabilisée pour chaque règle correspondant à la requête.
Conservez donc les règles spécialisées au début. L'échec documenté : placez app-a-limit (10 000 rpm, virtualaccount:app-a) au-dessus de tenant-wide-limit (5 000 rpm, when: {}), et le trafic de l'application A — comptabilisé pour les deux — sature le compteur du tenant à lui seul. Tous ceux dont la première correspondance est la règle du tenant reçoivent alors une erreur 429 bien en dessous de 5 000 rpm. La solution n'est pas de réordonner mais de définir la portée : rate_limit_applies_per: ['user', 'virtualaccount'].
Toute requête rejetée par la passerelle, ou échouant côté fournisseur avec un code 4XX/5XX, compte comme une requête dans chaque règle requests_per_* à laquelle elle a correspondu. Une exception : une requête déjà rejetée avec une erreur 429 par la limitation de débit elle-même, afin qu'une tempête de réessais n'aggrave pas la situation.
Les limites de tokens se comportent différemment. Les requêtes échouées ne consomment pas de quota de tokens, car une requête échouée ne rapporte aucun token. Il n'y a rien à compter. C'est pourquoi une boucle de réessai peut épuiser votre budget de requêtes tandis que le tableau de bord des tokens reste sain.
Un dépassement renvoie un code HTTP 429 avec error.type: "RateLimitError" et error_origin_level: "rate_limit_budget", plus un en-tête x-tfy-applied-rules nommant la règle qui s'est déclenchée.
Les budgets constituent le contrôle financier, et ils sont uniquement basés sur les coûts, cost_per_* en USD. Il n'existe pas de budget libellé en tokens — si vous souhaitez un plafond de tokens, il s'agit d'une limite de débit.
Budget V2 a été livré avec la v0.158.0 et inverse la logique d'application : chaque règle correspondante est vérifiée et toutes doivent autoriser la requête, selon une logique AND entre les budgets. La limitation de débit fonctionne au premier match gagnant ; les budgets exigent la validation de l'ensemble. La V1 utilisait le premier match gagnant, la migration implique donc un changement sémantique, et non syntaxique.
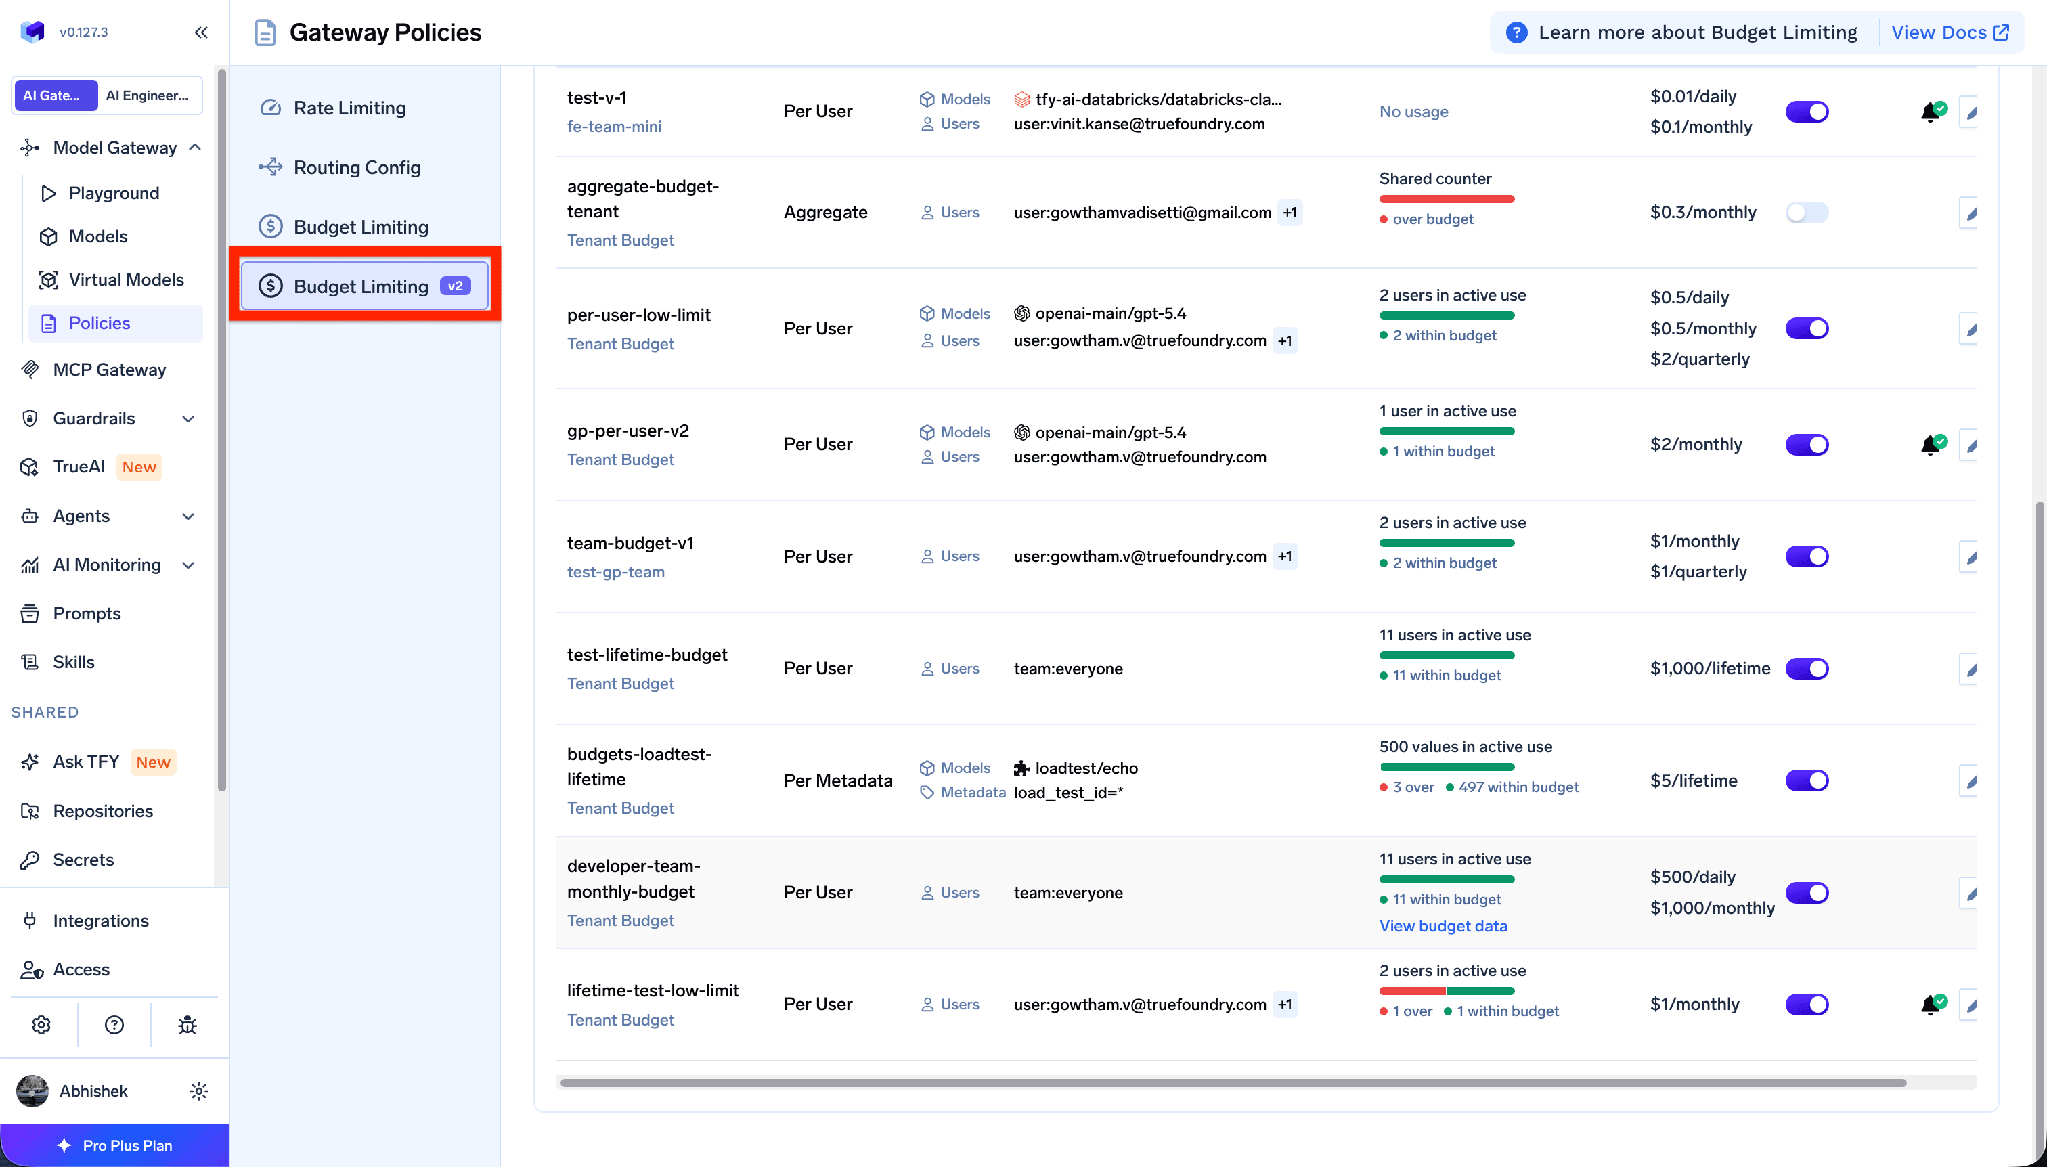
Les règles se trouvent sous AI Gateway → Policies → Budget Limiting → Add Rule, selon deux portées : tenant (tenant-budget-config) ou team (team-budget-config, avec un team_name appliqué par RBAC).
Cinq périodes de réinitialisation, toutes en UTC : Quotidienne (00:00), Hebdomadaire (Lundi 00:00), Mensuelle (1er du mois), Trimestrielle (1er janv., 1er avr., 1er juil., 1er oct.), et À vie (Lifetime), qui ne se réinitialise jamais — le plafond de dépenses du tableau ci-dessus :
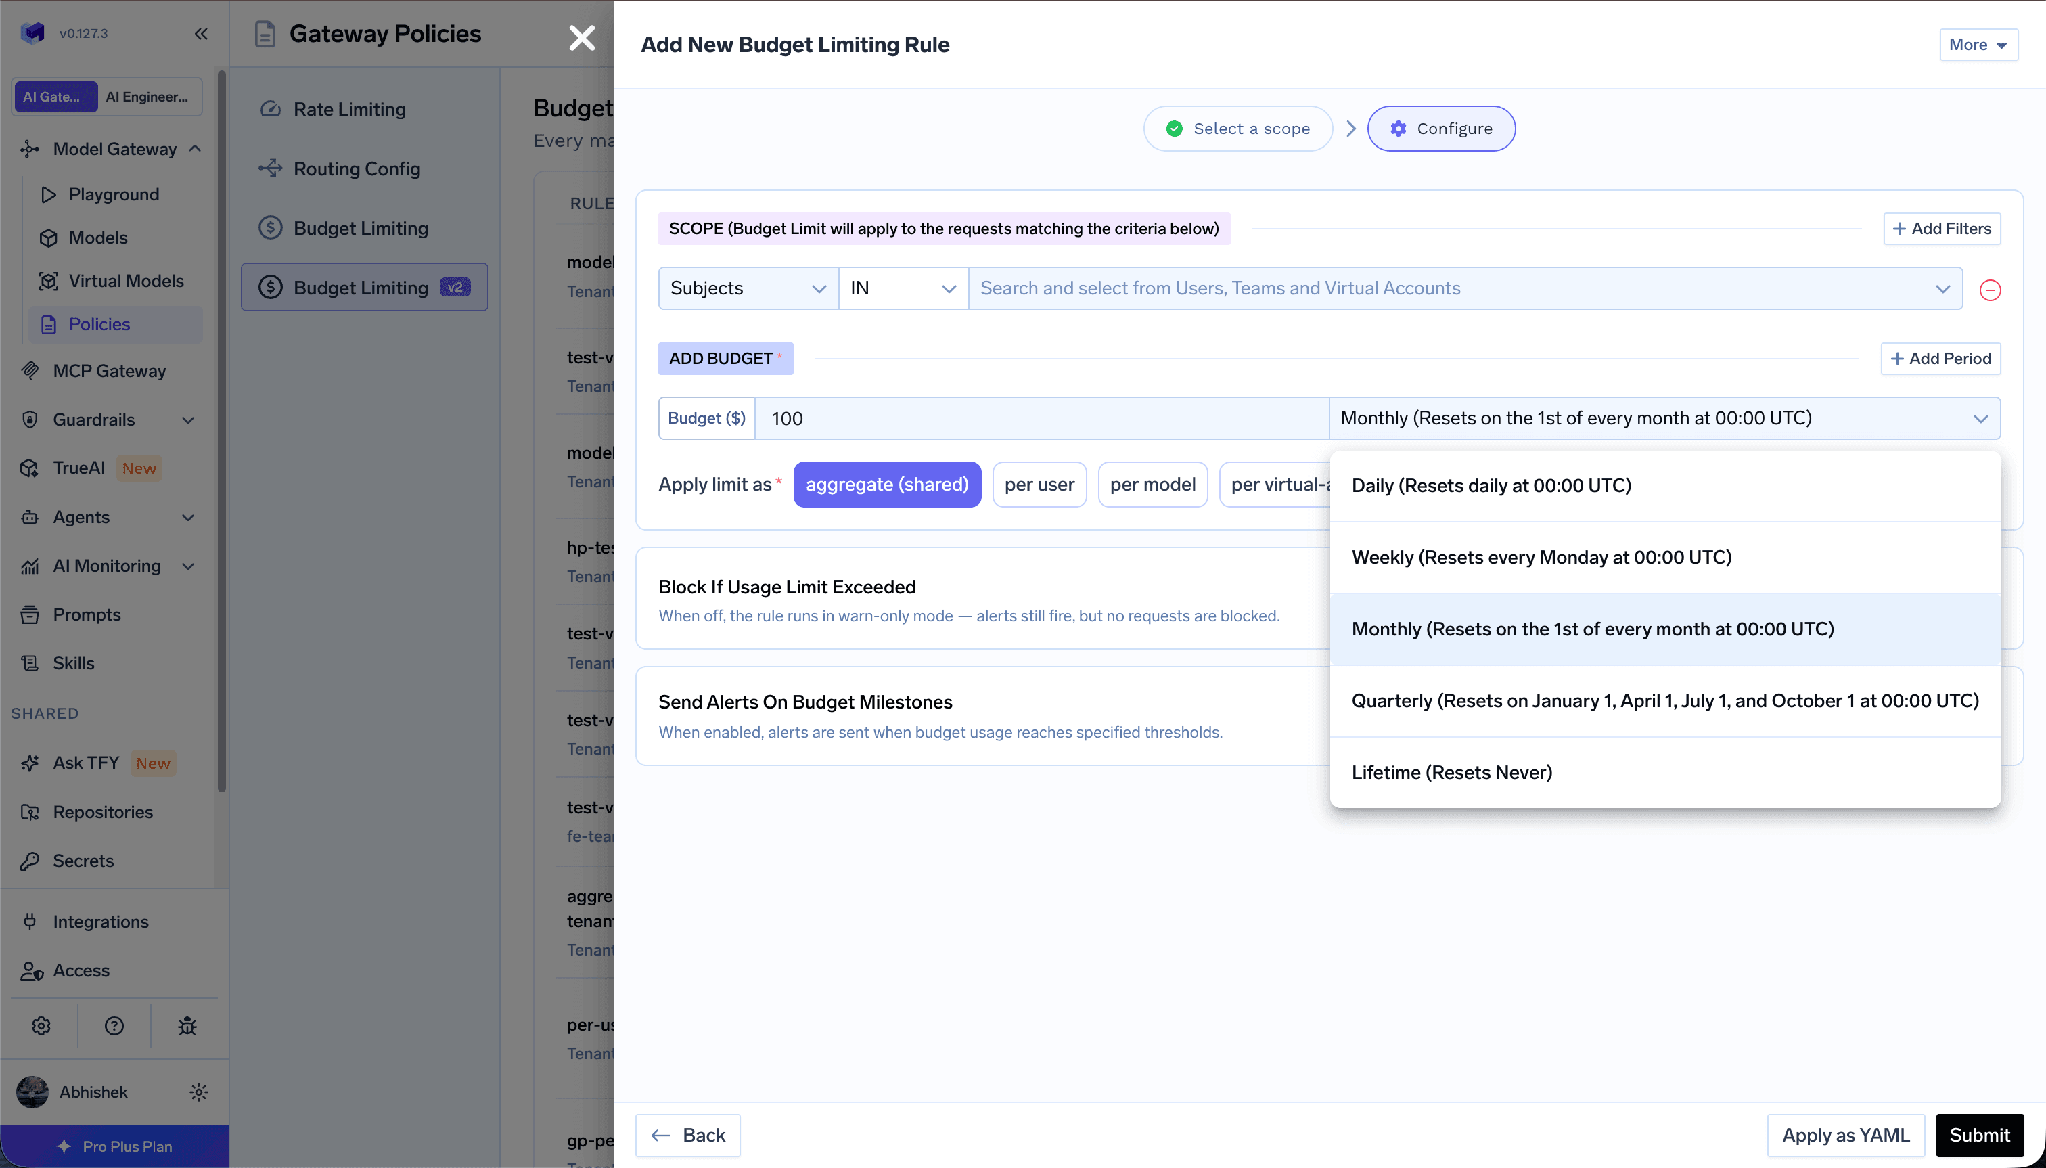
Une seule règle peut appliquer plusieurs périodes à la fois, en bloquant si l'une d'entre elles est dépassée — l'exemple multi-period-cap de la documentation définit ensemble cost_per_day: 0.5, cost_per_month: 0.5 et cost_per_quarter: 2. Les filtres de portée — Sujets, Modèles, Comptes fournisseurs, Métadonnées — acceptent IN/NOT IN et se combinent avec AND :
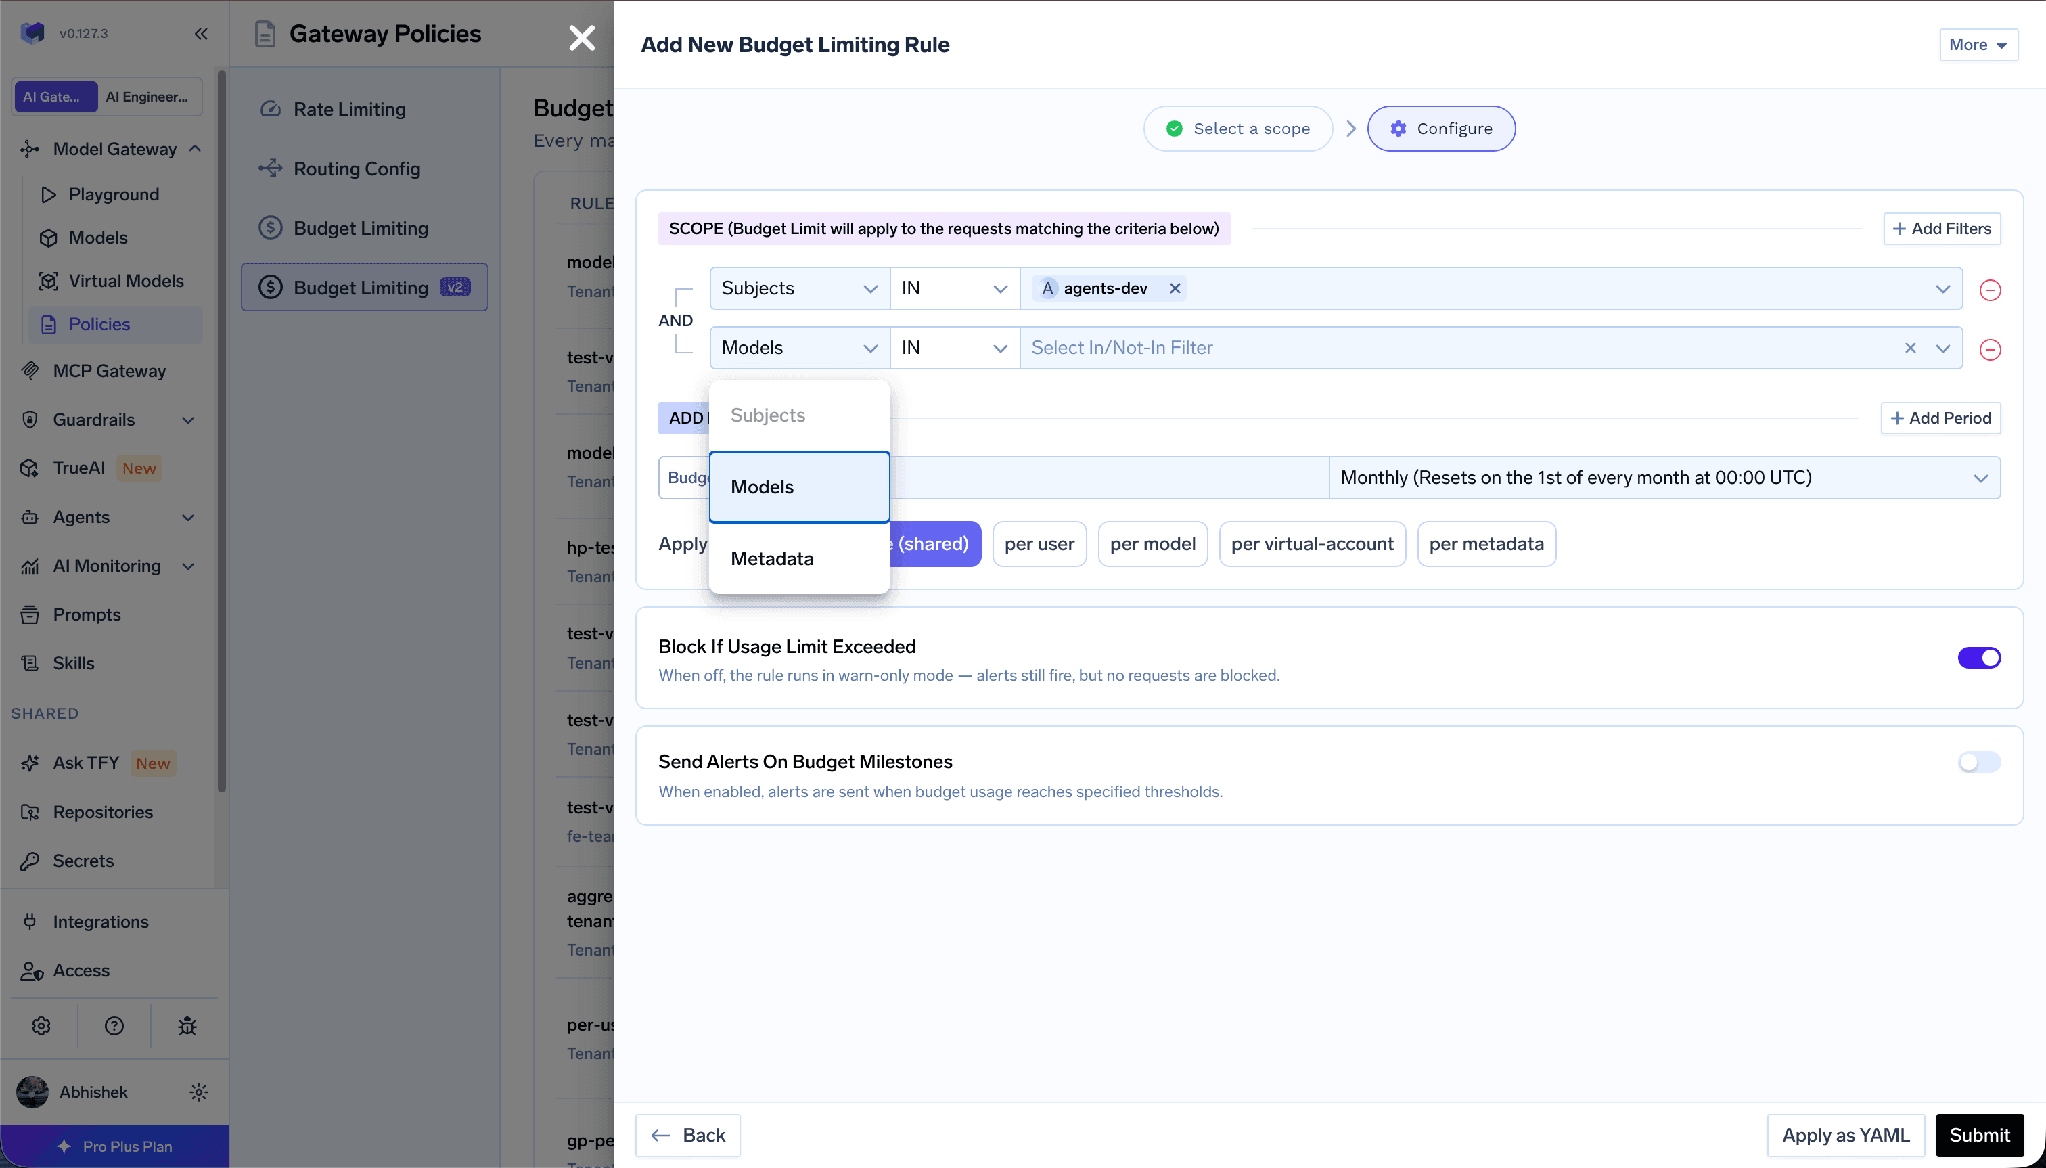
Apply limit as (applies_to.type) accepte aggregate, per-user, per-model, per-virtual-account, ou metadata avec une clé, et ne peut pas être modifié après la création. Les règles par entité prennent en charge des dérogations (overrides) pour des utilisateurs, modèles, comptes virtuels ou valeurs de métadonnées nommés :
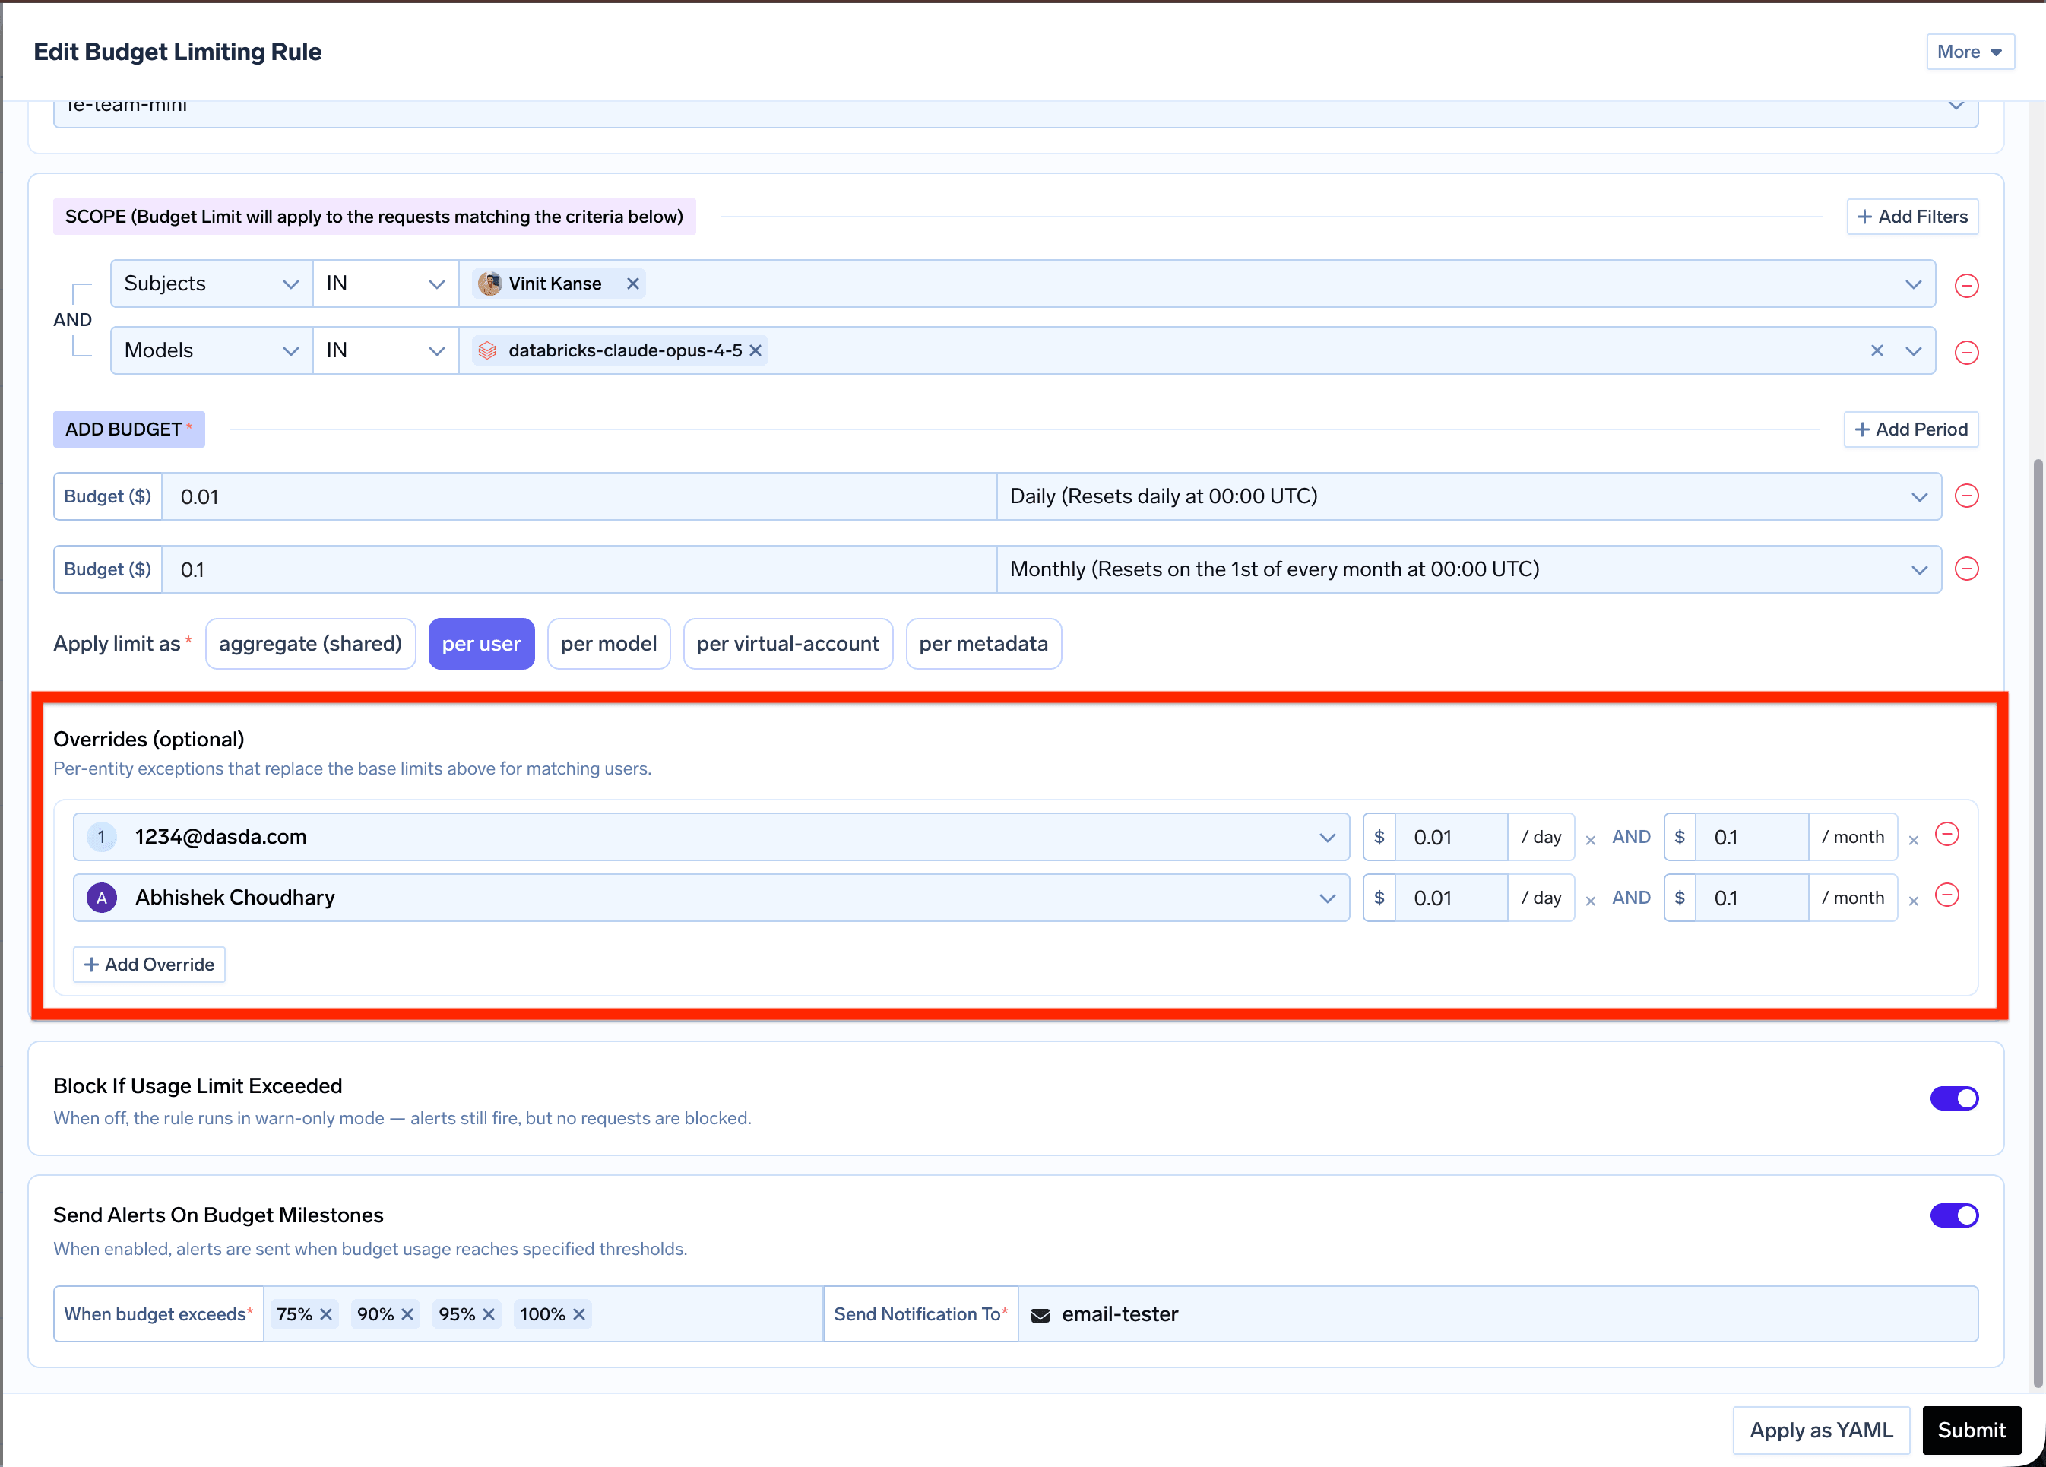
Une dérogation remplace toutes les périodes pour cette entité. Si la règle de base définit des plafonds quotidien et trimestriel et que la dérogation ne définit qu'un plafond quotidien, cette entité n'aura aucun plafond trimestriel. Incluez chaque période que vous souhaitez voir appliquée.
Trois modes : enforce (par défaut, rejet), audit (laisser passer, suivre, alerter), et soft_enforce — bloqué uniquement si aucun autre budget correspondant ne peut l'autoriser ; si un autre a de la marge, la requête passe et le dépassement est journalisé comme une violation d'audit. Un dépassement en mode enforce strict l'emporte toujours.
Les alertes se déclenchent à 75, 90, 95 et 100 pour cent, chacune une fois par période de budget, séparément pour chaque entité sur un budget par entité ; les budgets À vie alertent une fois par seuil au total. Cibles : email, slack-webhook, slack-bot, pagerduty, ms-teams-webhook, avec {{user.email}} pour la livraison par utilisateur.
Une mise en garde : les compteurs de budget démarrent à la création de la règle, pas au début de la période. Les dépenses antérieures ne sont pas comptabilisées rétroactivement, donc une règle créée au milieu du mois ne concordera pas avec votre facture pour cette période.
Les budgets ne valent que par la précision des tarifs sur lesquels ils s'appuient, c'est pourquoi cette tarification est ouverte. Le catalogue disponible sur github.com/truefoundry/models est la base de données de tarification utilisée pour le suivi des coûts publics, consultable sur truefoundry.com/models. Consultez le tarif qui vous est facturé ; ouvrez une PR s'il est incorrect.
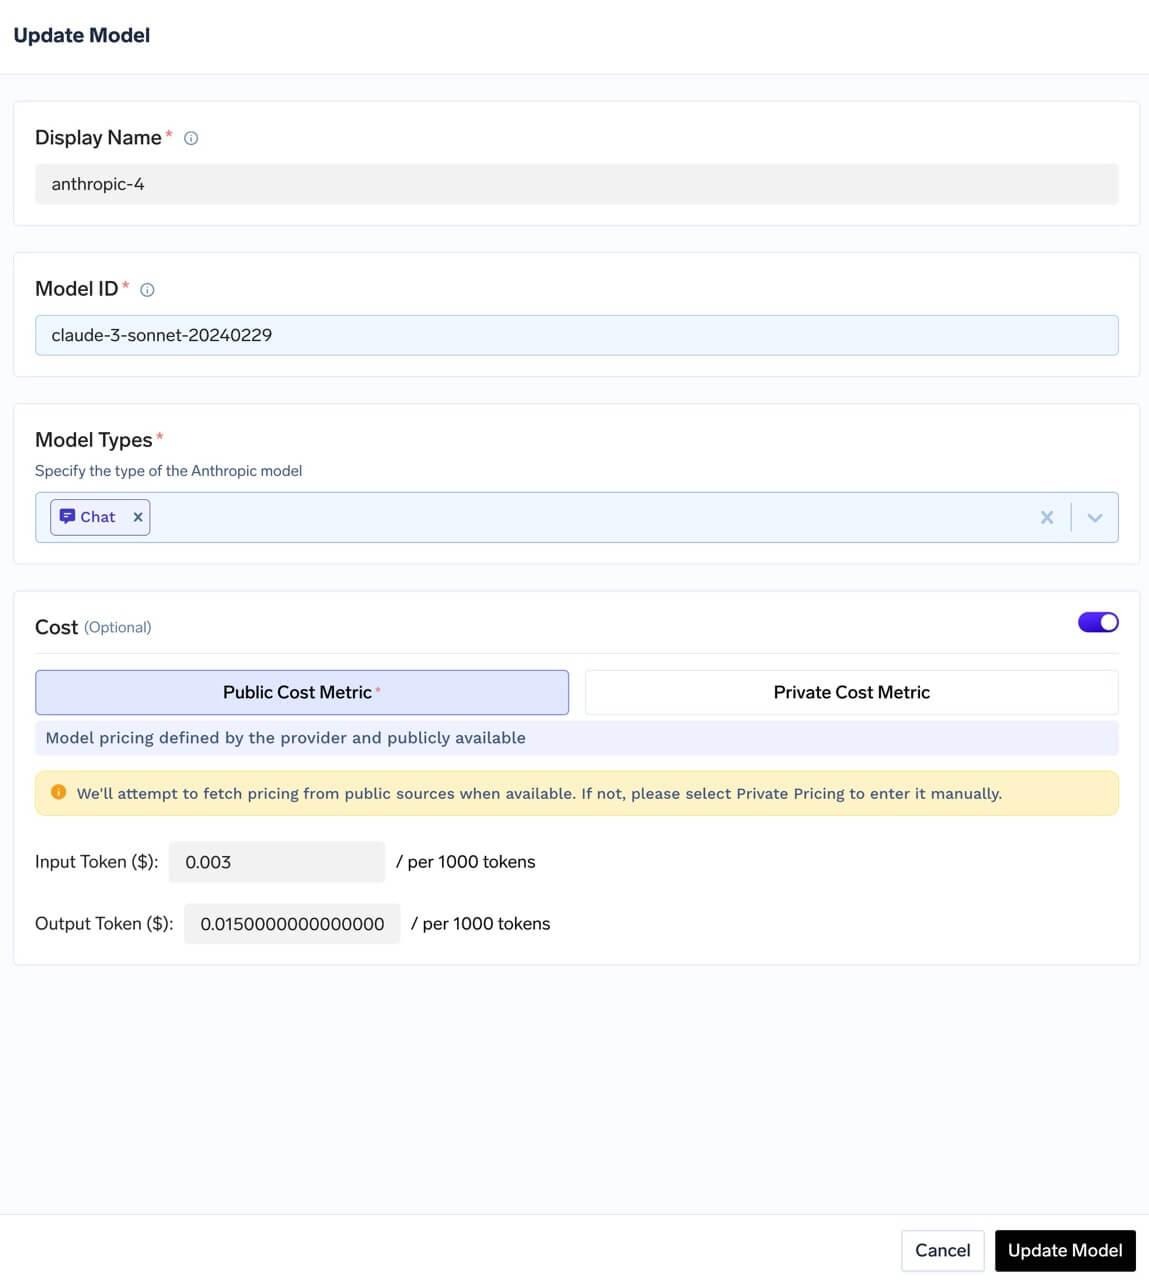
Deux détails sont importants. Tarification par région : providers/aws-bedrock/us.amazon.nova-lite-v1:0.yaml comporte des tarifs d'entrée et de sortie différents pour us-west-2, us-west-1, eu-central-1 et eu-west-1, de sorte que le trafic multi-région n'est pas évalué à un tarif forfaitaire erroné. Tarification par paliers : providers/google-gemini/gemini-2.5-pro.yaml a des tarifs de base ainsi que des tarifs plus élevés à partir de 200K tokens, et gemini-1.5-flash.yaml applique des paliers à partir de 128K tokens. Les longs contextes ne sont pas tarifés de manière linéaire. Les modèles sans tarification publique utilisent une entrée Private Cost.
Un budget par utilisateur ne fonctionne que si les requêtes sont attribuées de manière fiable. Trois mécanismes rendent cela automatique au lieu d'en faire une question de discipline de développeur :
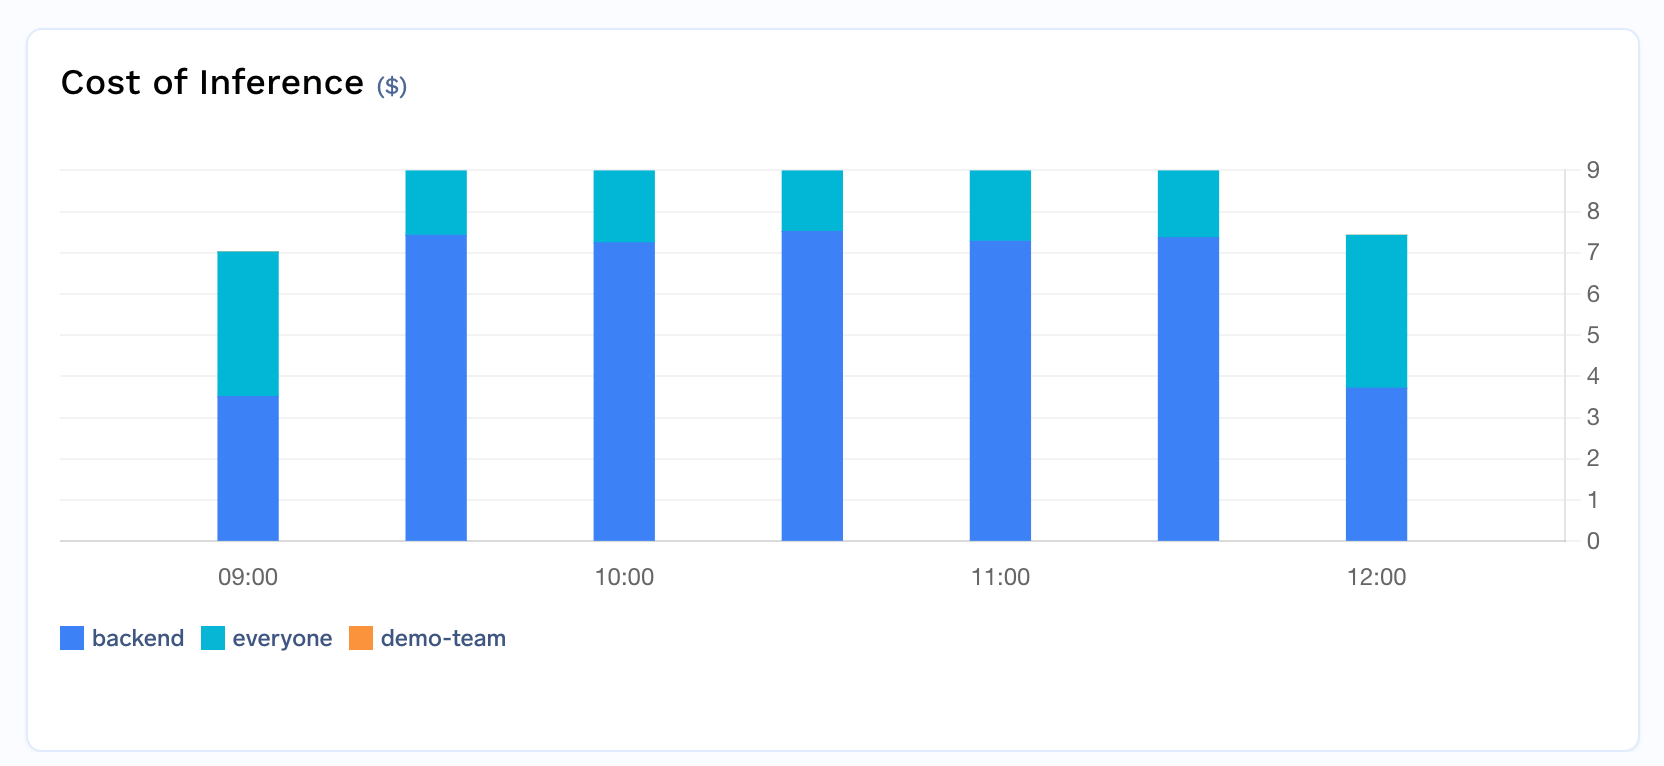
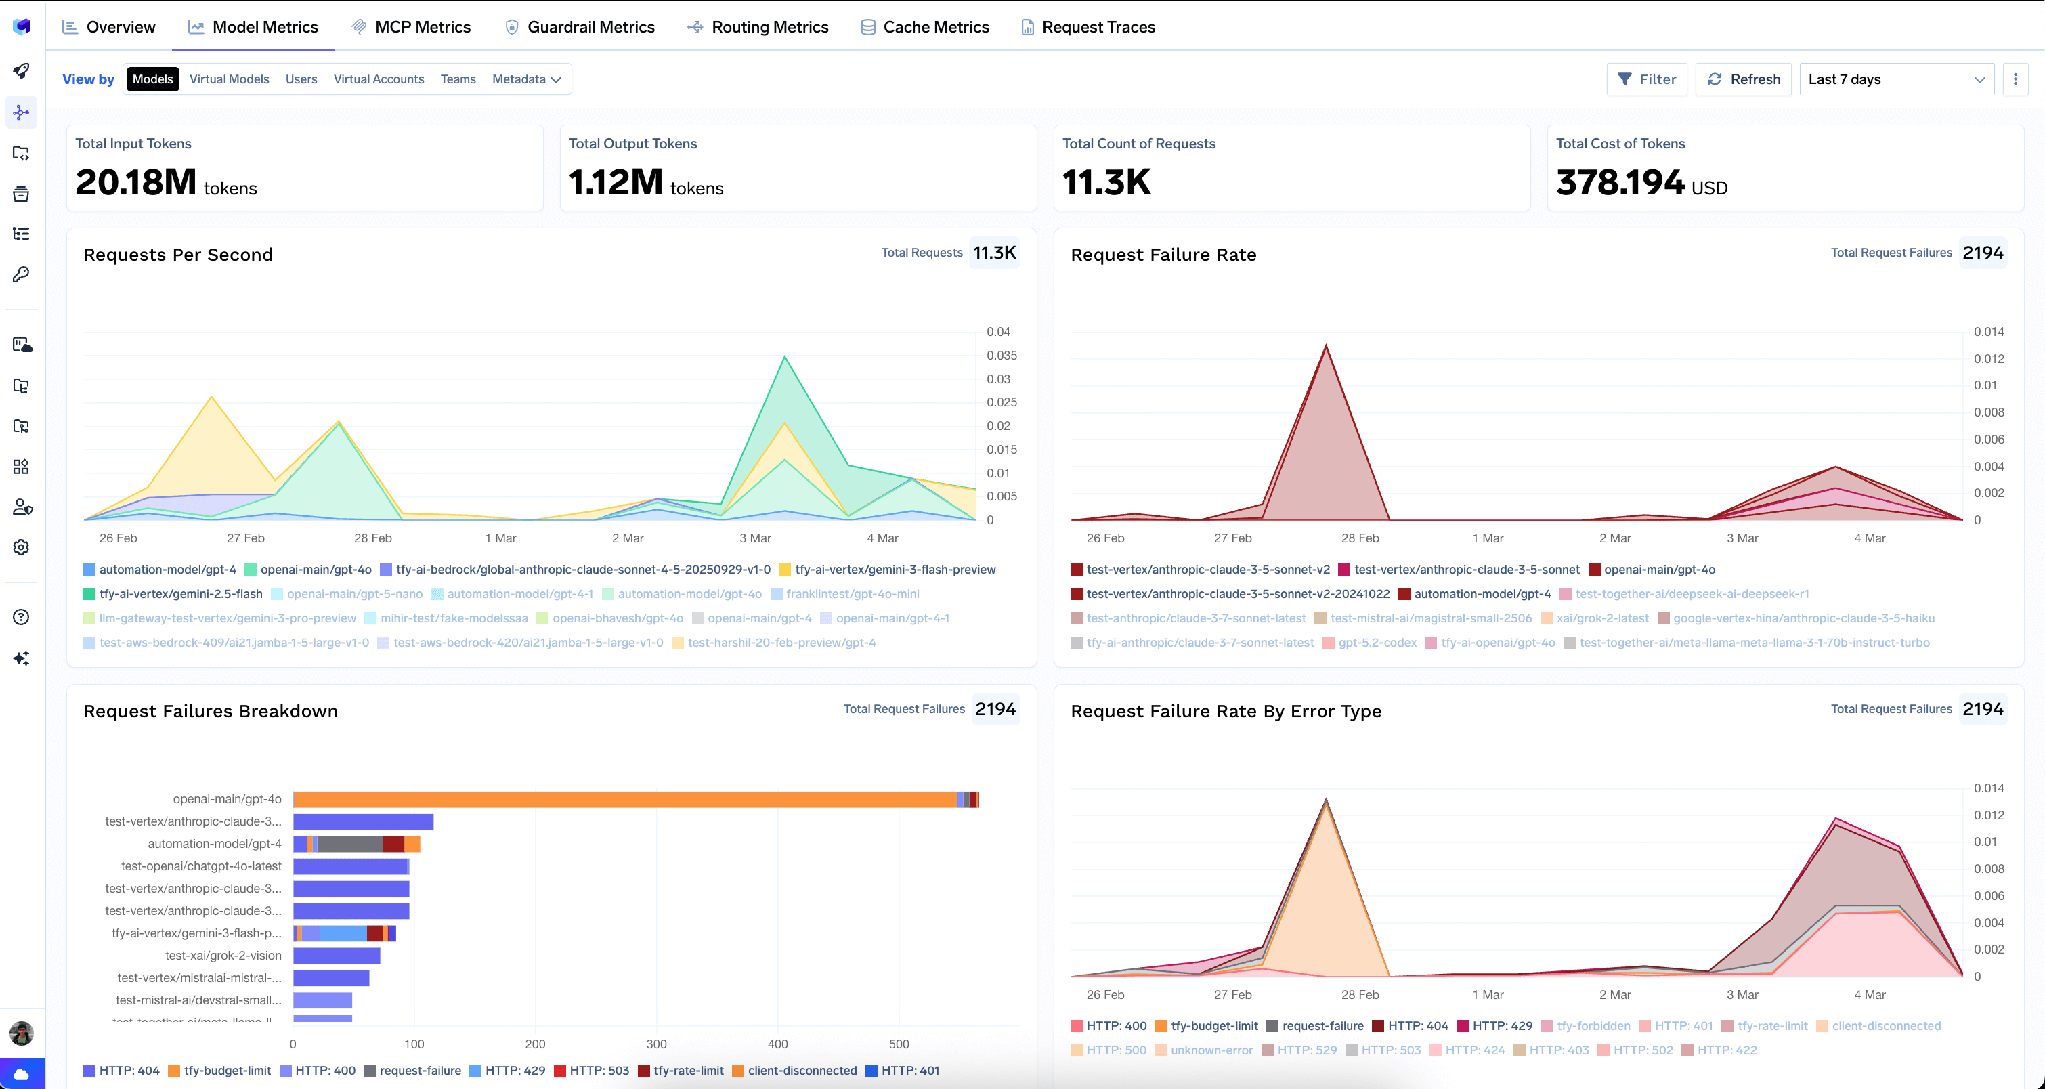
Model Metrics suit Total Input Tokens, Total Output Tokens et Total Cost of Tokens en USD, exportables via Metrics → 3 petits points → Download Raw Data regroupés par username, model_name ou teams :
Une passerelle, trois groupes : un assistant destiné aux clients, un agent de codage interne et une équipe de données effectuant de l'extraction en masse, tous sur le même compte fournisseur. L'agent de codage a eu un comportement anormal un après-midi le mois dernier et tous les autres utilisateurs ont reçu des erreurs 429.
Éviter la privation de ressources. Le problème venait d'un compteur partagé, non d'une limite manquante. Placez une règle coding-agent-tpm (200 000 tokens_per_minute, subjects: ["virtualaccount:coding-agent"]) au-dessus d'une règle générique à l'échelle du tenant (500 000 tokens_per_minute, when: {}), et attribuez à la règle générique rate_limit_applies_per: ['virtualaccount'] afin que l'agent ne puisse pas épuiser le quota de tout le monde en correspondant aux deux règles. Ajoutez également une règle requests_per_minute sur les mêmes sujets : les requêtes échouées comptent pour celle-ci, mais pas pour la règle de tokens.
Ajouter le plafond financier. Un budget mensuel par utilisateur sur l'agent de codage avec une dérogation pour un ingénieur, plus un plafond À vie sur le projet d'extraction :
Les deux sont vérifiés à chaque requête correspondante et les deux doivent valider la requête. La dérogation augmente le plafond d'un ingénieur sans assouplir celui des autres, et comme elle remplace toutes les périodes, elle répète celles de la règle de base.
Commencer en mode audit, puis attribuer. Exécutez le mode : audit pendant une semaine : l'utilisation est suivie et les alertes se déclenchent, rien n'est bloqué. Analysez les alertes à 75 %, ajustez par rapport au trafic réel, puis appliquez la limitation. Taggez chaque compte virtuel et exigez la sélection d'équipe sur les PAT : le rapport de facturation interne se génère tout seul — tout l'intérêt de l'attribution des coûts par équipe.
Les deux systèmes s'appliquent dans des directions opposées. La limitation de débit fonctionne selon le principe du premier match gagnant ; une seule règle bloque. Budget V2 exige la validation de l'ensemble (all-must-pass) ; chaque règle correspondante peut bloquer. Si vous appliquez la logique de l'un à l'autre, vos politiques vous surprendront.
Les budgets ne peuvent pas être définis en tokens, et les limites de débit ne peuvent pas être définies en dollars. Vous avez besoin des deux. Et l'URL de la documentation est /ai-gateway/ratelimiting, en un seul mot — avec un trait d'union, vous obtiendrez une erreur 404.
Le suivi des coûts audio est plus restreint que le suivi des coûts de tokens. Il couvre la synthèse vocale et la reconnaissance vocale ElevenLabs et Google Vertex ; les autres fournisseurs audio enregistrent l'utilisation mais pas de coût par caractère ou par seconde, et la tarification audio privée ne concerne que Google Vertex. La reconnaissance vocale sans durée signalée par le fournisseur est évaluée à zéro — un budget autorisera alors un trafic illimité qu'il considère comme gratuit.
Passer des requêtes aux tokens représente une modification simple de configuration mais entraîne des conséquences majeures. Un compteur de requêtes vous indique votre niveau d'activité ; un compteur de tokens vous indique ce que vous achetez ; un budget vous indique quand vous arrêter.
Organisez correctement vos couches et le reste suivra : les limites de tokens lissent la minute, les limites de requêtes protègent le chemin d'accès, les budgets régissent le mois, et un plafond À vie gère le reste. Le comportement décrit ici est issu de la documentation de TrueFoundry de septembre 2026.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




La même idée — plafonner ce qu'un appelant peut consommer sur une fenêtre — mais l'unité change. La limitation de débit d'API classique compte les requêtes, ce qui fonctionne lorsque les requêtes coûtent à peu près la même chose. Les requêtes LLM varient de plusieurs ordres de grandeur en tokens, si bien qu'une limite de tokens reflète bien mieux la consommation réelle. Utilisez les deux : les tokens régissent le rythme des dépenses, les requêtes protègent la connexion contre les tempêtes de nouvelles tentatives.
Les deux. Une limite de tokens est un contrôle de débit sur une fenêtre glissante : elle empêche un appelant de monopoliser la capacité à l'instant présent. Un budget est un contrôle financier sur une période calendaire : il empêche une équipe de trop dépenser ce mois-ci. Une limite de tokens ne peut pas exprimer des dollars, puisqu'un même nombre de tokens coûte des montants différents selon les modèles — et un budget ne dit rien de la minute en cours.
Une requête en échec — rejetée par la passerelle, ou mise en échec par le fournisseur avec un code 4XX ou 5XX — compte pour une requête dans chaque règle requests_per_* à laquelle elle correspondait. La seule exception est une requête déjà rejetée avec un 429 par la limitation de débit elle-même. Les limites de tokens ne sont pas affectées : une requête en échec ne déclare aucun token.
Oui. TrueFoundry s'exécute dans votre VPC, on-premise, en environnement air-gapped ou en hybride, de sorte que les prompts et les réponses ne quittent jamais votre domaine, même lorsque vous routez vers de nombreux fournisseurs.
Environ 3 à 4 ms de surcoût, en traitant plus de 350 RPS sur un seul vCPU, pour plus de 1 000 LLM pris en charge. L'exception est le classifieur LLM facultatif, qui ajoute un véritable appel de modèle avant le transfert de la requête.
Oui. La passerelle est conforme à OpenTelemetry et se connecte à Grafana, Datadog ou Prometheus. Chaque appel au classifieur LLM produit son propre span, de sorte que la latence du classifieur est visible séparément de celle du modèle servi.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















