



October 10, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: October 10, 2026
¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Las técnicas de ingeniería de prompts ayudan a los equipos a redactar mejores instrucciones para los modelos de lenguaje, mejorar la calidad de los resultados y reducir errores evitables. OpenAI describe la ingeniería de prompts como la redacción de instrucciones eficaces para que los modelos generen contenido que cumpla con los requisitos. Anthropic señala que la ingeniería de prompts funciona mejor cuando los criterios de éxito pueden controlarse mediante el prompting.
Para los equipos empresariales, la ingeniería de prompts ya no es una habilidad de productividad personal. Ahora afecta al coste del modelo, la latencia, la fiabilidad, el cumplimiento normativo y la experiencia del usuario. Un prompt que añade tres frases de razonamiento puede duplicar el gasto en tokens en un mes con un millón de solicitudes. Un prompt que otorga a un agente acceso inseguro a herramientas puede constituir un incidente de control de acceso.
Esta guía explica los métodos de ingeniería de prompts más útiles, cuándo aplicar cada uno y dónde debe conectarse la disciplina a nivel de prompt con la gobernanza de la pasarela de IA. También explica cómo TrueFoundry ayuda a los equipos a gobernar prompts, modelos, herramientas MCP, presupuestos y agentes en producción.
La ingeniería de prompts es la práctica de diseñar prompts para LLM con el fin de producir resultados de IA fiables, precisos y con el formato adecuado. Es la interfaz principal entre la intención humana y el comportamiento del modelo de IA. La calidad de esa interfaz afecta directamente a la fiabilidad, el coste, la seguridad y la utilidad de la aplicación en diferentes tareas.
La disciplina ha pasado de redactar instrucciones concisas para una pregunta sencilla a construir arquitecturas de prompts para flujos de trabajo agentes. Un prompt moderno puede incluir variables de entrada, reglas de salida estructurada, contexto adicional, configuración del modelo, salvaguardas y requisitos de política para su uso en producción.
La implicación práctica es clara. Los equipos que tratan los prompts como texto desechable suelen lanzar aplicaciones de IA de menor calidad. Los equipos que aplican técnicas sistemáticas de ingeniería de prompts con control de versiones, evaluación y gobernanza tienen un camino más sólido hacia respuestas precisas y mejores resultados.
El sistema de TrueFoundry Gestión de Prompts refleja ese cambio. Un prompt guardado almacena el mensaje del sistema, el mensaje del usuario, las variables de entrada, las salvaguardas y la configuración de salida estructurada en un único objeto versionado. Las aplicaciones pueden hacer referencia a él mediante un nombre completo en lugar de incrustar el texto del prompt.
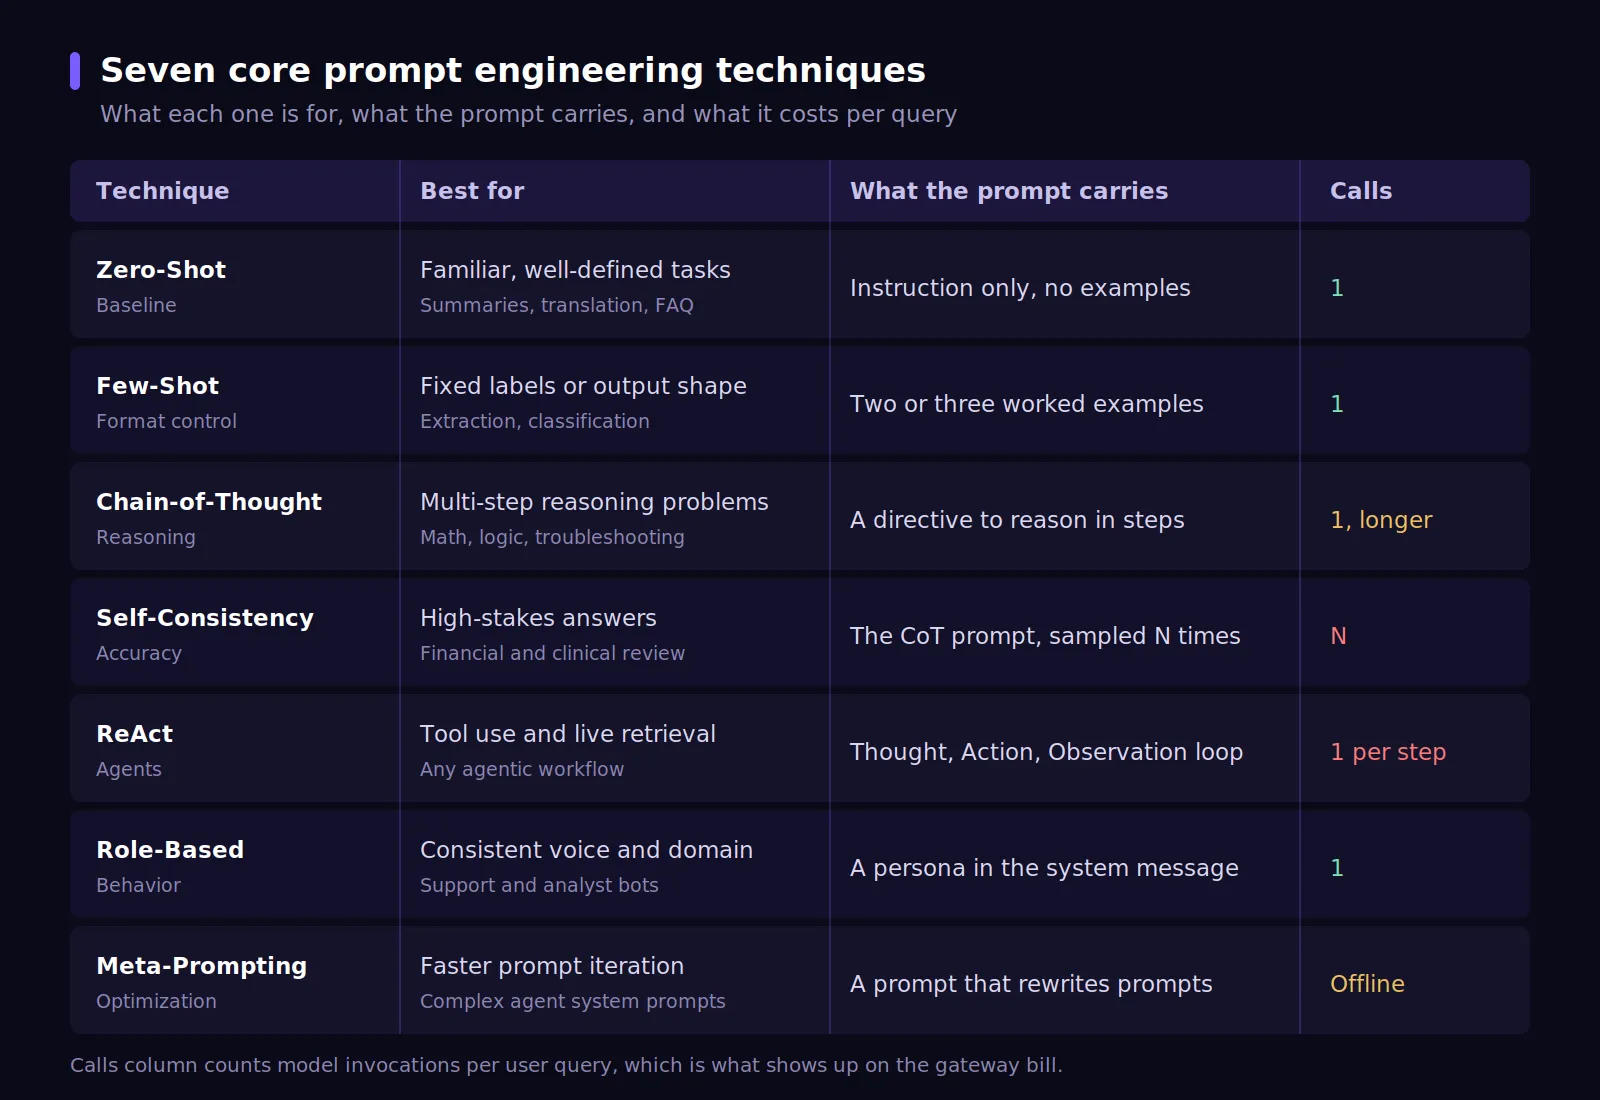
Siete técnicas fundamentales de ingeniería de prompts cubren la mayor parte del trabajo en producción. Léalas como una progresión. Cada una aporta precisión, estructura o control. Cada una también supone un coste para los equipos en términos de tokens, latencia, esfuerzo de mantenimiento o complejidad de gobernanza.
El prompting zero-shot pide al modelo de lenguaje grande que complete una tarea específica sin ejemplos previos. El modelo se basa en sus datos de entrenamiento y en el sentido común para inferir el formato, el contenido y el tono de respuesta correctos a partir de la instrucción por sí sola.
Ideal para: Tareas bien definidas donde el modelo ya comprende el patrón. Algunos ejemplos incluyen el resumen, la traducción, la clasificación sencilla, la respuesta a preguntas frecuentes y la extracción de hechos relevantes a partir de entradas breves.
Limitación: La fiabilidad del zero-shot disminuye cuando la tarea deseada requiere un formato estricto o un comportamiento específico del dominio. El fallo suele ser silencioso. Un clasificador zero-shot devuelve una etiqueta plausible en lugar de un error, por lo que el defecto aparece más tarde en forma de análisis deficientes o menor satisfacción del usuario.
El prompting few-shot proporciona uno o más ejemplos de entrada-salida antes de la solicitud real. Estos ejemplos detallados ofrecen al modelo un patrón concreto a seguir, especialmente cuando el resultado deseado requiere un tono, esquema, conjunto de etiquetas o estructura de redacción específicos.
Ideal para: Tareas donde la forma del resultado es importante. Úselo para clasificaciones con etiquetas fijas, extracción de datos estructurados, coincidencia de estilo, tono específico del dominio y requisitos de formato repetibles.
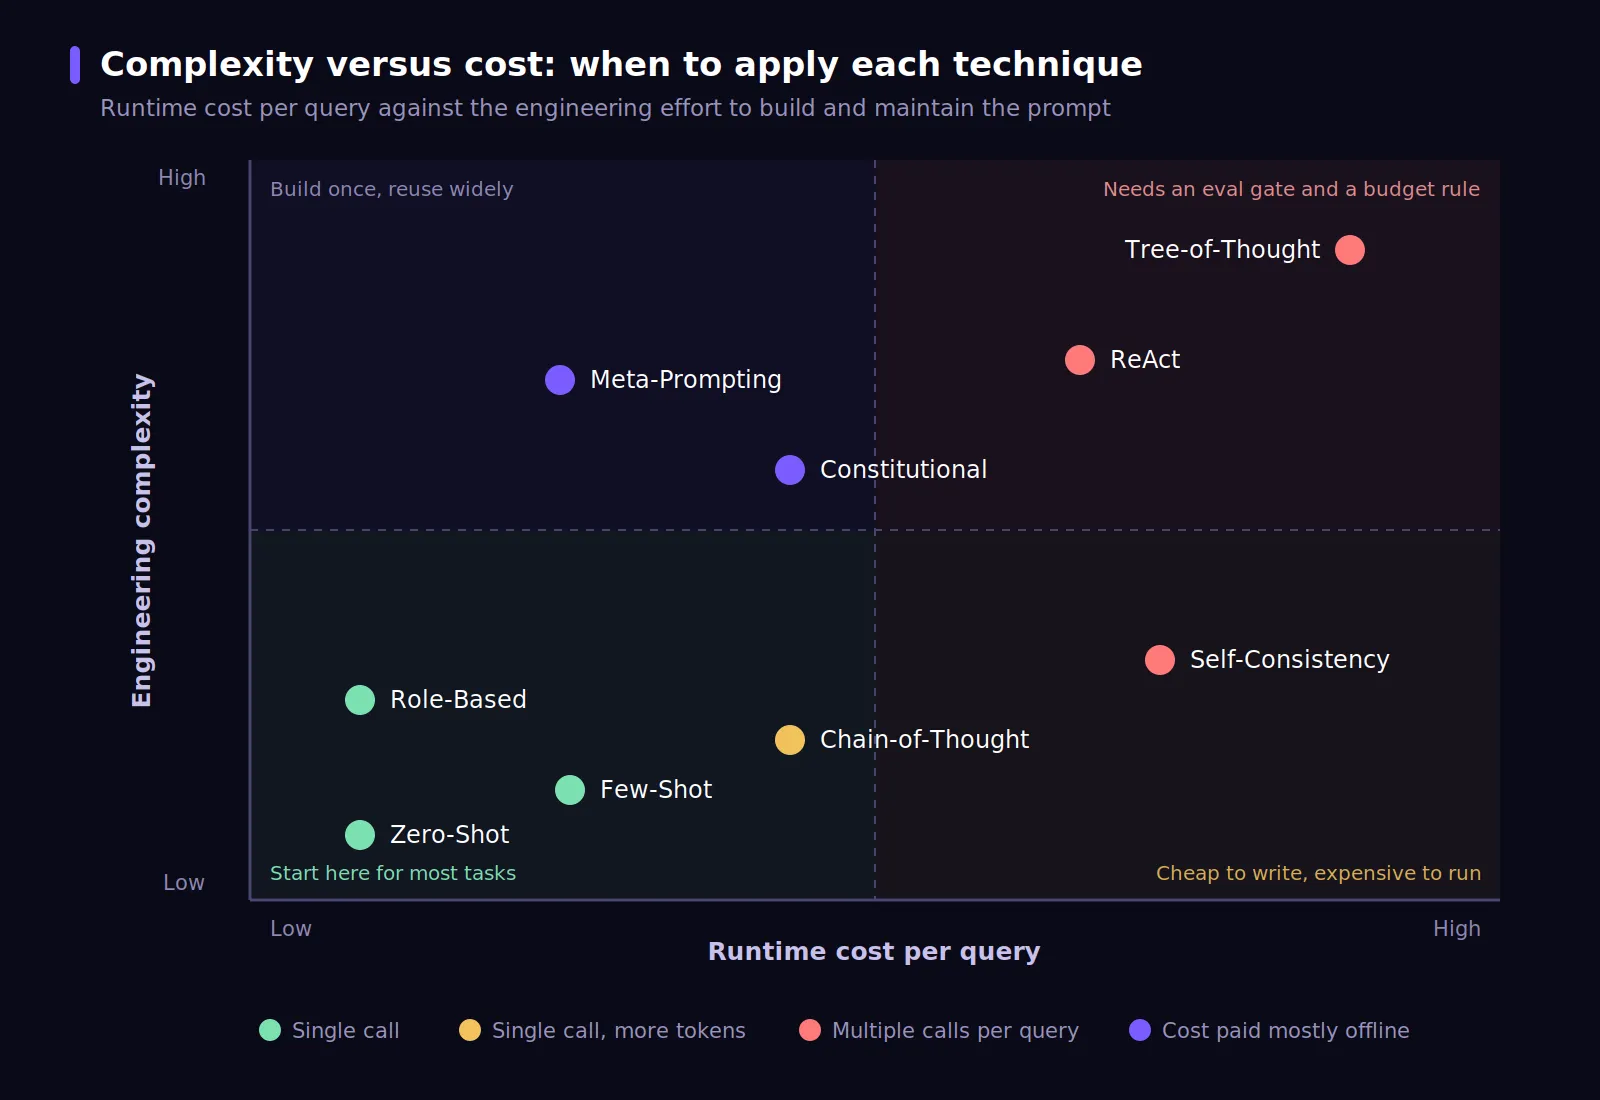
¿Cuántos ejemplos?: Dos o tres ejemplos suelen funcionar bien para muchas tareas de producción. Un mayor número de ejemplos puede mejorar la calidad del prompt, aunque cada solicitud paga por esos tokens. Los equipos deben evaluar el equilibrio antes de utilizar prompts más largos en endpoints de alto volumen.
El prompting de cadena de pensamiento solicita al modelo que razone a través de pasos intermedios antes de generar la respuesta final. Puede mejorar el rendimiento en problemas matemáticos, tareas lógicas, flujos de trabajo de resolución de problemas o problemas de programación donde el razonamiento intermedio afecta al resultado.
Ideal para: Razonamiento complejo, árboles de decisión, diagnósticos técnicos, análisis financiero y tareas de razonamiento complejo. Funciona mejor cuando el prompt solicita una resolución de problemas deliberada en lugar de una respuesta corta.
CoT Zero-shot: Añadir una instrucción de razonamiento paso a paso puede activar el comportamiento de cadena de pensamiento sin necesidad de proporcionar ejemplos de cadenas de razonamiento. Sigue siendo una forma sencilla de mejorar el razonamiento en tareas complejas.
Combinación con few-shot: Los ejemplos few-shot que incluyen rutas de razonamiento pueden mejorar el rendimiento en flujos de trabajo específicos de un dominio. Los equipos deben mantener la respuesta mostrada concisa cuando los usuarios solo necesiten la respuesta final.
Aquí hay una advertencia operativa importante. La salida de la cadena de pensamiento es larga, y las salidas largas son precisamente lo que los equipos transmiten (stream) para mantener baja la latencia percibida. La documentación de guardrails de TrueFoundry establece que los guardrails de salida se omiten cuando una solicitud establece `stream: true`, porque no hay una respuesta completa que evaluar. El razonamiento que se transmite es un razonamiento que ninguna política de salida inspecciona.
La autoconsistencia amplía el prompting de cadena de pensamiento generando múltiples cadenas de razonamiento independientes para la misma pregunta. El sistema selecciona entonces la respuesta final más consistente entre las muestras.
Ideal para: Razonamiento de alto riesgo donde la precisión de la respuesta es más importante que el coste de inferencia. Algunos ejemplos incluyen revisiones de riesgos, apoyo al razonamiento legal, análisis financiero, estudios de casos y recomendaciones sensibles a la seguridad.
Equilibrio de costes: La autoconsistencia requiere múltiples llamadas al modelo por consulta. Cinco cadenas muestreadas convierten una solicitud facturable en cinco. La aplicación de presupuestos por equipo a través de una AI Gateway es esencial cuando los equipos aplican este método a gran escala.
El prompting ReAct combina el razonamiento con la acción. El modelo alterna entre un paso de Pensamiento, un paso de Acción y un paso de Observación. Este patrón permite al modelo razonar, invocar herramientas externas, leer el resultado y continuar hasta completar la tarea.
Ideal para: Flujos de trabajo de agentes que requieren recuperación de información, ejecución de herramientas, contexto en tiempo real o la finalización de tareas de varios pasos. ReAct es útil cuando un asistente de IA debe interactuar con bases de datos, API, herramientas SaaS o sistemas internos.
ReAct cambia la cuestión de la seguridad. El prompt ya no solo da forma al texto, sino que también influye en la selección de herramientas y en la secuenciación de acciones. Cuando las herramientas interactúan con sistemas empresariales, el MCP Gateway actúa como la capa de cumplimiento para permisos, validación y registro de auditoría.
El prompting basado en roles asigna al modelo una personalidad, un área de especialización o un contexto de comportamiento específico a nivel de prompt del sistema. "Eres un analista financiero senior que revisa la cartera de un cliente" produce patrones de razonamiento y estilos de respuesta diferentes a los de la misma pregunta sin una asignación de rol.
Ideal para: Aplicaciones específicas de dominio, agentes de atención al cliente con personalidades definidas, bots de soporte técnico y cualquier aplicación donde la coherencia en el tono y el contexto de comportamiento sea fundamental en todas las interacciones.
Aplicación empresarial: Los prompts del sistema basados en roles son un mecanismo principal para aplicar barreras de comportamiento a nivel de aplicación, antes de que se aplique el filtrado de resultados en la capa de infraestructura.
Tenga en cuenta un límite que sorprende a la mayoría de los equipos. La documentación de las barreras de seguridad de TrueFoundry confirma que los prompts del sistema están excluidos de la evaluación de barreras de forma predeterminada, por lo que la definición del rol en sí nunca se inspecciona, bloquea ni redacta. Las instrucciones de personalidad moldean el comportamiento, pero no actúan como una política que la infraestructura verifique.
El meta-prompting utiliza el LLM para analizar, criticar y mejorar los prompts en lugar de completar directamente las tareas del usuario final. Un ingeniero de prompts puede utilizarlo para generar candidatos, comparar patrones comunes y refinar instrucciones en menos tiempo.
Ideal para: Equipos que iteran con frecuencia en el diseño de prompts y desean acelerar la optimización. Es útil para actividades complejas, planificación estratégica y prompts de sistemas de agentes con muchos elementos clave.
Nota de producción: El meta-prompting genera prompts candidatos que aún requieren una evaluación frente a un conjunto de pruebas antes de su paso a producción. Acelera el paso de generación de candidatos, no el de validación.
Unaflujo de trabajo sistemático de mejora de prompts mantiene esa distinción clara al puntuar a los candidatos frente a un conjunto de evaluación fijo en lugar de basarse en la impresión de un revisor.
Las técnicas avanzadas que se presentan a continuación sacrifican más capacidad de cómputo o esfuerzo de diseño a cambio de mejoras en problemas que las técnicas más sencillas resuelven con dificultad. Úselas cuando un conjunto de evaluación demuestre que el método más sencillo se ha estancado.
Tree-of-Thought amplía el prompting de cadena de pensamiento lineal hacia una estructura ramificada. El modelo explora múltiples rutas de razonamiento, evalúa posibles soluciones y selecciona la rama más prometedora para continuar.
Ideal para: Problemas en los que la ruta de solución no es obvia desde el planteamiento inicial. Algunos ejemplos incluyen la síntesis de investigación, trabajos creativos como un relato corto, el desarrollo de estrategias, la depuración compleja y la planificación abierta.
Tree-of-Thought puede mejorar los resultados en tareas de razonamiento difíciles. También escala el coste a través del factor de ramificación y la profundidad. Esto hace que los límites presupuestarios sean importantes antes de que la técnica llegue a los puntos finales orientados al cliente.
El prompting constitucional integra un conjunto de principios en el prompt del sistema. El modelo utiliza esos principios para autoevaluar y revisar su propia respuesta antes de devolver un resultado.
Ideal para: Aplicaciones de IA donde la alineación coherente con los valores organizativos, las normas de seguridad o los estándares de cumplimiento es fundamental. Puede ayudar a guiar el comportamiento antes de que se ejecute el filtrado posterior a la generación.
Trate la constitución como un control de calidad, no como un control de auditoría. Los principios residen dentro del prompt del sistema. La evidencia de cumplimiento debe provenir de barreras de seguridad, seguimientos, resultados de políticas y registros que el modelo no pueda influenciar.
El prompting de estímulo direccional añade una breve pista, palabra clave o señal de guía para dirigir al modelo hacia la información más relevante. Puede ser útil cuando el prompt base es claro, pero el modelo necesita una señal más fuerte sobre lo que es importante.
Ideal para: Tareas de clasificación, resumen y extracción donde una pequeña señal direccional mejora el enfoque. Por ejemplo, un resumen sobre el cambio climático puede utilizar un estímulo como "impactos de las políticas" para guiar la atención.
Esta es una técnica avanzada porque las pequeñas señales pueden cambiar la respuesta de forma inesperada. Los equipos deben comparar el rendimiento con una línea base y confirmar que el estímulo mejora el resultado deseado sin perjudicar otros casos.
Los métodos individuales de ingeniería de prompts funcionan de manera diferente en pruebas controladas que en entornos de producción con usuarios reales. Varias realidades operativas afectan a qué técnicas siguen siendo viables una vez que el tráfico, el coste, el riesgo y la gobernanza aumentan.
El sistema integrado de TrueFoundry de protección contra inyección de prompts se ejecuta únicamente en modo de validación y analiza el prompt del usuario y cualquier documento o contenido de contexto como dos superficies independientes. Esta separación en el análisis es fundamental, ya que la inyección indirecta se produce dentro de los documentos recuperados y no en el mensaje directo del usuario.
Las técnicas de ingeniería de prompts determinan la eficacia con la que un LLM comprende y ejecuta una tarea. La capa de gobernanza determina si dicha ejecución se realiza de forma segura, dentro de los límites de costes y con los controles de acceso y las pruebas de auditoría que requiere la producción empresarial.
La AI Gateway de TrueFoundry aplica filtros de entrada antes de que los prompts lleguen a cualquier modelo, interceptando intentos de inyección de prompts independientemente de lo sofisticados que sean los métodos de ingeniería de prompts del sistema. Los guardrails de salida aplican políticas de contenido antes de que las respuestas vuelvan a las aplicaciones, complementando, en lugar de sustituir, el "constitutional prompting" a nivel de modelo.
El modelo de ejecución recompensa una lectura más atenta. Los guardrails de validación de entrada se ejecutan en paralelo con la solicitud al modelo y, cuando la validación falla durante el proceso, la pasarela cancela la solicitud al modelo para que el prompt bloqueado nunca genere costes. Los guardrails de mutación de entrada, como la redacción de PII, se ejecutan antes de la solicitud, ya que reescriben la carga útil que recibe el modelo.
Cada guardrail aparece en el seguimiento de la solicitud como su propio intervalo con latencia, veredicto, alcance y la entidad a la que se aplicó. El despliegue sigue la evidencia: comience con las reglas en modo Auditoría, promueva a Aplicar, pero ignorar en caso de error, y pase a Aplicar una vez que los resultados parezcan correctos.
Los guardrails pueden adjuntarse por solicitud a través de la cabecera `X-TFY-GUARDRAILS`, o de forma centralizada como políticas en AI Gateway → Controles → Guardrails para su aplicación en toda la organización.
{
  "llm_input_guardrails": ["my-group/prompt-injection"],
  "llm_output_guardrails": ["my-group/secrets-detection"],
  "mcp_tool_pre_invoke_guardrails": ["my-group/sql-sanitizer"],
  "mcp_tool_post_invoke_guardrails": ["my-group/code-safety"]
}
Los presupuestos de tokens por equipo aplicados a través de la pasarela de LLM evitan los sobrecostes que producen a escala las técnicas de autoconsistencia y "tree-of-thought" cuando no existe una gobernanza de costes. Las reglas de limitación de tasa aceptan unidades de token así como unidades de solicitud, y `rate_limit_applies_per` crea un contador independiente por usuario, por modelo o por clave de metadatos.
name: ratelimiting-config
type: gateway-rate-limiting-config
rules:
  # Cap the reasoning-heavy service that runs self-consistency
  - id: "reasoning-service-hourly"
    when:
      metadata:
        service: "risk-analysis"
    limit_to: 200000
    unit: tokens_per_hour

  # Give every user an independent daily token ceiling
  - id: "user-daily-limit"
    when: {}
    limit_to: 1000000
    unit: tokens_per_day
    rate_limit_applies_per: ['user']
Las reglas de presupuesto añaden límites en dólares por usuario, equipo, modelo, cuenta virtual o clave de metadatos. Las alertas de hitos y el modo de auditoría ayudan a los equipos a calibrar los umbrales antes de que la aplicación bloquee el tráfico.
Las aplicaciones pueden llamar a un prompt gobernado mediante un FQN de versión en lugar de enviar el texto con la aplicación. Esto mantiene las ediciones de los prompts fuera del ciclo de lanzamiento. La pasarela renderiza la plantilla y ejecuta la llamada.
from openai import OpenAI

client = OpenAI(
    api_key="your-tfy-api-key",
    base_url="{GATEWAY_BASE_URL}"
)

response = client.chat.completions.create(
    messages=[],
    model="",
    extra_headers={
        "X-TFY-METADATA": '{"service":"risk-analysis","env":"production"}',
    },
    extra_body={
        "prompt_version_fqn": "chat_prompt:truefoundry/default/cot-risk-review:3",
        "prompt_variables": {
            "portfolio_id": "PF-4471",
            "review_window": "Q3"
        }
    },
)

print(response.choices[0].message.content)
Dos detalles en esa llamada tienen peso. El anclaje de versión significa que una reversión de prompt nunca requiere un nuevo despliegue, y la cabecera `X-TFY-METADATA` es lo que hace que los presupuestos por servicio, los límites de tasa y la atribución de costes se resuelvan en un propietario real.
ElAgent Gateway gobierna cada llamada a herramienta que realizan los agentes basados en ReAct, de modo que los pasos de razonamiento y ejecución permanecen gobernados de forma independiente, y cada invocación de herramienta lleva el contexto de identidad del usuario en su registro.
La MCP Gateway proporciona los ganchos de pre-invocación y post-invocación que la hacen cumplir, y los guardrails evalúan cada llamada a herramienta por separado en lugar de una vez por conversación. Un agente que llama a cinco herramientas en secuencia obtiene cinco conjuntos de comprobaciones.
Los ganchos de pre-invocación detienen la acción antes de que se ejecute, cubriendo la validación de parámetros, la higienización de SQL y las comprobaciones de permisos escritas como políticas Cedar u OPA. Los ganchos de post-invocación inspeccionan la salida de la herramienta, detectando inyecciones indirectas y secretos filtrados antes de que el paso de Observación los devuelva al contexto del modelo.
Cree flujos de trabajo de prompts que permanezcan gobernados en producción.Solicite una demostración para ver cómo TrueFoundry conecta el registro de prompts, las barreras de seguridad, los controles presupuestarios y los registros de auditoría dentro de su AI Gateway.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada




















