



noviembre 18, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Cuando una llamada LLM es lenta, costosa o incorrecta, necesitas ver qué ha sucedido realmente. ¿Un guardrail redactó el prompt? ¿Cuánto tiempo tardó el modelo en comparación con la red? ¿Qué envió el gateway al proveedor? El registro de solicitudes y el tracing en AI Gateway responden a estas preguntas para cada llamada.
Como todas las solicitudes ya fluyen a través del gateway, obtienes esta visibilidad sin necesidad de instrumentar cada aplicación manualmente.
La documentación de registro de solicitudes te permite controlar qué solicitudes se registran. El control más sencillo es por solicitud, utilizando la cabecera X-TFY-LOGGING-CONFIG con un valor JSON convertido en cadena. Establece enabled a true para registrar la solicitud o a false para omitirla.
Un detalle importante a tener en cuenta: el valor de esa cabecera es un JSON convertido en cadena, no un objeto JSON sin procesar, porque la mayoría de los SDK serializan las cabeceras como cadenas. Los modos de registro globales anteriores se están reemplazando por una configuración de registro basada en reglas, que te permite controlar el registro por sujeto, modelo o metadatos y redactar valores confidenciales.
Para ver las solicitudes registradas en la interfaz de usuario, ve a AI Gateway, luego a Monitor y después a Requests. Esto te da la lista de todas las llamadas registradas, las cuales puedes abrir para inspeccionar una solicitud individual en detalle.
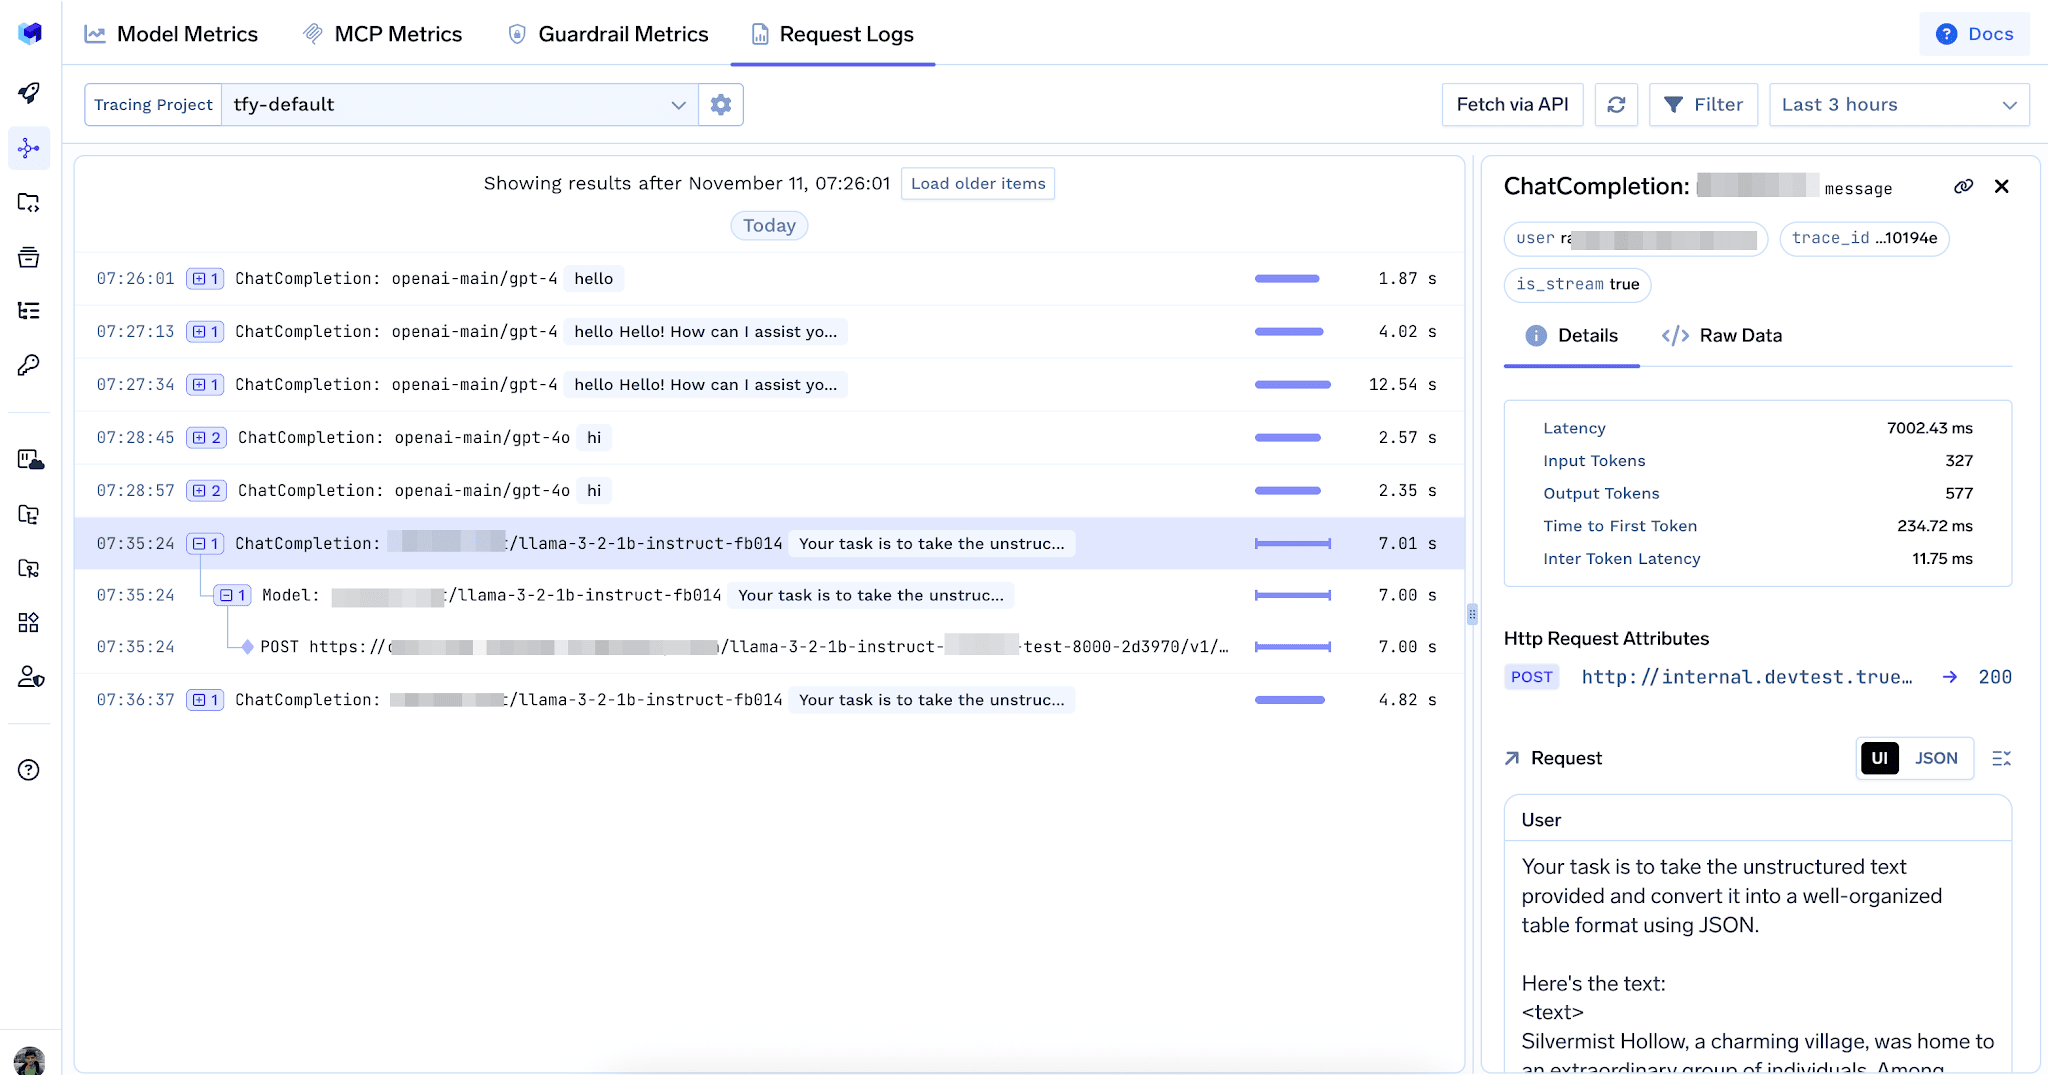
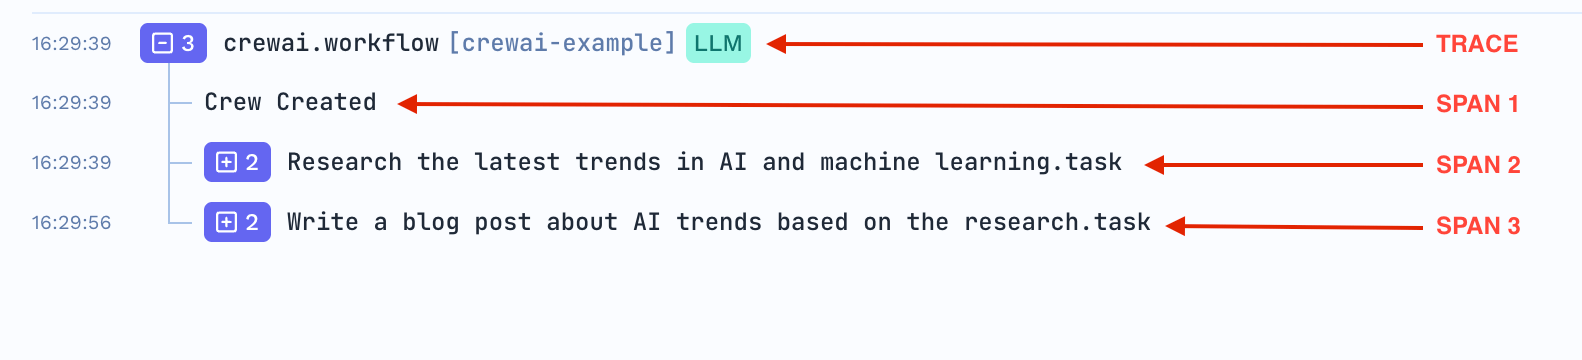
La documentación de tracing describe una trace como el ciclo de vida completo de una solicitud a medida que fluye por los servicios que interactúan con el LLM. Normalmente, una trace se corresponde con una única llamada a la API de una aplicación.
Un span es una unidad individual de trabajo dentro de esa trace, como una llamada a una función, una solicitud HTTP o una inferencia de modelo. Una trace es un árbol de spans con relaciones de padre e hijo, donde un span hijo suele ser causado por su padre. TrueFoundry proporciona un backend de colector OpenTelemetry que almacena estas traces y una interfaz de usuario para consultarlas y analizarlas, y puede recibir traces de cualquier SDK compatible con OpenTelemetry.
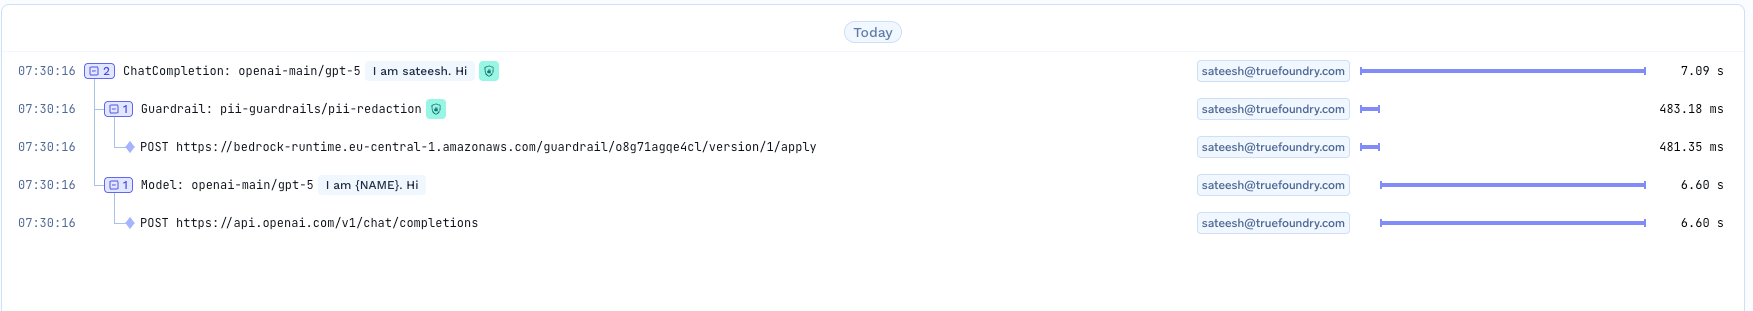
La documentación de inspección de traces muestra un ejemplo real: una personalización de chat completion con un guardrail de redacción de PII, capturado en cinco spans que forman una jerarquía.
En ese mismo ejemplo, la entrada se redacta visiblemente de un nombre a un marcador de posición, lo que muestra el funcionamiento del guardrail de PII de extremo a extremo dentro de la trace.
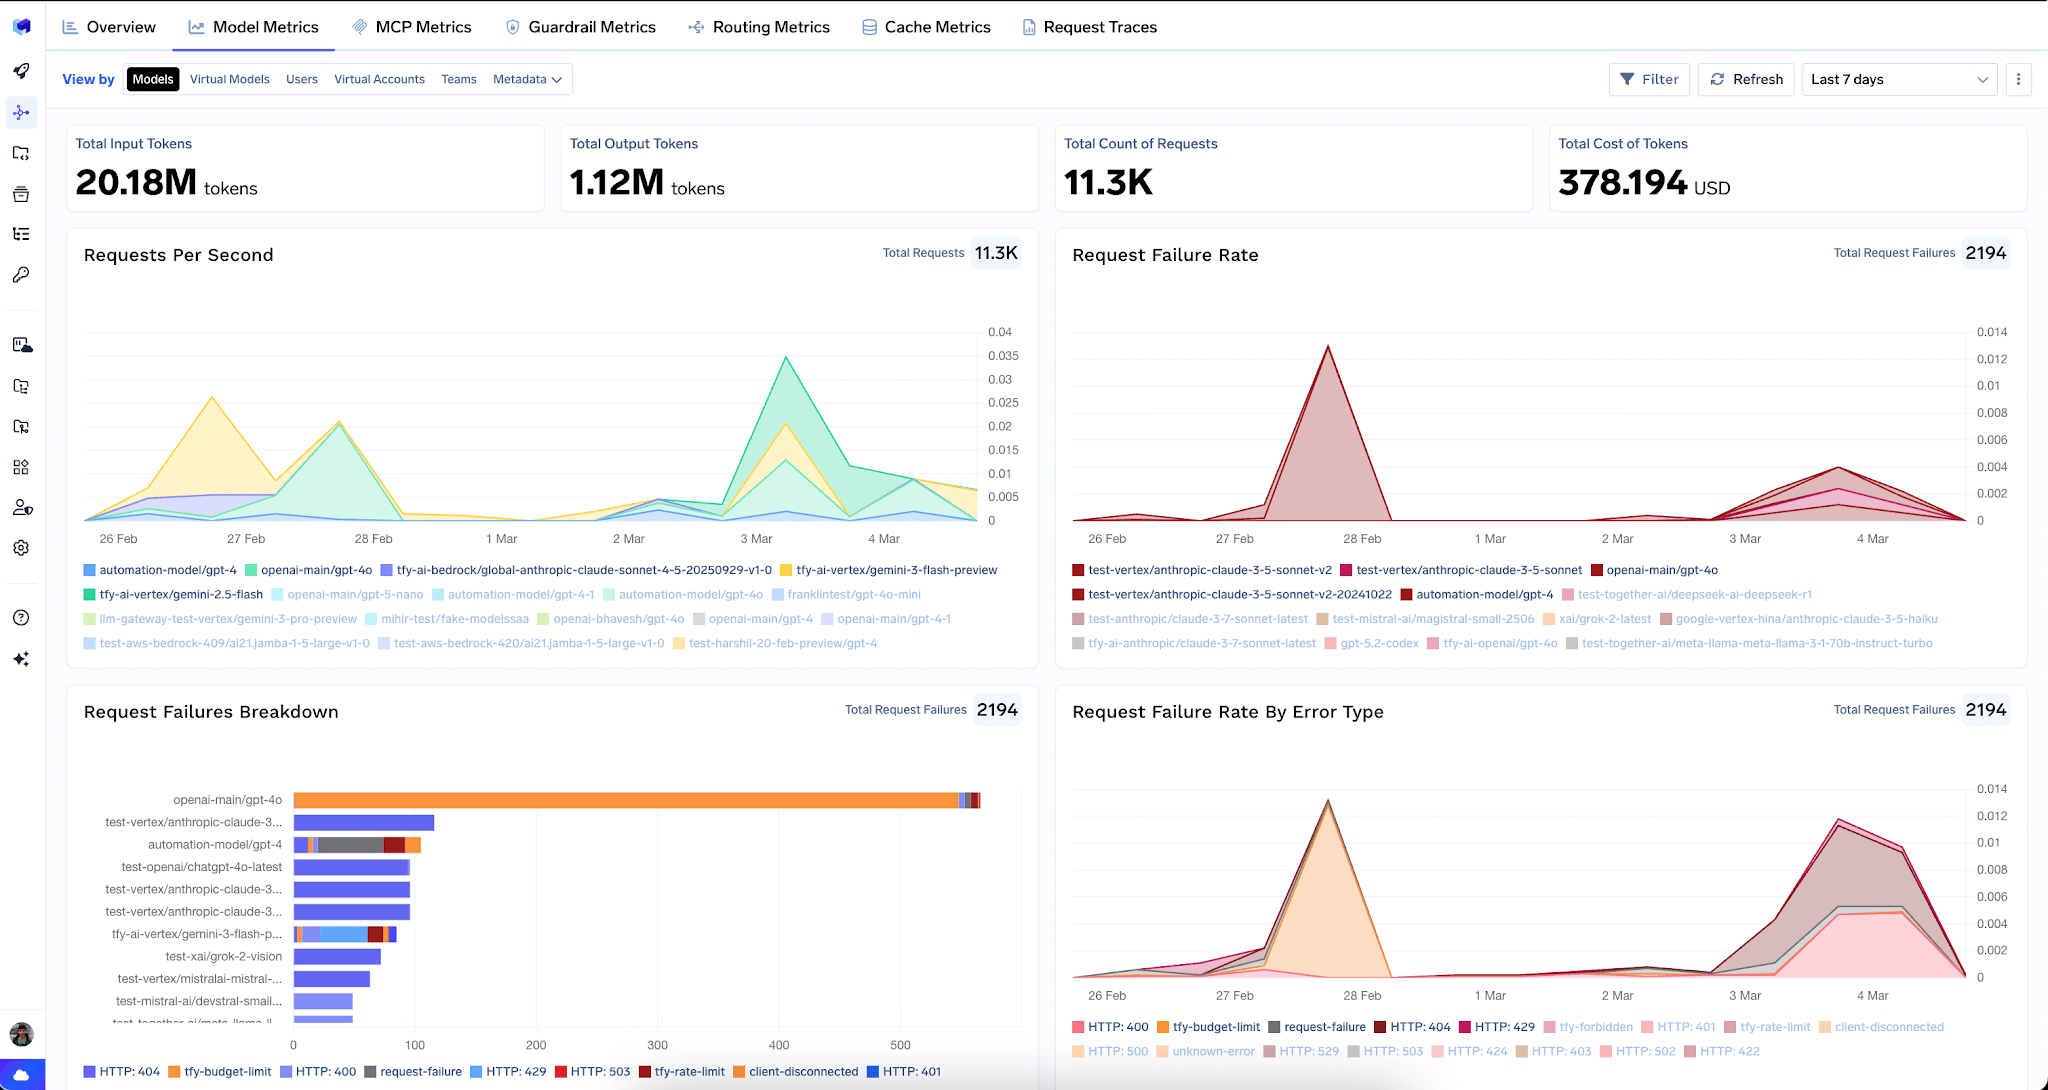
Las traces individuales sirven para la depuración. Para ver tendencias, el panel de analítica mecha y agrega los mismos datos. Las pestañas cubren Overview, Model Metrics, MCP Metrics, Guardrail Metrics, Routing Metrics y Cache Metrics.
Las métricas de modelos se pueden agrupar por modelos, modelos virtuales, usuarios, cuentas virtuales, equipos o metadatos, y las vistas de latencia desglosan la latencia de la solicitud, el tiempo hasta el primer token, la latencia entre tokens y el tiempo por token de salida. Junto con las traces por solicitud, esto te proporciona tanto el microscopio como el panel de control.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.




Send the X-TFY-LOGGING-CONFIG header with a stringified JSON value and set enabled to true or false. Remember that the value is stringified JSON, not a raw object, because most SDKs serialize headers as strings.
Logged requests appear under AI Gateway, then Monitor, then Requests. Opening a request shows its trace, which is the tree of spans covering guardrails, the model, and the outbound provider calls.
A trace is the full lifecycle of a single request. A span is one unit of work inside that trace, such as a guardrail check or a model inference. Spans form a parent and child tree within the trace
Yes. TrueFoundry runs an OpenTelemetry collector backend and can receive traces from any OpenTelemetry compatible SDK. For LLM use cases the docs recommend an LLM focused SDK that captures model specific traces and metrics.



Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada
















