November 5, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
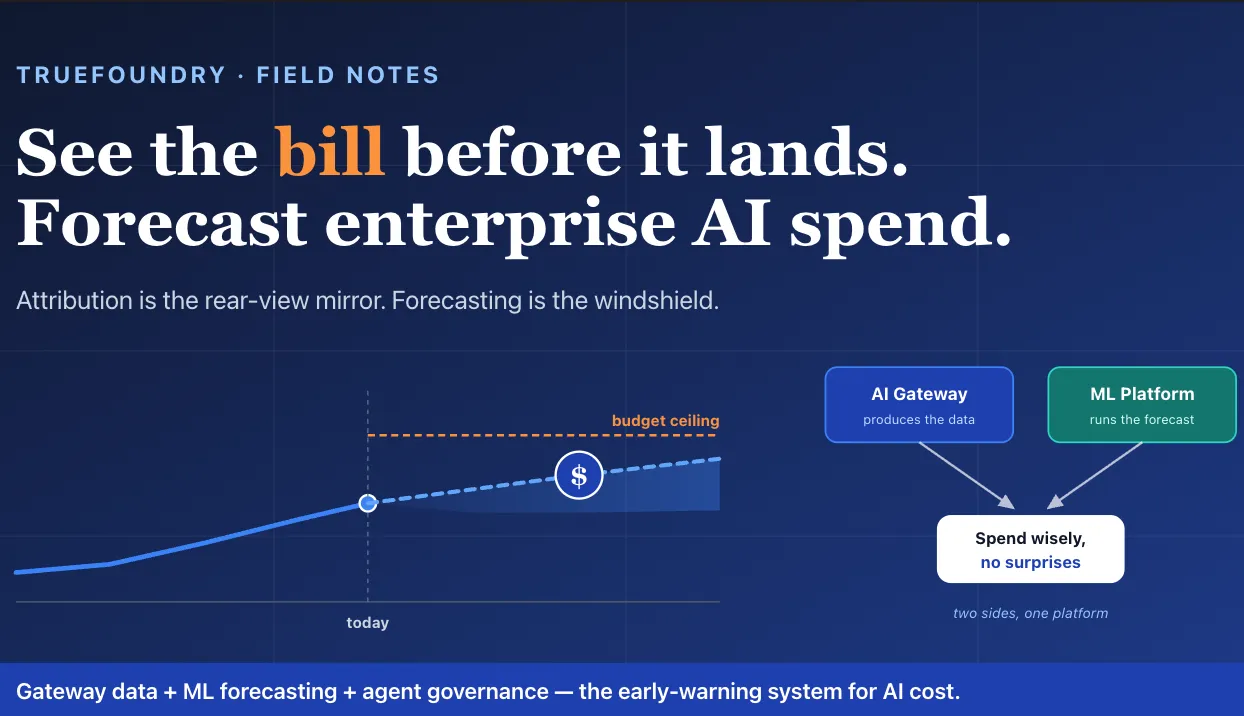
Cómo convertir los datos de costes de su AI Gateway en un presupuesto prospectivo —con una señal de alerta temprana antes de sobrepasarlo— utilizando dos modelos de series temporales bien conocidos, ejecutados de principio a fin en TrueFoundry.
La trilogía sobre la maximización de tokens defendía la necesidad de la atribución: no se puede gobernar el gasto que no se ve. El artículo de seguimiento de Notas de campo sobre las fluctuaciones de Meta / Amazon / Uber argumentaba que la atribución por sí sola proporciona un dial en lugar de un interruptor. Pero un dial sigue dejando una pregunta sin respuesta: no «¿a dónde fue el dinero?» —eso es el espejo retrovisor— sino «¿a dónde va?». Cuando se informó de que Uber había agotado todo su presupuesto de programación con IA para 2026 en cuatro meses, el problema no era que el gasto fuera invisible. El problema era que nadie tenía una proyección creíble de cuándo se agotaría el presupuesto hasta que ya se había agotado.
Este artículo trata de cerrar esa brecha mediante la predicción. Acompañaremos a una empresa ficticia pero realista —Meridian, una fintech mediana con unos 800 ingenieros— desde el punto «tenemos datos de costes atribuidos» hasta «tenemos una proyección semanal y autoactualizada del gasto en tokens por equipo, con una franja de incertidumbre honesta y una alerta que se dispara antes de romper el presupuesto». Utilizaremos dos modelos de series temporales complementarios, SARIMAX y Prophet, y construiremos, desplegaremos y reentrenaremos todo el sistema en TrueFoundry —la misma plataforma que emite la telemetría de costes del gateway, que también proporciona la infraestructura de ML para entrenar, servir y reentrenar el modelo de predicción.
Todo lo que aquí se expone depende de un requisito previo: datos de costes limpios y atribuidos con una marca de tiempo. Eso es exactamente lo que puede producir un AI Gateway bien instrumentado: coste a nivel de solicitud —con precios calculados automáticamente a partir de las tarifas publicadas por los proveedores— acompañado de los metadatos necesarios para agregar el gasto por equipo, ruta, modelo, cliente o centro de costes. Como se explicó en la trilogía y en el resumen de observabilidad, cada solicitud a través del gateway emite esa cifra de coste etiquetada por modelo, usuario y metadatos arbitrarios, y se exporta a su almacén de datos o pila de observabilidad. Agréguelo a un total semanal por centro de costes y tendrá el único dato de entrada que necesita un modelo de predicción: una serie temporal regular y etiquetada del gasto.
La predicción será tan buena como la disciplina de etiquetado en la que se apoye, por lo que este paso es más operativo de lo que parece. El gateway registrará fielmente cualquier metadato que sus aplicaciones le envíen, lo que significa que la serie temporal solo estará tan limpia como esa instrumentación. Antes de entrenar, un equipo necesita claves de metadatos estables y mapeos consistentes de equipos a centros de costes, un método para mantener actualizados los precios de los modelos a medida que los proveedores los cambian, y una política explícita para los registros problemáticos: datos retrasados o faltantes, reintentos, alternativas (fallbacks) y respuestas almacenadas en caché que cuestan poco o nada. Normalizar los precios, eliminar duplicados y alinear las marcas de tiempo a una sola zona horaria carece de glamour, pero marca la diferencia entre una predicción real y un artefacto de apariencia sólida construido sobre ruido.
Dicho esto, esta es la parte que los equipos sin un gateway no pueden realizar en absoluto. Si su gasto está disperso entre facturas brutas de proveedores, puede reconstruir un total mensual a nivel de empresa, pero no puede obtener una serie semanal limpia por equipo con el contexto causal adjunto —y las series enriquecidas con contexto y desglosadas por equipo son las que hacen que la predicción sea útil en lugar de decorativa. El gateway no es solo un punto de control de costes; es el instrumento que hace que el gasto sea predecible en primer lugar.
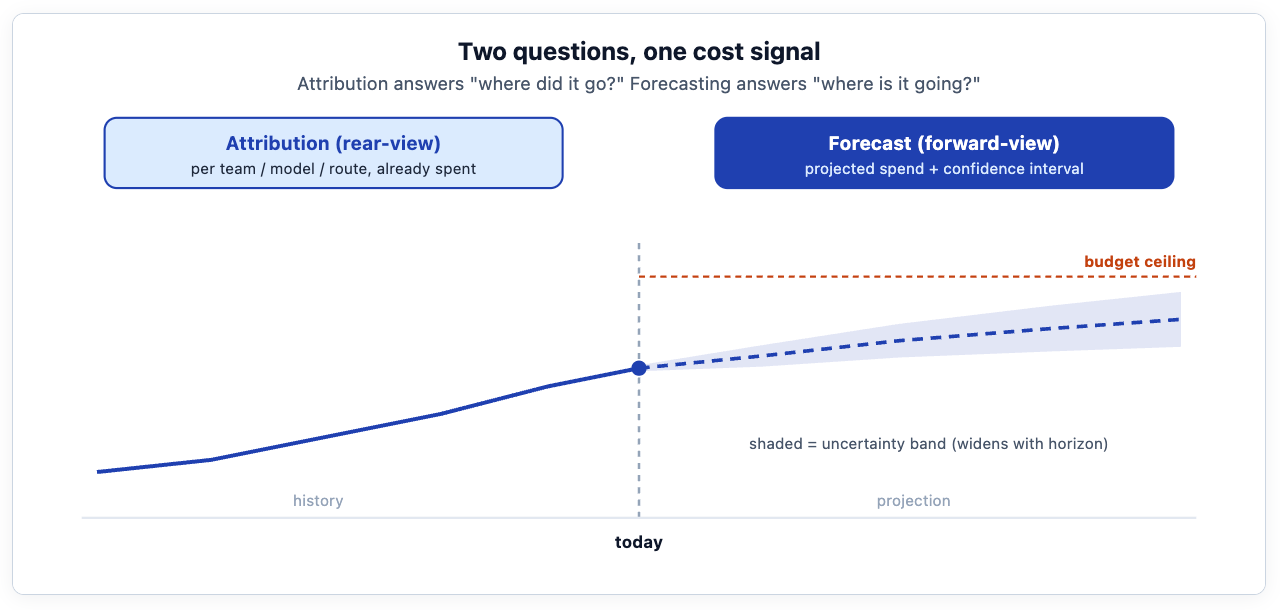
Conozca a Meridian: una empresa ficticia pero basada en patrones completamente reales. Cuenta con unos 800 ingenieros, un año de adopción agresiva de IA interna y un equipo de finanzas que acaba de recibir una pregunta de la junta directiva que no pudo responder: «¿cuánto nos costará la IA el próximo trimestre?». La atribución ya está resuelta: su gateway puede mostrar, al dólar exacto, cuánto costó el mes pasado y quién lo generó. Lo que no pueden hacer es proyectar hacia el futuro de forma creíble. La hoja de cálculo del director financiero extrapola una línea recta; el equipo de plataforma sabe que la realidad es más irregular, porque el gasto se dispara con los lanzamientos, disminuye en vacaciones y aumenta cada vez que un equipo pone un nuevo agente en producción.
Esa es la brecha entre una línea de tendencia y una predicción. Una extrapolación lineal no tiene noción de estacionalidad, no sabe qué factores están impulsando la curva y —lo más importante— no ofrece una declaración honesta de su propia incertidumbre. Meridian necesita un modelo que capture el ritmo, pueda incorporar lo que sabe que se avecina (el aumento planificado de la plantilla, los tres lanzamientos de la hoja de ruta) y reporte un intervalo de confianza en lugar de un único número engañosamente preciso.
No existe un único modelo ideal de series temporales, y cualquiera que sostenga lo contrario le está vendiendo algo. Para el problema de Meridian, dos de ellos se ganan su puesto, y lo hacen por razones diferentes.
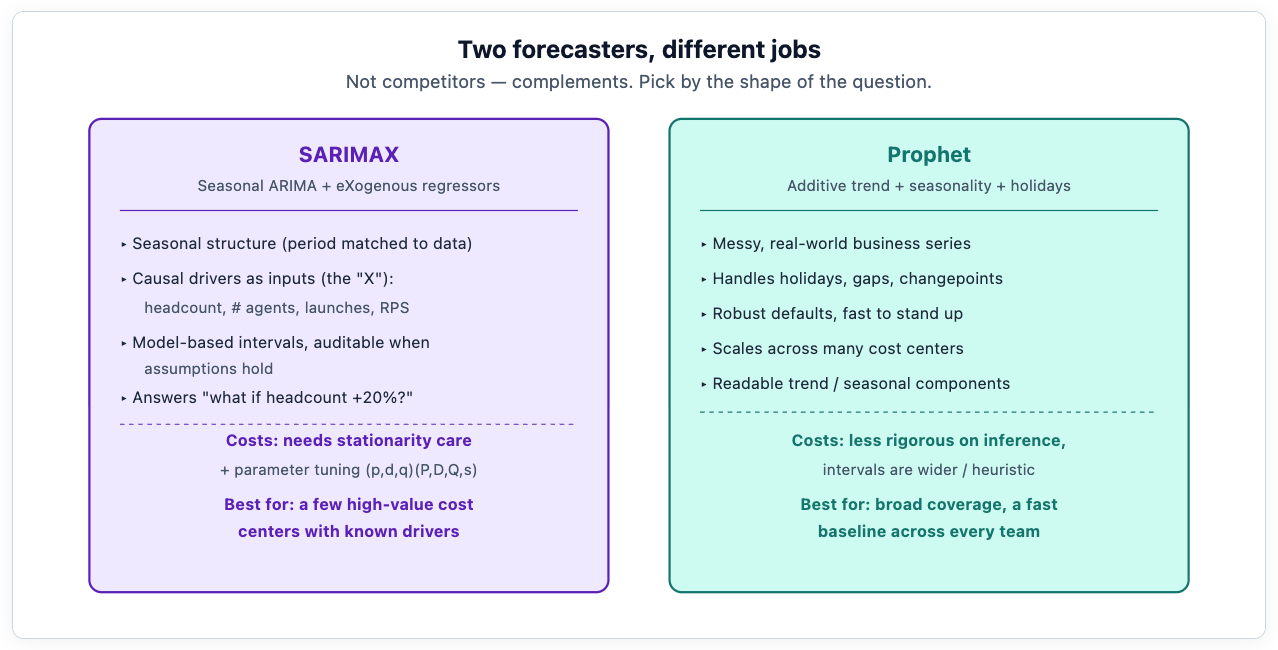
SARIMAX significa modelo autorregresivo integrado de media móvil estacional con regresores exógenos (Seasonal AutoRegressive Integrated Moving Average with eXogenous regressors). Si quitamos el acrónimo, se reduce a tres ideas. El núcleo ARIMA modela una serie como una función de su propio pasado reciente: el gasto de la semana pasada predice el de esta semana. La parte estacional añade un ciclo repetitivo, y el periodo tiene que coincidir con cómo ha agregado los datos: para una serie semanal, la estacionalidad suele referirse a ritmos más largos como ciclos de sprint, trimestrales o de planificación anual (un periodo estacional de 52 captura el año), mientras que los efectos de días laborables frente a fines de semana solo existen en una serie diaria y utilizarían un periodo de 7. Conviene ser preciso al respecto, porque un periodo estacional inadecuado es una de las formas más habituales en las que una predicción se descuadra silenciosamente. La parte exógena —la X, y la razón por la que se adapta tan bien a Meridian— le permite introducir variables externas que impulsan la serie: plantilla de ingeniería, número de agentes en producción o banderas de lanzamientos planificados. Eso es lo que convierte una predicción en una herramienta de análisis de escenarios: Meridian puede preguntar «¿cómo se verá el gasto si añadimos veinte ingenieros y lanzamos los tres proyectos de la hoja de ruta?» y obtener una respuesta con un intervalo de confianza, no una suposición.
En términos generales e ilustrativos, su ajuste se ve así (lo relevante es la estructura, no la sintaxis):
El coste de ese rigor es real: SARIMAX necesita que la serie sea razonablemente estacionaria (se aplican diferencias hasta que lo sea; la «I» del nombre), y los parámetros de orden requieren ajuste. Esto lo convierte en la herramienta adecuada para un puñado de centros de coste de alto valor donde el esfuerzo compensa y donde realmente se dispone de datos de variables impulsoras, no para predecir doscientos equipos a la vez.
Prophet, el modelo de predicción de código abierto del grupo de investigación de Meta, adopta la postura opuesta. Descompone una serie en tendencia, estacionalidad y efectos festivos, y está diseñado para series temporales de negocios complejas —con tendencia, estacionalidad semanal y anual, días festivos, detección automática de puntos de cambio y herramientas prácticas para gestionar valores atípicos e irregularidades— ofreciendo una predicción razonable con poco ajuste. Esto no equivale a decir que «no requiera limpieza de datos» (se aplican las advertencias anteriores sobre precios, reintentos y registros faltantes), pero es mucho más flexible de forma predeterminada que SARIMAX. Para Meridian, esto lo convierte en la opción natural para la cola larga (long tail): se ejecuta en las series de todos los equipos para obtener una proyección base sólida en todas partes, a bajo coste y sin tener que ajustar manualmente doscientos modelos.
El compromiso es la imagen especular de SARIMAX. SARIMAX puede proporcionar intervalos basados en modelos que son más fáciles de auditar cuando se cumplen sus supuestos; Prophet también proporciona intervalos de incertidumbre útiles, pero se derivan de forma diferente y los equipos deberían calibrar ambos frente a backtests en lugar de tratar a cualquiera de los dos como una garantía formal. Lo que Prophet no ofrece de forma nativa es el análisis condicional causal claro que proporcionan los regresores exógenos, y eso no supone un problema, porque no se le está pidiendo eso. La arquitectura pragmática a la que llega Meridian consiste en ejecutar ambos: Prophet para dar cobertura global a todos los equipos y SARIMAX superpuesto en los tres o cuatro centros de coste lo suficientemente grandes como para justificar una modelización basada en variables impulsoras. Juntos cubren más terreno que cualquiera de ellos por separado.
Antes de abordar la parte operativa, la advertencia que evita que esto sea humo. El resultado más importante de una predicción no es su estimación puntual: es su intervalo de incertidumbre. Un modelo que dice «el próximo trimestre costará 1,2 M$» es mucho menos útil, y mucho más peligroso, que uno que dice «el próximo trimestre se situará entre 1,0 M$ y 1,5 M$ con un 80% de confianza, y he aquí por qué la franja es así de ancha». La franja es lo que indica al equipo de finanzas si están ante un error de redondeo o un riesgo real. Y debe ensancharse a medida que se aleja el horizonte: cualquier sistema de predicción que pretenda tener la misma precisión para la semana 12 que para la semana 1 está ocultando la realidad. El modelo interactivo a continuación está construido precisamente en torno a esta característica.
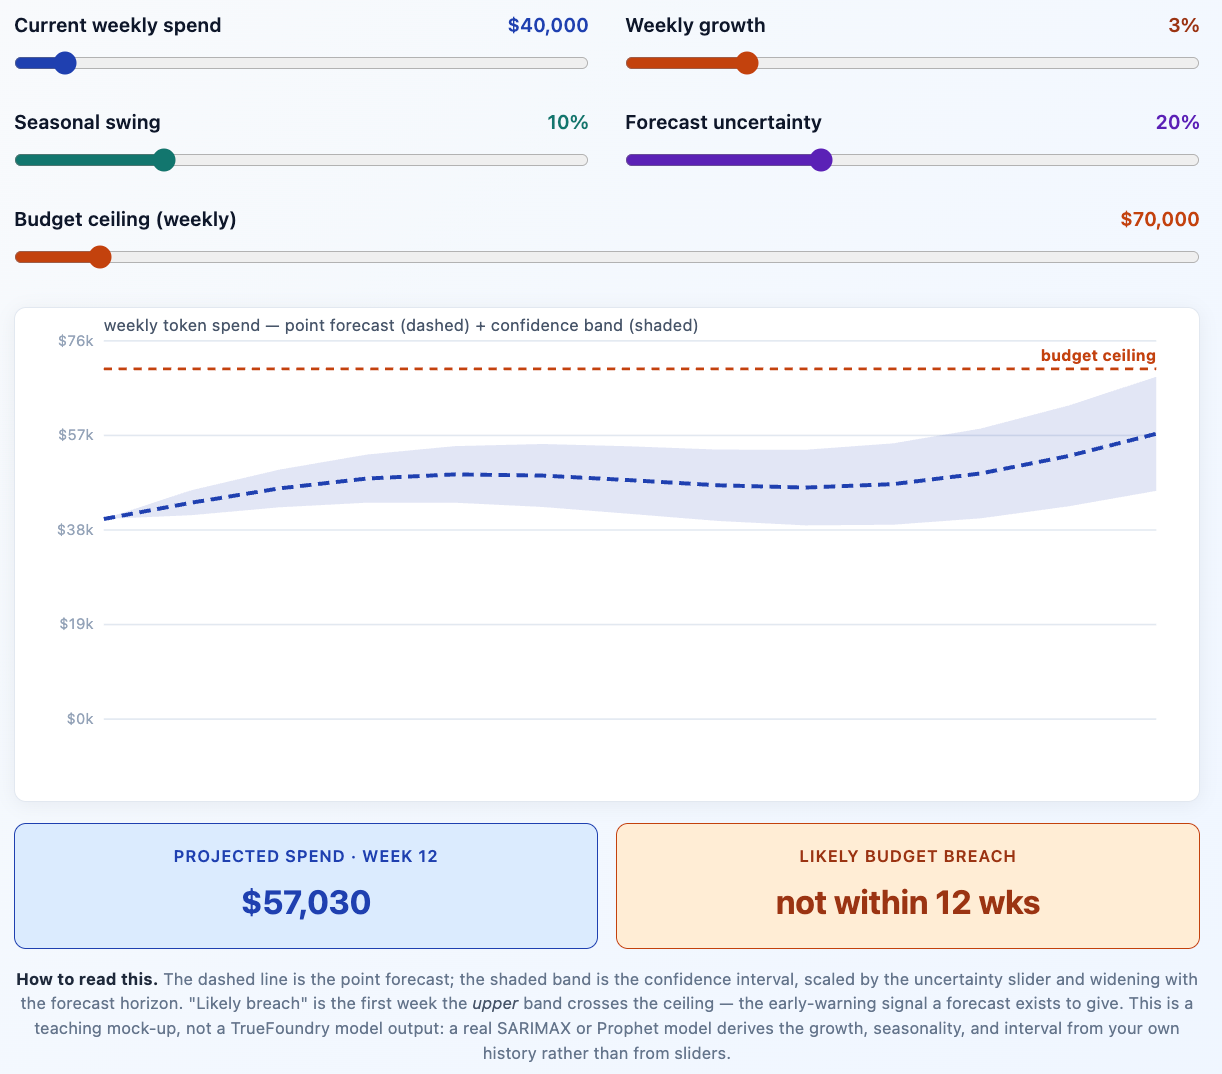
Fíjese en cuál es realmente la señal de alerta temprana. No es que la estimación puntual cruce el límite presupuestario, sino el momento en que el borde superior de la franja lo cruza. Esa es la primera semana en la que un sobrecoste pasa a ser plausible en lugar de seguro, y es el momento adecuado para actuar, porque actuar pronto es barato y actuar tarde se reduce al límite drástico contra el que ha argumentado toda la serie. Una buena predicción le otorga ese margen de tiempo.
Este es el hilo secundario, mantenido deliberadamente en su propia sección para que no desvíe la atención de la predicción. Aquí es donde se cruzan las dos mitades de la plataforma de TrueFoundry, y donde esto deja de ser un tutorial genérico de ciencia de datos. La mayoría de los artículos sobre Prophet o SARIMAX se quedan en el modelo. Pero un modelo en un notebook no es una predicción en la que un equipo de finanzas pueda confiar: es un trabajo puntual. La parte difícil, aburrida y verdaderamente valiosa es la operativa: conseguir que el modelo se entrene en una infraestructura real, versionado para que se pueda comparar y promocionar, servido tras una API que el panel de control pueda consultar y —la pieza que casi todos olvidan— reentrenado automáticamente para que no se degrade en silencio a medida que cambian los patrones de gasto.
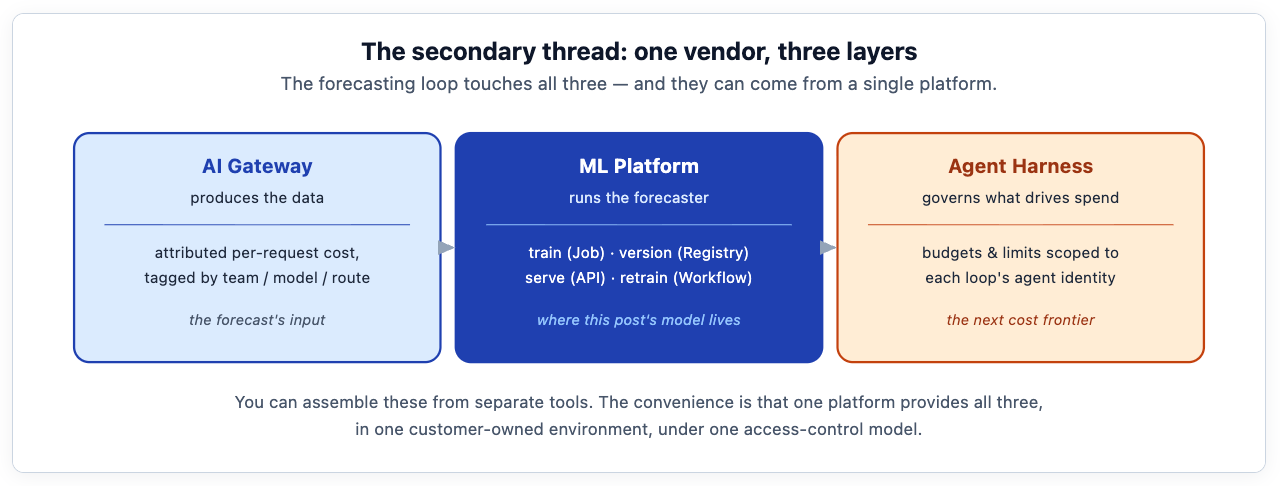
TrueFoundry es, por debajo del gateway, una plataforma de ML basada en Kubernetes. Su objetivo de diseño, expuesto claramente en esa documentación de arquitectura, es que los datos no salgan de su nube —el mismo modelo de plano dividido que el gateway, donde el plano de control de TrueFoundry orquesta mientras su plano de cómputo ejecuta las cargas de trabajo reales dentro de su propia cuenta. Para una fintech como Meridian, esta propiedad no es un lujo; los datos de costes etiquetados por equipo y proyecto son sensibles, y mantener el entrenamiento y la puesta en servicio dentro de la VPC es lo que hace que este enfoque sea viable.
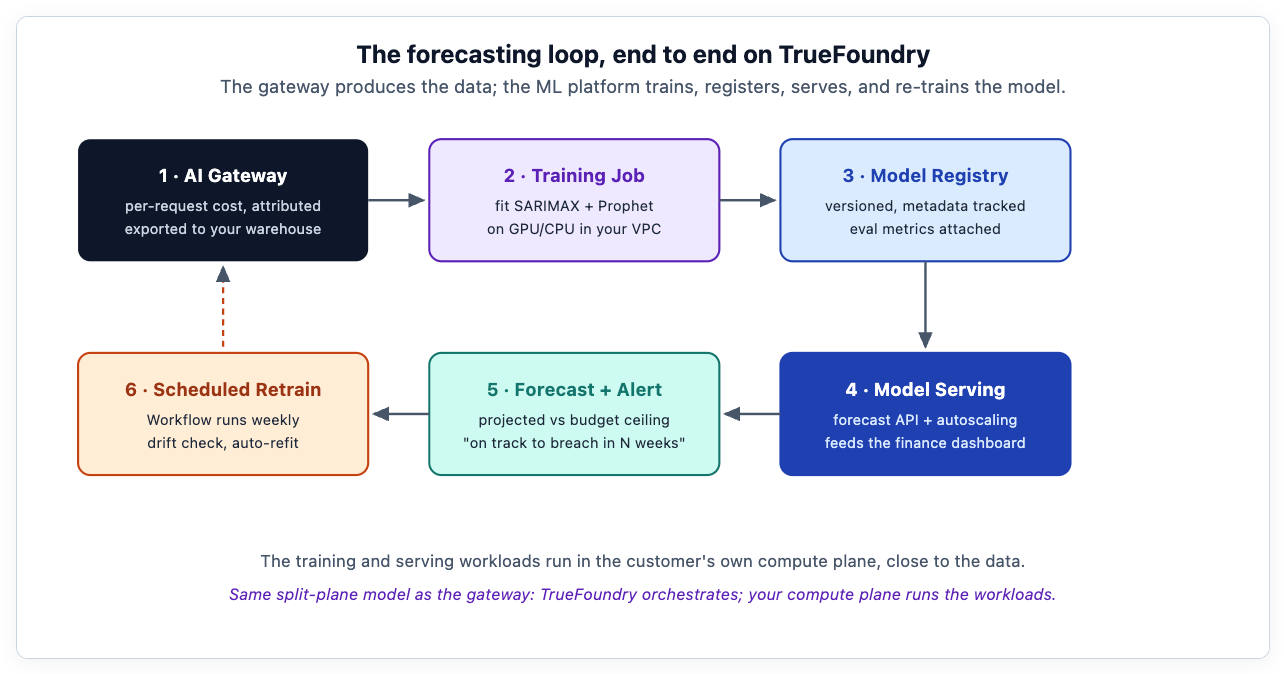
De forma concreta, el ciclo se mapea en módulos de la plataforma TrueFoundry que la documentación de arquitectura describe directamente:
Entrenamiento como Job. El ajuste del modelo se ejecuta como un Job de TrueFoundry —una tarea contenedorizada en su plano de cómputo de Kubernetes, con los recursos de CPU o GPU necesarios, leyendo los datos de costes exportados por el gateway. Sin notebooks ejecutándose en el portátil de alguien; un trabajo reproducible con entradas rastreadas.
Versionado en el Model Registry. TrueFoundry proporciona un registro de modelos para que cada sistema de predicción entrenado se versione con sus metadatos y métricas de evaluación adjuntas. Cuando el modelo de esta semana ofrece peores resultados en el backtest que el de la semana pasada, puede comparar las versiones y decidir si promociona el nuevo o sigue sirviendo el anterior —la diferencia entre un experimento y un servicio fiable.
Servido como API. El modelo elegido se despliega como un Service de TrueFoundry: un endpoint escalable y monitorizado al que llama el panel de finanzas para obtener la proyección y la franja más recientes. El autoescalado y los controles de estado (health checks) provienen de la plataforma, no de código de unión personalizado.
Reentrenamiento programado como Workflow. Esta es la pieza clave. TrueFoundry integra un motor de flujos de trabajo (ArgoWorkflows) exactamente para este tipo de tareas programadas de múltiples pasos. Un flujo de trabajo semanal extrae los últimos datos de costes, comprueba si el modelo activo sufre desviación (drift), lo vuelve a ajustar si es necesario, evalúa y promociona la nueva versión solo si supera a la anterior. La predicción se mantiene al día sin necesidad de que alguien se acuerde de ejecutar un script.
Con atribución de costes, de forma natural. Dado que las propias cargas de trabajo de predicción se ejecutan en TrueFoundry, su coste de cómputo también es atribuido por la plataforma —la documentación de arquitectura señala la atribución detallada de costes por servicio a través de OpenCost. El sistema que predice su gasto en IA reporta su propio coste en el mismo panel de control. El instrumento se calibra contra sí mismo.
Esa visión integral —el gateway produce los datos, la plataforma de ML entrena, sirve y reentrena el modelo, bajo un único modelo de control de accesos— es algo que una librería de predicción aislada no puede ofrecer, y es la parte que convierte esto en una decisión de plataforma en lugar de un proyecto secundario de ciencia de datos. Para ser precisos con los límites: las cargas de trabajo de entrenamiento y servido se ejecutan en su plano de cómputo, cerca de los datos, mientras que el plano de control de TrueFoundry las orquesta; como en cualquier despliegue, los equipos deben confirmar qué metadatos, registros, licencias y registros del plano de control salen del entorno según el modelo y contrato elegidos. Y para ser precisos sobre la división del trabajo: TrueFoundry no hace que SARIMAX o Prophet sean especiales, ni genera una predicción de nivel financiero por sí solo desde el primer momento. Lo que lleva a nivel de producción es el ciclo que rodea al modelo: datos de costes atribuidos desde el gateway, trabajos de entrenamiento en el plano de cómputo del cliente, versionado, servido, reentrenamiento basado en flujos de trabajo y atribución de costes para la propia carga de trabajo de predicción. El cliente sigue construyendo y validando el modelo; la plataforma es el sustrato que permite que ese modelo se ejecute de forma fiable. El punto no es que SARIMAX y Prophet sean exóticos; no lo son. El punto es que la distancia entre «un modelo que funciona en un notebook» y «una predicción en la que finanzas confía cada lunes por la mañana» es exactamente la distancia para la que está diseñada una plataforma de ML.
Una predicción que nadie ha validado es solo una línea con apariencia de certeza, y enviar alertas desde un modelo no validado es la forma más rápida de enseñar al equipo de finanzas a ignorar sus avisos. Antes de que cualquier proyección impulse una decisión, debe ganarse la confianza basándose en el historial. El método estándar es la evaluación con origen móvil (rolling-origin evaluation), a veces llamada walk-forward: entrenar en las semanas 1 a N, predecir las semanas N+1 a N+12, comparar con lo que ocurrió realmente, deslizar la ventana hacia adelante y repetir. Al aplicarlo a todo el historial, esto le indica cómo habría funcionado el modelo semana tras semana, no solo en una partición afortunada de los datos.
Rastree algunas métricas, ya que cada una responde a una pregunta diferente. MAPE o WAPE —error como porcentaje— es la más legible para una audiencia financiera («solemos estar dentro de un margen del 8%»). RMSE penaliza más severamente las desviaciones grandes, por lo que saca a la luz la eventual semana mala que un porcentaje medio suavizaría. Y la que la mayoría olvida: la cobertura de intervalo —¿la franja del 80% realmente contiene el valor real alrededor del 80% del tiempo? Un modelo cuya franja del 80% solo acierta con la realidad la mitad del tiempo está mintiendo sobre su propia confianza, y eso es peor que una franja más ancha pero honesta. La regla de promocionar solo si supera al anterior en el reentrenamiento programado debe definirse en función de estas métricas: un nuevo modelo semanal reemplaza al anterior únicamente si lo supera en la métrica de error acordada sin degradar la cobertura.
En conjunto: el gateway de Meridian ha estado emitiendo costes atribuidos durante meses, por lo que disponen de una serie semanal limpia por equipo. Un Job de entrenamiento de TrueFoundry ajusta Prophet en todos los equipos para obtener una línea base, y SARIMAX en los cuatro centros de coste más grandes utilizando la plantilla y el recuento de agentes como regresores. Ambos modelos se registran en el registro con sus errores de backtest guardados. El mejor modelo por centro de costes se sirve tras una API de predicción. El panel de finanzas muestra ahora, para cada equipo, una curva de gasto proyectado con una franja del 80% y un indicador —verde, ámbar o sobrecoste probable— basado en dónde se sitúa la franja superior con respecto al presupuesto de ese equipo. Un flujo de trabajo semanal mantiene todo actualizado.
La pregunta de la junta directiva —«¿cuánto nos costará la IA el próximo trimestre?»— tiene ahora una respuesta honesta: un rango, con las variables causales identificadas y una alerta que se disparará en el margen de tiempo previo a que cualquier equipo sobrepase el límite, en lugar de hacerlo a posteriori. Meridian no eliminó el coste. Hizo que el coste fuera legible hacia el futuro, que es lo único que convierte un presupuesto de un muro contra el que se choca a un plan que se puede dirigir. Ese es el dial, orientado hacia adelante.
Esto no pretende afirmar que la predicción elimine la necesidad de criterio, ni que un modelo pueda gestionar la gobernanza de costes en piloto automático. Una predicción es un soporte para la toma de decisiones: amplía el margen en el que un ser humano puede actuar y hace que la acción sea más económica al proporcionar tiempo de reacción. No decide si una trayectoria de gasto es aceptable; esa es una decisión de negocio sobre si el trabajo que producen los tokens vale la pena, que es la misma pregunta de entrada frente a salida sobre la que giraba la trilogía. Una predicción que anticipa un exceso de presupuesto puede significar «reducir el desperdicio» o «aumentar el presupuesto porque este equipo está entregando resultados»; el modelo no puede decirle cuál de las dos opciones elegir, y cualquier proveedor que sugiera lo contrario está vendiendo por encima de la realidad.
Tampoco afirmamos que SARIMAX y Prophet sean los únicos ni los mejores modelos; los árboles con gradient boosting, los modelos de espacio de estados y los pronosticadores profundos tienen todos su lugar, y para algunas series, una línea base estacional ingenua es realmente difícil de superar. Los dos que elegimos son bien comprendidos, cuentan con un excelente soporte y forman una pareja por defecto sensata; son un sólido punto de partida, no una respuesta definitiva. Y el gráfico interactivo anterior es una maqueta didáctica controlada por deslizadores, no un output de un modelo de TrueFoundry: un pronóstico real obtiene su crecimiento, estacionalidad e intervalo a partir de su historial, no de un control que usted arrastra. El enfoque honesto es el mismo que ha mantenido esta serie en todo momento: la plataforma le ofrece los instrumentos; su equipo sigue siendo quien los lee y toma la decisión.
Sin duda puede empezar con uno, y para la mayoría de los equipos Prophet es el primer paso más rápido: proporciona una línea base sólida en cada centro de costes con un ajuste mínimo. Añada SARIMAX más adelante, y solo en los pocos centros de costes de gran valor donde disponga de datos de impulsores reales (plantilla, número de agentes, calendario de lanzamientos) y desee intervalos más ajustados y la capacidad de análisis hipotético ("what-if") que proporcionan los regresores exógenos. La combinación es el estado de madurez, no un requisito previo.
Una línea recta no tiene estacionalidad, no reconoce los impulsores y, lo que es fatal, no tiene banda de incertidumbre. Se equivocará con total seguridad en los lanzamientos y vacaciones, y no ofrece al equipo de finanzas ninguna forma de distinguir una pequeña oscilación de un riesgo real. Todo el valor de un pronóstico reside en el intervalo honesto y la señal de alerta temprana; una línea de tendencia no tiene ninguno de los dos.
Las cargas de trabajo de entrenamiento y serving pueden ejecutarse en su propio plano de computación, cerca de los datos, con el plano de control de TrueFoundry orquestando en lugar de ingerir los datos de entrenamiento. Esa es la propiedad que hace que este enfoque sea utilizable para cargas de trabajo reguladas, pero los equipos deben confirmar exactamente qué metadatos, registros, licencias y registros del plano de control salen del entorno según el modelo de despliegue y contrato elegidos, en lugar de asumir automáticamente que "nada sale".
Depende de la rapidez con la que cambien sus patrones de gasto, pero una frecuencia semanal es un valor por defecto sensato para el coste de tokens, que oscila con los ciclos de sprint y los lanzamientos. Lo importante es que el reentrenamiento se automatice como un workflow programado con una comprobación de drift y un filtro de "promocionar solo si es mejor", de modo que el pronóstico siga el ritmo sin esfuerzo manual y sin degradarse silenciosamente.
Si su gasto mensual en AI es pequeño y plano, un pronóstico no vale la pena: la atribución y una alerta de presupuesto son suficientes. El pronóstico justifica su esfuerzo cuando el gasto es grande, creciente y lo suficientemente irregular como para que la diferencia entre "superamos el límite en la semana 5" y "superamos el límite en la semana 11" cambie lo que hace este mes. Meridian ha superado ese umbral; una startup de diez personas probablemente aún no.
La trilogía sobre tokenmaxxing (el argumento de atribución sobre el que se construye esto):
Parte 1 — The Cost-Governance Gap. Parte 2 — The Architecture of Governed AI Usage. Parte 3 — Building the AI Leverage Control Room.
Field Notes (el argumento del efecto látigo y del regulador en lugar del interruptor):
When AI Cost Control Becomes a Switch — and Why It Should Be a Gateway (el giro de Meta / Amazon / Uber, con citas de fuentes primarias).
Plataforma TrueFoundry (la superficie del producto subyacente a esto):
Arquitectura de plataforma de ML — Machine Learning on Kubernetes (entrenamiento, registry, serving, workflows, despliegue en plano dividido, atribución con OpenCost). AI Gateway — página de producto. Observabilidad y seguimiento de costes — observabilidad en el AI Gateway. Documentación de la plataforma — docs.truefoundry.com/introduction.
Los modelos (documentación externa y abierta):
SARIMAX está documentado en statsmodels; Prophet está documentado en facebook.github.io/prophet.
Escrito por el equipo de TrueFoundry. Este es un artículo educativo; Meridian es una entidad compuesta ficticia y el gráfico interactivo es una maqueta ilustrativa, no un output de producto ni un benchmark. El pronóstico es un soporte para la toma de decisiones, no una garantía: valide cualquier modelo con sus propios datos y trate sus intervalos, no sus estimaciones puntuales, como la señal real.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada