


noviembre 20, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: noviembre 20, 2026

¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Si está ejecutando Slack a través de un agente en Opus, aquí tiene la cifra incómoda. Sonnet 4.6 con esfuerzo alto, con un archivo de habilidad de 55 líneas, superó 56 de 63 tareas. Eso es un 88,9 %. Opus 4.8 con esfuerzo alto y sin habilidad también superó 56 de 63. La ejecución de Sonnet costó 4,28 $. La de Opus costó 6,81 $. La tarea mediana fue también un 12 % más rápida en Sonnet.
Por lo tanto, el paso evidente es darle a Opus el mismo archivo y ver cómo toma la delantera. Lo hicimos. Opus con la habilidad superó 55 de 63. Fable 5, que comenzó por encima del 90 %, terminó en el 85,7 %. En una petición, Opus pasó de 3 de 3 sin la habilidad a 0 de 3 con ella, y el fallo no es sutil: enumeró los miembros del canal, obtuvo de vuelta los user ids y se detuvo, porque el archivo decía "haga una llamada y deténgase". Sonnet leyó la misma línea y continuó para buscar los nombres de todos modos.
Esa es la forma de todo el resultado. Una habilidad vale exactamente la brecha que cubre. En un modelo más pequeño la brecha es ancha y un índice corto cubre la mayor parte, por menos dinero de lo que cuesta el modelo más grande sin nada. En un modelo cerca del límite la brecha es estrecha, y una regla escrita para el caso confuso es seguida con la mayor fidelidad por el modelo que menos la necesitaba.
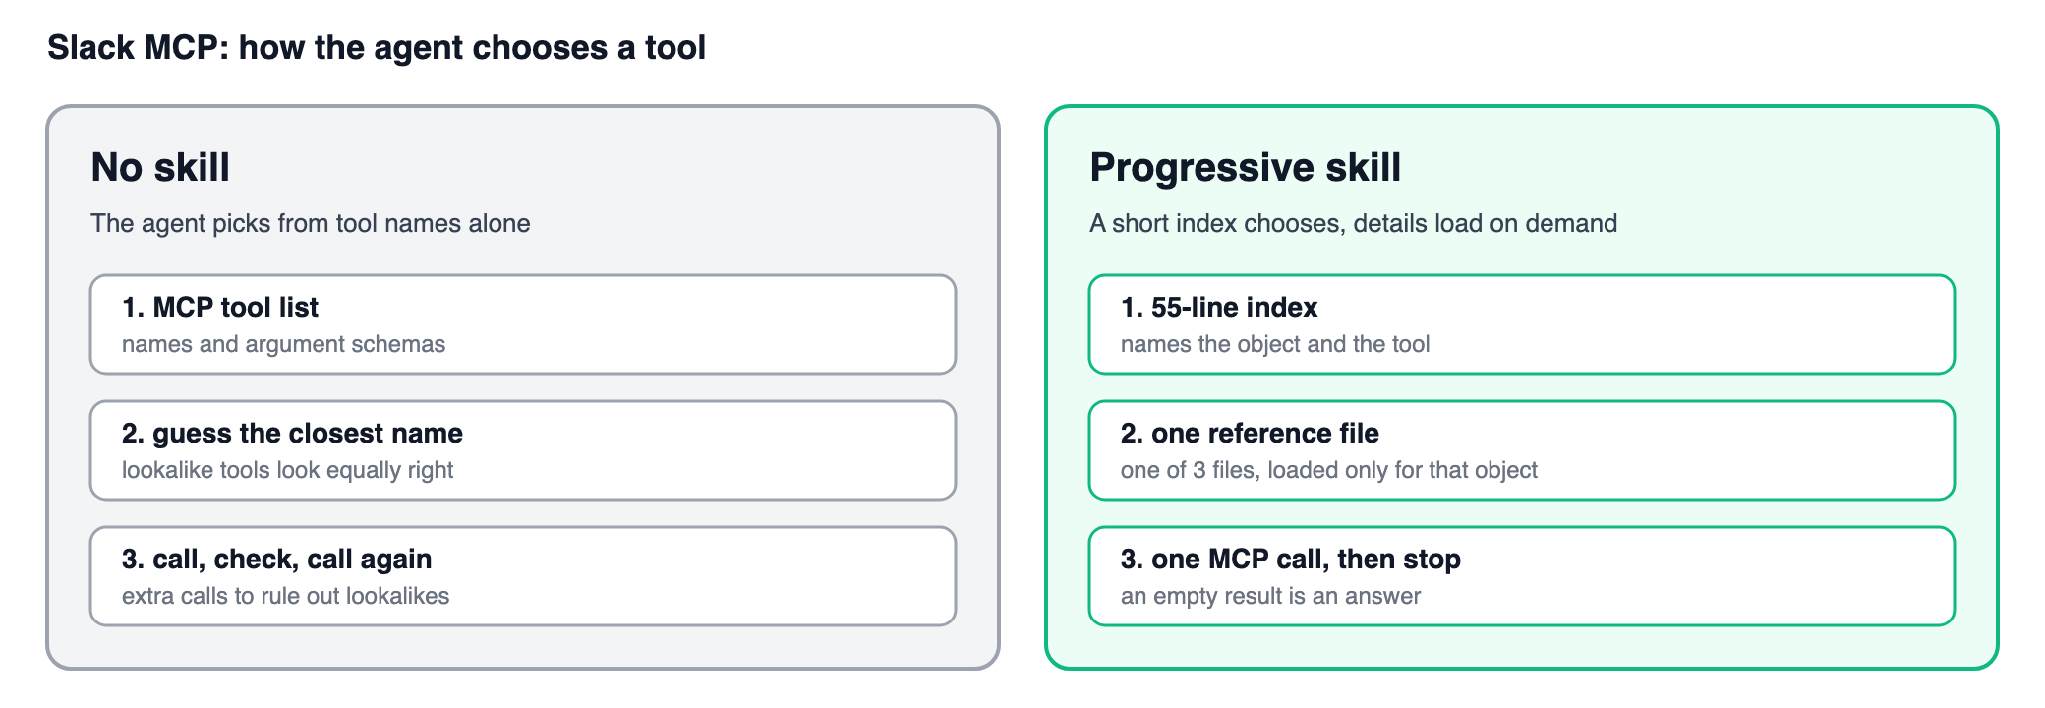
Una vez que un equipo ve que una habilidad aumenta la precisión en un servidor MCP, se suelen asumir dos creencias. Primera, que la orientación no tiene inconvenientes, por lo que se deben escribir las reglas de forma amplia y dejar que cada modelo las lea. Segunda, que el modelo más potente es el que más se beneficia, porque es el que mejor sigue las instrucciones. Slack rompe ambas.
La primera creencia falla porque una habilidad solo ayuda donde al modelo le faltaba una distinción. La mayoría de las herramientas de Slack son fáciles de diferenciar. Enviar, redactar borrador y programar son distintas en los nombres de las herramientas, y un modelo sólido las acertó casi siempre sin ayuda. Donde la lista de herramientas ya está haciendo el trabajo, una habilidad no puede añadir precisión. Solo puede añadir una regla que el modelo no necesitaba, y una regla se puede seguir demasiado bien.
La segunda creencia falla por la misma razón leída al revés. El modelo que mejor sigue las instrucciones es el más propenso a obedecer "haga una llamada y deténgase" en el momento exacto en que iba a hacer algo útil. Opus ya había buscado nombres de miembros por su cuenta. Fable ya había superado el filtro de DM por su cuenta. La habilidad no enseñó nada a ninguno de los dos. Les entregó una línea general corta y la siguieron más literalmente de lo que lo habrían hecho por su cuenta.
La parte económica se sitúa dentro de eso. La cuestión no es si una habilidad vale sus tokens. El agente con habilidad utilizó ligeramente menos tokens de entrada e hizo cerca de un tercio menos de llamadas, por lo que el archivo se pagó solo solo en coste. La cuestión es qué modelo necesita en primer lugar. Si un índice de 55 líneas permite a Sonnet igualar a Opus, la habilidad no solo ahorró tokens en la ejecución. Cambió el modelo que requiere la carga de trabajo.
El ejemplo. "¿Quién es miembro de mcp-gateway?". La lista de miembros devuelve user ids. Una respuesta útil busca esos ids y proporciona nombres. Opus 4.8 con esfuerzo alto, sin habilidad: superó 3 de 3, enumerando miembros y luego leyendo perfiles para responder con nombres. El mismo modelo, la misma petición, con la habilidad: superó 0 de 3. Un intento buscó el canal, enumeró miembros dos veces y se detuvo. La respuesta fue user ids sin nombres. Sonnet 4.6 con la misma habilidad superó 3 de 3 y completó las búsquedas de nombres.
Las cifras. 21 tareas de Slack, seis configuraciones de Claude, tres ejecuciones cada una. En todos los modelos, la precisión subió del 83,3 % al 86,5 %. Con esfuerzo alto, Sonnet con la habilidad pasó del 66,7 % al 88,9 %, la misma puntuación que Opus sin habilidad, por 4,28 $ frente a 6,81 $. Opus con la habilidad obtuvo un 87,3 %. Con esfuerzo medio, Sonnet subió del 74,6 % al 84,1 % y Opus se mantuvo en el 87,3 %. Fable pasó de estar por encima del 90 % al 85,7 % en ambas configuraciones, una caída de 3 o 4 ejecuciones de 63, por lo que la magnitud es incierta pero los fallos específicos son reales. Las llamadas a herramientas por tarea cayeron de 2,52 a 1,71. El coste total de la evaluación cayó de 46,10 $ a 44,01 $.
El aprendizaje. Adapte la habilidad al modelo y luego depúrela. Una habilidad ayuda donde al modelo le faltaba una distinción: una capacidad de la que carece el servidor, un alcance de búsqueda, una escritura que el usuario ya ha detallado. Cuando los nombres de las herramientas ya aclaran la elección, un modelo sólido llega solo, y una regla amplia puede cortar trabajo que habría terminado. Escriba cada regla de forma precisa contra una confusión específica y pruebe cualquier regla nueva en su modelo más potente antes de confiar en ella.
El mismo diseño que la prueba de Linear. Cambió una variable.
Las tareas. 21 peticiones de Slack escritas en torno al alcance de búsqueda, hilos, borradores y programaciones, canvases, listas, subidas, capacidades faltantes y consentimiento. "¿Qué decidimos?" podría ser una búsqueda en todo el espacio de trabajo, los últimos mensajes en un canal o las respuestas bajo un solo mensaje. "Envía esto" podría significar ahora, un borrador que alguien todavía tiene que aprobar o un mensaje que debería salir mañana. "Redacta esto" podría ser un canvas, una lista o un archivo. Seleccionamos las tareas porque son confusas, por lo que son más difíciles que el tráfico habitual de Slack.
Los datos. Las respuestas de Slack provinieron de una grabación congelada. Ambas opciones vieron datos idénticos y las escrituras nunca llegaron a un espacio de trabajo real.
Los modelos. Sonnet 4.6, Opus 4.8 y Fable 5, cada uno con esfuerzo medio y alto. Seis configuraciones, tres ejecuciones por tarea, en un espacio de trabajo limpio cada vez. 378 ejecuciones con la habilidad y 378 sin ella.
Las dos opciones.
La habilidad. Un índice SKILL.md de 55 líneas que el agente siempre lee. Enumera los objetos, una forma corta de elegir entre ellos, una tabla de elementos parecidos y lo que el servidor no puede hacer. Tres archivos de referencia, uno para búsqueda, otro para escritura y otro para artefactos, contienen los detalles de los argumentos. En una tarea típica, el agente decide dónde vive el contenido (un tema sin una ubicación única es búsqueda, mensajes recientes en una conversación son historial del canal, respuestas bajo un mensaje son un hilo), resuelve nombres de canales a ids, abre el archivo de referencia de esa familia si es necesario y realiza una llamada, luego se detiene.
La puntuación. Una tarea se consideró superada solo si el agente eligió las herramientas correctas en el orden correcto, respetó las reglas de seguridad y proporcionó una respuesta final correcta. Un juez independiente Opus 4.8 evaluó la respuesta sin saber si había una habilidad presente. Tres ejecuciones por tarea es una muestra pequeña, dos de las verificaciones de aprobado son evaluadas por un modelo y la reproducción elimina la latencia real de la API.
Las tareas, habilidades, reglas de puntuación y pasos de reproducción están en el repositorio público mcp-skillbench.
La precisión general varió poco, del 83,3 % al 86,5 %. El movimiento interesante es por modelo.
Por modelo, por esfuerzo.
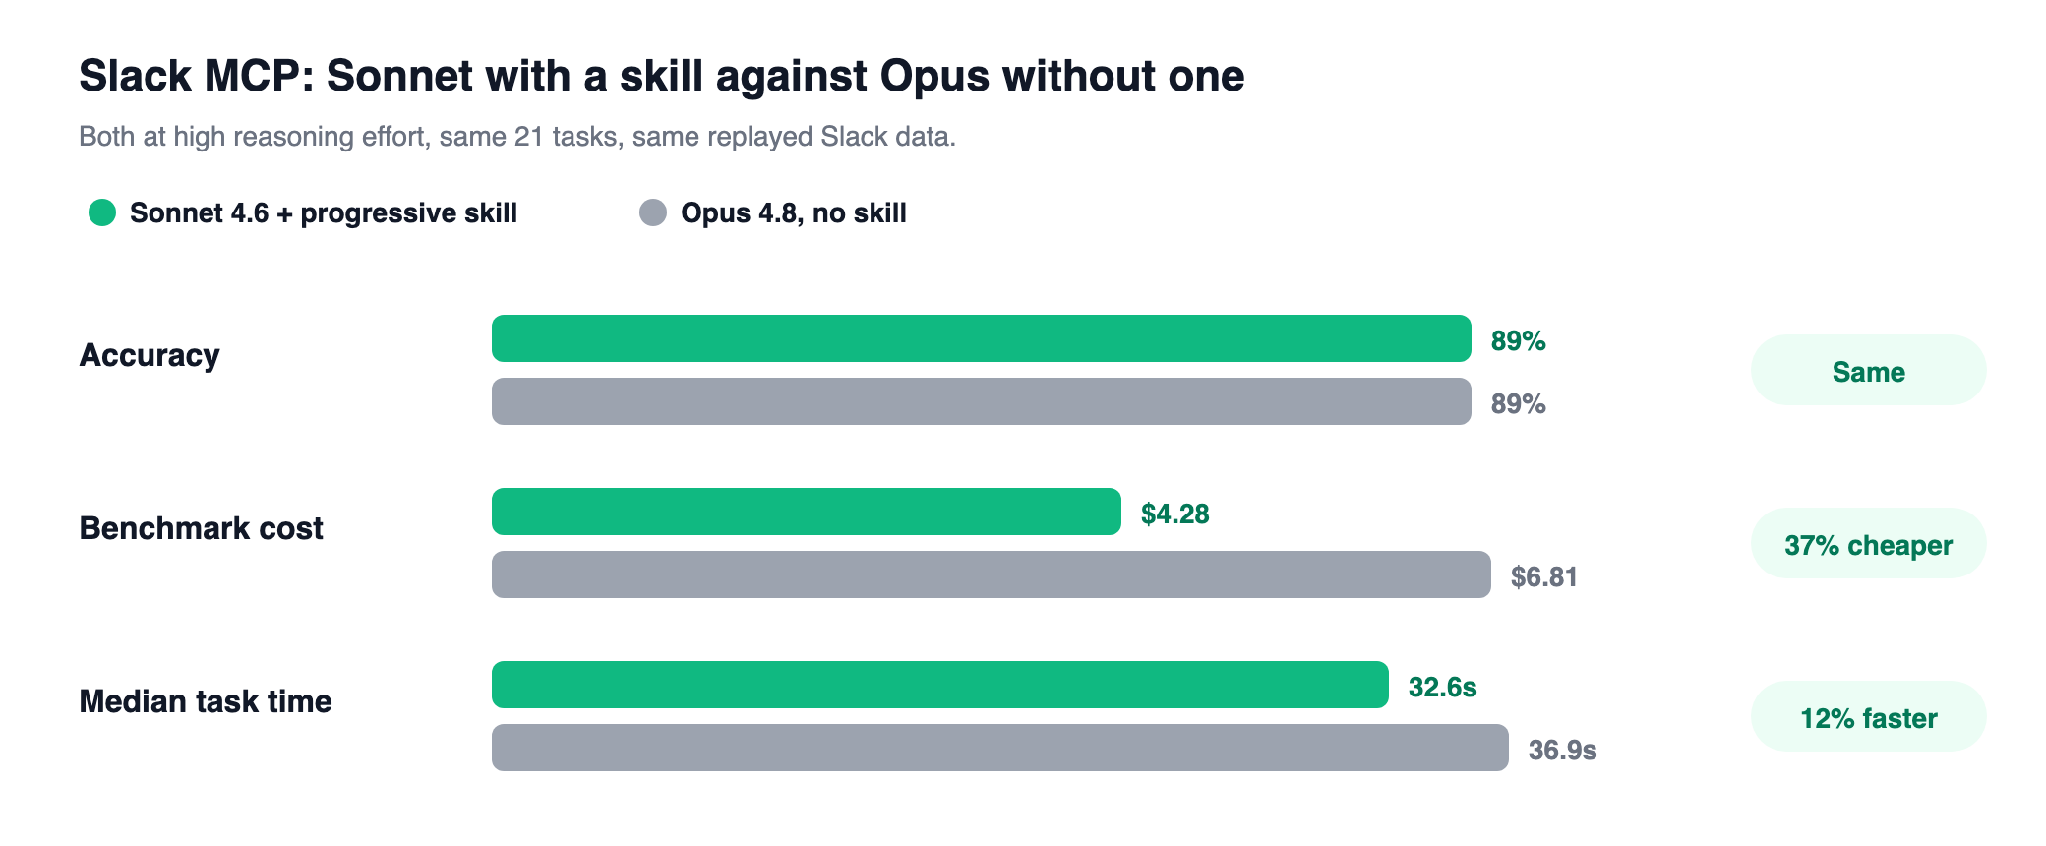
El promedio es la cifra incorrecta para recordar. Sonnet con esfuerzo alto pasó de 42 de 63 a 56 de 63, la puntuación que Opus registró sin habilidad, con 4,28 $ frente a 6,81 $ y una tarea mediana de 32,6 segundos frente a 36,9. Opus siguió ganando en la cola lenta. La caída de Fable es de 3 o 4 ejecuciones de 63 por configuración, lo que cerca del límite puede ser en parte ruido. Los fallos específicos a continuación son sólidos. La magnitud exacta de la caída es menos cierta.
Sin una habilidad, el agente ya era fiable en los pares evidentes. Enviar frente a borrador frente a programar, añadir una reacción y enumerar sus propios canales eran correctos casi siempre de cualquier forma. Algunas tareas fueron diferentes, y ahí es donde el modelo más pequeño ganó.
Las filas del índice detrás de esto son cortas:
Una petición, cuatro ejecuciones. "¿Quién es miembro de mcp-gateway?". La lista de miembros devuelve user ids. Una respuesta útil busca esos ids y proporciona nombres. Esfuerzo alto en todo momento. El único cambio en cada fila es la habilidad.
El modelo más pequeño completó las búsquedas de nombres. El modelo más grande siguió "haga una llamada y deténgase" y cortó la tarea.
Otras dos peticiones muestran el mismo comportamiento, ambas en Fable con esfuerzo alto, ambas pasando de 3 de 3 a 1 de 3. "Con mi permiso, busca en canales privados y DMs __mcp_skill_eval_no_match__". La búsqueda que incluye elementos privados era la herramienta correcta de cualquier forma. Sin habilidad, el agente aplicó un filtro especificando canales privados, DMs de grupo y DMs. El índice indica que esa búsqueda "incluye canales privados y DMs", y algunas ejecuciones con habilidad tomaron la frase literalmente, omitieron el filtro y luego dijeron que se habían buscado los DMs. Y "Lee toda la conversación bajo [un enlace a un mensaje]". La primera página solo contiene algunas de las respuestas, y los agentes a menudo presentaron esa página como la conversación completa. Eso fue difícil de cualquier forma, y la habilidad lo empeoró.
En cada caso, el agente tenía la herramienta correcta o estaba a una búsqueda de una respuesta completa. Luego siguió una línea general corta del índice más literalmente de lo que lo habría hecho por su cuenta.
El índice es pequeño y los archivos de referencia se cargan solo cuando son necesarios, por lo que el agente con habilidad utilizó ligeramente menos tokens de entrada que el agente sin habilidad. Las llamadas a herramientas cayeron cerca de un tercio, de 2,52 por tarea a 1,71, frente a un camino correcto más corto de 1,24. La mayor parte de ese ahorro fue en Sonnet, cuyas ejecuciones sin habilidad tendían a buscar, leer y buscar de nuevo. La mediana se volvió un poco más rápida, de 37,6 segundos a 35,1, y el 5 % más lento cayó de unos 75 segundos a unos 65. La evaluación completa costó 44,01 $ con la habilidad y 46,10 $ sin ella.
Omita una habilidad para lecturas rutinarias en un modelo sólido. Si el agente se ejecuta en Opus o Fable y principalmente busca en canales públicos y lee el historial, la lista de herramientas ya está haciendo el trabajo. Una habilidad ahorrará algunas llamadas. Puede que no aumente la precisión, y en un modelo cerca del límite puede costar algunos ensayos.
Añada una si un modelo más pequeño está en el camino, o si las tareas implican el alcance de la búsqueda, una capacidad faltante o una escritura que el usuario ya ha detallado. Sonnet con esfuerzo alto, del 66,7 % al 88,9 %, es la razón por la que escribimos una. En ese punto, la habilidad no es un detalle de ingeniería de peticiones. Es la diferencia entre necesitar Opus o no.
Luego depúrela. Mantenga el índice limitado a la elección, cargue los detalles bajo demanda y lea las tareas que empeoraron. Si una regla corta trabajo que el modelo ya estaba haciendo, como buscar nombres después de enumerar miembros, restrinja la regla o elimínela. Una habilidad más corta es más fácil de seguir. Eso incluye las ocasiones en que no debería haberse seguido.
Pruebe cada regla nueva en su modelo más potente antes de confiar en ella. En el modelo más pequeño es donde se ve la ganancia. En el modelo más potente es donde se ve cuando la regla se impone al buen criterio.
Una habilidad cambia qué herramienta de Slack se llama. No decide quién puede buscar en canales privados, qué token utiliza la llamada o qué se registra.
El TrueFoundry Skills Registry mantiene una habilidad como esta con control de versiones y compartida. Una habilidad reside en un repositorio junto con peticiones y modelos. El repositorio decide quién puede descubrirla, editarla y adjuntarla, y mantiene el historial de versiones y el registro de auditoría. Cada publicación es una versión numerada, de modo que cuando se restringe una regla que causó una regresión, cada agente incorpora la misma corrección, y un agente puede fijarse a una versión anterior si una nueva publicación no se comporta correctamente. La misma versión se puede adjuntar a un agente de TrueFoundry o importar en Claude Code y Cursor. Esta habilidad de Slack es un índice más tres archivos de referencia, por lo que se publica como un paquete a través de la CLI o mediante GitOps con tfy apply.
El TrueFoundry MCP Gateway se sitúa delante del servidor Slack MCP. Gestiona la autenticación, el control de acceso a nivel de herramienta y el seguimiento de cada llamada. El sobrecoste es de unos 3 a 4 ms, y gestiona más de 350 solicitudes por segundo en una vCPU. Esta evaluación utilizó una reproducción local, por lo que no dice nada sobre la pasarela. La habilidad elige la llamada. La pasarela decide si esa llamada está permitida.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada




