Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.
9,9
Wie man über die AI Gateway Architecture im Generative AI Stack nachdenkt
In modernen generativen AI-Systemen fungiert das AI Gateway als kritische Proxy-Schicht zwischen Anwendungen und Anbietern von Sprachmodellen (LLM). Es spielt eine zentrale Rolle bei der Verwaltung von Zuverlässigkeit, Observability, Zugriffskontrolle und Kosteneffizienz für jede Anfrage, die in die Produktion fließt.
Da das Gateway im kritischen Pfad des Produktionsdatenverkehrs liegt, muss es unter Berücksichtigung der folgenden Kernprinzipien entworfen werden:
Wichtige Architekturprioritäten:
Hohe Verfügbarkeit: Das Gateway darf nicht zu einem Single Point of Failure werden. Selbst bei Problemen mit Abhängigkeiten (wie Ausfällen von Datenbanken oder Queues) sollte es den Datenverkehr weiterhin reibungslos bedienen.
Geringe Latenz: Da es inline bei jeder Inference-Anfrage liegt, muss das Gateway minimalen Overhead erzeugen, um eine schnelle Benutzererfahrung zu gewährleisten.
Hoher Durchsatz und Skalierbarkeit: Das System sollte Cloud Scalability unterstützen, linear mit der Last skalieren und Tausende von gleichzeitigen Anfragen mit effizienter Ressourcennutzung verarbeiten.
Keine externen Abhängigkeiten im Hot Path: Alle netzwerk- oder festplattengebundenen Vorgänge sollten auf asynchrone Systeme ausgelagert werden, um Performance-Engpässe zu vermeiden.
Entscheidungsfindung im Arbeitsspeicher: Kritische Prüfungen wie Rate Limiting, Load Balancing, Authentifizierung und Autorisierung sollten für maximale Geschwindigkeit und Zuverlässigkeit alle in-memory durchgeführt werden.
Trennung von Control Plane und Proxy Plane: Konfigurationsänderungen und Systemverwaltung sollten vom Live-Traffic-Routing entkoppelt werden, was globale Bereitstellungen mit regionaler Fehlertrennung ermöglicht.
TrueFoundry's AI Gateway Architecture
Das AI Gateway von TrueFoundry verkörpert alle oben genannten Entwurfsprinzipien und wurde speziell für geringe Latenz, hohe Zuverlässigkeit und nahtlose Skalierbarkeit entwickelt.
TrueFoundry's Gateway Architecture
Hauptmerkmale der AI Gateway Architecture
Baut auf dem Hono Framework auf: Das Gateway nutzt Hono, ein minimalistisches, extrem schnelles Framework, das für Edge-Umgebungen optimiert ist. Dies sorgt für minimalen Laufzeit-Overhead und eine extrem schnelle Anfrageverarbeitung.
Keine externen Aufrufe im Anfragepfad: Sobald eine Anfrage das Gateway erreicht, löst sie keine externen Aufrufe aus (es sei denn, semantisches Caching ist aktiviert). Die gesamte betriebliche Logik wird intern verarbeitet, was das Risiko verringert und die Zuverlässigkeit erhöht.
In-Memory-Durchsetzung: Alle Entscheidungen bezüglich Authentifizierung, Autorisierung, Rate-Limiting und Load-Balancing werden mithilfe von In-Memory-Konfigurationen getroffen, was Antwortzeiten im Sub-Millisekunden-Bereich garantiert.
Asynchrones Logging: Protokolle und Anfragemetriken werden asynchron an eine Nachrichtensequenz (Queue) übergeben, um sicherzustellen, dass Data Observability den Anfragepfad nicht blockiert oder verlangsamt.
Ausfallsicheres Verhalten (Fail-Safe): Selbst wenn die externe Logging-Queue ausfällt, wird das Gateway keine Anfragen fehlschlagen lassen. Dies garantiert Betriebszeit und Resilienz bei partiellen Systemausfällen.
Horizontal skalierbar: Das Gateway ist CPU-gebunden und zustandslos (stateless), was das Scale-Out einfach macht. Es arbeitet effizient bei hoher Nebenläufigkeit und geringem Speicherverbrauch.
Control Plane & Datenfluss
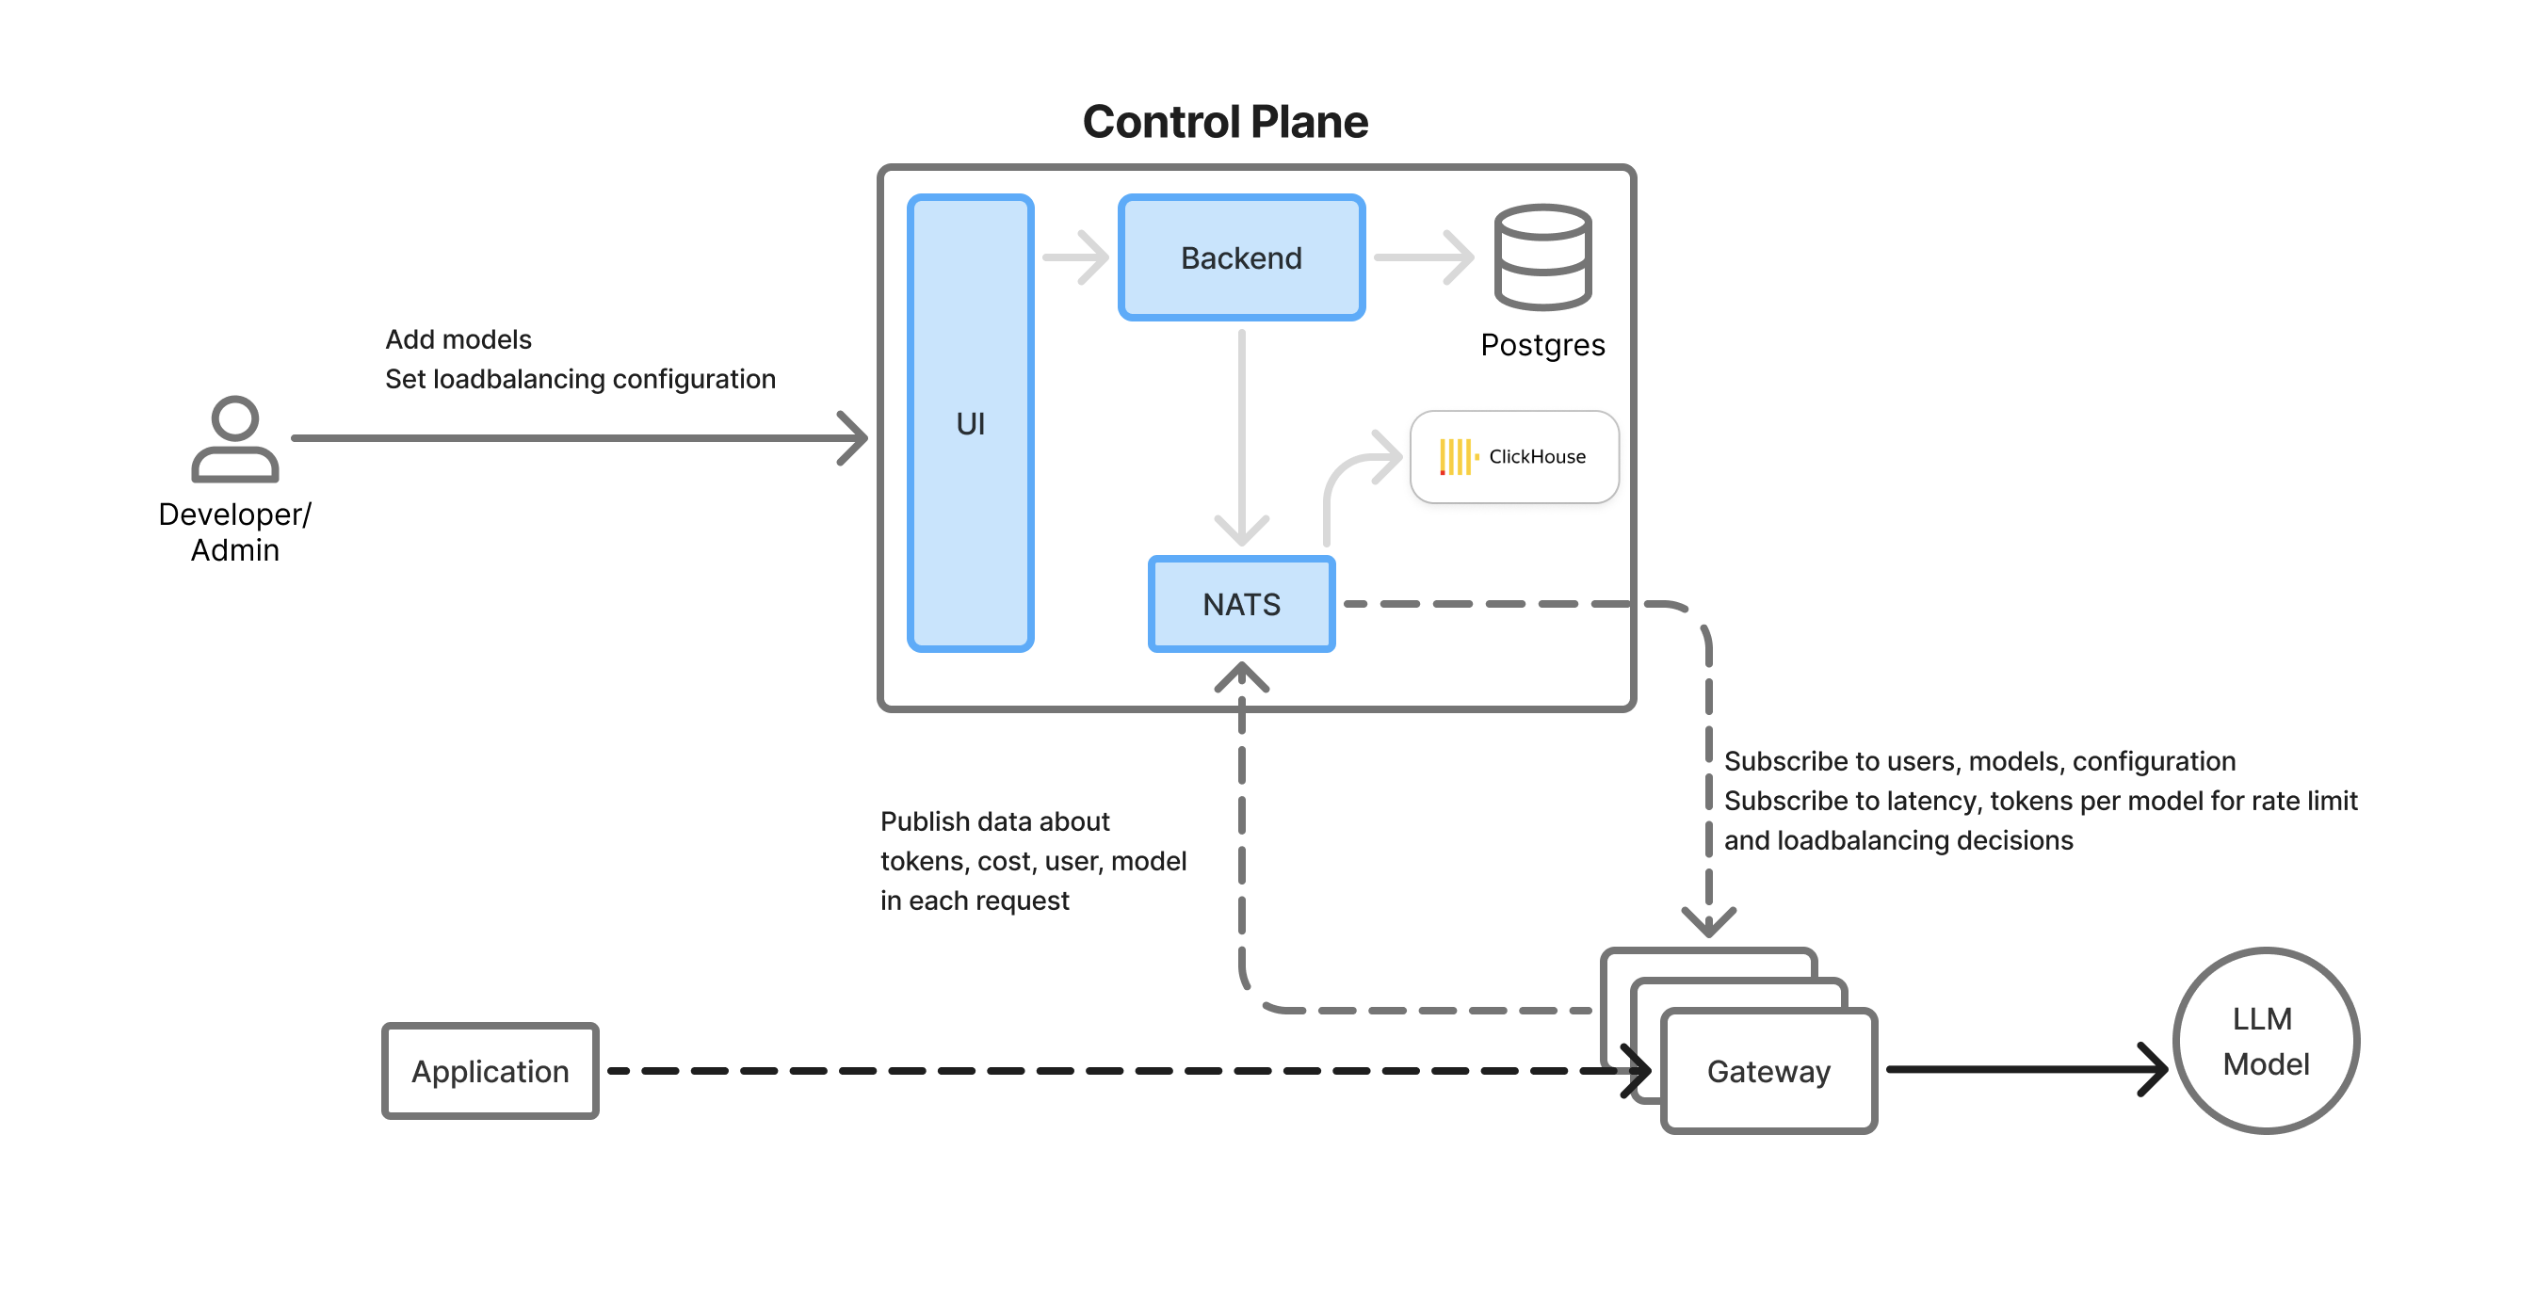
TrueFoundry trennt die Control Plane (Verwaltung) von der Data Plane (Echtzeit-Traffic-Routing) für Skalierbarkeit und Flexibilität.
Komponentenübersicht des AI Gateways:
UI: Weboberfläche mit einem LLM-Playground, Monitoring-Dashboards und Konfigurationspanels für Modelle, Teams, Rate Limits usw.
ClickHouse: Hochleistungsfähige Spaltendatenbank zur Speicherung von Logs, Metriken und Nutzungsanalysen.
NATS Queue: Fungiert als Echtzeit-Synchronisationsbus zwischen der Control Plane und den verteilten Gateway-Pods. Alle Konfigurations-/Zustandsaktualisierungen werden über NATS übertragen und sind in allen Regionen sofort verfügbar.
Backend Service: Orchestriert die Konfigurationssynchronisation, Datenbankaktualisierungen und die Erfassung von Analysedaten.
Gateway Pods: Zustandslose, in der Region liegende, leichtgewichtige Proxys, die den tatsächlichen LLM-Datenverkehr verarbeiten. Sie konsumieren NATS-Nachrichten und führen die gesamte Logik in-memory aus, ohne externe Abhängigkeiten.
Key Metrics for Evaluating Gateway
Criteria
What should you evaluate ?
Priority
TrueFoundry
Latency
Adds <10ms p95 overhead for time-to-first-token?
Must Have
✅ Supported
Data Residency
Keeps logs within your region (EU/US)?
Depends on use case
✅ Supported
Latency-Based Routing
Automatically reroutes based on real-time latency/failures?
Must Have
✅ Supported
Key Rotation & Revocation
Rotate or revoke keys without downtime?
Must Have
✅ Supported
Key Rotation & Revocation
Rotate or revoke keys without downtime?
Must Have
✅ Supported
Key Rotation & Revocation
Rotate or revoke keys without downtime?
Must Have
✅ Supported
Key Rotation & Revocation
Rotate or revoke keys without downtime?
Must Have
✅ Supported
Key Rotation & Revocation
Rotate or revoke keys without downtime?
Must Have
✅ Supported
Evaluating an AI Gateway?
A practical guide used by platform & infra teams
Performance Benchmarks für das AI Gateway von TrueFoundry
Das Gateway von TrueFoundry wurde unter produktionsnahen Lasten gründlich auf seine Performance getestet:
250 RPS bei 1 CPU/1GB RAM mit nur 3 ms zusätzlicher Latenz.
Skaliert effizient bis zu 350 RPS pro Pod vor Erreichen der CPU-Sättigung; darüber hinaus können Replikate hinzugefügt werden.
Unterstützt Zehntausende von RPS durch horizontale Skalierung über Regionen hinweg.
Keine zusätzliche Latenz, selbst wenn mehrere Regeln für Rate-Limiting, Auth und Load-Balancing eingerichtet sind.
Warum das wichtig ist
Wenn Sie GenAI-Workloads in großem Maßstab ausführen oder planen, mehrere LLMs (OpenAI, Claude, Open Source usw.) zu integrieren, wird das Gateway zum Fundament Ihres Stacks.
Das Design von TrueFoundry stellt sicher:
Sie können sicher über verschiedene Anbieter hinweg routen und skalieren.
Wenden Sie feingranulare Steuerungen auf Benutzer-/Team-Ebene an.
Wahren Sie Observability und Governance über das gesamte System hinweg, während Sie die Cost of Generative AI kontrollieren.
Erreichen Sie all dies, ohne Beeinträchtigung von Latenz oder Zuverlässigkeit.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.
Auf Geschwindigkeit ausgelegt: ~ 10 ms Latenz, auch unter Last