outubro 5, 2023
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
À medida que a adoção de machine learning continua a acelerar em todos os setores, a necessidade de pipelines de ML robustos, escaláveis e automatizados nunca foi tão grande. Em 2026, as plataformas de MLOps se tornaram fundamentais para a operacionalização da AI, desde o treinamento e implantação de modelos até o monitoramento e governança.
Essas plataformas otimizam o ciclo de vida de ponta a ponta, ajudando as equipes a gerenciar a complexidade, garantir a reprodutibilidade e acelerar o tempo até o valor (time-to-value). Seja você uma startup escalando seu primeiro modelo ou uma grande empresa implantando centenas, escolher a plataforma de MLOps certa é fundamental.
Neste guia, exploramos o que é MLOps, por que ele é importante e as melhores ferramentas de MLOps que estão moldando o mercado em 2026.
MLOps (Machine Learning Operations) é uma disciplina que unifica os princípios de machine learning, DevOps e engenharia de dados para permitir o desenvolvimento, a implantação, o monitoramento e a manutenção de sistemas de ML confiáveis em escala. Ele garante que os modelos construídos em ambientes experimentais possam ser transicionados com segurança e eficiência para a produção, onde devem operar de forma consistente, adaptar-se às mudanças e manter a rastreabilidade e governança.
Os fluxos de trabalho tradicionais de DevOps focam no controle de versão, pipelines de CI/CD, testes automatizados e confiabilidade do sistema. O MLOps herda esses conceitos, mas os estende para enfrentar os desafios únicos do machine learning: gerenciar dados em constante evolução, reterar modelos para lidar com o drift (degradação), avaliar resultados não determinísticos e manter a reprodutibilidade entre as iterações dos modelos.
À medida que o machine learning avança da experimentação para a implantação em escala empresarial, as ferramentas de MLOps se tornaram essenciais para garantir consistência, confiabilidade e velocidade ao longo de todo o ciclo de vida do modelo. Sem uma solução de MLOps centralizada, as equipes frequentemente terminam com ferramentas fragmentadas, processos manuais e fluxos de trabalho inconsistentes que desaceleram a inovação e introduzem riscos operacionais.
As plataformas de MLOps resolvem esses desafios oferecendo uma interface unificada para gerenciar pipelines de dados, fluxos de treinamento, rastreamento de modelos, implantação e monitoramento, tudo em um só lugar. Essa consolidação permite uma colaboração mais estreita entre cientistas de dados, engenheiros de ML e equipes de DevOps, reduzindo os atritos nas passagens de bastão e melhorando a reprodutibilidade entre ambientes.
Ao selecionar as ferramentas de MLOps em 2026, é importante avaliar não apenas os recursos, mas o quão bem a plataforma suporta seu fluxo de trabalho de ML, escala com sua infraestrutura e se alinha aos objetivos operacionais da sua equipe. Abaixo estão alguns critérios essenciais a serem considerados:
Uma plataforma de MLOps ideal deve cobrir todo o ciclo de vida do machine learning, desde o versionamento de dados e treinamento até a implantação e monitoramento. Cadeias de ferramentas fragmentadas podem criar ineficiências e inconsistências entre as equipes. Plataformas que unificam essas etapas em um único fluxo de trabalho ajudam a melhorar a reprodutibilidade, reduzir o atrito na transição de tarefas e acelerar a iteração.
À medida que as cargas de trabalho de ML escalam, a plataforma também deve escalar. Uma boa solução de MLOps deve suportar desde a experimentação local até o treinamento distribuído em múltiplos GPUs ou nós. Ela também deve oferecer flexibilidade na implantação, suportando ambientes nativos na nuvem, on-premise e híbridos sem prender você a uma pilha de tecnologia específica (vendor lock-in).
A usabilidade é frequentemente negligenciada, mas é crítica. Uma plataforma sólida oferece interfaces limpas, tanto UI quanto CLI, além de SDKs abrangentes que se integram com frameworks populares como PyTorch, TensorFlow e Hugging Face. Uma plataforma intuitiva tanto para cientistas de dados quanto para engenheiros de ML promove uma colaboração melhor e um onboarding mais rápido.
O MLOps não existe isoladamente. Sua plataforma deve se integrar perfeitamente aos sistemas existentes para armazenamento (como S3 ou GCS), ferramentas de CI/CD (como GitHub Actions ou Jenkins), plataformas de observabilidade (como Prometheus ou Grafana) e registries de modelos. Integrações fortes garantem o fluxo contínuo de dados e modelos através do seu pipeline.
Para organizações que operam em ambientes regulados, os recursos de governança são obrigatórios. A plataforma deve suportar controle de acesso baseado em funções (RBAC), logs de auditoria e rastreamento de linhagem (lineage tracking). A conformidade com padrões como SOC 2, HIPAA ou GDPR ajuda a garantir a privacidade dos dados, a confiança e a viabilidade de longo prazo em cenários corporativos.
O cenário de MLOps em 2026 é rico em plataformas que atendem a diferentes necessidades, desde o rastreamento leve de experimentos até a implantação e monitoramento de modelos em nível corporativo. Abaixo estão as 25 melhores ferramentas de MLOps que ajudam as equipes a otimizar seus fluxos de trabalho de ML, maximizar a infraestrutura e operacionalizar modelos em escala. Cada plataforma tem seus pontos fortes dependendo da sua pilha tecnológica, maturidade da equipe e objetivos de negócios.
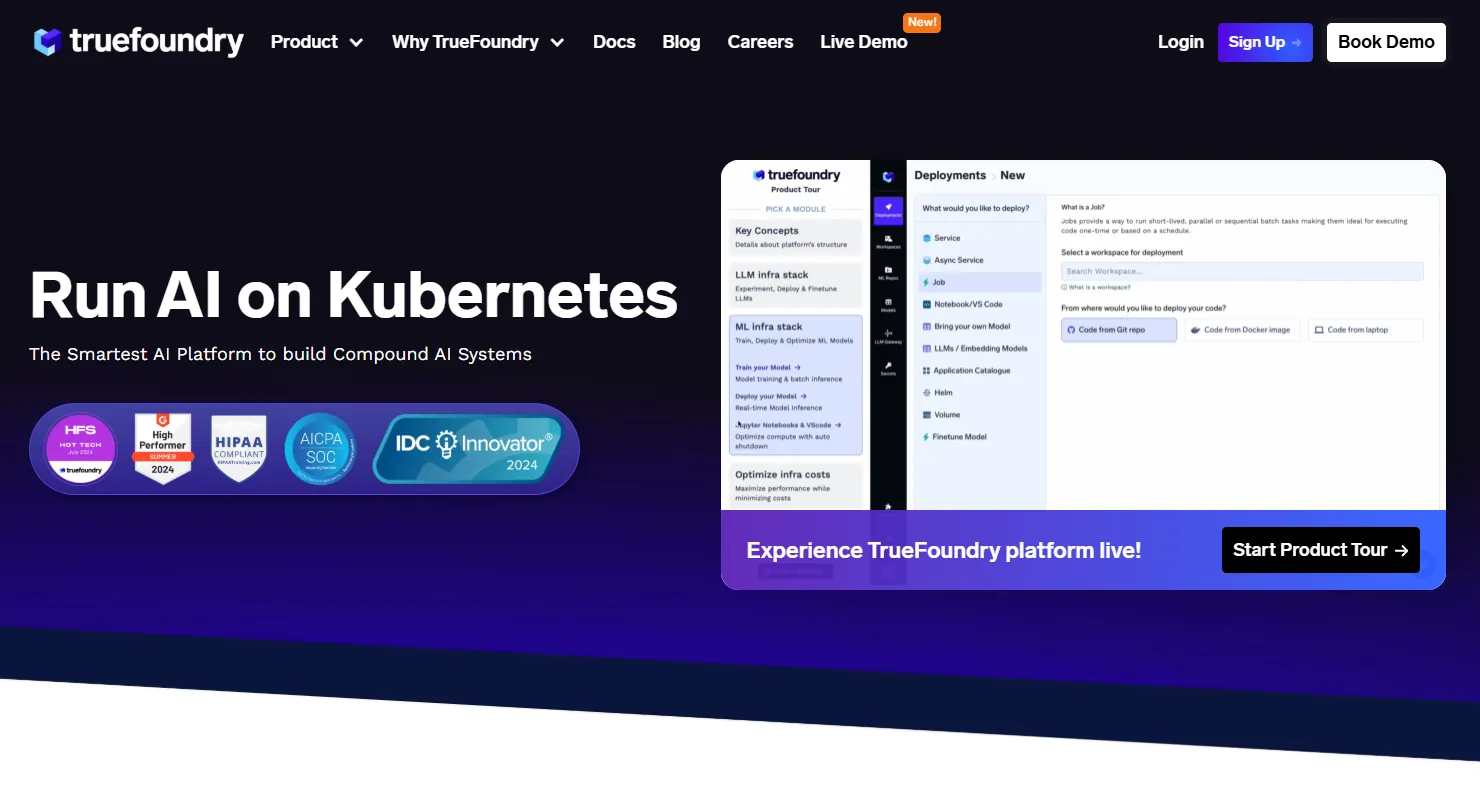
A TrueFoundry é uma plataforma moderna de MLOps e LLMOps desenvolvida para equipes que desejam implantar, escalar e monitorar modelos de machine learning e AI generativa em produção. Ela abstrai a complexidade da infraestrutura enquanto oferece controle total, permitindo que as equipes passem da experimentação para a implantação em minutos.
Diferente de sistemas legados, a TrueFoundry é otimizada para alto desempenho, produtividade do desenvolvedor e fluxos de trabalho focados em GenAI, incluindo suporte a agentes, pipelines de RAG e rastreamento avançado (tracing). Sua segurança de nível corporativo e design modular a tornam uma das melhores ferramentas de MLOps, adequada para organizações de todos os portes.
Principais Recursos:
Ideal Para:
Equipes impulsionadas por AI que constroem produtos baseados em LLM, especialmente onde desempenho, segurança e observabilidade são críticos. Excelente escolha para equipes em rápido crescimento ou empresas que precisam de implantação escalável de GenAI. Aqui estão algumas das melhores ferramentas de LLM gateway.
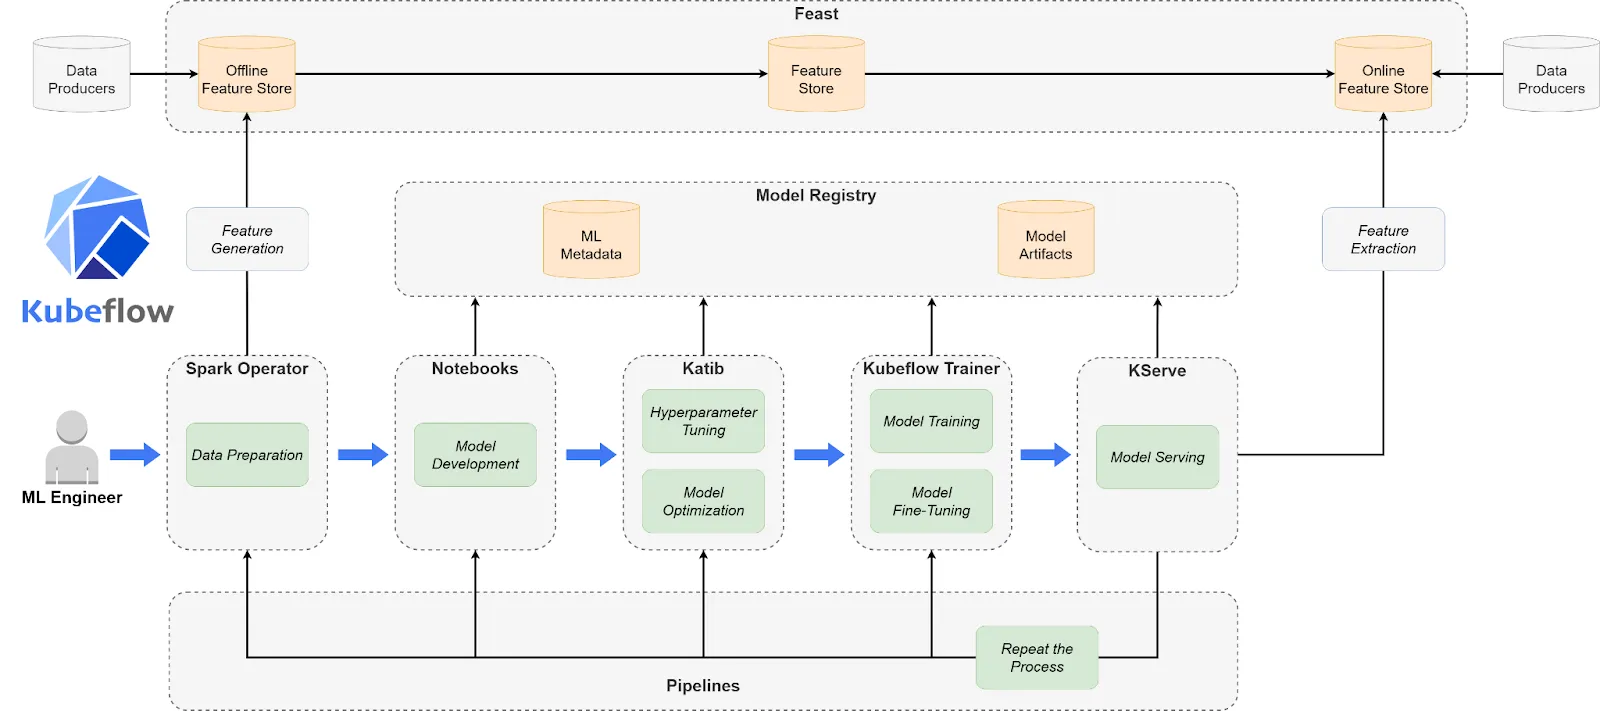
O Kubeflow é uma das melhores ferramentas de MLOps open-source e nativas do Kubernetes para construir e gerenciar fluxos de trabalho de ML portáveis e composíveis. Ele oferece flexibilidade para orquestrar treinamento, ajustes e serviço utilizando abstrações conhecidas do Kubernetes. Embora poderoso, o Kubeflow exige conhecimento profundo de infraestrutura e não é o ideal para equipes sem suporte dedicado de DevOps. Ele se destaca quando pipelines de ML personalizados, escaláveis e seguros são indispensáveis.
Principais Recursos:
Ideal Para:
Equipes com forte expertise em Kubernetes que buscam personalizar e controlar totalmente seus fluxos de trabalho de MLOps, especialmente em ambientes de nuvem híbrida ou altamente regulados.
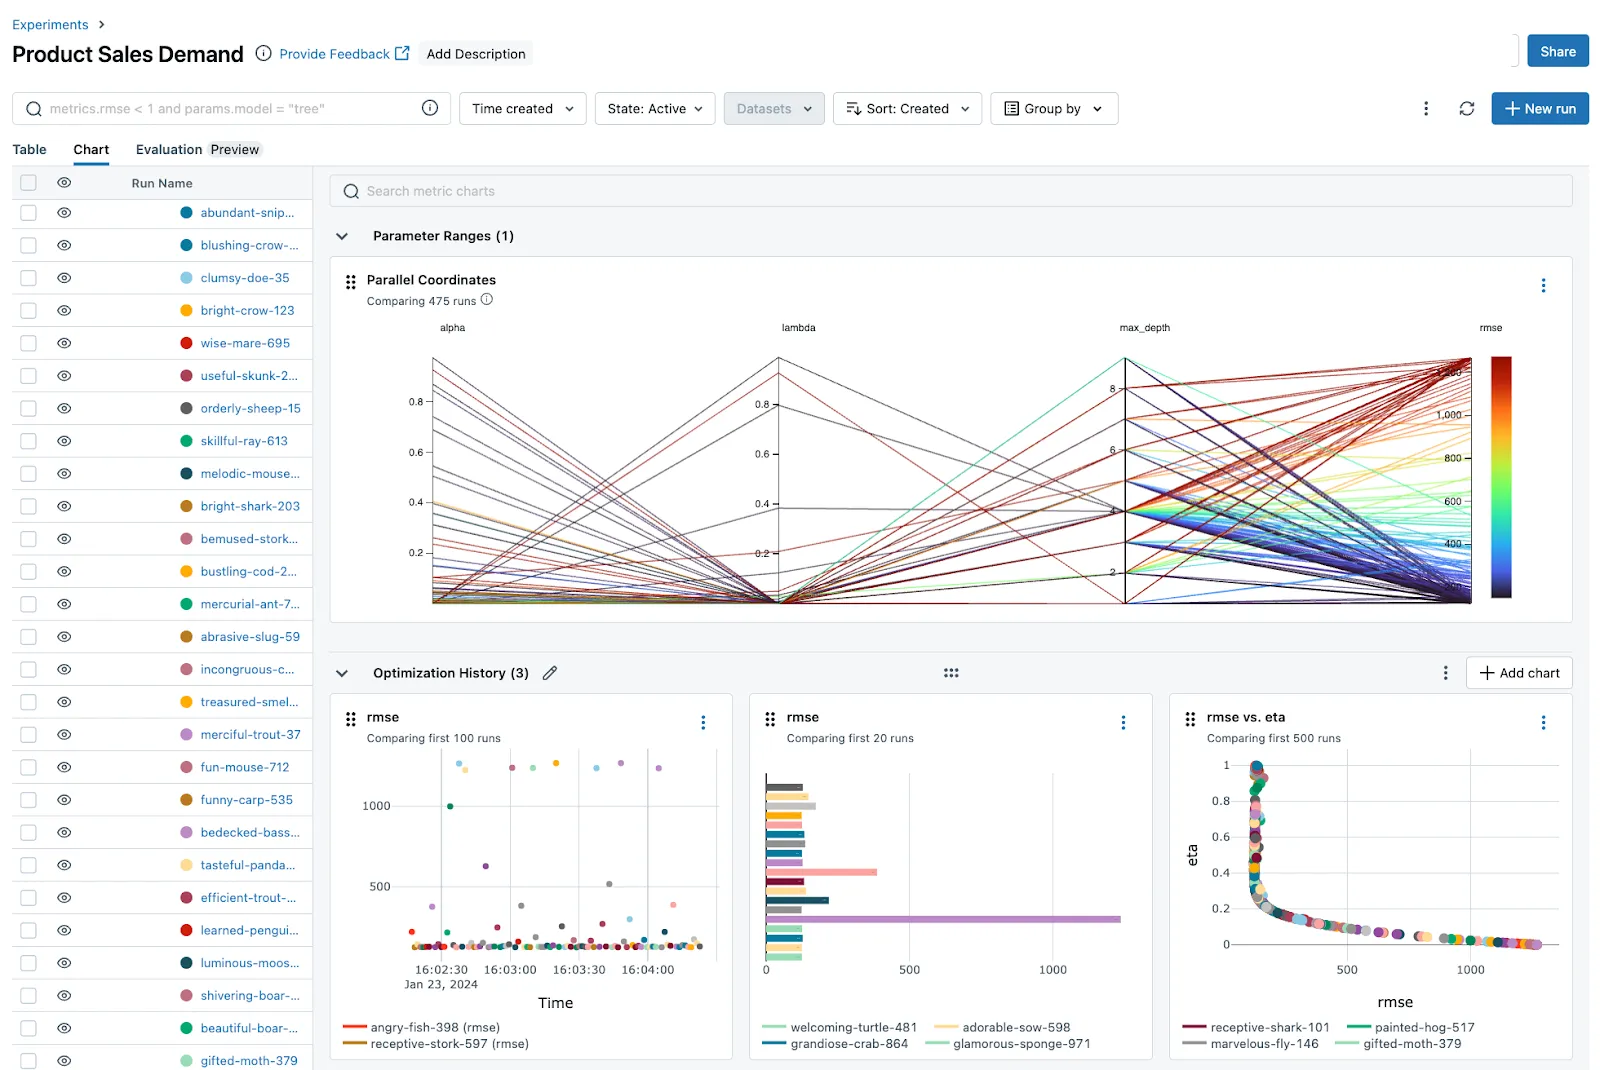
O MLflow é uma plataforma de MLOps leve e open-source criada pela Databricks, focada no gerenciamento da experimentação de ML e no versionamento de modelos. Seus componentes modulares permitem que as equipes integrem rastreamento, registry e implantação aos seus fluxos de trabalho existentes.
Esta ferramenta de MLOps é ideal para equipes menores ou organizações que desejam flexibilidade sem a sobrecarga de uma infraestrutura em grande escala ou do Kubernetes.
Principais Recursos:
Ideal Para:
Equipes de ML que buscam ferramentas leves e personalizáveis para rastrear experimentos, compartilhar modelos e gerenciar versões sem depender de uma plataforma de grande porte.
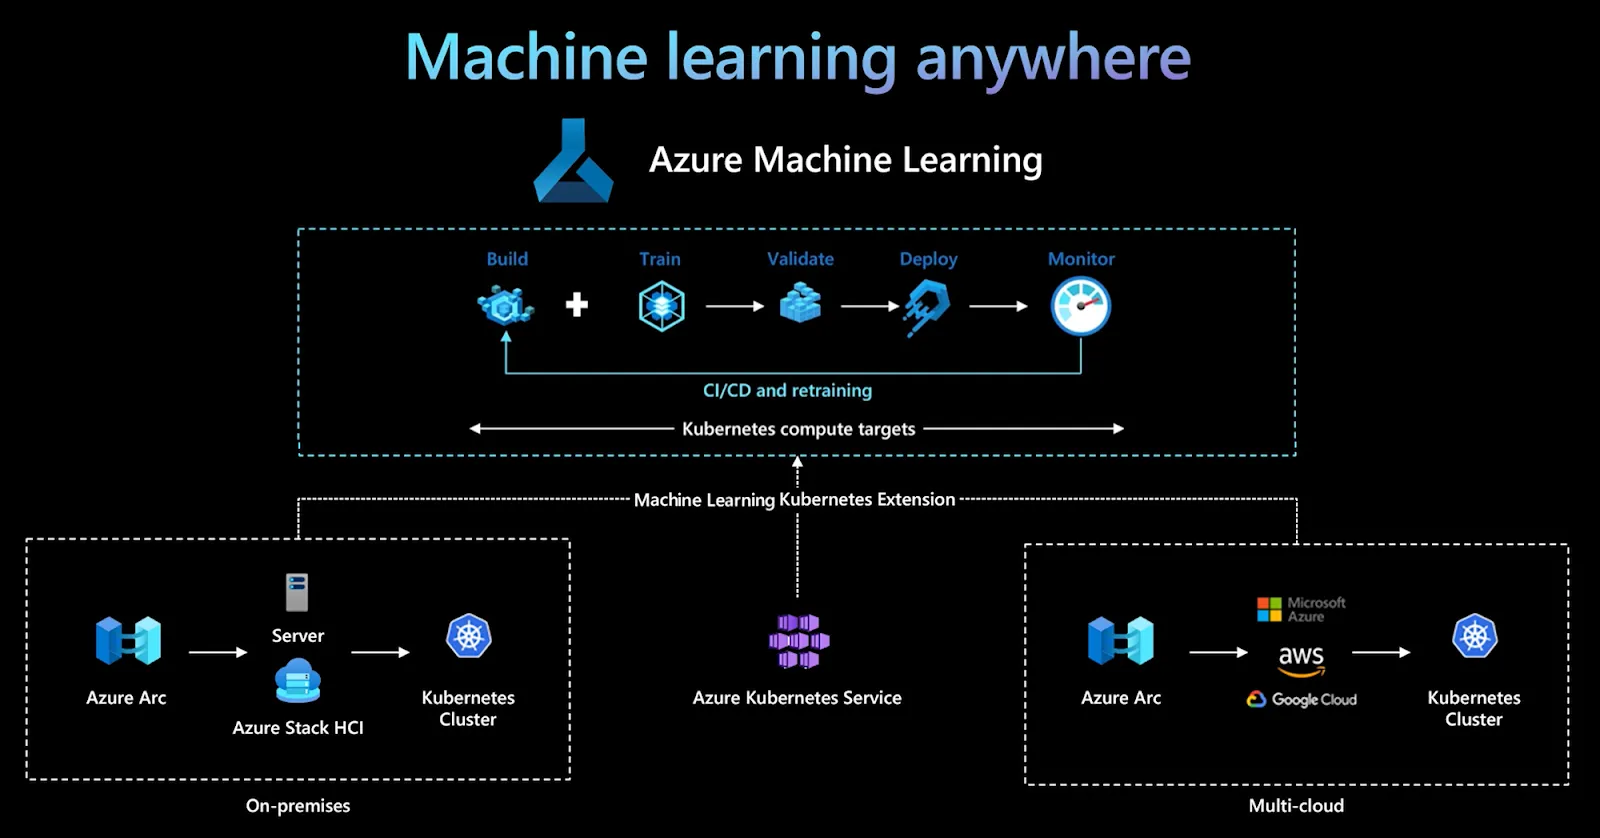
O Azure Machine Learning é a plataforma de MLOps totalmente gerenciada da Microsoft, projetada para construir, treinar, implantar e monitorar modelos de machine learning em escala corporativa. Ela se integra profundamente ao ecossistema Azure, oferecendo um conjunto poderoso de ferramentas para gerenciamento de modelos, AutoML e AI responsável. O Azure ML é ideal para organizações que já investem na nuvem da Microsoft e buscam segurança, escalabilidade e conformidade.
Principais Recursos:
Ideal Para:
Empresas que operam na Microsoft Azure e precisam de uma plataforma de MLOps altamente segura, escalável e totalmente integrada, com conformidade corporativa nativa.
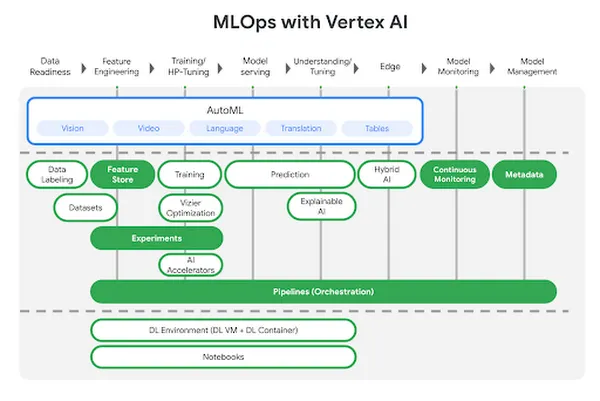
O Vertex AI é a plataforma unificada do Google Cloud para desenvolvimento de ML, combinando AutoML e treinamento de modelos customizados sob uma única interface. Ele abstrai a infraestrutura enquanto oferece serviços avançados como feature stores, pipelines e rastreamento de experimentos.
Construído para escalabilidade e integração com o ecossistema do Google, esta ferramenta de MLOps é otimizada para implantação de ML em nível de produção e fluxos orientados a dados.
Principais Recursos:
Ideal Para:
Equipes que constroem e escalam machine learning no Google Cloud e desejam uma plataforma de MLOps gerenciada e escalável com integração total de dados e implantação.
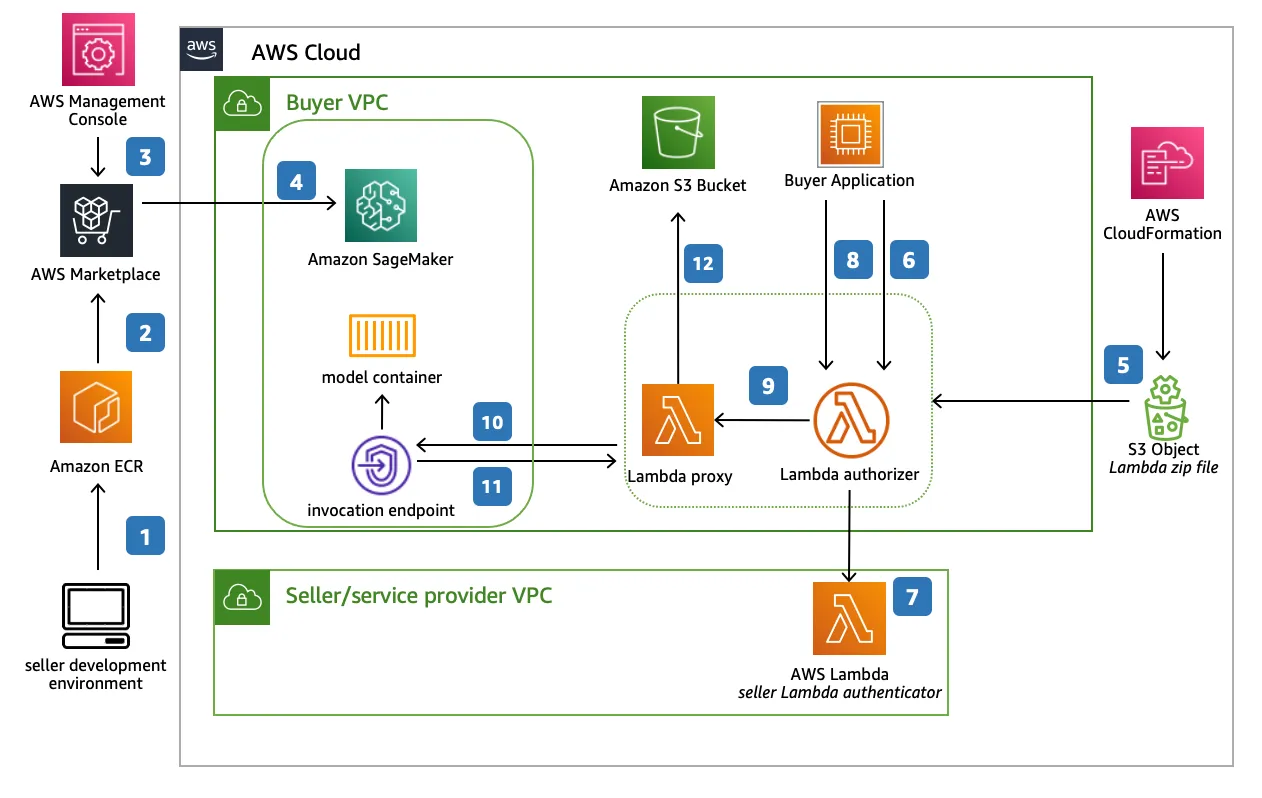
O Amazon SageMaker é a plataforma principal de MLOps da AWS, oferecendo desde o pré-processamento de dados até a implantação de modelos em tempo real. Conhecido por sua ampla funcionalidade, o SageMaker suporta desenvolvimento de modelos customizados, AutoML, hospedagem de modelos e ferramentas avançadas de monitoramento. É profundamente integrado ao ecossistema AWS, sendo a escolha ideal para empresas nativas da nuvem.
Principais Recursos:
Ideal Para:
Organizações que já utilizam a AWS para infraestrutura e precisam de uma plataforma de MLOps robusta e escalável, com integração profunda e suporte a todo o ciclo de vida.
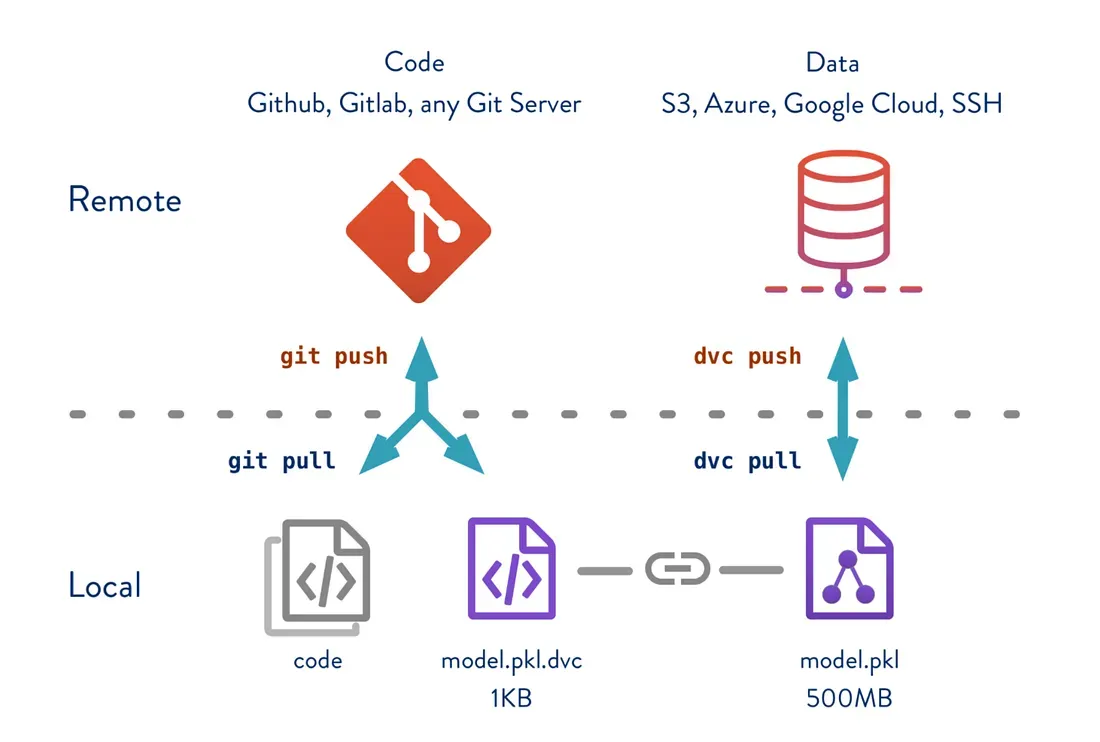
O DVC é uma ferramenta open-source que traz o controle de versão para projetos de machine learning, rastreando datasets, modelos e experimentos — de forma semelhante a como o Git gerencia código. Ele não busca ser uma plataforma completa de MLOps, mas foca na reprodutibilidade, colaboração e rastreamento de modelos por meio de fluxos de trabalho compatíveis com Git. O DVC se integra perfeitamente a pipelines existentes e concede aos especialistas em ML maior controle sobre o gerenciamento de experimentos.
Principais Recursos:
Ideal Para:
Equipes que procuram recursos de MLOps leves e focados em código, voltados para reprodutibilidade, fluxos baseados em Git e gerenciamento de experimentos — especialmente em projetos de pesquisa e ML iterativo.
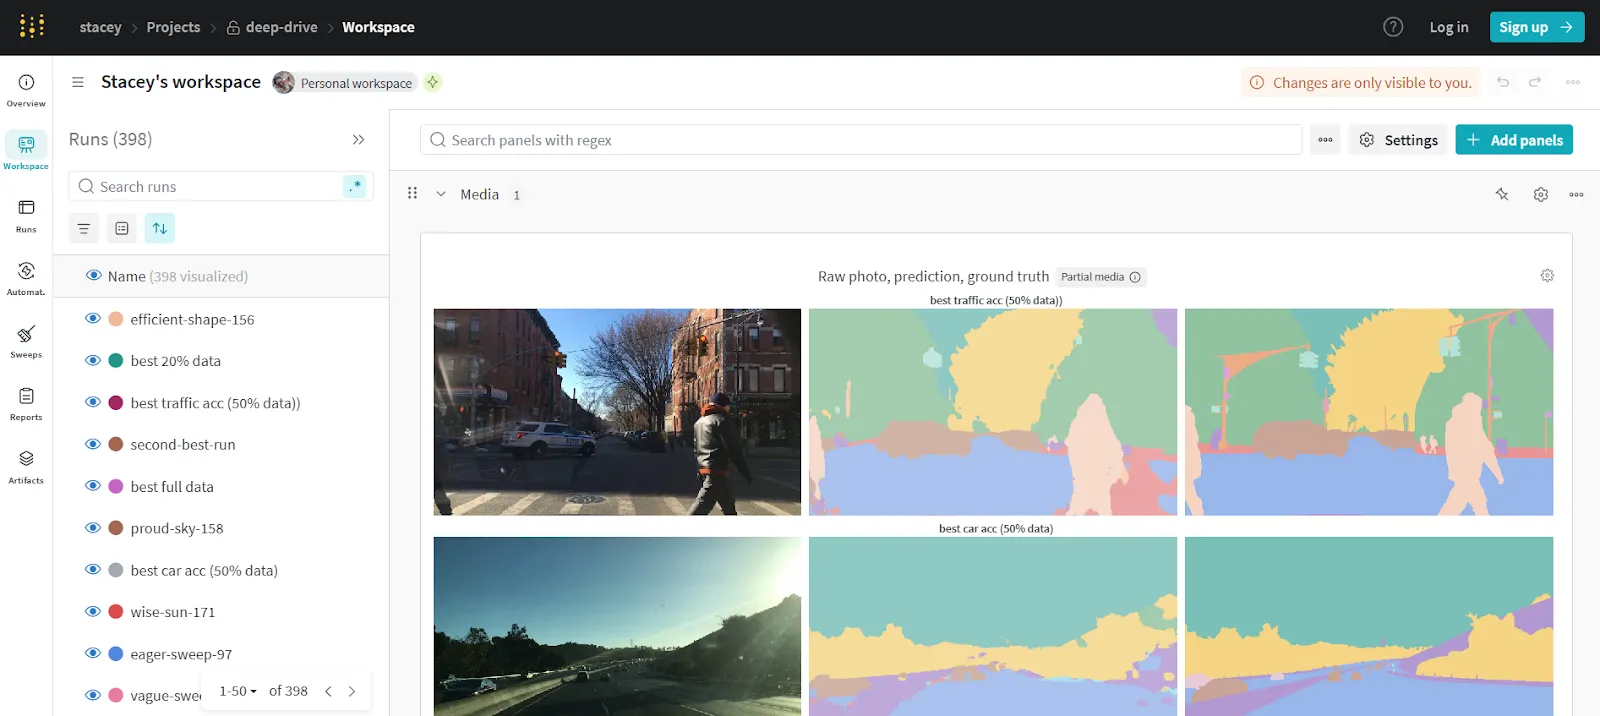
O Weights & Biases (W&B) é uma das melhores ferramentas de MLOps para rastreamento de experimentos, colaboração e visualização de modelos. É amplamente adotado tanto em ambientes de pesquisa quanto de produção, oferecendo integração simples com a maioria dos frameworks de ML. O W&B foca na observabilidade, permitindo visibilidade em tempo real sobre o desempenho do treinamento, hiperparâmetros e métricas do sistema.
Principais Recursos:
Ideal Para:
Equipes de ML focadas em iteração rápida, visualização e colaboração. Ideal para ambientes orientados à pesquisa e equipes que buscam melhor visibilidade sobre o desempenho do treinamento.
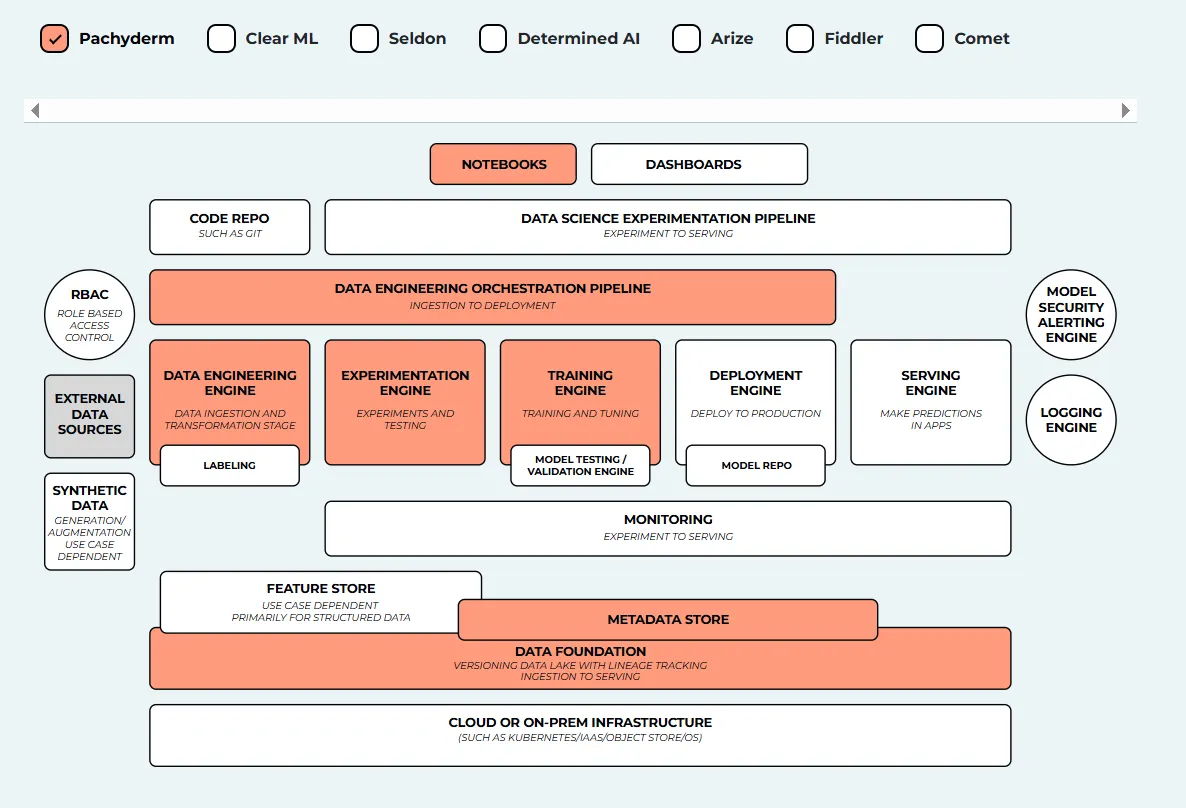
O Pachyderm é uma plataforma de ciência de dados open-source projetada para linhagem de dados, controle de versão e pipelines reprodutíveis. Diferente de ferramentas tradicionais de MLOps, o Pachyderm usa uma abordagem estilo Git para dados, tornando-o altamente adequado para equipes que lidam com dependências complexas de dados ou ambientes regulados. Ele combina conteinerização com orquestração de pipelines de dados para garantir fluxos versionados e rastreáveis.
Principais Recursos:
Ideal Para:
Equipes em setores regulados ou com fluxos intensivos de dados que necessitam de forte controle de versão e rastreamento de linhagem para conformidade, reprodutibilidade e escala.
O Allegro AI é uma plataforma de MLOps projetada especificamente para gerenciar fluxos de trabalho de deep learning em escala — particularmente em visão computacional e ambientes de AI na borda (Edge AI). Seu foco é melhorar a reprodutibilidade, colaboração e rastreabilidade ao longo do ciclo de vida da AI.
Com recursos robustos no gerenciamento de datasets, versionamento de modelos e rastreamento de experimentos, essa ferramenta de MLOps oferece uma infraestrutura segura de ponta a ponta para equipes que constroem e implantam modelos de alto desempenho em produção ou ambientes regulados.
Principais Recursos:
Ideal Para:
Equipes que trabalham com visão computacional, deep learning ou casos de uso em borda — especialmente em indústrias como automotiva, manufatura, saúde ou defesa, onde a rastreabilidade e o controle sobre dados e modelos são essenciais.
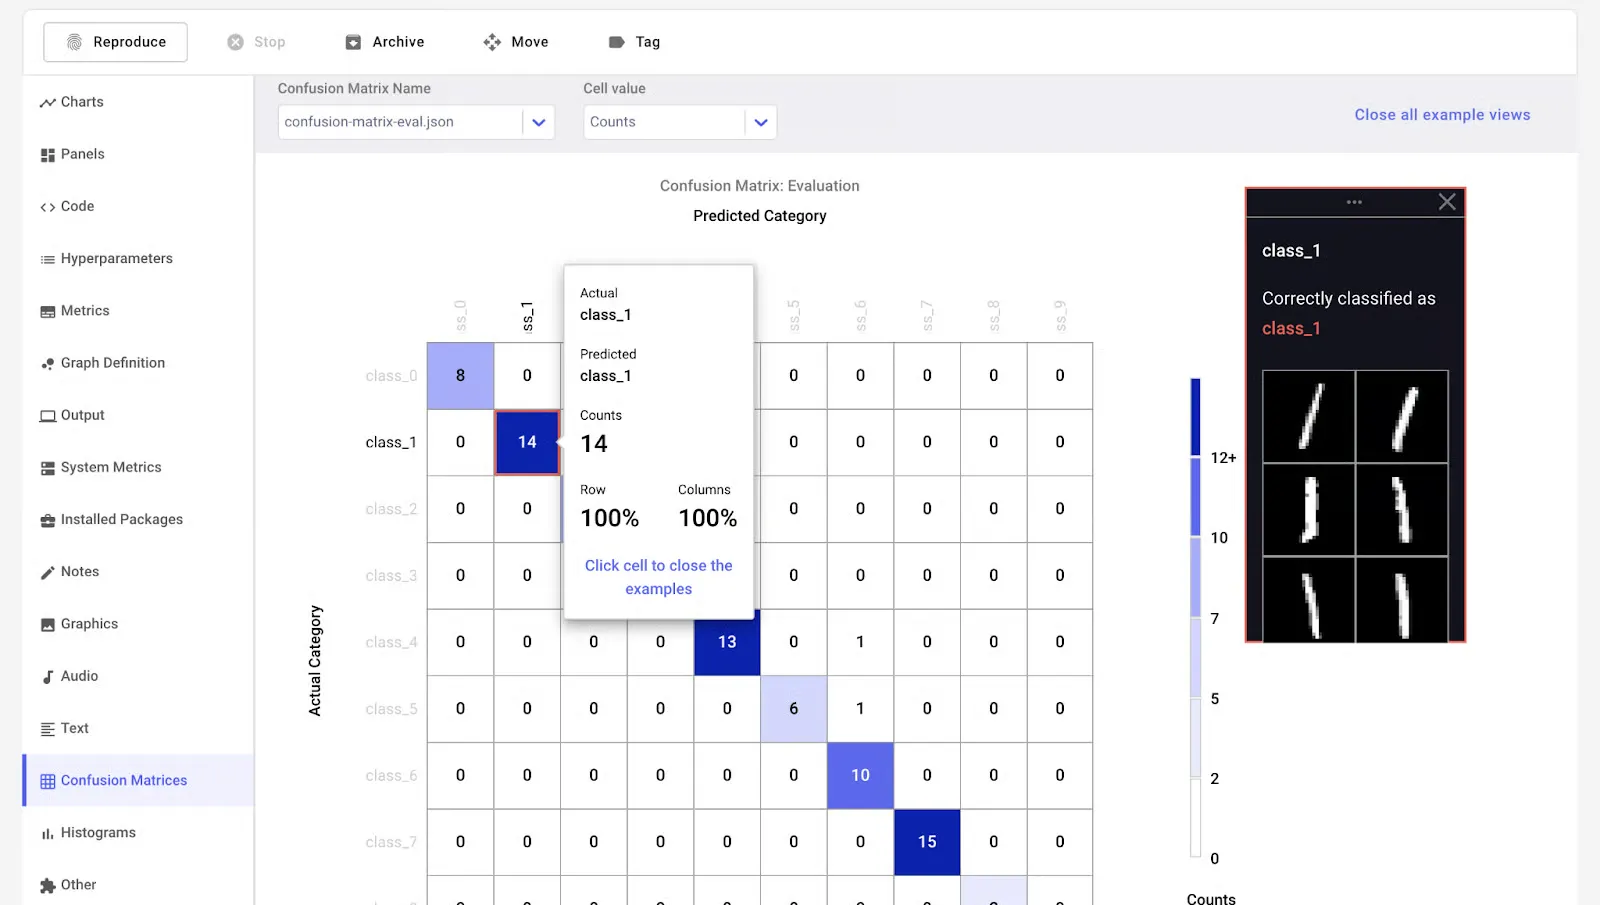
O Comet ML é uma plataforma de machine learning projetada para ajudar você a monitorar, analisar e aprimorar modelos e experimentos. Ele funciona perfeitamente com bibliotecas populares como Scikit-learn, PyTorch, TensorFlow e Hugging Face.
A ferramenta de MLOps Comet facilita a exploração e a comparação dos resultados dos experimentos, enquanto oferece visualizações ricas para amostras de dados, incluindo imagens, áudio, texto e tabelas estruturadas.
Principais Recursos:
Ideal Para:
Ideal para cientistas de dados, engenheiros de machine learning e equipes que buscam uma maneira simples de rastrear experimentos, comparar resultados e melhorar o desempenho dos modelos.
O Prefect é uma ferramenta moderna de orquestração de fluxos de trabalho projetada para monitorar, coordenar e gerenciar pipelines de dados em diversas aplicações. É uma solução leve e open-source criada para suportar fluxos de trabalho de dados e machine learning de ponta a ponta.
Você pode usar a Prefect Orion UI ou o Prefect Cloud para gerenciar e visualizar fluxos de trabalho. A Prefect Orion UI é um motor de orquestração open-source hospedado localmente e servidor de API que fornece insights sobre as execuções locais de fluxos e atividades do sistema.
O Prefect Cloud, por outro lado, é um serviço hospedado que permite visualizar fluxos, execuções e implantações, além de gerenciar contas, espaços de trabalho e a colaboração da equipe.
Principais Recursos:
Ideal Para:
Engenheiros de dados, engenheiros de ML e equipes que precisam de orquestração de fluxos de trabalho confiável, visibilidade sobre os pipelines e colaboração escalável para projetos de machine learning e dados.
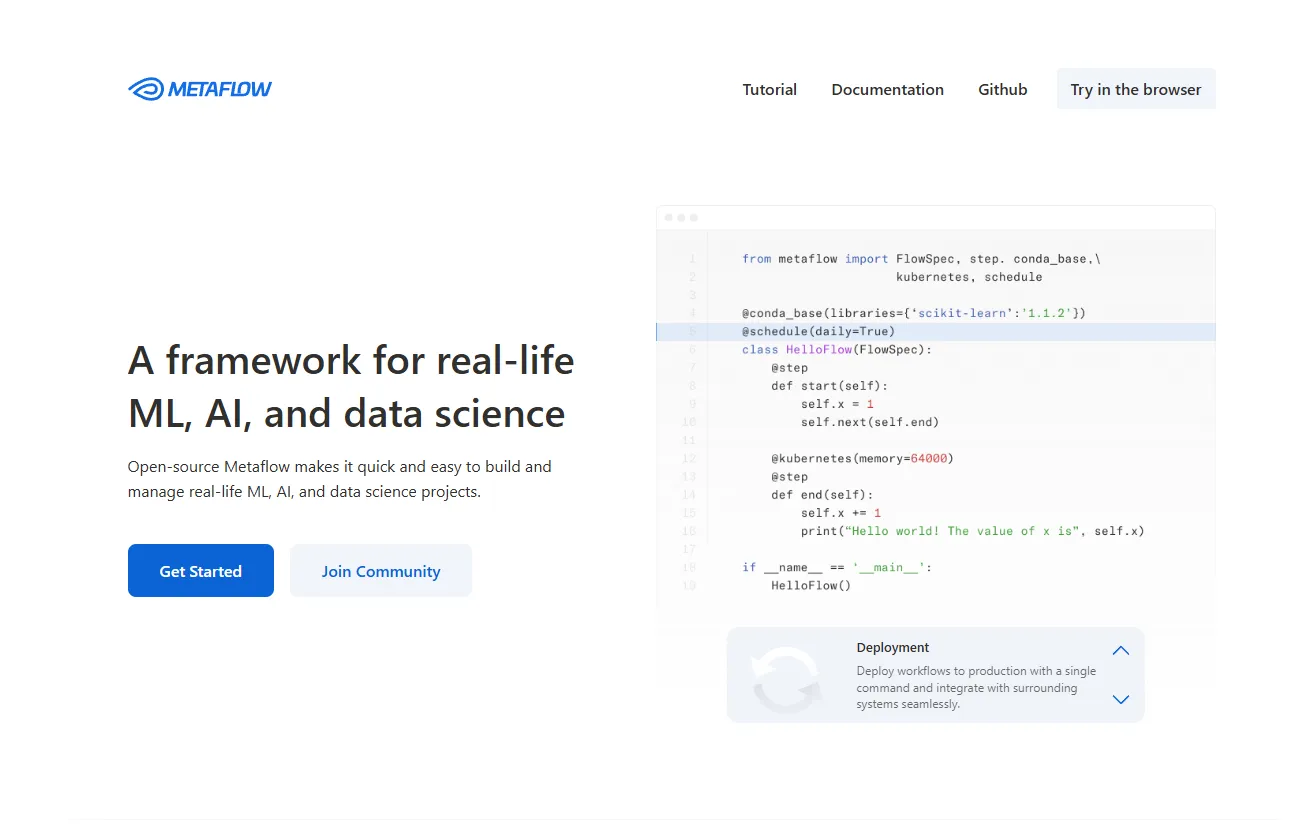
O Metaflow é uma ferramenta de gerenciamento de fluxo de trabalho para ciência de dados e machine learning que simplifica a construção, execução e implantação de modelos. Esta ferramenta de MLOps ajuda as equipes a gerenciar pipelines em escala enquanto lida automaticamente com rastreamento de experimentos, versionamento de dados e implantação em produção.
Principais Recursos:
Ideal Para:
Cientistas de dados e equipes de ML que buscam uma ferramenta de fluxo de trabalho simples e escalável que lide com orquestração, rastreamento e implantação, minimizando a sobrecarga de MLOps.
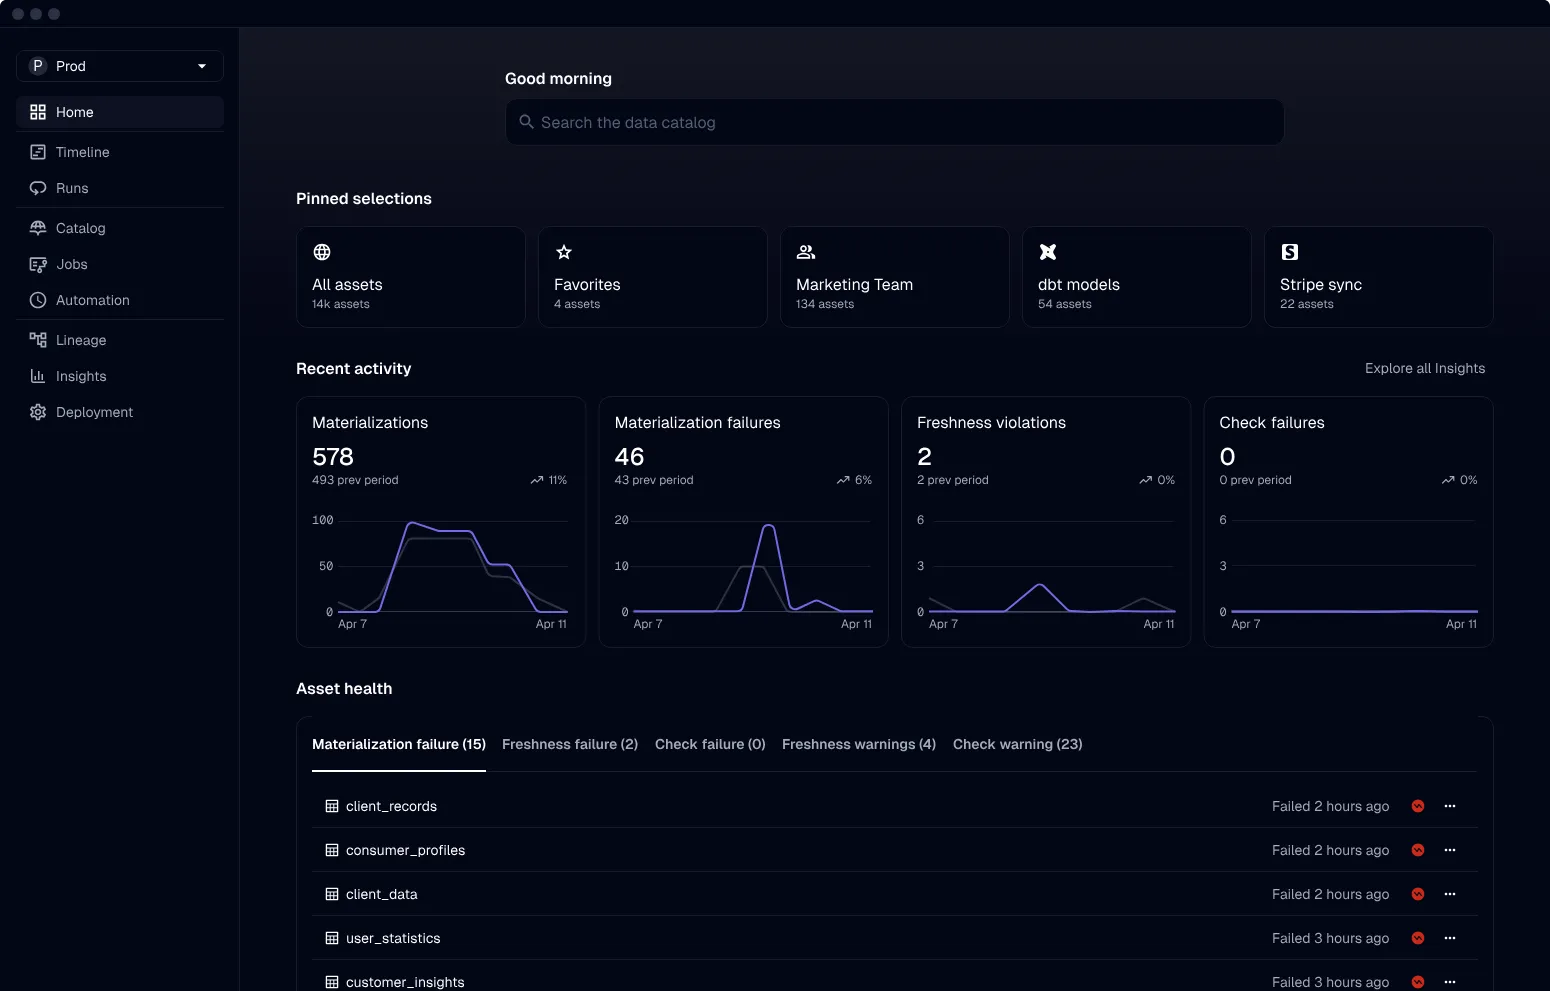
O Dagster é uma plataforma de orquestração nativa da nuvem que ajuda equipes de dados a definir, executar e monitorar pipelines de dados complexos com eficiência. Ele foca em confiabilidade, observabilidade e em uma experiência moderna de desenvolvimento para gerenciar fluxos de dados.
Key Features:
Best For:
Engenheiros de dados e equipes de dados que precisam de orquestração de pipeline de dados confiável, testável e observável, com forte suporte de integração e um fluxo de trabalho de desenvolvimento moderno.
Kedro é uma ferramenta de orquestração de fluxo de trabalho baseada em Python que ajuda a construir projetos de ciência de dados reproduzíveis, de fácil manutenção e modulares. Ela traz as melhores práticas de engenharia de software, como modularidade, separação de preocupações e versionamento, para os fluxos de trabalho de machine learning.
Key Features:
Best For:
Cientistas de dados e equipes que desejam fluxos de trabalho de ciência de dados estruturados, de fácil manutenção e reproduzíveis usando as melhores práticas de engenharia de software.
TruEra é uma plataforma focada em melhorar a qualidade de modelos de machine learning por meio de testes, explicabilidade e análise de causa raiz. Esta ferramenta de MLOps ajuda as equipes a depurar modelos, entender problemas de desempenho e garantir a justiça (fairness) ao longo de todo o ciclo de vida do ML.
Key Features:
Best For:
Engenheiros de ML, cientistas de dados e organizações que precisam de insights mais profundos sobre modelos, verificações de justiça e monitoramento confiável de desempenho ao longo do ciclo de vida do modelo.
BentoML é uma plataforma Python-first que simplifica a implantação, a disponibilização (serving) e o monitoramento de modelos de machine learning em produção. Ela ajuda as equipes a entregar aplicações de ML mais rapidamente com serving de modelos escalável e de alto desempenho.
Key Features:
Best For:
Engenheiros de ML e equipes que precisam de uma forma rápida, escalável e confiável para implantar e gerenciar modelos de machine learning em ambientes de produção.
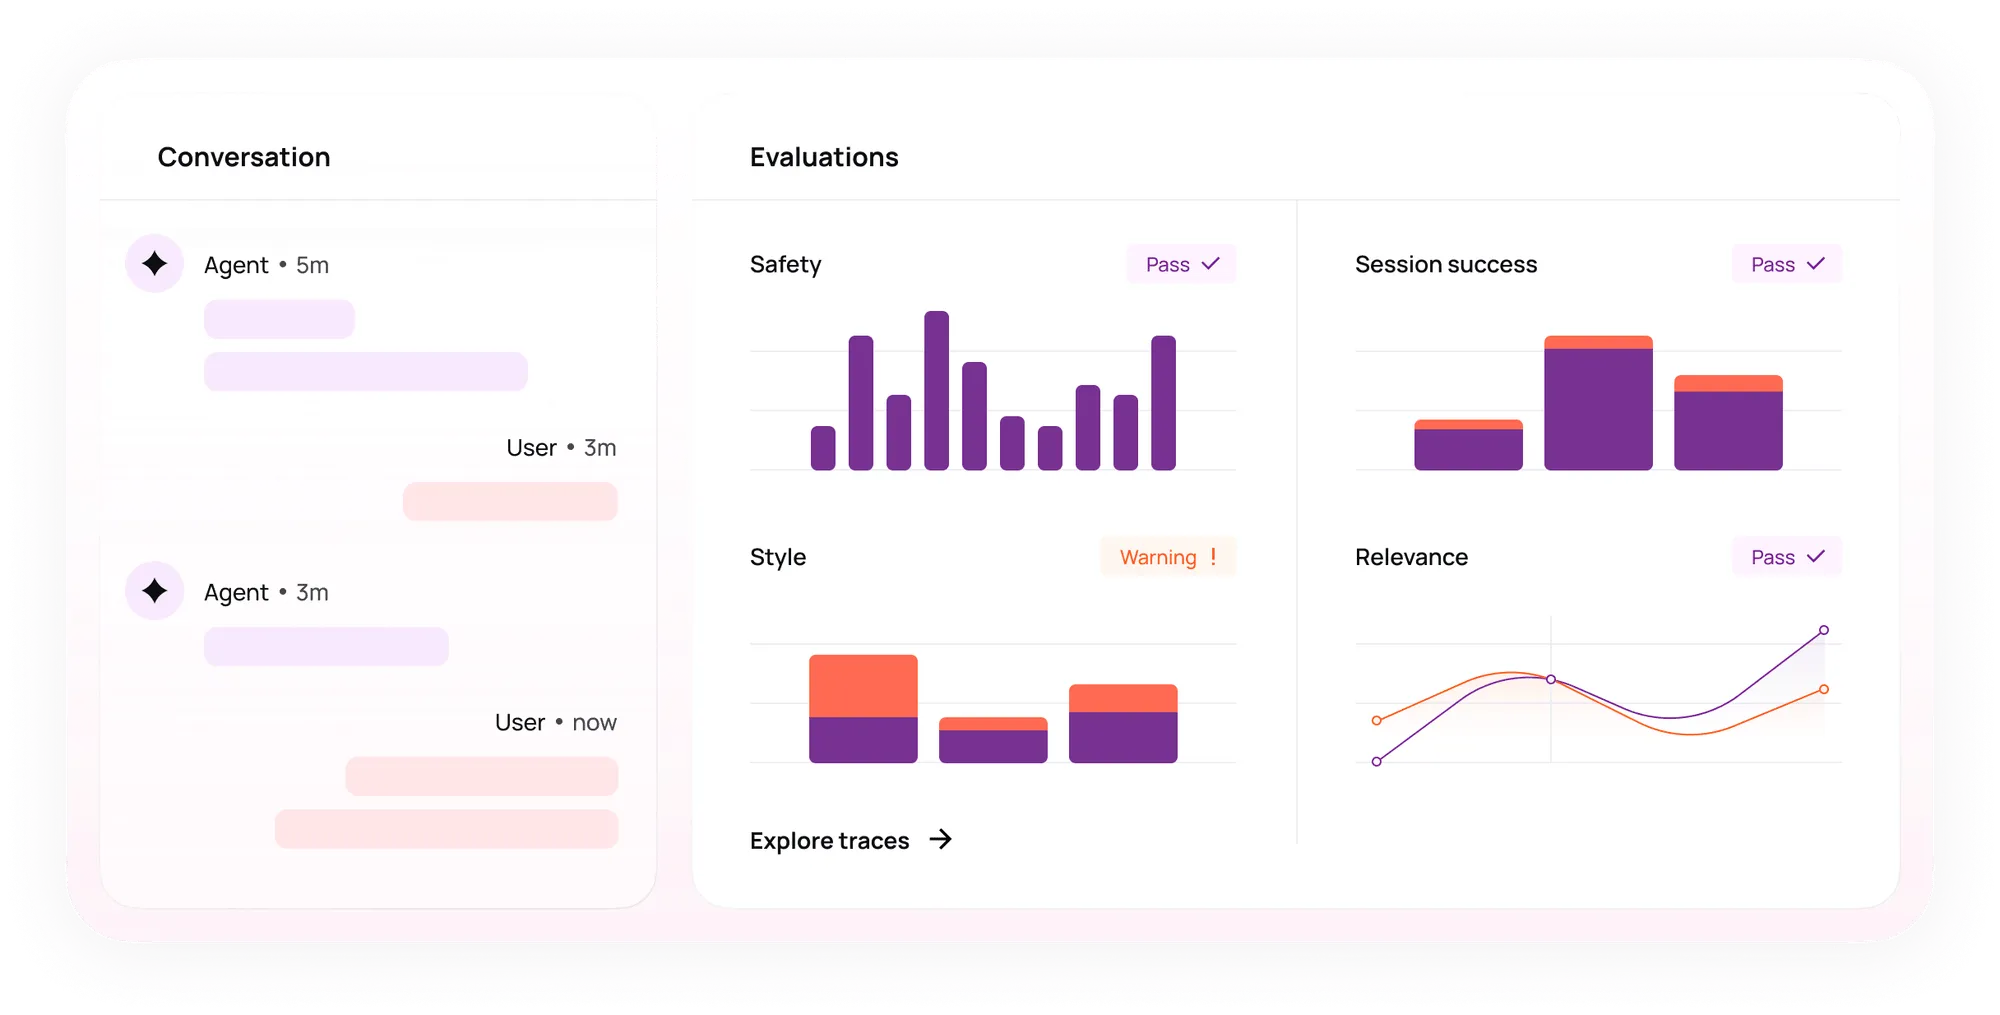
Evidently AI é uma biblioteca Python open-source para monitoramento de modelos de machine learning ao longo do desenvolvimento, validação e produção. Ela ajuda a garantir a qualidade dos dados e do modelo ao detectar drift, problemas de desempenho e outros potenciais problemas.
Key Features:
Best for:
Cientistas de dados e engenheiros de ML que precisam de monitoramento confiável de modelos, detecção de drift e rastreamento de desempenho durante todo o ciclo de vida do ML.
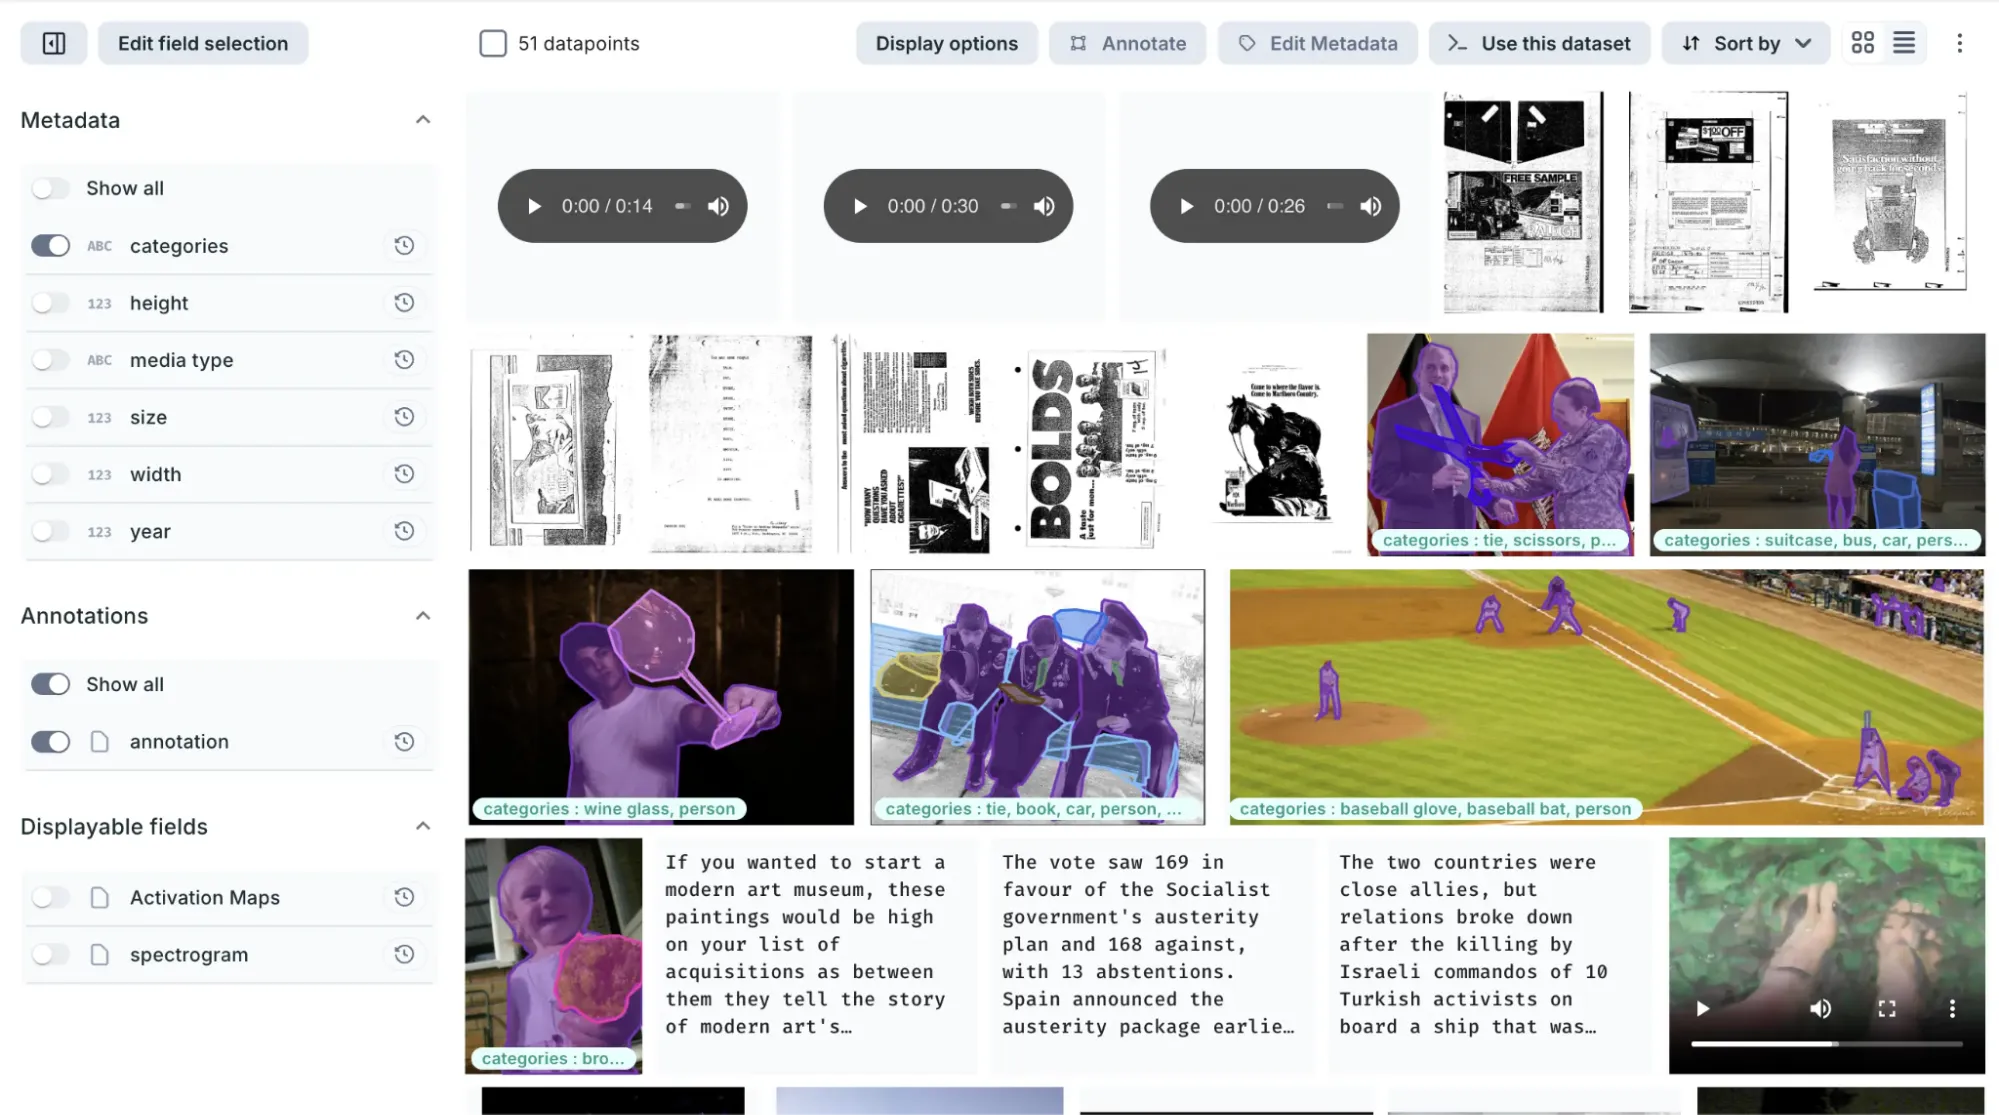
DagsHub é uma plataforma de colaboração para projetos de machine learning que ajuda equipes a rastrear, versionar e gerenciar dados, modelos, experimentos, pipelines e código em um só lugar. Frequentemente descrita como o “GitHub para machine learning”, ela fornece ferramentas para simplificar o fluxo de trabalho de ML ponta a ponta.
Key Features:
Best For:
Equipes de ML e organizações que precisam de um ambiente colaborativo e versionado para gerenciar todo o ciclo de vida do machine learning com forte suporte a integração e reproduzibilidade.
A Iguazio MLOps Platform é uma solução ponta a ponta que automatiza todo o ciclo de vida do machine learning, desde a ingestão e preparação de dados até o treinamento, implantação e monitoramento em produção. Esta ferramenta de MLOps oferece tanto um framework open-source (MLRun) quanto uma plataforma totalmente gerenciada, com implantação flexível em nuvem, ambientes híbridos ou on-premises.
Key Features:
Best For:
Empresas e indústrias regulamentadas (por exemplo, saúde, finanças) que precisam de uma plataforma de MLOps flexível, escalável e governada, com forte automação e controle de implantação.
Qdrant é um banco de dados vetorial open-source e motor de busca por similaridade que permite armazenar, gerenciar e consultar embeddings vetoriais por meio de um serviço pronto para produção e uma API simples. Ele foi projetado para busca semântica de alto desempenho e aplicações baseadas em IA.
Key Features:
Best For:
Desenvolvedores e equipes de ML que constroem sistemas de busca semântica, sistemas de recomendação e aplicações de IA que exigem busca e filtragem de vetores rápidas e escaláveis.
LakeFS é um sistema open-source de controle de versão de dados que traz operações semelhantes às do Git para o armazenamento de objetos, permitindo que as equipes gerenciem data lakes com os mesmos fluxos de trabalho usados para código. Ele possibilita um versionamento de dados escalável e confiável para ambientes de dados em larga escala.
Key Features:
Best For:
Engenheiros de dados e organizações que gerenciam grandes data lakes e precisam de controle de versão confiável, experimentação segura e fluxos de trabalho de dados reproduzíveis em escala.
Fiddler AI é uma plataforma de monitoramento e explicabilidade de modelos que ajuda equipes a entender, depurar e rastrear modelos de machine learning em produção. Ela fornece insights claros sobre o comportamento, o desempenho e a qualidade dos dados do modelo por meio de uma interface intuitiva.
Key Features:
Best For:
Engenheiros de ML, cientistas de dados e organizações que precisam de monitoramento transparente de modelos, explicabilidade e alertas proativos para manter sistemas de ML em produção confiáveis.
Ray é um framework de computação distribuída que ajuda desenvolvedores a dimensionar aplicações de IA e Python com facilidade. Ele fornece um ambiente de execução (runtime) flexível e um conjunto de bibliotecas de IA para construir, treinar e implantar sistemas de machine learning em escala.
Key Features:
Best For:
Desenvolvedores, engenheiros de ML e equipes de IA que precisam de um framework flexível e de alto desempenho para escalar treinamento, processamento de dados e serving de modelos em ambientes distribuídos.
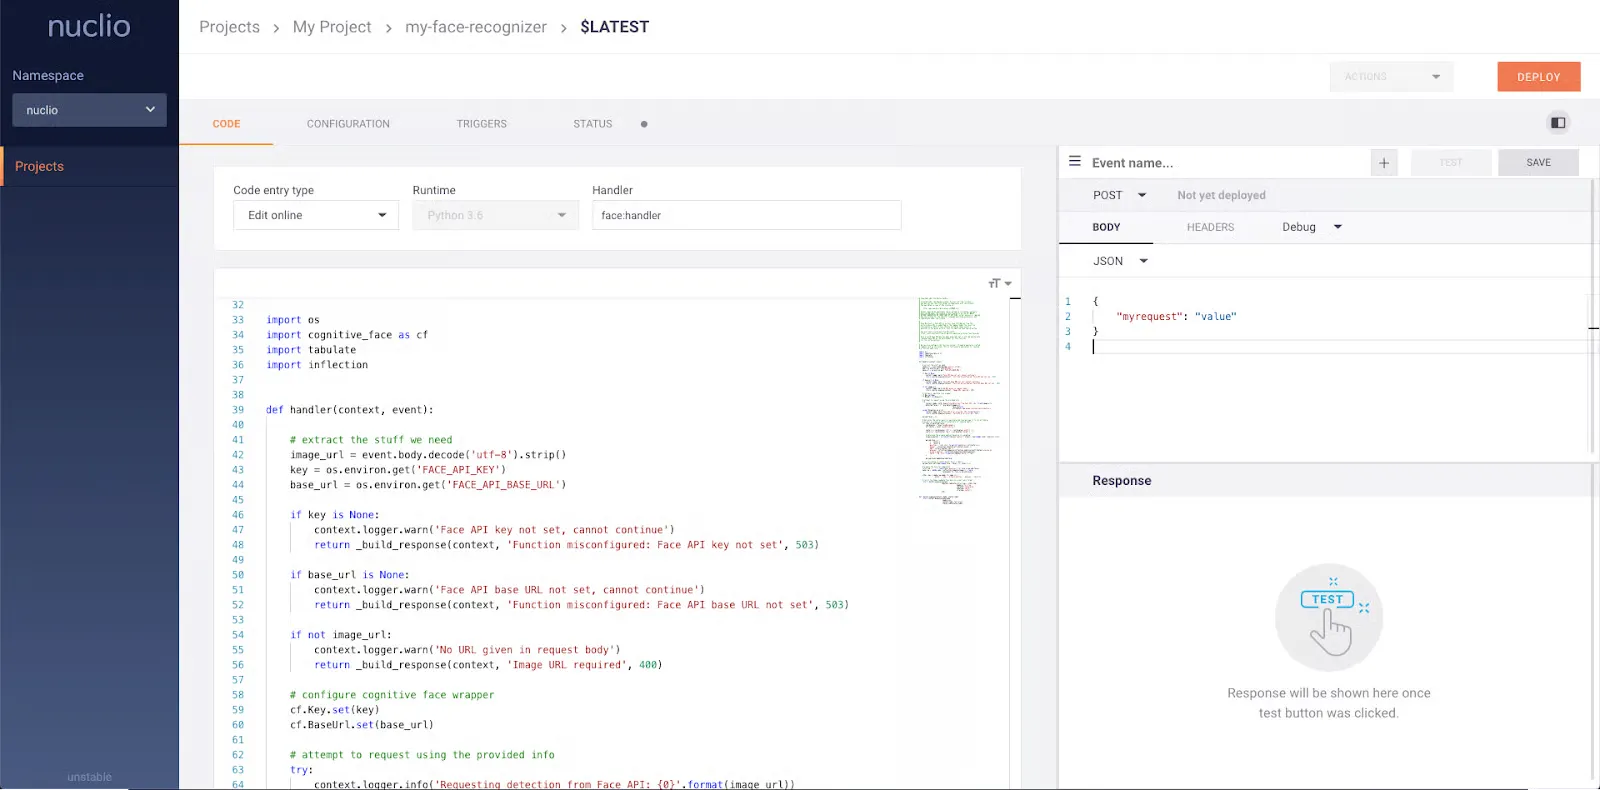
Nuclio é um framework serverless de alto desempenho projetado para workloads intensivos em dados, E/S e computação. Ele permite o processamento em tempo real sem o gerenciamento de servidores e se integra perfeitamente com ferramentas de ciência de dados e plataformas de ML.
Key Features:
Best For:
Organizações e equipes de ML que precisam de uma plataforma serverless e de alto desempenho para processamento de dados em tempo real, streaming e workloads de IA escaláveis em ambientes de nuvem e borda.
As melhores ferramentas de MLOps ajudam as organizações a gerenciar todo o ciclo de vida do machine learning de forma mais eficiente. Elas trazem automação, colaboração e confiabilidade para a construção, implantação e manutenção de sistemas de ML.
As ferramentas de MLOps automatizam tarefas repetitivas, como preparação de dados, rastreamento de experimentos e orquestração de pipelines. Isso permite que as equipes iterem mais rapidamente, reduzam erros manuais e levem modelos da ideia para a produção em menos tempo.
Essas ferramentas fornecem espaços de trabalho compartilhados, ativos versionados e documentação clara, tornando mais fácil para cientistas de dados, engenheiros e partes interessadas colaborarem, revisarem alterações e compartilharem insights entre as equipes.
Com monitoramento, testes e validação integrados, as ferramentas de MLOps ajudam a detectar problemas como data drift, viés e degradação de desempenho. Isso garante que os modelos permaneçam precisos, confiáveis e alinhados com os objetivos de negócios.
As plataformas de MLOps rastreiam versões de dados, código, modelos e experimentos, permitindo que as equipes reproduzam resultados, auditem alterações e mantenham a consistência entre ambientes.
Elas simplificam a implantação de modelos em produção por meio de automação, pipelines de CI/CD e infraestrutura escalável, permitindo que as organizações lidem com cargas de trabalho crescentes e se adaptem às demandas em constante mudança de forma eficiente.
O MLOps evoluiu de uma prática de nicho para um componente fundamental dos fluxos de trabalho modernos de machine learning. Em 2026, as organizações não estão mais se perguntando se precisam de MLOps; elas estão perguntando qual plataforma se alinha melhor com seus objetivos, infraestrutura e escala.
Como vimos, o cenário oferece desde ferramentas leves e modulares, como MLflow e DVC, até soluções corporativas totalmente gerenciadas, como Azure ML, Vertex AI e SageMaker.
Para equipes focadas em GenAI, ajuste fino (fine-tuning) e inferência em tempo real, plataformas mais recentes como a TrueFoundry oferecem recursos de ponta construídos para os desafios modernos de IA.
O MLOps não é melhor que o DevOps; ele é uma extensão do DevOps adaptada para machine learning. Enquanto o DevOps se concentra na entrega de software e na automação de infraestrutura, o MLOps adiciona recursos para gerenciamento de dados, rastreamento de experimentos, monitoramento de modelos e reproduzibilidade, lidando com os desafios únicos de construir, implantar e manter sistemas de ML em produção.
As melhores ferramentas de MLOps para empresas são aquelas que equilibram a velocidade do desenvolvedor com uma rigorosa governança de infraestrutura. Embora os grandes provedores de nuvem ofereçam serviços amplos, a TrueFoundry costuma ser a escolha ideal para equipes que exigem soberania de dados e flexibilidade multicloud. Ela fornece um plano de controle unificado que roda nativamente dentro da sua VPC privada, permitindo automatizar todo o ciclo de vida, do treinamento à implantação, sem comprometer a segurança ou o controle da infraestrutura.
O Docker é uma tecnologia fundamental para conteinerização, tornando-se uma peça crítica da stack de ferramentas de MLOps. Ele garante que os modelos funcionem de forma consistente nos ambientes de desenvolvimento e produção, embora não gerencie tarefas de nível superior, como monitoramento ou versionamento de modelos. A TrueFoundry simplifica o processo de conteinerização ao construir automaticamente imagens Docker e orquestrá-las no Kubernetes, permitindo que os cientistas de dados implantem código sem precisarem se tornar especialistas em DevOps.
A TrueFoundry funciona como uma camada de abstração centrada no desenvolvedor que se posiciona sobre a sua infraestrutura de nuvem existente. Ela se conecta diretamente aos seus clusters Kubernetes e automatiza tarefas complexas como provisionamento de recursos, CI/CD e serving de modelos. Ao fornecer uma interface única para gerenciar experimentos e workloads de produção, ela reduz os tempos de implantação de semanas para minutos, reduzindo custos por meio do suporte a instâncias spot e otimização automatizada de GPUs.
Nenhuma nuvem isolada é a melhor para MLOps; a escolha certa depende de suas necessidades, ferramentas e orçamento. AWS, Azure e Google Cloud oferecem excelentes serviços de MLOps, incluindo pipelines automatizados, treinamento escalável e monitoramento de modelos. As equipes geralmente escolhem com base na infraestrutura existente, nos requisitos de conformidade e na integração com seu ecossistema de dados.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada