



novembro 20, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: novembro 20, 2026

Blazingly fast way to build, track and deploy your models!
O Model Context Protocol avançou mais rápido em 2026 do que a maioria das equipes conseguiu acompanhar. A especificação de 28/07/2026 — a primeira grande revisão após o lançamento de novembro de 2025 — não adicionou apenas uma funcionalidade; ela reestruturou a base do protocolo. Autorização, transporte, roteamento e interação mudaram, e vários blocos de construção amplamente utilizados foram descontinuados com um prazo fixo para remoção.
Se você tem um punhado de servidores MCP conectados diretamente a um único agente, pode ler o changelog e migrar no seu próprio ritmo. Se você executa o MCP em muitas equipes, diversos servidores e múltiplos agentes, essas mudanças não são apenas uma entrada de changelog — são um projeto de migração, e as alterações que afetam transporte e roteamento atingirão todos os clientes que você opera. Este artigo detalha o que realmente mudou, por que cada mudança foi feita e o que isso significa para quem opera o MCP em escala. Para os conceitos fundamentais, nosso guia explicativo sobre o que é um gateway MCP é o ponto de partida ideal; este artigo pressupõe que você já conhece a estrutura do protocolo e foca no que a nova revisão altera e corrige.
Quer que o novo transporte, autenticação e roteamento do MCP sejam gerenciados em um único ponto de controle em vez de em cada cliente? Agende uma demonstração.
Cinco mudanças carregam quase todo o impacto operacional. Tudo o mais nesta versão deriva delas.
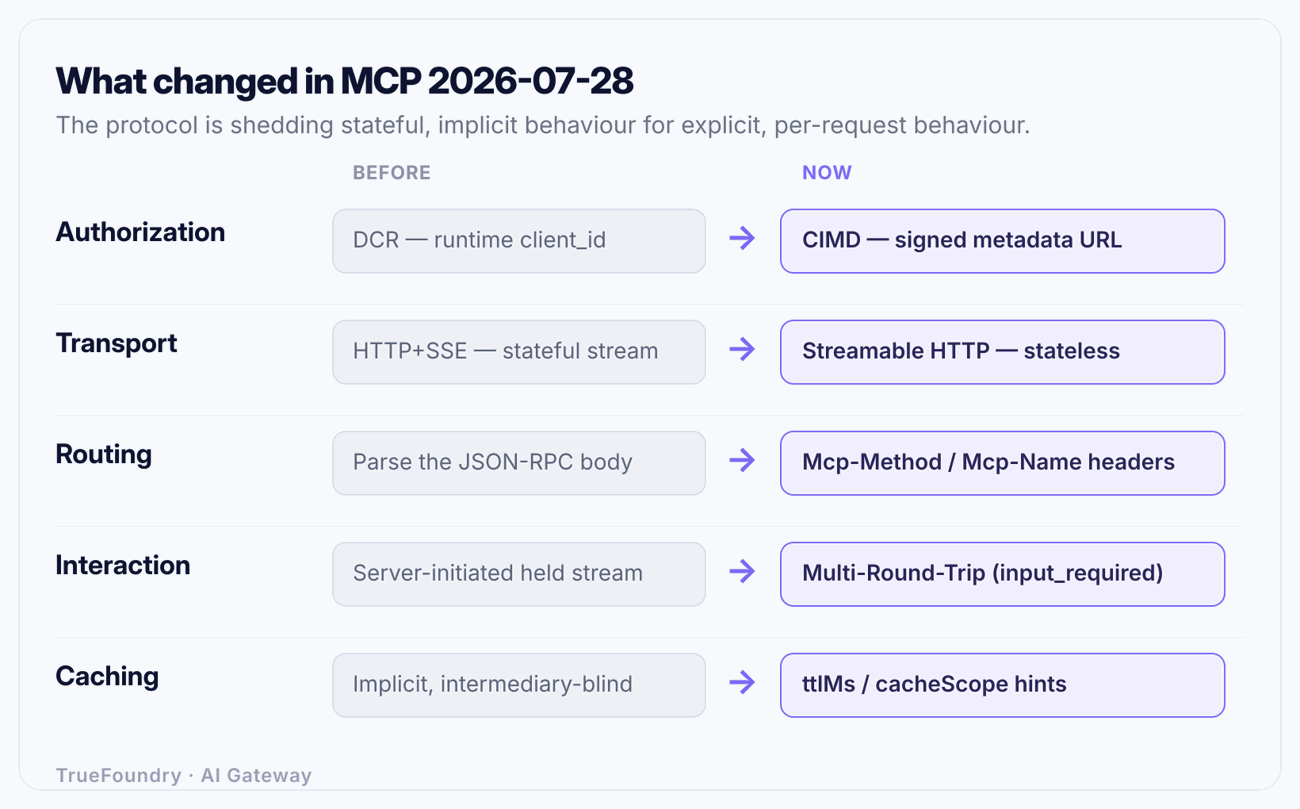
O padrão é consistente: o protocolo está abandonando comportamentos implícitos, mantidos por conexões contínuas e com estado (stateful), e substituindo-os por comportamentos explícitos, por requisição e visíveis nos cabeçalhos. Essa mudança é o que torna a nova revisão mais amigável para gateways, proxies e limitadores de taxa — e mais exigente para clientes que presumiam uma sessão de longa duração.
O Dynamic Client Registration permitia que um cliente se registrasse com um servidor de autorização em tempo de execução, gerando um client_id. Era conveniente, mas gerava um problema: cada cliente que se conectava recebia um registro, o que resultava em uma população ilimitada e difícil de governar de identidades, além de um endpoint de registro que se tornava um alvo permanente.
A revisão de 28/07/2026 descontinua o DCR em favor dos Client ID Metadata Documents (CIMD). Em vez de se registrar para obter um identificador, o cliente é identificado por uma URL que resolve para um documento de metadados assinado que o descreve. O servidor de autorização busca e valida esse documento em vez de armazenar um registro. A identidade do cliente agora é algo que o servidor pode verificar sob demanda, a partir de uma fonte controlada pelo cliente, em vez de uma linha no banco de dados que o servidor precisa provisionar e manter.
Três mudanças de segurança correlacionadas acompanham essa atualização:
iss e os clientes devem validá-lo antes de resgatar um código de autorização, fechando uma brecha antiga de troca indevida de servidores de autorização (authorization-server mix-up).application_type para que os servidores parem de rejeitar redirecionamentos localhost para ferramentas legítimas de desktop e CLI.Há um ponto de atenção importante: buscar uma URL controlada pelo cliente no lado do servidor é, por definição, uma requisição server-side para um endereço que pode ser influenciado por um atacante. O CIMD troca um endpoint de registro por uma consideração de SSRF, e qualquer pessoa que o implemente precisa tratar essa busca de metadados com o mesmo cuidado dedicado a qualquer outra requisição de saída de dentro do limite de confiança. Nossa análise detalhada desses modos de falha está em riscos de segurança e melhores práticas no MCP, e a mecânica da autenticação agente-servidor é coberta em autenticação no MCP explicada.
A conclusão prática: não crie novas integrações baseadas em DCR. Ele foi descontinuado, será removido e a solução substituta oferece uma governança superior. Se você já depende dele, tem prazo até pelo menos julho de 2027 — mas a migração é uma questão de quando, e não de se.
O antigo transporte HTTP+SSE foi oficialmente descontinuado com uma janela de migração de um ano. Seu substituto, o Streamable HTTP, é stateless por design, e essa palavra traz grandes consequências.
Sob o novo transporte, não há handshake initialize / initialized nem Mcp-Session-Id. Cada requisição é autodescritiva: a versão do protocolo, a identidade do cliente e suas capacidades trafegam em um bloco _meta por requisição, e uma chamada opcional server/discover permite que um servidor anuncie suas capacidades com antecedência. Como cada requisição é independente, qualquer instância do servidor pode atender a qualquer requisição, permitindo que os servidores fiquem atrás de um balanceador de carga comum em round-robin e escalem horizontalmente sem sessões pegajosas (sticky sessions).
O custo da arquitetura stateless é que requisições perdidas em trânsito não são retomadas. Não há uma conexão contínua para reconectar. Um cliente que perde uma requisição precisa reenviá-la com um novo ID, o que significa que ferramentas de longa execução devem ser idempotentes ou devolver um identificador durável para o cliente consultar (poll). O estado entre chamadas não desaparece — ele apenas precisa ser tornado explícito, normalmente como um identificador gerado pelo servidor, passado como argumento da ferramenta e sustentado por armazenamento compartilhado com tempo de expiração. Remover sessões no nível do protocolo não torna sua aplicação stateless; apenas transfere a responsabilidade do gerenciamento de estado do transporte para você.
Esta é a mudança com maior probabilidade de impactar todos os clientes que você executa, pois altera o próprio meio de transmissão. Se cada um dos seus agentes abre suas próprias conexões MCP, todos precisarão adotar o novo transporte. Se eles utilizam um gateway, o gateway encerra o transporte em um único ponto e seus agentes continuam se comunicando com um endpoint estável — o que é a justificativa central para não permitir que agentes acessem servidores diretamente, tópico abordado em nosso artigo sobre hospedagem de servidores MCP remotos.
A mudança com maior impacto para qualquer pessoa que opera infraestrutura é a mais discreta no changelog. O Streamable HTTP agora exige Mcp-Methodem cada requisição e Mcp-Nameemtools/call,resources/readeprompts/get. Um parâmetro de ferramenta pode, adicionalmente, ser marcado com x-mcp-header, e os clientes em conformidade espelham esse argumento em um cabeçalho Mcp-Param-{Name} — o exemplo canônico sendo um parâmetro region promovido a um cabeçalho de roteamento.
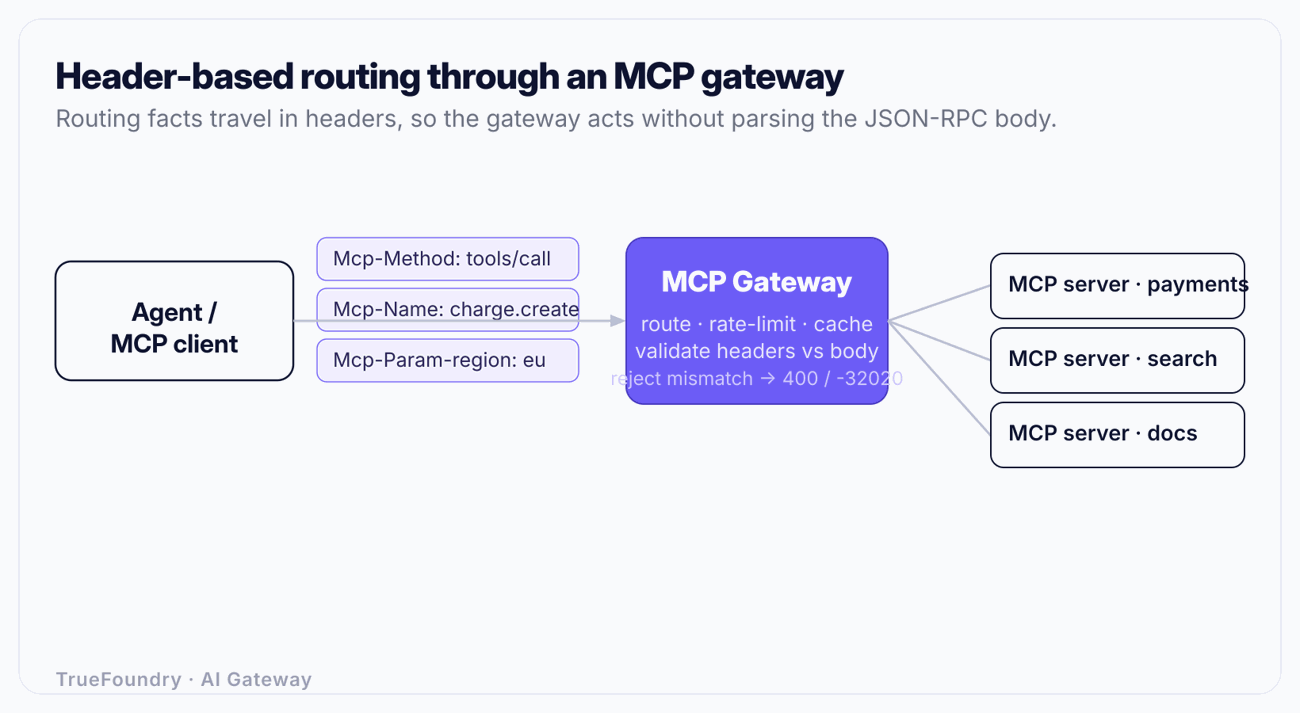
Antes disso, um intermediário que quisesse rotear ou aplicar rate-limit por ferramenta precisava abrir e analisar o corpo JSON-RPC de cada requisição. Agora, os fatos relevantes para o roteamento estão nos cabeçalhos, onde um gateway, um balanceador de carga ou um WAF pode lê-los de forma leve e agir sobre eles sem precisar entender o payload. Você pode enviar tools/call para uma ferramenta custosa para um pool dedicado, aplicar rate-limit em uma ferramenta específica pelo nome, ou rotear o tráfego de um tenant por um cabeçalho region — tudo no edge.
Existe uma regra que não pode ser ignorada: cabeçalhos e corpo devem concordar. Um servidor que processa o corpo deve verificar se os cabeçalhos correspondem a ele e rejeitar divergências com um 400 e código de erro -32020. Qualquer intermediário que reescreva um corpo deve reescrever os cabeçalhos também, ou nenhum dos dois — e um gateway só deve confiar em um cabeçalho após validá-lo contra o corpo. O roteamento baseado em cabeçalhos é poderoso precisamente porque é confiado logo no início do caminho da requisição, e é exatamente por isso que ele precisa ser validado ali.
Veja como o TrueFoundry MCP Gateway absorve as mudanças da especificação para que seus agentes nunca precisem se preocupar. Agende uma demonstração.
Anteriormente, um servidor que precisasse de entrada no meio da chamada — uma elicitação, uma requisição de sampling, uma listagem de roots — fazia isso por meio de uma stream mantida aberta. Em um mundo stateless não existe stream mantida aberta, então a revisão 2026-07-28 substitui essas chamadas iniciadas pelo servidor por Multi-Round-Trip Requests (MRTR). O servidor retorna um resultado do tipo input_required descrevendo o que precisa; o cliente responde tentando novamente a chamada original com as respostas em inputResponses e um blob requestState que permite ao servidor retomar.
Como a nova tentativa pode cair em uma instância de servidor diferente, o caminho de retomada precisa ser testado dessa forma, e quaisquer efeitos colaterais realizados antes da coleta da entrada precisam de reconciliação — o MCP não oferece garantia de exatamente-uma-vez. Separadamente, Roots, Sampling e Logging foram descontinuados (funcionais por pelo menos doze meses, remoção não antes de julho de 2027), Tasks foram movidas para uma extensão com um modelo baseado em polling, e respostas de list/read agora carregamttlMsecacheScopehints para que intermediários possam fazer cache com segurança. Essa dica de cache esconde uma armadilha, abordada abaixo.
O lançamento também formaliza um framework de extensões, e a que mais deve importar para as equipes de produto é a MCP Apps (io.modelcontextprotocol/ui) — superfícies de UI interativas renderizadas por hosts compatíveis. Até agora, um servidor MCP retornava texto e dados estruturados; com o MCP Apps ele pode retornar uma superfície interativa que um host compatível renderiza inline, transformando uma chamada de ferramenta em algo mais próximo de uma mini-aplicação embutida.
Essa é uma capacidade genuinamente nova e uma superfície de governança genuinamente nova. Um servidor que pode fornecer UI pode fornecer uma UI que solicita credenciais, que estrutura uma confirmação de forma enganosa ou que renderiza conteúdo que o host não antecipou — portanto, o mesmo escrutínio que você aplica às ferramentas de um servidor agora precisa se estender a tudo o que ele pode renderizar. MCP Apps é uma extensão, sua maturidade é acompanhada separadamente da especificação principal e o suporte dos hosts é irregular, portanto, trate-o como algo emergente em vez de consolidado. O ponto para uma equipe de plataforma é mais simples: a superfície de ataque e políticas de "um servidor MCP" acabou de crescer, e quaisquer revisões e allowlists que você aplica a ferramentas devem estar prontas para serem aplicadas a apps.
Lidas em conjunto, as mudanças de 2026-07-28 apontam em uma única direção: o protocolo está se tornando algo que um intermediário pode governar de forma limpa. Requisições stateless, fatos de roteamento visíveis nos headers, hints explícitos de cache e identidade de client verificável são todos mais fáceis de aplicar em um ponto de controle do que eram há um ano. Esse é o argumento para colocar um gateway entre seus agentes e seus servidores MCP, em vez de conectá-los diretamente.
Um gateway é onde o novo transporte é encerrado uma única vez, onde a autenticação baseada em CIMD é validada uma única vez, onde o roteamento de Mcp-Name e os rate limits por ferramenta são aplicados, e onde o registro de quais servidores existem e quem pode alcançá-los realmente reside. Quando a especificação for revisada novamente — e ela será —, os clients apontados para o gateway não mudam; o gateway muda. O MCP gateway da TrueFoundry é construído exatamente em torno desse ponto de controle, e o modelo de governança é detalhado na governança de MCP enterprise e na documentação do produto.

Se você está avaliando um MCP gateway central em comparação com permitir que cada equipe gerencie seus próprios servidores, os prós e contras estão expostos em nossa comparação dos melhores MCP gateways, e a questão protocolo-vs-protocolo de onde o MCP termina e onde a mensageria agente-para-agente começa é abordada em MCP vs A2A.
Elas adotam primitivas descontinuadas em novos códigos. DCR, Roots, Sampling e Logging ainda funcionam, portanto parecem seguros para construir em cima. No entanto, eles estão com os dias contados para remoção. Novas integrações devem tratá-los como proibidos.
Elas confiam em headers que nunca validaram. O roteamento baseado em headers só funciona porque os headers são lidos antes do body. Um gateway que roteia no Mcp-Name sem checá-lo contra o body — e sem rejeitar divergências com 400 / -32020 — construiu um bypass de roteamento, não uma camada de roteamento.
Elas marcam dados de tenant como cacheáveis compublic. O novo hint cacheScope é útil e perigoso. Um resultado específico de principal ou tenant marcado como public pode ser servido por um intermediário para o contexto de autorização errado. Respostas com escopo de tenant nunca devem ser public.
Elas assumem que stateless significa ausência de estado. O estado apenas subiu na pilha, ele não desapareceu. Se uma ferramenta tinha estado entre chamadas, esse estado agora precisa de um handle explícito e armazenamento durável — ou ele quebrará silenciosamente quando uma nova tentativa cair em uma instância diferente.
Elas migram por client em vez de na borda. Fazer o rollout do novo transporte para cada agente, SDK e script manualmente é o caminho lento e propenso a erros. Encerrá-lo uma única vez em um gateway é o caminho rápido.
A ordem que minimiza interrupções é aproximadamente: estancar o sangramento nas depreciações, mover o transporte (wire) e, em seguida, explorar o novo roteamento.
A especificação de 2026-07-28 não é um pacote de funcionalidades; é uma reestruturação da infraestrutura. O DCR dá lugar ao CIMD, o HTTP+SSE dá lugar a um Streamable HTTP stateless, o roteamento se move para os headers, a elicitação se torna multi-round-trip e os servidores ganham a capacidade de entregar UI. Cada mudança faz sentido por si só, e juntas elas empurram o MCP em direção a algo que um intermediário pode governar de forma limpa — desde que alguém esteja operando esse intermediário.
Essa é a conclusão discreta de todo o lançamento. A especificação está convergindo para um mundo onde um ponto de controle na frente dos seus servidores MCP não é um capricho opcional, mas o local natural para as políticas de transporte, auth, roteamento e caching residirem. Coloque esse ponto de controle em funcionamento uma única vez, e a próxima revisão será apenas uma alteração de configuração em vez de uma migração em toda a frota.
Coloque um ponto de controle na frente dos seus servidores MCP antes que a próxima revisão da especificação chegue. Agende uma demonstração.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada


