



novembro 19, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.




Blazingly fast way to build, track and deploy your models!
À medida que os grandes modelos de linguagem (LLMs) se tornam centrais para as aplicações modernas de AI, garantir sua confiabilidade, desempenho e segurança em produção é mais crítico do que nunca. A observabilidade de LLM refere-se à capacidade de monitorar, rastrear e depurar o comportamento dos LLMs, acompanhando prompts, latência, uso de tokens, sessões de usuário e padrões de falha. Sem uma observabilidade robusta, as equipes arriscam alucinações, estouros de orçamento e falhas silenciosas. Neste artigo, vamos entender como funciona a observabilidade de LLM, as melhores ferramentas de observabilidade de LLM e muito mais.
A Observabilidade de LLM refere-se à prática de monitorar, analisar e compreender o comportamento e o desempenho dos Grandes Modelos de Linguagem (LLMs) em aplicações do mundo real. Conforme os LLMs são integrados a sistemas de produção como chatbots, agentes de AI e mecanismos de busca, a observabilidade torna-se crucial para garantir confiabilidade, segurança e confiança.
Ela vai além do logging básico ou de métricas simples. A observabilidade de LLM foca no rastreamento de entradas, saídas, cadeias de prompts, latência, uso de tokens, versionamento de modelos e casos de falha. Ela permite que desenvolvedores e equipes de ML detectem alucinações, viés, respostas tóxicas, ataques de prompt injection ou comportamentos inesperados. Também ajuda a identificar quando as saídas do modelo se desviam das normas esperadas, o que é crítico para manter a consistência e a conformidade, especialmente em indústrias regulamentadas.
Com a observabilidade, as equipes podem realizar depuração em tempo real, rastrear a causa raiz de falhas, monitorar interações de usuários e melhorar continuamente prompts ou modelos ajustados (fine-tuned). Ferramentas como TrueFoundry, LangSmith, Arize, WhyLabs e PromptLayer estão surgindo para trazer um monitoramento no estilo DevOps para sistemas de LLM.
A observabilidade de LLM atua como os "olhos e ouvidos" do seu stack de GenAI. Ela permite o dimensionamento seguro de aplicações de AI ao fornecer visibilidade e responsabilidade, ajudando a fechar a lacuna entre a experimentação e a implantação confiável em produção.
Para um mergulho profundo nos conceitos básicos da observabilidade de LLM, leia nosso guia detalhado: O que é Observabilidade de LLM?
A Observabilidade de LLM funciona capturando telemetria detalhada em cada estágio do ciclo de vida do LLM. Desde o envio do prompt até a saída final, ela oferece visibilidade sobre como o sistema se comporta em condições reais. Isso geralmente envolve três componentes principais: rastreamento de prompts, coleta de métricas e monitoramento de comportamento.
Rastreamento no Nível de Prompt (Prompt-Level Tracing): Cada interação com o LLM é registrada com metadados ricos, incluindo o prompt bruto, contexto do usuário, versão do modelo, carimbo de data/hora (timestamp) e resposta do sistema. Ferramentas avançadas rastreiam fluxos de trabalho de várias etapas ou cadeias de agentes, vinculando operações upstream e downstream usando correlation IDs. Isso permite que as equipes depurem problemas como alucinações, perda de contexto ou gargalos de desempenho rastreando toda a jornada de inferência.
Métricas de Desempenho e Tokens: As plataformas de observabilidade rastreiam latência, uso de tokens (entrada/saída), throughput e taxas de falha em tempo real. Essas métricas ajudam a identificar lentidões, uso excessivo de tokens ou comportamentos anômalos. O rastreamento no nível de token é crítico para gerenciar custos em APIs como a OpenAI, onde o preço está atrelado ao consumo de tokens.
Qualidade, Guardrails e Detecção de Anomalias: Muitas ferramentas monitoram as saídas em busca de riscos de qualidade, como viés, toxicidade ou alucinação, usando modelos estatísticos ou regras. Elas também detectam violações de políticas de moderação ou limites de segurança e geram alertas. Algumas plataformas integram análise de drift de embeddings para monitorar mudanças no comportamento semântico ao longo do tempo.
Esses sinais de observabilidade são normalmente visualizados em painéis (dashboards) e podem disparar alertas, integrar-se a sistemas de logging ou alimentar pipelines de CI/CD. Ao fornecer transparência, suporte à depuração e insights de custo, as ferramentas de observabilidade de LLM garantem operações de GenAI seguras, eficientes e escaláveis.
Aqui está uma visão geral rápida das diferentes plataformas de observabilidade de LLM:
Escolher a ferramenta de observabilidade correta é essencial para escalar aplicações de LLM com confiança. Do rastreamento de prompts ao monitoramento de latência, as plataformas atuais oferecem insights profundos em cada estágio da inferência do modelo. Nesta seção, destacamos as principais ferramentas que se destacam em confiabilidade, governança e experiência do desenvolvedor. Quer você esteja executando na nuvem ou on-premise, essas soluções ajudam a tornar os LLMs prontos para produção.

Rastreamento de Prompts e Saídas de Ponta a Ponta: A TrueFoundry captura cada estágio de uma interação de LLM, desde a geração do prompt e inferência do modelo até o pós-processamento — criando um trace completo com correlation IDs e spans OpenTelemetry. Esse rastreamento granular permite que os desenvolvedores identifiquem exatamente onde ocorrem picos de latência ou erros, seja no tratamento do prompt, na resposta do modelo ou em processos downstream. Os traces são visualizados na UI para facilitar a depuração e armazenados para auditoria de conformidade, oferecendo transparência em cada ponto de decisão em fluxos de trabalho de várias etapas.

Análise em Tempo Real: Dashboards nativos fornecem insights ao vivo sobre latência do modelo, throughput de tokens, taxas de erro, estouros de limite de requisições (rate limits) e eventos de fallback. Análises agregadas, como heatmaps de latência e detalhamento de uso, são atualizadas em tempo real, permitindo que as equipes identifiquem rapidamente problemas antes que eles afetem os usuários. A TrueFoundry suporta alertas configuráveis para limites como picos de latência ou drift incomum do modelo, garantindo uma resposta proativa e minimizando o tempo de inatividade.

Metadados Detalhados e Atribuição de Custos: Cada invocação é enriquecida com metadados como modelo, usuário, equipe, ambiente ou tags personalizadas, e inclui detalhes de uso de tokens e custos. Isso permite um rastreamento preciso de gastos e tendências de uso entre departamentos ou recursos. As equipes podem filtrar dashboards e exportar relatórios para transparência de faturamento e análise de ROI, capacitando as equipes de engenharia, finanças e produto com visibilidade total sobre quem usa o quê, quando e a qual custo.

O Langfuse é uma plataforma de observabilidade open-source construída especificamente para aplicações de LLM. Ele fornece rastreamento completo de prompt-resposta, incluindo metadados de entrada, saídas do modelo, latência e uso de tokens. O Langfuse se integra perfeitamente com LangChain, APIs compatíveis com OpenAI e outros stacks de LLM, tornando-o ideal para desenvolvedores que constroem fluxos de trabalho de várias etapas ou baseados em agentes. Ele suporta o rastreamento em cadeias, permitindo a visualização de chamadas aninhadas, uso de ferramentas e caminhos de raciocínio em tempo real.
A plataforma registra telemetria detalhada para cada sessão de usuário, que pode ser filtrada por projeto, usuário ou modelo. O Langfuse também oferece suporte ao versionamento de prompts e ao acompanhamento de alterações ao longo do tempo, facilitando a depuração de regressões ou a iteração na engenharia de prompts. As equipes podem auto-hospedar o Langfuse ou usar a versão em nuvem gerenciada, e os dados de observabilidade podem ser exportados para análises externas ou relatórios de conformidade. Sua UI intuitiva e controle detalhado sobre os logs fazem do Langfuse uma escolha amigável para desenvolvedores em equipes que priorizam transparência e depuração em fluxos de trabalho de LLM.
Equipes que avaliam a profundidade da observabilidade e os recursos no nível de gateway geralmente exploram comparações como langfuse vs portkey para entender as diferenças no rastreamento, roteamento e atribuição de custos antes de escolher uma solução pronta para produção.
O Confident AI é uma plataforma de observabilidade de AI para equipes que monitoram, avaliam e melhoram aplicações de LLM em produção. Ele fornece rastreamento completo em chamadas de LLM, uso de ferramentas, etapas de agentes e fluxos de trabalho multiagente, tornando mais fácil depurar falhas e entender como os sistemas de AI se comportam com tráfego real.
Seu principal diferencial é a observabilidade guiada por avaliações (eval-driven observability). Além de latência, custo e erros, o Confident AI executa avaliações online diretamente em traces de produção para monitorar alucinações, fidelidade, relevância de respostas e outros padrões de falha — detectando problemas em tempo real e identificando quais prompts, agentes ou ferramentas estão causando a degradação do desempenho. O Confident AI também fecha o ciclo entre o monitoramento e os testes pré-lançamento: os traces de produção podem ser selecionados em conjuntos de dados de avaliação, enfileirados para anotação humana e reutilizados para testes de regressão e melhoria de prompts.
Ideal para equipes que desejam observabilidade e avaliação em um único fluxo de trabalho. Equipes empresariais também contam com controles de governança, permitindo que as equipes de plataforma apliquem padrões de qualidade em todos os produtos.
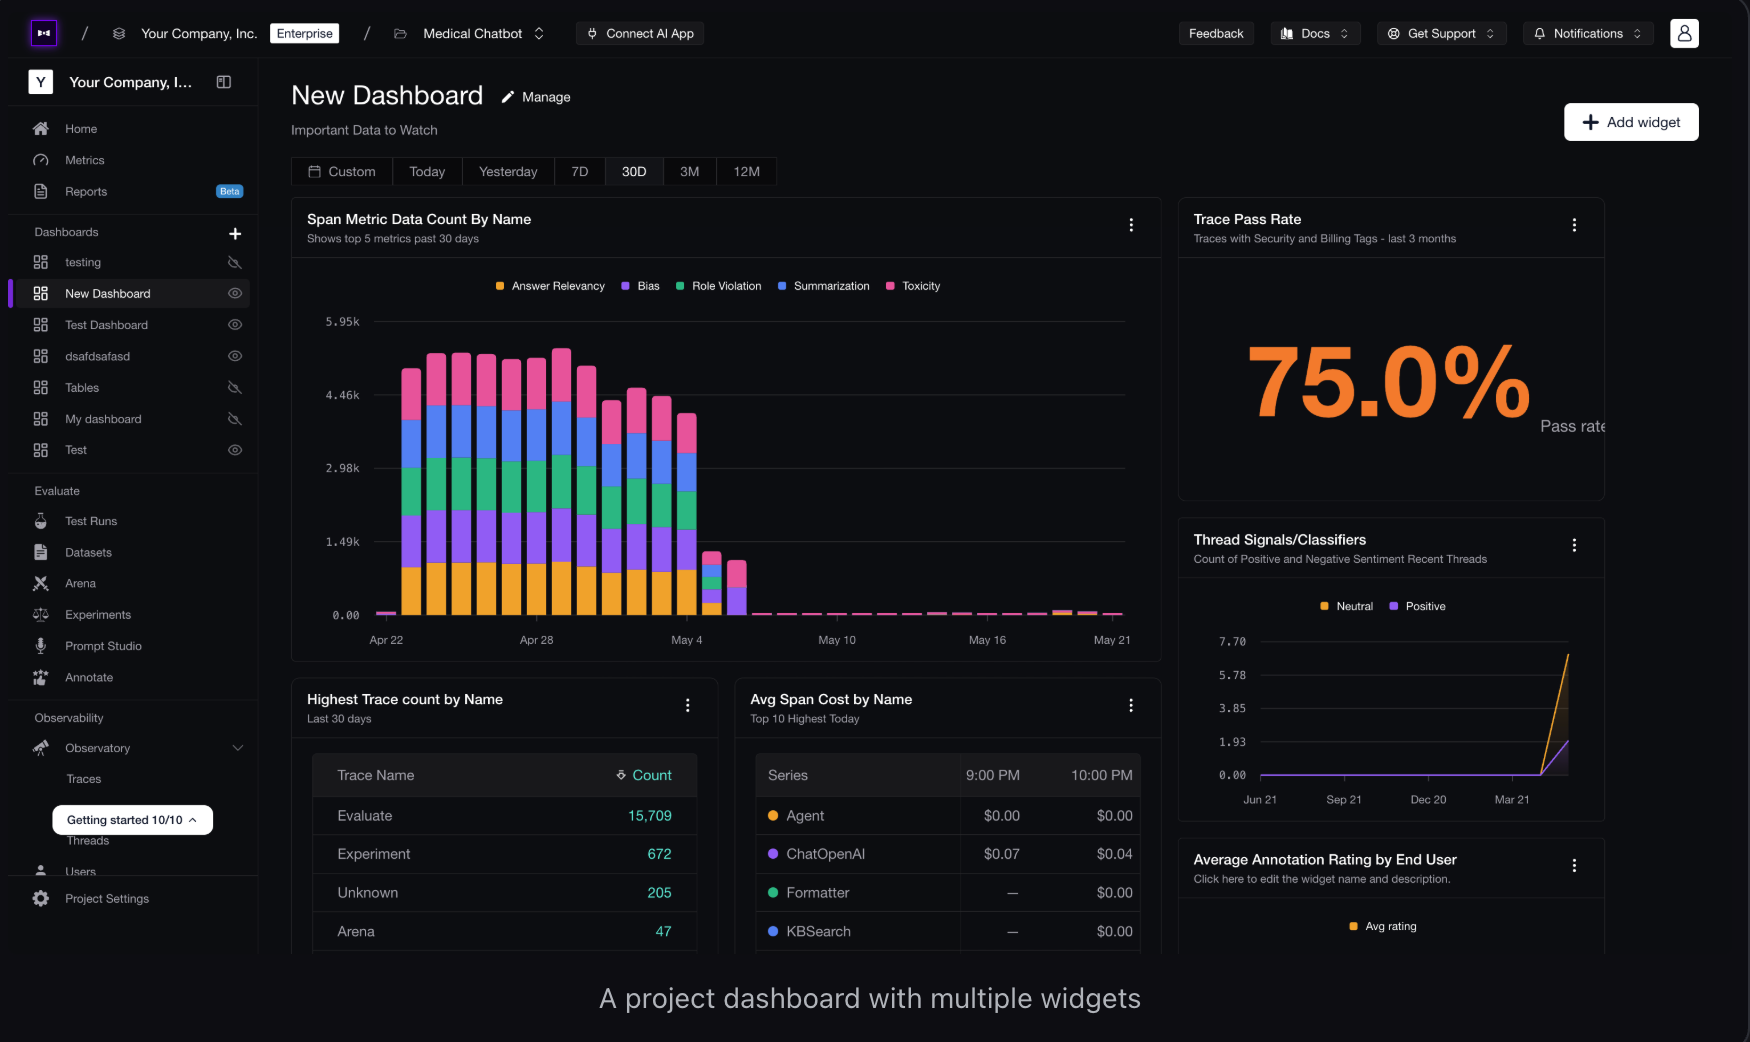

O Helicone é uma camada leve de observabilidade desenvolvida especialmente para APIs compatíveis com a OpenAI. Ele atua como um proxy que registra e monitora cada requisição de API de LLM, capturando dados detalhados como conteúdo de prompts, uso de tokens, latência, tempo de resposta e códigos de erro. Projetado para oferecer simplicidade, o Helicone requer configuração mínima; os desenvolvedores podem integrá-lo apenas alterando o endpoint da API.
O que torna o Helicone atraente é o seu foco na visibilidade de custos e em insights no nível de equipe. Ele rastreia o uso em diferentes ambientes, suporta chaves de API virtuais e permite que as equipes detalhem os custos por usuário, modelo ou rota. O dashboard web oferece visibilidade em tempo real sobre logs no nível de prompt, volume de requisições e tendências de desempenho, ajudando as equipes a identificar problemas e gerenciar orçamentos.
O Helicone suporta alertas para picos de uso ou falhas e se integra a ferramentas externas de logging. Ele é open-source e pode ser auto-hospedado, sendo uma opção flexível para startups e equipes de desenvolvimento que desejam observabilidade de LLM rápida sem a necessidade de gerenciar infraestruturas pesadas ou ficar presas a um único fornecedor (vendor lock-in).
Explore também: Top 5 Alternativas ao Helicone

O PromptLayer é uma plataforma dedicada de observabilidade e gerenciamento de prompts para aplicações de LLM. Ele ajuda desenvolvedores a rastrear, versionar e avaliar cada par de prompt-resposta em tempo real, facilitando a depuração das saídas do modelo e a otimização da qualidade dos prompts. Com suporte nativo para OpenAI e LangChain, o PromptLayer captura metadados como carimbos de data/hora, latência, uso de tokens e status de sucesso/falha com mínimo esforço de integração.
Um de seus recursos centrais é o controle de versão de prompts. Os desenvolvedores podem anotar alterações, comparar saídas e monitorar como os ajustes nos prompts impactam o desempenho do modelo ao longo do tempo. Isso é especialmente útil para equipes que executam testes A/B ou iteram rapidamente em recursos de AI voltados ao usuário. O PromptLayer também suporta marcação por tags, agrupamento e busca de logs entre usuários, modelos e aplicações.
Seu dashboard intuitivo permite filtrar por chave de API ou ambiente, oferecendo às equipes uma visão clara do desempenho em produção e do progresso do desenvolvimento. Seja usado para depuração, conformidade ou experimentação, o PromptLayer traz estrutura e visibilidade ao ciclo de vida da engenharia de prompts.

O WhyLabs LangKit é um toolkit especializado em observabilidade e monitoramento focado em detectar riscos nas saídas de LLMs, como alucinações, viés e linguagem tóxica. Projetado para equipes que implantam AI generativa em escala, o LangKit se integra aos pipelines de inferência do modelo e escaneia continuamente as saídas em busca de anomalias usando técnicas estatísticas e baseadas em regras.
Diferente das ferramentas tradicionais de rastreamento, o LangKit enfatiza a qualidade da saída e a análise comportamental. Ele monitora mudanças em embeddings, drift semântico e anomalias de distribuição que possam indicar problemas emergentes com a confiabilidade do modelo ou com as entradas de dados. Ele também suporta explicabilidade ao destacar por que certas gerações foram sinalizadas, ajudando as equipes a refinar prompts, escolhas de modelos ou guardrails.
O LangKit funciona com stacks de inferência gerenciados ou auto-hospedados e suporta integração com backends de observabilidade como a Plataforma WhyLabs, OpenTelemetry ou dashboards personalizados. É particularmente valioso em ambientes regulamentados ou aplicações voltadas ao cliente, onde uma saída inadequada do LLM pode ter consequências reais. Com o LangKit, as equipes obtêm garantia de qualidade proativa e sinais de alerta precoce antes que as falhas se intensifiquem.

O Arize AI oferece recursos avançados de observabilidade e avaliação adaptados para implantações de LLM em nível de produção. Construído originalmente para monitoramento de modelos de ML, o Arize expandiu suas capacidades para suportar grandes modelos de linguagem, focando na análise pós-implantação, detecção de drift de dados e saúde da geração aumentada por recuperação (RAG).
Um dos pontos fortes do Arize é o monitoramento de drift de embeddings — acompanhando mudanças nas representações vetoriais ao longo do tempo para sinalizar desvios semânticos nas consultas dos usuários ou no comportamento do modelo. Ele também suporta avaliações específicas para LLMs, como detecção de alucinação, pontuação de relevância e alinhamento entre prompt e saída, ajudando as equipes a comparar a qualidade do modelo em escala. Pipelines de RAG se beneficiam da visibilidade sobre a latência do recuperador (retriever), taxas de correspondência de conteúdo e lacunas de conhecimento.
A plataforma se integra com OpenAI, Cohere, Hugging Face e LLMs personalizados, fornecendo dashboards centralizados e alertas. Com suporte para filtragem por tipo de prompt, segmentos de usuários e loops de feedback, o Arize permite uma análise detalhada do modelo e melhoria contínua. É uma escolha sólida para empresas que executam aplicações críticas de LLM que exigem observabilidade além dos logs básicos no nível de token.

O Comet ML Observability estende sua suíte de experimentação e rastreamento de ML para incluir suporte abrangente para aplicações de LLM. Projetado para equipes de pesquisa e produção, o Comet permite o rastreamento detalhado de prompts, respostas, contagem de tokens, latência e interações no nível do usuário em fluxos de trabalho de LLM. Ele suporta tanto métricas pré-construídas quanto personalizadas, tornando-o adaptável para diversos casos de uso, como ajuste de prompts, avaliação de modelos e testes A/B.
As ferramentas de observabilidade de LLM do Comet permitem que as equipes comparem variantes de prompts, visualizem o desempenho ao longo do tempo e anotem execuções de prompts para depuração colaborativa. Com forte integração aos pipelines de treinamento e inferência de modelos, ele unifica o monitoramento em todos os estágios do ciclo de vida do modelo, desde o ajuste fino até a implantação. As equipes podem marcar experimentos, monitorar violações de guardrails e definir alertas para comportamentos anômalos.
Ele também suporta integração com OpenAI, Hugging Face, LangChain e endpoints personalizados, sendo adequado tanto para LLMs hospedados quanto gerenciados autonomamente. Para equipes que já usam o Comet para desenvolvimento de modelos, essa extensão adiciona transparência e governança valiosas ao uso de LLM.
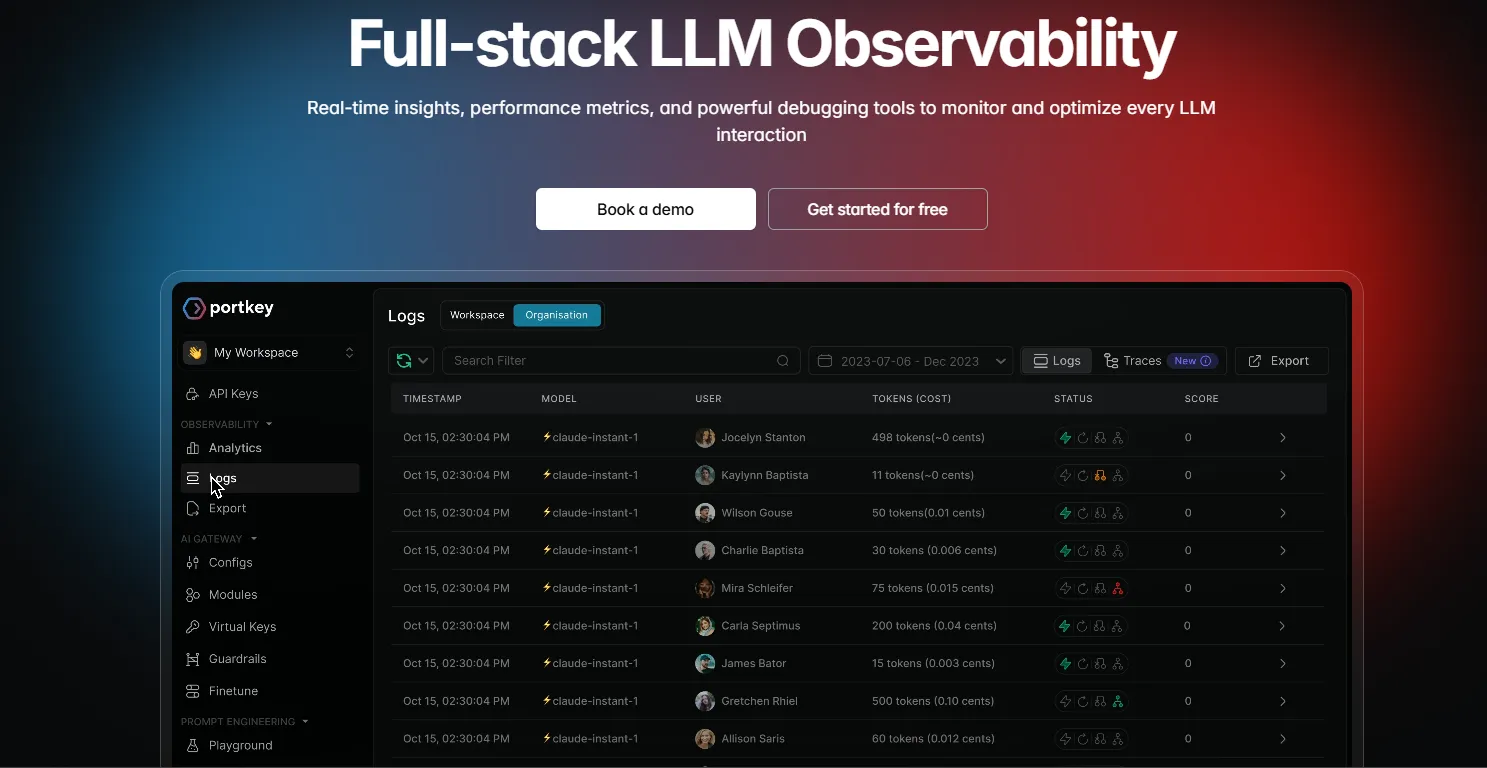
O Portkey tornou-se amplamente conhecido por meio de seu LLM Gateway open-source, que fornece acesso unificado a mais de 100 provedores de LLM através de uma única API. Mais tarde, expandiu-se para a observabilidade de LLM, ajudando equipes a monitorar e gerenciar aplicações de AI em escala.
A plataforma funciona como uma camada de proxy entre sua aplicação e os provedores de LLM, permitindo que as equipes gerenciem bibliotecas de prompts, regras de roteamento, reoperativas (retries), configurações de temperatura e configurações de modelo de forma centralizada. O Portkey também suporta caching de respostas, balanceamento de carga e roteamento de fallback para melhorar a confiabilidade e reduzir os custos de infraestrutura.
Para observabilidade, o Portkey captura logs de requisição e resposta, uso de tokens, latência e análises do modelo. No entanto, ele se concentra principalmente no registro de interações, e não no rastreamento completo do fluxo de trabalho. Sua combinação de gerenciamento de gateway e monitoramento o torna uma forte escolha para implantações de AI multimodelo e de alto volume.
O LangSmith é uma plataforma comercial de rastreamento e observabilidade desenvolvida pela LangChain, um dos frameworks de orquestração de LLM que mais cresce. Desde o seu lançamento em julho de 2023, cresceu rapidamente junto com o ecossistema LangChain e sua grande comunidade de desenvolvedores.
O LangSmith é profundamente integrado ao LangChain, permitindo que os desenvolvedores capturem automaticamente traces de prompts, saídas de modelos, chamadas de ferramentas, latência e fluxos de execução sem grandes alterações no código. Ele também suporta fluxos de trabalho fora do LangChain, tornando-o útil para depurar aplicações complexas de LLM e sistemas baseados em agentes.
A plataforma inclui ferramentas de avaliação que permitem às equipes revisar manualmente as saídas ou usar avaliadores baseados em LLM para pontuação e benchmarking automatizados. O LangSmith também oferece análises e monitoramento limitado de custos, focado principalmente no uso da OpenAI. Embora não ofereça auto-hospedagem em sua oferta padrão, continua sendo uma escolha popular para equipes focadas no rastreamento e depuração de fluxos de trabalho de LLM.
Selecionar a ferramenta de observabilidade de LLM correta pode fazer a diferença entre escalar sistemas de AI com confiança e operar no escuro com comportamentos imprevisíveis do modelo. À medida que os LLMs se tornam profundamente integrados em aplicações de alto risco e voltadas ao cliente, a observabilidade precisa ir além dos logs e métricas básicos. Aqui estão os critérios essenciais a avaliar ao escolher a solução ideal:
Rastreamento e Telemetria no Nível de Prompt
No centro da observabilidade de LLM está a capacidade de rastrear cada prompt do início ao fim. Uma boa ferramenta deve registrar o conteúdo do prompt, metadados de entrada, respostas do modelo, uso de tokens (entrada e saída), latência e o impacto no sistema downstream. Essa visibilidade ajuda a diagnosticar falhas, otimizar custos e monitorar a qualidade.
Suporte a Múltiplos Provedores e Modelos de LLM
Como as aplicações modernas podem usar diferentes modelos (OpenAI, Anthropic, Mistral, auto-hospedados via vLLM, etc.), a plataforma de observabilidade deve se integrar perfeitamente a todos os provedores. Ela deve fornecer visualizações unificadas e suportar o formato de API compatível com a OpenAI para facilitar a adoção.
Monitoramento e Alertas em Tempo Real
Procure sistemas que suportem dashboards em tempo real, heatmaps de latência e métricas de consumo de tokens. Mais importante ainda, eles devem permitir alertas para comportamentos incomuns, como picos nas taxas de erro, latência excessiva ou falhas de prompt. Isso permite uma resposta e resolução mais rápidas durante incidentes em produção.
Violação de Guardrails e Auditoria de Políticas
Uma ferramenta de nível empresarial deve rastrear violações de guardrails — instâncias em que entradas ou saídas violam políticas de moderação ou segurança. Isso é essencial para manter a conformidade e alinhar o comportamento do modelo com os padrões organizacionais.
Atribuição de Custos e Aplicação de Orçamento
Plataformas avançadas de observabilidade oferecem rastreamento detalhado de custos até o nível do usuário, modelo ou prompt. Capacidades robustas de solução de rastreamento de custos de LLM permitem que as equipes de engenharia e finanças monitorem o uso em tempo real, apliquem orçamentos e evitem estouros silenciosos de custos em produção. Algumas permitem a integração com sistemas de faturamento ou aplicam limites de uso por meio de alertas e controles automatizados, ajudando a manter a engenharia e o setor financeiro alinhados.
Acesso Baseado em Funções (RBAC) e Visualizações por Equipe
Para grandes organizações, a capacidade de filtrar dados por usuário, equipe ou projeto é essencial. As ferramentas de observabilidade devem suportar RBAC e permitir acesso delimitado para que as equipes vejam apenas traces e logs relevantes.
Integração com Ferramentas de Dev e Data Lakes
Escolha plataformas que ofereçam APIs, funcionalidade de exportação e suporte para repositórios de dados (data sinks) como ClickHouse, BigQuery ou OpenTelemetry. Isso garante que os dados de observabilidade possam ser estendidos para análises, auditorias de conformidade ou fluxos de trabalho de ajuste fino (fine-tuning) do modelo.
Uma ferramenta de observabilidade abrangente não apenas ajuda a monitorar o desempenho, mas também melhora a governança do modelo, a velocidade de depuração e o controle de custos. Priorize flexibilidade, segurança e insights em tempo real para preparar seu stack de LLM para o futuro.
Para saber mais sobre como funcionam a atribuição de custos e o orçamentamento, leia nosso guia aprofundado sobre: Observabilidade de Custos de AI: Rastreando e Controlando Gastos com LLM em Produção
À medida que as aplicações baseadas em LLM passam da fase de experimentação para a produção, a observabilidade torna-se essencial para a confiabilidade, segurança e escalabilidade. Ao contrário dos sistemas de software tradicionais, os LLMs geram saídas probabilísticas, o que significa que a mesma entrada pode produzir respostas diferentes dependendo do contexto, do design do prompt ou do estado do modelo. Sem visibilidade sobre como esses sistemas se comportam, a depuração e a otimização tornam-se extremamente difíceis.
Uma das maiores razões pelas quais a observabilidade de LLM é importante é a detecção de alucinações. Os modelos podem gerar respostas imprecisas ou enganosas com alta confiança, especialmente em aplicações voltadas para o cliente. As ferramentas de observabilidade ajudam as equipes a rastrear prompts, inspecionar saídas e identificar onde ocorrem as alucinações para que possam melhorar os prompts, os pipelines de recuperação ou as guardrails.
A gestão de custos é outra grande preocupação. Como muitas APIs de LLM cobram com base no consumo de tokens, mesmo pequenas ineficiências podem levar a estouros de orçamento em grande escala. As plataformas de observabilidade rastreiam o uso de tokens, a latência e o throughput em tempo real, permitindo que as equipes otimizem prompts e reduzam custos desnecessários com APIs.
A observabilidade de LLM também melhora a confiabilidade e a experiência do usuário. Ao monitorar picos de latência, solicitações com falhas ou degradação na qualidade da saída, as equipes podem responder aos incidentes mais rapidamente e manter o desempenho da aplicação. Isso é especialmente importante para agentes de AI, copilotos e pipelines de RAG que dependem de múltiplas chamadas de modelos e ferramentas externas.
A segurança e a conformidade são igualmente importantes. A observabilidade ajuda a detectar ataques de prompt injection, saídas tóxicas, violações de políticas e exposição não autorizada de dados. Para empresas que operam em setores regulamentados, como saúde ou finanças, essa visibilidade é crítica para governança e auditabilidade.
Em última análise, a observabilidade transforma os sistemas de LLM de caixas-pretas em infraestrutura gerenciável e pronta para produção. Ela permite que as equipes construam aplicações de AI mais seguras, eficientes e confiáveis em escala.
TrueFoundry se destaca como uma das plataformas mais completas para observabilidade de LLM em nível empresarial, pois combina rastreamento profundo, analytics em tempo real, governança e visibilidade de custos em uma única stack pronta para produção.
Uma das maiores vantagens da TrueFoundry é sua arquitetura de rastreamento de ponta a ponta. Cada interação de LLM é capturada em todo o fluxo de trabalho, incluindo prompts, respostas, latência, metadados do modelo, chamadas de ferramentas, eventos de fallback e dependências downstream. Isso permite que as equipes depurem sistemas de AI complexos com visibilidade total sobre cada etapa de inferência.
A plataforma também oferece dashboards avançados de monitoramento em tempo real que rastreiam:
Esses insights ajudam as equipes a identificar rapidamente gargalos antes que eles afetem os usuários ou aumentem os custos de infraestrutura.
Outro ponto forte é a atribuição granular de custos. A TrueFoundry permite que as organizações rastreiem o uso e os gastos de tokens por:
Esse nível de visibilidade é extremamente valioso para empresas que executam cargas de trabalho de GenAI em larga escala em vários departamentos.
Ao contrário de muitas ferramentas leves de observabilidade, a TrueFoundry foi projetada para operações de AI em produção. Ela suporta:
Isso a torna particularmente atraente para organizações que lidam com dados sensíveis ou regulamentados.
A TrueFoundry também se integra perfeitamente com ecossistemas modernos de LLM, incluindo APIs compatíveis com OpenAI, fluxos de trabalho do LangChain, pipelines de RAG e stacks de inferência personalizadas. As equipes podem adotar a observabilidade sem precisar reconstruir sua infraestrutura.
Para empresas que buscam dimensionar a AI de forma responsável, mantendo a governança, a confiabilidade e a eficiência de custos, a TrueFoundry oferece uma das soluções de observabilidade de LLM mais completas disponíveis em 2026.
À medida que os LLMs se tornam fundamentais nas aplicações modernas, a observabilidade deixa de ser opcional e se torna essencial. As ferramentas certas, como a TrueFoundry LLM observability, ajudam as equipes a rastrear o comportamento dos prompts, gerenciar custos, detectar falhas e garantir a implantação responsável de AI em escala. Quer você esteja otimizando a latência, se protegendo contra alucinações ou analisando o uso de tokens, essas ferramentas oferecem a visibilidade necessária para operar com confiança.
Plataformas como TrueFoundry, Langfuse e Arize lideram o caminho com recursos de nível de produção, enquanto outras fornecem opções leves para uma integração rápida. Em última análise, a melhor ferramenta depende da sua stack, das suas necessidades de governança e da escala das suas operações. Investir em observabilidade hoje garante sistemas de LLM mais seguros e inteligentes amanhã.
Obtenha visibilidade total sobre seus rastreamentos em produção e otimize custos com a TrueFoundry, a melhor plataforma de observabilidade de LLM para cargas de trabalho de AI empresariais. Agende uma demonstração hoje mesmo para garantir que seus modelos sejam confiáveis, seguros e eficientes.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada

















