August 26, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Published: October 10, 2026
Blazingly fast way to build, track and deploy your models!
Quando a OpenAI lançou o GPT-5.6 em 9 de julho com três níveis (Sol, Terra e Luna), a maior parte da atenção se voltou para a própria hierarquia de níveis. A mudança mais discreta é a mais interessante: as gravações em cache agora são cobradas pela primeira vez, a 1,25x a taxa normal de entrada, enquanto as leituras de cache mantêm o desconto existente de 90%. O cache costumava ser uma vantagem quase gratuita. Agora ele tem um custo, o que significa que também existe um ponto em que deixa de valer a pena.
Então, onde fica esse ponto? Criamos um pequeno modelo de custo para descobrir, em todos os três níveis.
Para uma carga de trabalho típica de agente, você tem um grande contexto compartilhado (prompt do sistema, esquemas de ferramentas, contexto do repositório) reutilizado em muitas chamadas, além de uma pequena parte exclusiva por solicitação. O ponto de equilíbrio depende de três números: o preço total de entrada, o preço de gravação em cache e o preço de leitura em cache. Resolva a combinação de gravação/leitura onde o cache custa o mesmo que não usar cache, e você obtém uma proporção única.
Aqui está a parte que não esperávamos: essa proporção é idêntica em Sol, Terra e Luna. As gravações podem representar até 78,3% das solicitações antes que o cache deixe de valer a pena, e esse número não muda com o tamanho do contexto, o volume de solicitações ou o nível em que você está. A OpenAI aplicou os mesmos multiplicadores de 1,25x/0,10x uniformemente em toda a família, portanto, a escolha do nível altera seus custos absolutos, não sua estratégia de cache.
O tamanho do contexto não altera o ponto de equilíbrio, mas muda o que está em jogo. Executando a mesma proporção de gravação/leitura em três tamanhos de contexto:
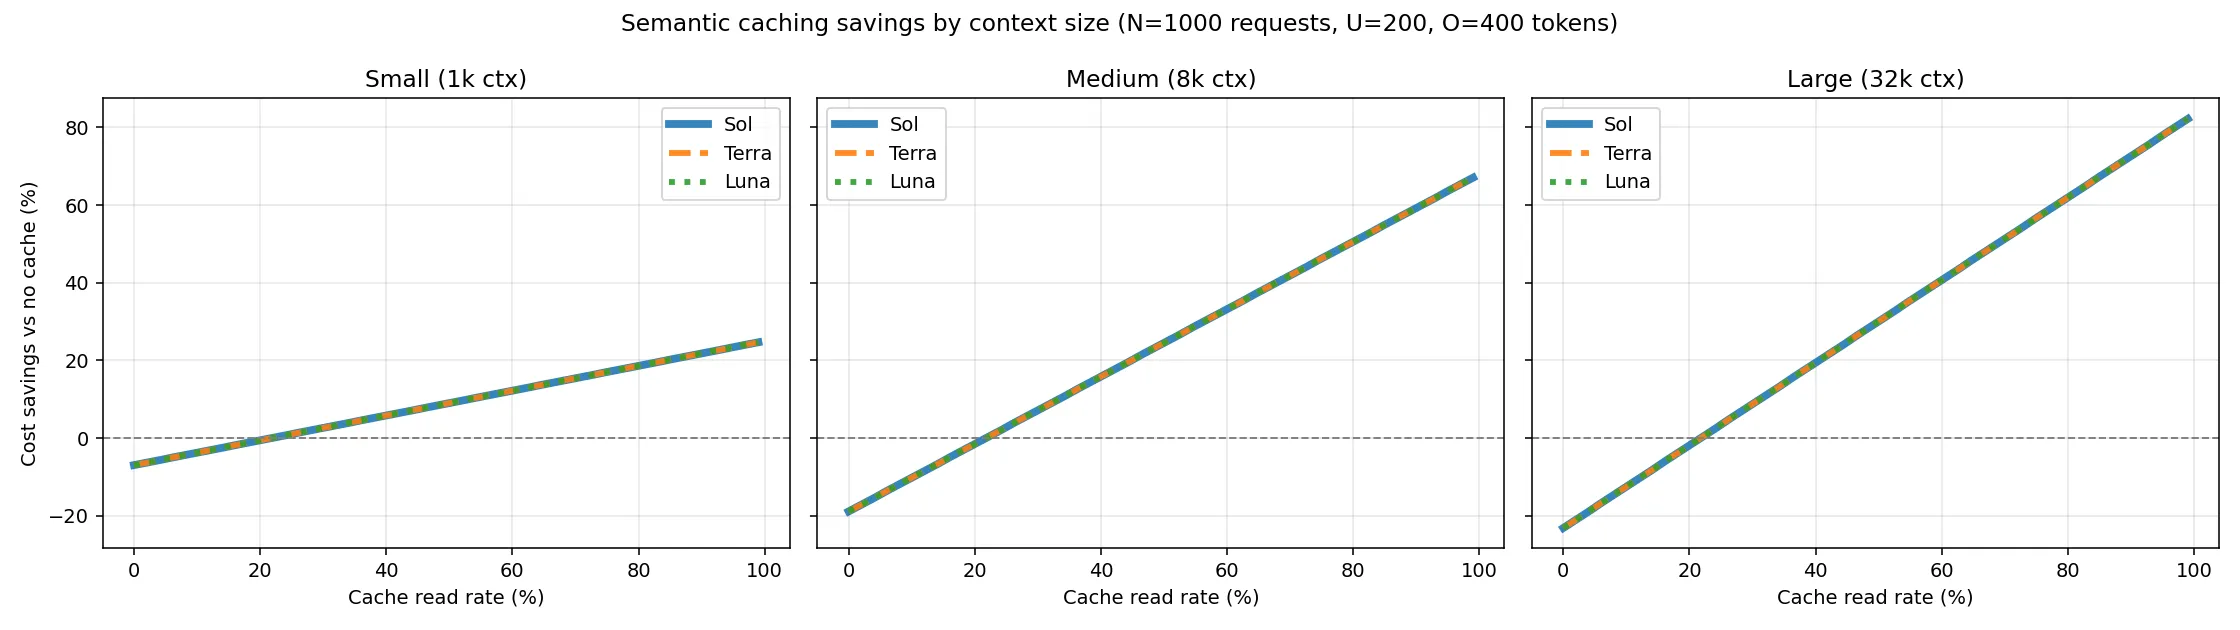
Com um contexto compartilhado pequeno (1 mil tokens), as economias são reais, mas modestas, mesmo com altas taxas de repetição. Com um grande (32 mil tokens, pense em prompts de sistema longos e grandes esquemas de ferramentas), a mesma taxa de repetição produz economias drasticamente maiores, simplesmente porque há mais sendo descontado em cada leitura.
Uma taxa de repetição fixa e limpa é um bom exemplo didático, mas o tráfego real de agentes não é tão organizado. As durações das sessões (quantas chamadas compartilham um contexto em cache antes que ele mude ou expire) variam muito. Modelamos as durações das sessões com uma distribuição log-normal (média de 25 solicitações por sessão, cauda longa) e obtivemos uma participação de gravação simulada de cerca de 3%, com uma sessão mediana de 23 solicitações e uma sessão no 90º percentil de 58. Isso não chega nem perto do limite de equilíbrio de 78,3%. Nesta simulação, o cache venceu confortavelmente: as economias variaram de 24% em um contexto pequeno de 1 mil tokens até quase 80% em um de 32 mil.
O único modo de falha que vale a pena observar: contexto que muda rapidamente. Se o contexto compartilhado do seu agente mudar a cada poucas solicitações em vez de persistir por dezenas delas, você pode acabar do lado errado desse limite, e o cache se torna um custo em vez de uma economia.
Não julgue o preço do cache do GPT-5.6 apenas pelo preço de tabela. Modele sua própria combinação de gravação/leitura em relação ao limite de 78,3%. Se o contexto do seu agente permanecer estável por dezenas de solicitações de cada vez, é muito provável que o cache ainda seja uma vitória clara com o novo preço, independentemente do nível que você esteja usando.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada