



novembro 20, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: novembro 20, 2026

Blazingly fast way to build, track and deploy your models!
A pergunta "qual modelo é o melhor?" é a pergunta errada e custa dinheiro às equipes silenciosamente. A resposta honesta é que um modelo de fronteira é uma ferramenta com um preço, e a escolha correta depende do que você está pedindo para ele fazer. Enviar uma tarefa de classificação de avaliação de produto para um modelo de raciocínio de topo de linha é como alugar um guindaste para pendurar um quadro na parede. Funciona. Mas custa 40 vezes mais do que o necessário e é mais lento.
No final de 2026, a fronteira de IA se dividiu claramente em camadas (tiers). Todos os grandes fornecedores oferecem pelo menos três modelos: um flagship otimizado para raciocínio complexo, um modelo intermediário (workhorse) focado em custo-benefício e vazão (throughput), e um modelo pequeno projetado para ser ultra-rápido e de baixo custo. As decisões importantes já não são mais "OpenAI ou Anthropic", mas sim "qual camada usar para qual requisição, a que custo e com qual fallback". Isso é um problema de roteamento, e problemas de roteamento são resolvidos com políticas, não com lealdade a uma marca.
Este artigo faz duas coisas. Primeiro, apresenta um panorama por fornecedor focado nas reais fortalezas de cada modelo. Segundo, traz um framework de decisão que mapeia seus tipos de tarefas a uma camada de modelo e uma postura de custo, mostrando como um AI gateway permite aplicar esse framework sem reescrever sua aplicação a cada atualização de versão dos provedores.
Quer rotear cada requisição para o modelo certo com base em tarefa e custo? Agende uma demonstração.
Os benchmarks medem um modelo em um teste estático. O seu tráfego em produção não é um teste estático. Ele é uma mistura: um grande volume de chamadas baratas e repetitivas (extrair número de nota fiscal, classificar chamados, decidir qual prompt executar a seguir) e um fluxo reduzido de requisições genuinamente difíceis (depurar uma race condition em cinco arquivos, analisar um contrato de 200 páginas). Um único "melhor modelo" precisa ter seu preço e tamanho dimensionados para o fluxo difícil, fazendo com que você pague um valor excessivo para o grande volume de tarefas simples.
Três fatores tornam o pensamento focado em um único modelo extremamente dispendioso:
A solução é tratar a seleção de modelos como configuração. Defina a política uma vez ("extração vai para a camada barata, codificação vai para a camada intermediária, raciocínio complexo é escalado para um flagship e tudo tem fallback para um segundo provedor em caso de erro"), aplique-a no gateway e altere-a sem precisar publicar código. Para entender a mecânica desse processo, veja o que é um roteador de LLM e a seleção de modelos consciente de custo e qualidade.
Os únicos números abaixo confirmados oficialmente pelo fornecedor são os do Claude. Todos os outros foram agregados a partir de dados de terceiros em novembro de 2026 e devem ser verificados diretamente nas páginas de preços e modelos de cada provedor antes de serem usados como referência definitiva. As especificações dos modelos mudam com frequência.
A linha do Claude no final de 2026 opera com uma janela de contexto de 1M de tokens, 128K de saída e data de corte de treinamento em junho de 2026. As camadas são bem definidas:
O padrão recomendado aqui é a divisão em três vias: um modelo pequeno quase gratuito, um modelo intermediário equilibrado e um modelo premium para agentes. É possível construir praticamente qualquer política de roteamento com base nessas três funções.
A geração GPT-6 da OpenAI é reportada como seguindo a mesma estrutura de camadas. O GPT-6 Astra é cotado a US$ 10 / US$ 50, posicionado para raciocínio de alto nível. O GPT-6.1 Sol é reportado a US$ 2 / US$ 10, descrito como o modelo mais forte da família para codificação e pesquisa, com um Coding Index reportado em torno de 54. O GPT-6.1 Terra, reportado a US$ 1 / US$ 5 e lançado por volta de 26 de outubro de 2026, possui contexto de cerca de 1.05M e Coding Index próximo a 48, entregando metade do preço do Sol com grande parte de sua capacidade de código. O GPT-6 Luna, cotado a US$ 0,10 / US$ 0,50, é o modelo de alto volume para classificação e roteamento, com Coding Index reportado em torno de 31.
Considere os números do Coding Index como dados orientativos, não exatos. Eles vêm de agregações de terceiros e podem mudar.
A linha do Google é a mais difícil de precisar devido a relatórios divergentes. O Gemini 3.1 Pro é cotado a US$ 2 / US$ 12, voltado para raciocínio complexo. O Gemini 3.6 Flash é reportado a US$ 1,50 / US$ 7,50, lançado em meados de julho de 2026, com 1M de janela de contexto, Intelligence Index de cerca de 50, SWE-Bench Pro em torno de 58,7% e throughput perto de 280 tokens por segundo, posicionando-se como uma opção de alta capacidade e baixo custo para codificação. O Gemini 3.1 Flash-Lite é cotado próximo a US$ 0,25 / US$ 1,50 na camada de entrada. Caso o 3.6 Flash não esteja disponível na sua conta, a opção segura é o Gemini 3.5 Flash de disponibilidade geral.
O versionamento do Grok permanece instável. O Grok 4.3, a cerca de US$ 1,25 / US$ 2,50, é a configuração mais citada, destacando-se pelo baixo custo de saída. As versões mais recentes Grok 4.6 e Grok 5 são citadas no mercado, mas ainda não estão consolidadas. Verifique diretamente com a xAI antes de direcionar tráfego de produção para ele.
Para equipes que preferem auto-hospedagem ou foco total em redução de custos: o Meta Llama 4 Maverick é cotado em torno de US$ 0,20 / US$ 0,60 e o Scout a cerca de US$ 0,11 / US$ 0,34, ambos open-weight e prontos para auto-hospedagem. O DeepSeek V4 é reportado na faixa de US$ 0,22 a US$ 0,66, focado em raciocínio e codificação com excelente custo-benefício. O Mistral Large 3 é cotado por volta de US$ 0,50 / US$ 1,50. Essas opções são ideais quando a residência de dados ou a economia unitária são os fatores decisivos.
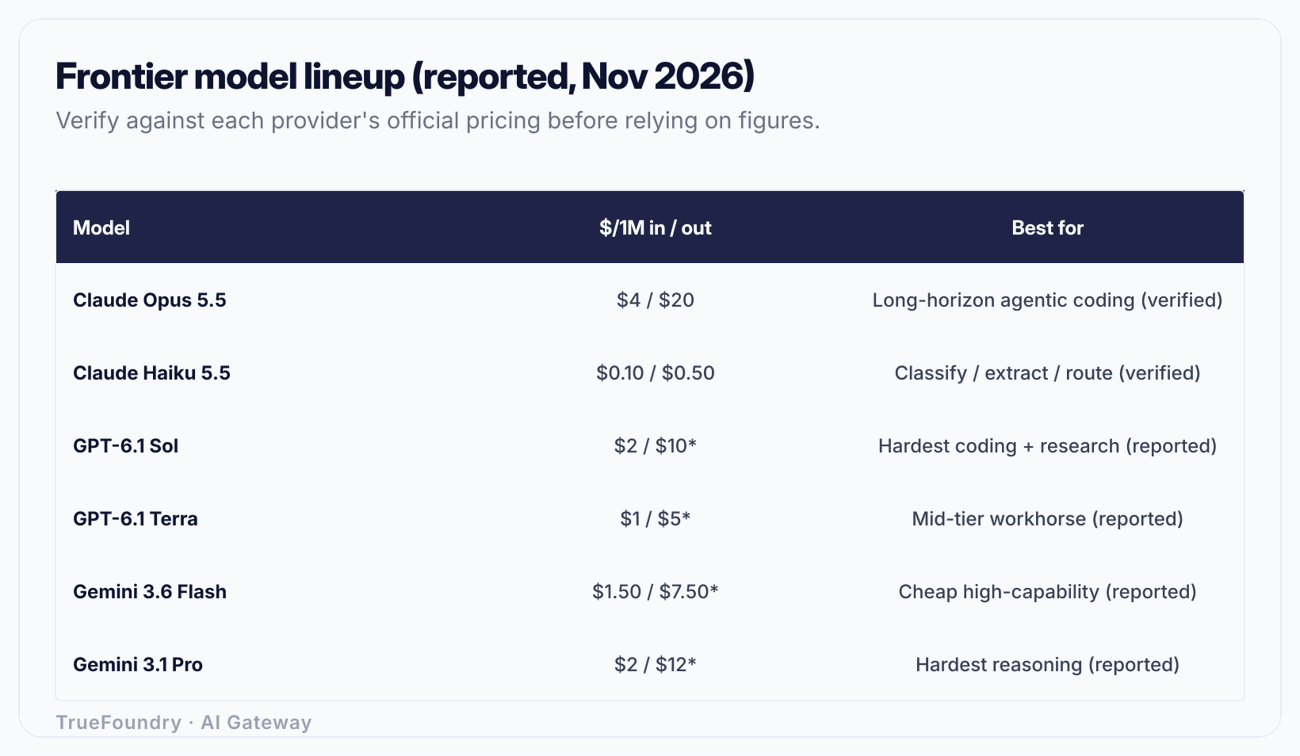
Preços e benchmarks reportados em novembro de 2026; verifique a página oficial de cada provedor antes de tomar decisões — as especificações mudam com frequência.
Pare de tentar escolher um único modelo. Comece a classificar o seu tráfego e conecte cada classe a uma camada e a uma postura de custo. Quatro categorias cobrem quase todos os cenários.
São tarefas de alto volume e baixa ambiguidade: etiquetar um chamado, extrair uma data de um documento, decidir qual ramificação de prompt executar. Elas não exigem um modelo flagship. Um modelo pequeno (Haiku 5.5, GPT-6 Luna, Gemini 3.1 Flash-Lite) a cerca de US$ 0,10 a US$ 0,25 por milhão de tokens de entrada resolve o problema. Como a saída é curta, o custo por requisição é mínimo. Postura de custo: minimizar. É aqui que o roteamento para a camada barata gera a maior economia.
O atendimento ao usuário via chat exige boa qualidade e baixa latência, mas raramente necessita do raciocínio mais profundo. Um modelo intermediário (Sonnet 5.5, GPT-6.1 Terra, Gemini 3.6 Flash) é a escolha ideal. Postura de custo: equilibrar. Preste atenção especial ao preço de saída, pois o chat gera um volume alto de tokens.
A codificação em múltiplas etapas — onde o modelo planeja, executa ferramentas, lê arquivos e mantém o contexto através de vários turnos — é onde as diferenças de capacidade ficam evidentes. Para as tarefas mais complexas de agentes, o Opus 5.5 é o modelo padrão recomendado; o GPT-6.1 Sol aparece como uma alternativa equivalente segundo relatórios. Para tarefas diárias de codificação que não exigem longo alcance, um modelo intermediário (Terra, Gemini 3.6 Flash, Sonnet 5.5) entrega cerca de 90% do resultado por uma fração do preço. Postura de custo: dividir por complexidade. Envie edições rotineiras para a camada intermediária e escale casos complexos de agentes para o flagship.
Análises jurídicas, síntese de pesquisas e interpretação de documentos extensos. Esse é o único cenário onde vale a pena pagar por um flagship (Astra, Gemini 3.1 Pro, Opus 5.5 ou Fable 5.1 para demandas extremas). Postura de custo: pagar por qualidade, mas controlar o acesso. Apenas uma pequena parcela do tráfego deve chegar a essa camada, controlada rigorosamente por regras de roteamento.
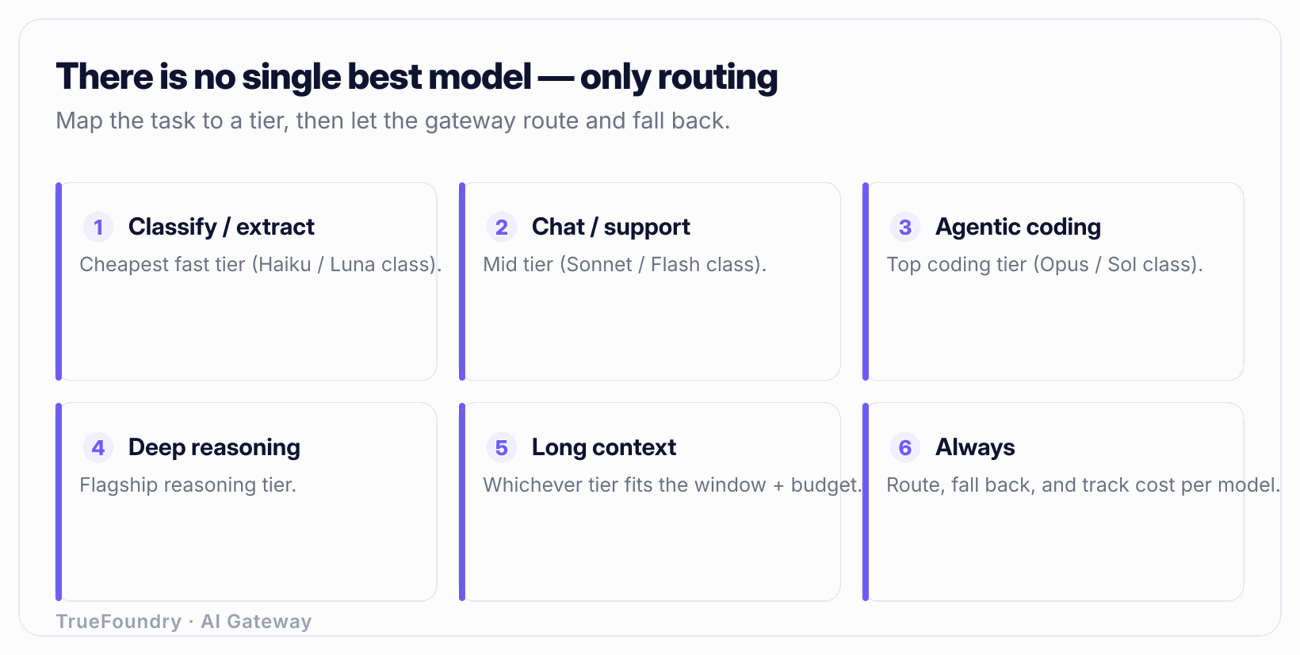
Preços e benchmarks reportados em novembro de 2026; verifique a página oficial de cada provedor antes de tomar decisões — as especificações mudam com frequência.
Veja como a TrueFoundry realiza o roteamento, gerencia fallbacks e rastreia custos em qualquer modelo. Agende uma demonstração.
Imagine que um produto processe 10 milhões de requisições de LLM por mês, com a seguinte distribuição: 80% simples (classificação, extração, roteamento), 15% chat e codificação rotineira, e 5% raciocínio avançado e codificação por agentes. Considere uma média de 500 tokens de entrada e 200 de saída por requisição para as camadas simples e de chat, com volumes maiores para a camada avançada.
Se você enviar todo o tráfego para um único flagship a US$ 4 / US$ 20, pagará a tarifa mais alta em todas as 10M de chamadas — incluindo as 8M que um modelo de US$ 0,10 resolveria com o mesmo nível de qualidade. Roteando por tarefa, o cenário muda:
A camada simples, que concentra o maior volume, passa a custar cerca de 1/40 por token de entrada em comparação ao flagship. Na maioria dos cenários reais, isso reduz a fatura total em mais da metade, mantendo as tarefas complexas nos modelos exatos que elas exigem. O valor exato depende da sua distribuição de tokens — o que reforça a importância de ter visibilidade de custos individualizada por modelo. Consulte o artigo sobre atribuição de custos de LLM e orçamentos de equipe para saber como gerenciar esses limites.
O framework só é útil se puder ser aplicado sem exigir um novo deploy a cada alteração. É exatamente para isso que serve um AI gateway. O gateway expõe uma API única e compatível com a OpenAI para a sua aplicação. Por trás desse endpoint único, você configura para qual modelo real cada requisição deve ser direcionada. A aplicação mantém o mesmo formato de chamada, enquanto o gateway decide o destino ideal.
Esse desacoplamento traz quatro vantagens diretas para o framework:
A padronização em uma API única traz um impacto estratégico importante. Quando um novo modelo é lançado (como o Terra no final de outubro), você o adiciona como destino e redireciona o tráfego via configuração. A aplicação continua funcionando normalmente. Para entender a infraestrutura por trás dessa solução, leia o que é um proxy de LLM e como escolher um AI gateway.
A fronteira dos modelos de IA no final de 2026 não é liderada por uma opção única e absoluta. Ela é formada por diferentes camadas, e as equipes que otimizam seus custos são aquelas que alinham cada tipo de tráfego à camada correta, evitando pagar tarifas de topo de linha para operações simples de classificação. Os nomes dos fornecedores, os preços e os rankings continuarão mudando. O framework permanece válido diante dessas variações: classifique seu tráfego, alinhe cada categoria a uma camada e postura de custo e controle o acesso à camada de alto custo para que apenas requisições complexas a utilizem.
Ao implementar esse framework como uma política de roteamento em um gateway, a escolha do modelo deixa de ser uma discussão recorrente e passa a ser apenas uma linha de configuração alterada em minutos. Você roteia por tarefa e custo, aciona fallbacks quando um provedor falha, faz cache de chamadas repetidas e acompanha exatamente o custo de cada modelo por requisição. Essa é a maneira mais eficiente de operar na fronteira da tecnologia sem ficar preso a um único provedor.
Evite o lock-in em um único modelo — faça o roteamento entre eles. Agende uma demonstração.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada


