



August 26, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
TrueFoundryは、Model Catalougeを通じて、大規模言語モデル(LLM)のデプロイとファインチューニングを行う強力かつ使いやすいソリューションを開発したことをお知らせします。私たちは、企業がKubernetes上でオープンソースLLMをセルフホストできるように支援し、1クリックで推論コストを10分の1に削減することを目指しています。このブログでは、TrueFoundryを使用してDolly-v2-3bモデルをデプロイし、Pythia-70Mモデルをファインチューニングする方法を紹介します。TrueFoundryプラットフォームは、ロジスティック回帰のような最もシンプルものからStable Diffusionのような最先端のモデルまで、あらゆるタイプの機械学習およびディープラーニングモデルをサポートするように設計されています。大規模言語モデルに関して、なぜ新しいものを構築する必要があるのかと思うかもしれません。
これらのモデルの絶大なサイズと複雑さは、実際のアプリケーションにデプロイする際に大きな課題をもたらします。TrueFoundryプラットフォームはすでにあらゆるサイズのモデルの大規模デプロイをサポートしていましたが、これらのモデルに対してさらに行える最適化(コスト+時間)とユーザー体験の向上が存在することに気づきました。
ChatGPTに代表される大規模言語モデル(LLM)が、人工知能の分野で大きな注目を集めていることは紛れもない事実です。
しかし、すでにプロダクション導入を進めている50社以上の企業と話をした結果、それがすでに生み出している価値は絶大です。人々が毎日新しいユースケースを発見するにつれて、LLMの活用は拡大していく一方であると私たちは信じています。
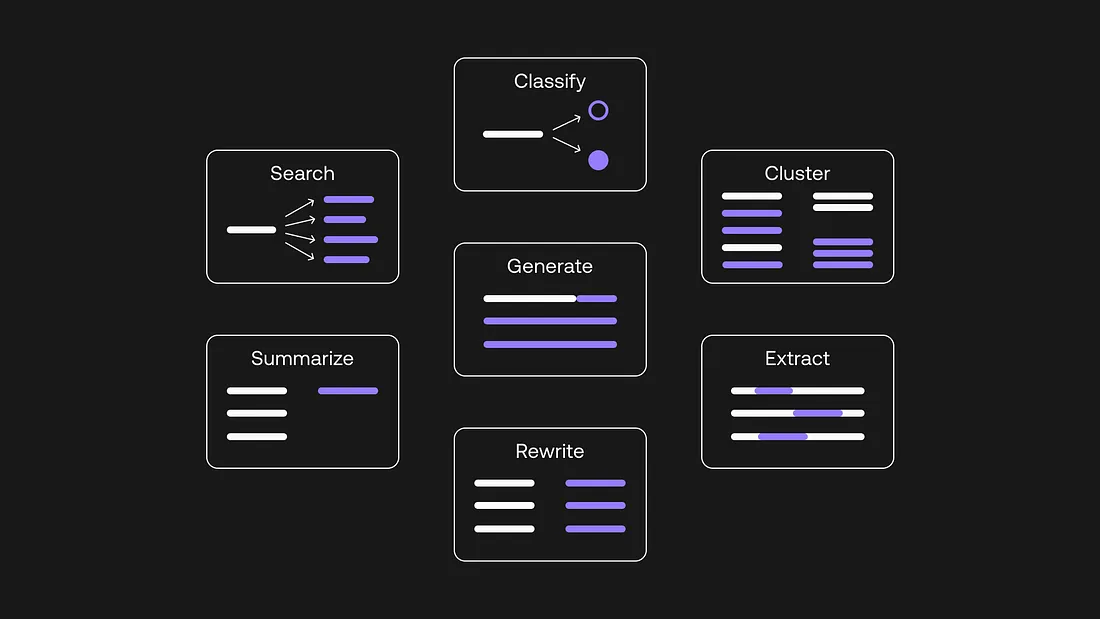
大規模言語モデルとOpenAI APIを使用して概念実証(PoC)のユースケースを作成するのは簡単ですが、プロダクション環境🚀を考え始めると、はるかに多くの考慮事項が発生します。
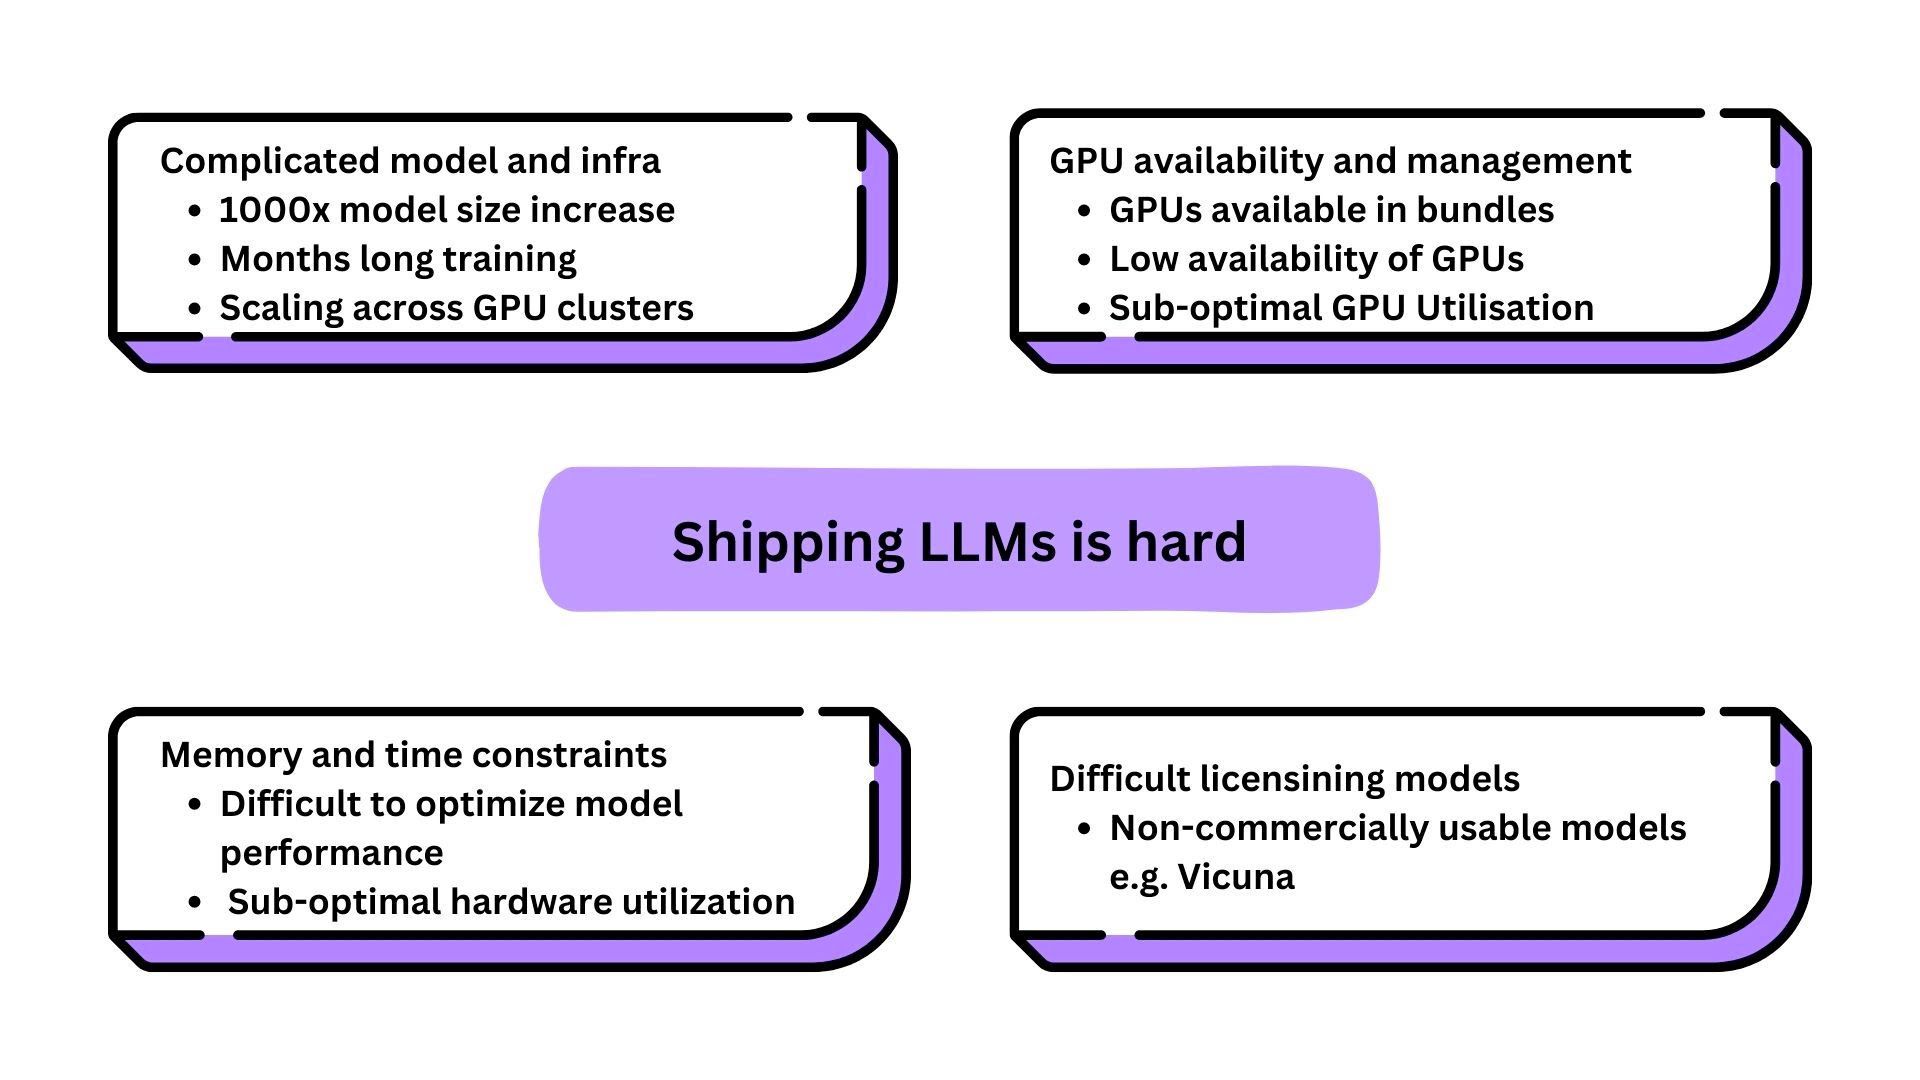
ほとんどの企業にとって、LLMを安定して提供するための複雑なGPUインフラストラクチャを処理するエンジニアリング能力を構築することは難しく、時間がかかります。さらに、多くの企業は自社のユースケースに最適な特定のモデルを望んでおり、そのためにはこれらのモデルをファインチューニングする必要があります。これは技術的にも困難であり、コストもかかる作業となります。
LLMの未来に関する私たちの立場は、オープンソースモデルが今後の進むべき道であるというものです。このテーマに関する私たちの見解の詳細はこちらをご覧ください。私たちは、この急速に革新が進むイノベーターのコミュニティを活用し、企業が組織内でこれらのオープンソースLLMの完全な価値を活用できるよう支援することを決定しました。
TrueFoundryは、自社の特定のユースケースに合わせてファインチューニングされたオープンソースLLMが組織にもたらすあらゆるメリットを、パートナー企業が実感できることを望んでいます。
ただし、独自のインフラストラクチャ上でオープンソースモデルを管理およびデプロイすることは容易ではありません。オンプレミスLLMデプロイメントは、比類のないデータ制御性、コンプライアンス対応力、長期的なコスト効率を提供しますが、GPUオーケストレーション、Kubernetes管理、モデル最適化に関する深い専門知識が必要です。
しかし、データを接続して数回クリックするだけで簡単に実行できるとしたらどうでしょうか?
私たちは、企業がLLMの概念実証からプロダクション環境へ移行する際に直面する課題を理解しています。私たちは、このプロセスをパートナーにとって超簡単にするレイヤーを構築することを目指しています。その仕組みは以下の通りです。
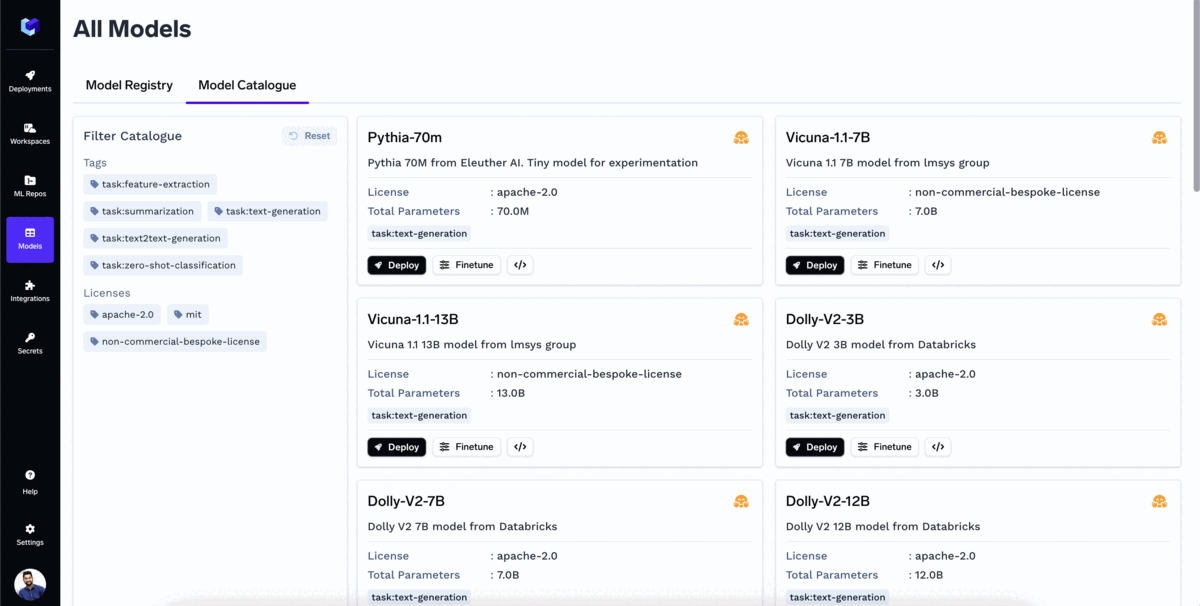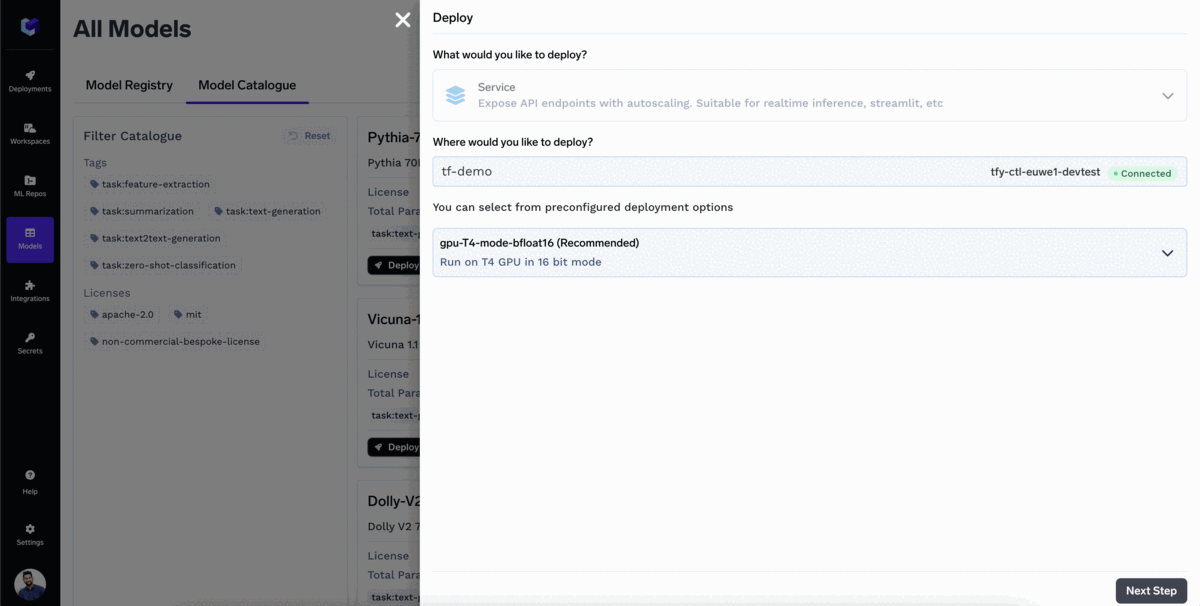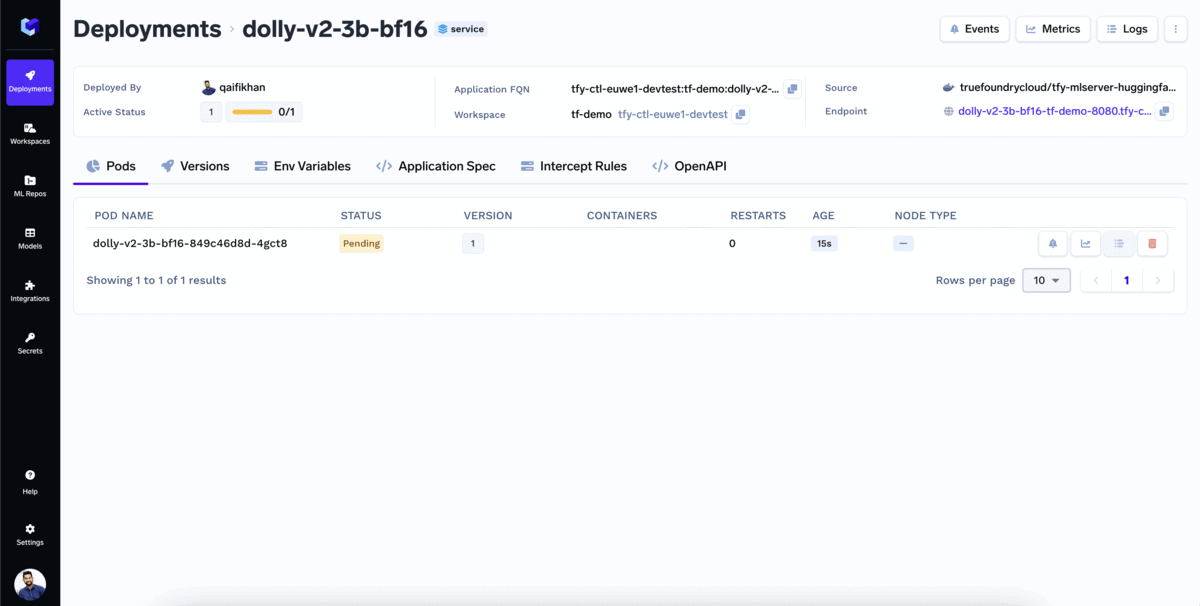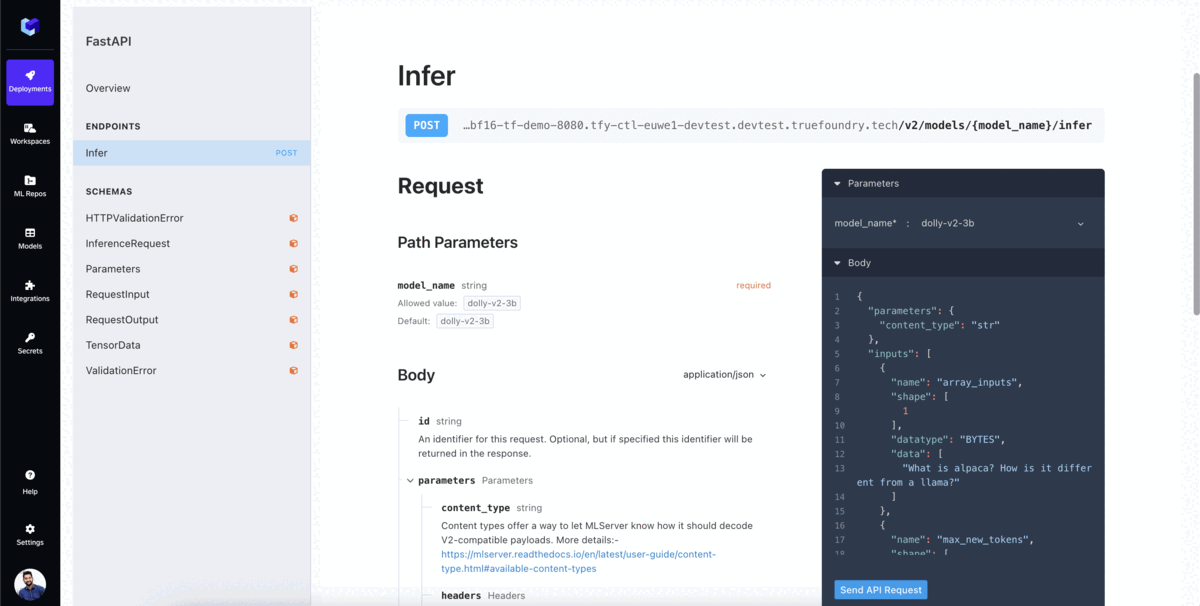
TrueFoundryのModel Catalogueは、ワンクリックでデプロイできる人気のあるすべてのオープンソース大規模言語モデル(LLM)のリポジトリです。ユーザーはモデルカタログから直接モデルをファインチューニングすることもできます。
カタログはすでに最も人気のあるモデルのほとんどをサポートしており、日々さらにサポートを追加しています。自社のクラウド上にすでにデプロイ可能な人気モデルの一部を以下に示します。
その他多数.....
私たちは、企業が初日からデプロイできるようにすることに注力しています。これを可能にするため、以下の原則に基づいてLLM機能を構築しています。
ℹ️
UI上でのトレーニングおよびファインチューニングのフローに関する詳細なガイドについては、こちらのYouTube動画を参照してください。
LLMのデプロイは、3回クリックするだけで完了します!
🚀
これでモデルがデプロイされました!
モデルAPIエンドポイントを使用して推論を開始します。TrueFoundryは、モデルをテストするためのOpenAPIインターフェースと、アプリケーション内でモデルを呼び出すためのサンプルコードを提供します。
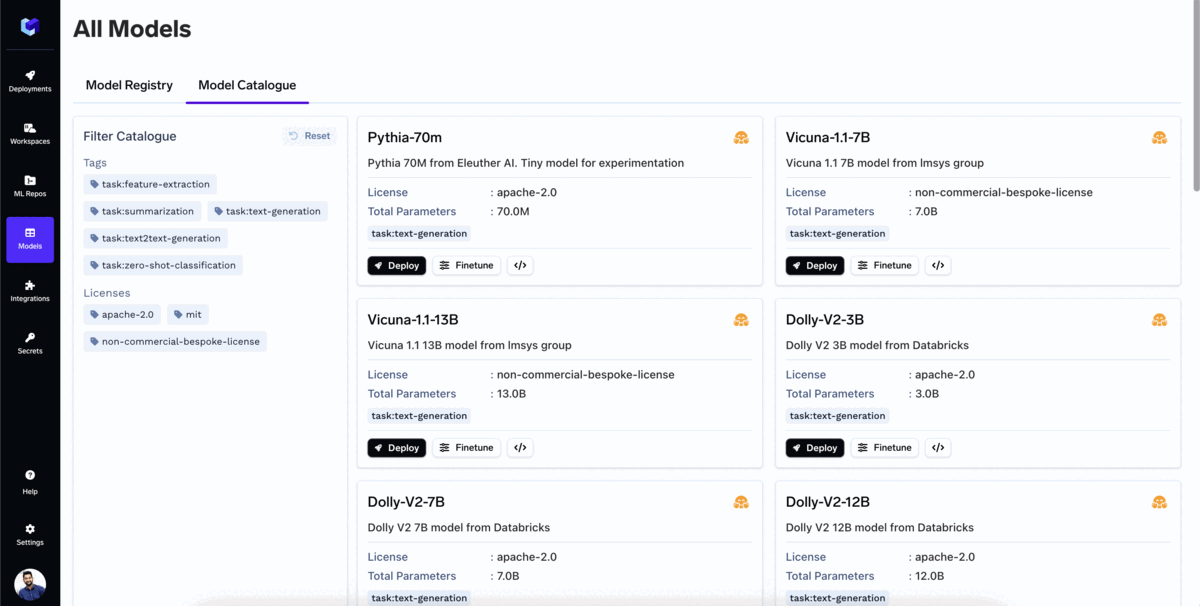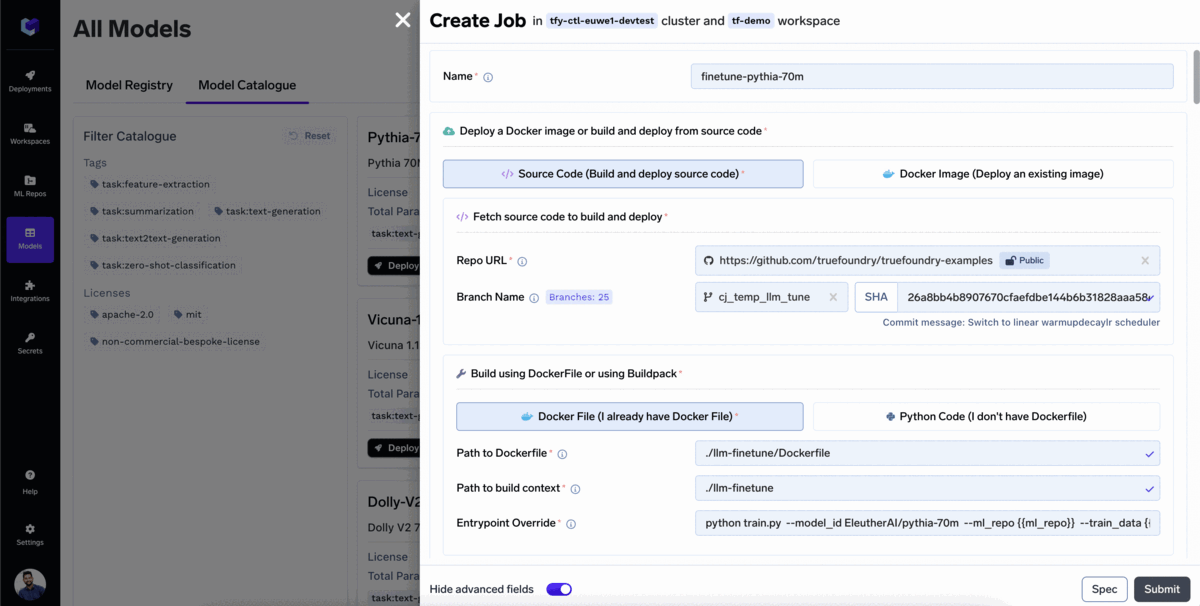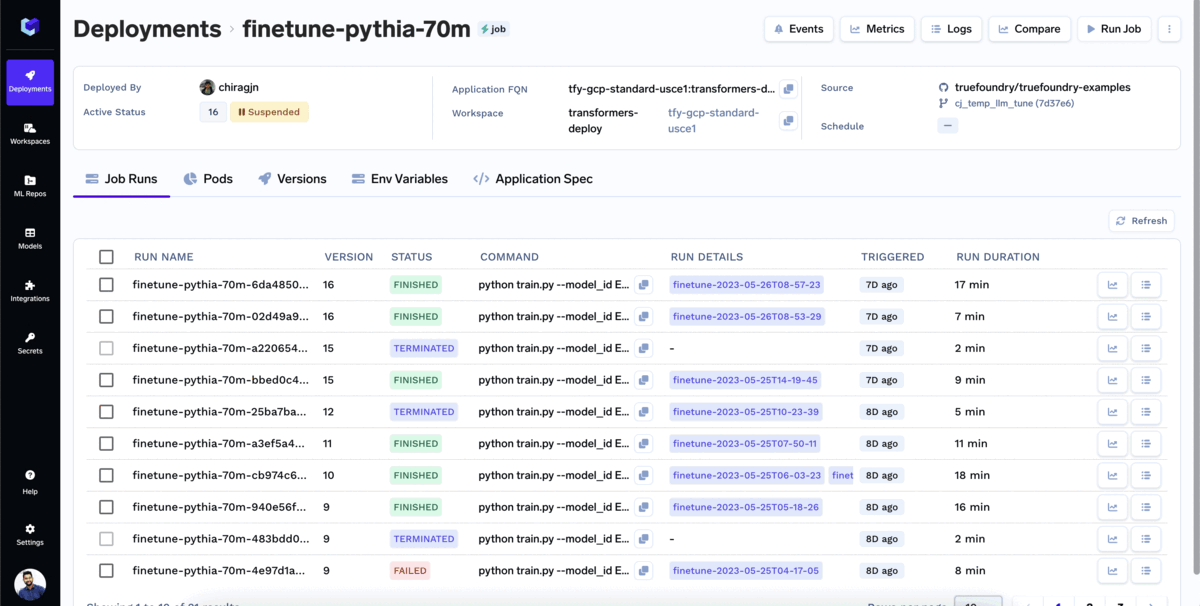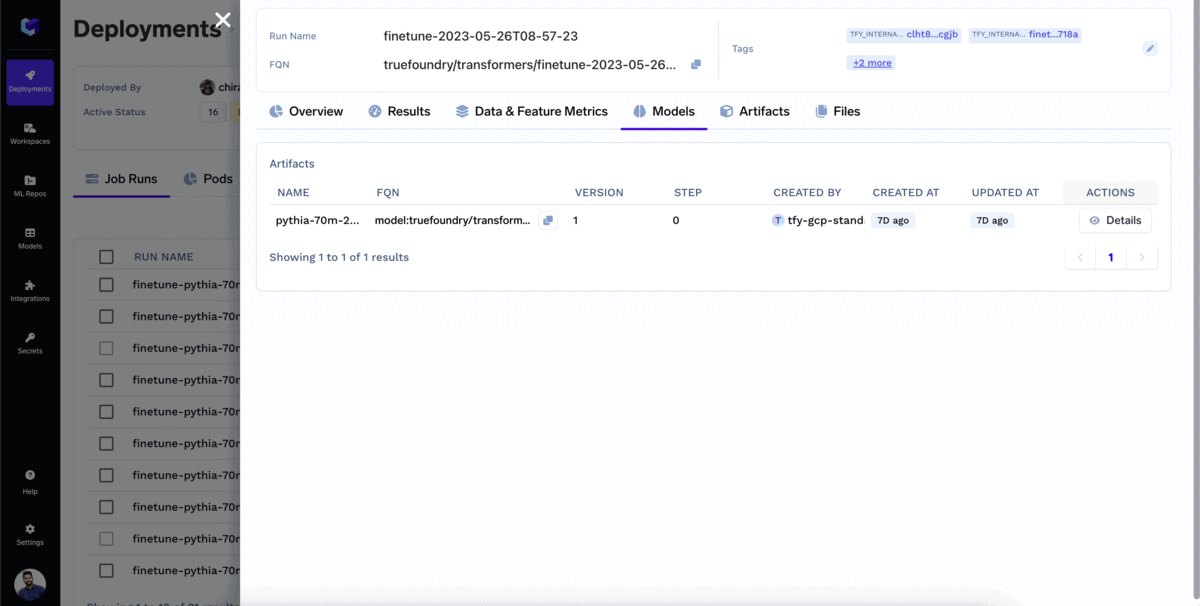
多くの企業は、自社の特定のユースケースに合わせてファインチューニングされたモデルを使用したいと考えています。TrueFoundryでモデルをファインチューニングするには:
🚀
モデルのファインチューニングが開始されました!
進行中のファインチューニングをモニタリングできます。「Job runs」タブでは、損失メトリクス、トレーニング曲線、評価結果など、トレーニングジョブに関連するすべての情報を確認できます。これにより、ファインチューニングプロセスを追跡し、ジョブのパフォーマンスに基づいて適切な決定を下すことができます。
これは、大規模言語モデル(LLM)と生成AIに関する私たちの旅の始まりに過ぎません。今後、さらに多くの機能を構築していく予定ですので、ご期待ください!
私たちも他の皆様と同様、この分野について日々学習を続けています。貴社で大規模言語モデルの活用をご検討されている場合は、ぜひ情報交換をさせてください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.































