


November 17, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
Generative AIがエンタープライズワークフローの中核となるにつれ、多くの組織がAIモデルをいつ、どのように実行すべきかを再考しています。クラウドベースのサービスは利便性とスピードを提供する一方で、データプライバシー、コンプライアンス、ベンダーロックイン、長期的なコストに関する懸念も生じさせます。機密データを扱う組織や規制の厳しい業界で運営するエンタープライズにとって、オンプレミスGenAIはセキュアでコントロール可能な代替手段を提供します。企業は自社環境内で強力な言語モデル、ベクターデータベース、AIインフラストラクチャを実行できるようになります。本記事では、オンプレミスGenAIとは何か、なぜ注目を集めているのか、そしてエンタープライズグレードのデプロイを実現するプラットフォームについて解説します。

オンプレミスGenerative AIとは、大型言語モデル(LLM)、画像生成AI、マルチモーダルシステムなどのGenerative AIモデルを、組織独自のインフラストラクチャ上でデプロイ・実行することを指します。このインフラストラクチャには、オンサイトデータセンター、プライベートクラウド、ハイブリッド環境が含まれ、組織はデータフロー、モデルアクセス、システムセキュリティを完全に制御できます。
サードパーティのインフラストラクチャ上で動作するクラウドベースのGenAIソリューションとは異なり、オンプレミスデプロイはエンタープライズのファイアウォール内で機能するように設計されています。この構成により、機密データが組織の信頼できる環境から外部へ流出することを防ぎます。また、モデルのファインチューニングやカスタマイズ、内部システムとの密接な統合、GDPR、HIPAA、SOC 2などの厳格な規制基準への準拠が可能になります。
オンプレミスGenAIソリューションは、通常いくつかの主要コンポーネントで構成されます。事前学習済みまたはファインチューニングされたLLM、推論エンジン(vLLMやTGIなど)、Kubernetesのようなコンテナオーケストレーションプラットフォーム、そして検索拡張生成(RAG)のユースケースに向けたオプションのベクターデータベースです。
この構成により、エンタープライズは外部APIに依存したりクラウドプロバイダーとデータを共有したりすることなく、チャットアシスタント、要約エンジン、インテリジェント検索などのGenAI機能をデプロイできます。このアプローチは、データのプライバシーとインフラストラクチャの制御が非常に重要な医療、金融、防衛、法務サービスなどの業界にとって特に魅力的です。
オンプレミスGenAIは利便性からコントロールへのシフトを表しており、エンタープライズが必要とするコンプライアンス、セキュリティ、パフォーマンス基準を維持しながら、自社の条件に合わせてAIワークロードを拡張できる柔軟性を提供します。
Generative AIがエンタープライズのオペレーションに一層組み込まれるにつれ、多くの組織がクラウド専用のソリューションから離れ、オンプレミスデプロイを支持するようになっています。このシフトは、データ、インフラストラクチャ、および長期的なAI戦略に対するより大きなコントロールの必要性によって推進されています。
オンプレミスGenAIを選択する主な理由は、データプライバシーとコンプライアンスです。医療、金融、防衛などの業界におけるエンタープライズは、GDPR、HIPAA、CCPAなどの厳格な規制を遵守しなければなりません。クラウドベースのサービスは、データの保存場所、アクセス方法、機密情報に対する視認性に関して懸念を引き起こすことがよくあります。オンプレミスデプロイはデータを組織の環境内に保持するため、監査可能性が向上し、リスクへの露出が減少します。
もう一つの重要な要因は、カスタマイズとコントロールです。エンタープライズでは、モデルのファインチューニング、厳格な出力動作の強制、または内部システムとの統合が頻繁に求められます。オンプレミスGenAIを利用することで、組織はサードパーティのAPIや外部のリリースサイクルに依存することなく、モデルパイプラインの変更、プロンプトの動作管理、ドメイン固有の機能拡張をデプロイできます。
ベンダーロックインの回避も強いモチベーションとなります。単一のクラウドプロバイダーに排他的に依存することは、柔軟性を制限し、長期的なコストやイノベーションの制約を導入する可能性があります。オンプレミスのセットアップはフルスタックの所有権を提供し、チームは外部依存なしにコンポーネントを入れ替え、オープンソースモデルをテストし、アーキテクチャを進化させることができます。
コストの予測可能性と最適化も、評価において同様に重要です。コスト。大規模な推論ワークロードを実行する企業にとって、従量課金制の管理は困難になる可能性があります。オンプレミスインフラストラクチャでは、コストはトークンごとやリクエストごとの料金ではなくハードウェアの使用状況に連動するため、財務予測の透明性が高まります。
オンプレミスGenAIは、企業がコンプライアンスを維持し、外部サービスプロバイダーへの依存を避けながら、AIワークロードを安全、柔軟、かつコスト効率よく運用する機能を提供します。
オンプレミスで生成AIを実行するには、パフォーマンス、制御、スケーラビリティのバランスが取れた、優れたアーキテクチャのスタックが必要です。以下は、エンタープライズ環境内にGenAIシステムをデプロイするために必要な主要なインフラストラクチャコンポーネントです。
これらのコンポーネントが組み合わさることで、堅牢でスケーラブルなオンプレミスGenAIデプロイメントの基盤が形成されます。
オンプレミスGenAIは優れた制御性とデータセキュリティを提供しますが、企業が慎重に計画しなければならない固有の課題も伴います。これらの課題は、インフラストラクチャ、スケーラビリティ、運用、メンテナンスに及びます。
ハードウェアの調達とセットアップ: GPUや専用AIアクセラレータの調達とメンテナンスには時間とコストがかかる場合があります。NVIDIA A100やH100のようなハイエンドハードウェアのリードタイムは数ヶ月に及ぶことがあり、冷却、電力、ラック用のスペースのセットアップによって複雑さが増します。
インフラストラクチャとDevOpsの複雑さ: オンプレミスで大規模モデルを実行するには、コンテナオーケストレーション、GPUスケジューリング、ネットワーキング、リソース制限の管理が必要です。専任のDevOpsまたはMLOpsチームがない場合、特に利用が増加するにつれて、稼働時間とスケーラビリティの確保がボトルネックになる可能性があります。
スケーリングと負荷管理: クラウドプラットフォームと比較して、オンプレミス環境ではオートスケーリングがより複雑です。企業はピーク時の負荷シナリオを計画し、バッファ容量を組み込む必要がありますが、適切に最適化されない場合、稼働率の低下やコストの増加につながる可能性があります。
モデル管理とバージョニング: 異なるチームやユースケース向けに複数のモデルをホストするには、バージョン管理、ロールバックサポート、安全なアクセス制御が必要です。適切なツールがないと、モデルの無秩序な拡散(モデルスプロール)が発生し、デプロイパイプラインの不安定さや非効率につながる可能性があります。
モニタリングとトラブルシューティング: ボトルネック、レイテンシースパイク、メモリの問題を特定するには、リアルタイムのモニタリングツールが必要です。堅牢な Observability(可観測性)が確立されていない場合、パフォーマンス問題の診断はプロアクティブ(事前対応型)ではなくリアクティブ(事後対応型)になってしまいます。
これらの課題があるにもかかわらず、多くの企業は最初から適切なツール、プラットフォーム、運用プラクティスに投資することで、GenAI のオンプレミスデプロイを正常に実現しています。
GenAIワークロードをオンプレミスで正常にデプロイおよび管理するには、適切なプラットフォームの選択が不可欠です。これらのプラットフォームは、インフラストラクチャ、オーケストレーション、モデルサービングの複雑さを抽象化するのに役立ちます。以下は、安全で拡張性が高く、カスタマイズ可能なオンプレミスGenAIデプロイメント向けに構築された主要なソリューションです。

TrueFoundryは、クラウド環境およびオンプレミス環境全体でAIおよびGenAIワークロードのデプロイ、推論、スケーリングを効率化するために設計された、エンタープライズグレードのKubernetesネイティブプラットフォームです。堅牢なAI Gateway、最適化されたモデルサービング層、フルスタックMLOps統合を提供することで、LLMインフラストラクチャ管理の複雑さを抽象化します。
デベロッパーファーストの考え方で構築されたTrueFoundryにより、MLチームおよびプラットフォームチームは、コンピューティングインフラストラクチャの管理ではなく、モデルの構築と最適化に集中できます。vLLMやText Generation Inference(TGI)などの主要な推論フレームワークとシームレスに統合され、非常に高速でトークン効率の高いLLMデプロイメントをサポートします。
主な機能:
統合AI Gateway:一貫したOpenAI互換API層を使用して、250以上のオープンソースおよびプロプライエタリLLMを提供します。統合コードを変更することなく、マルチモデルルーティングを介してLLaMA 2、Mistral、Mixtral、Claude、GPTなどのモデル間を切り替えることができます。
Kubernetesネイティブアーキテクチャ:ネイティブのKubernetesオーケストレーションを使用して、AWS、GCP、Azure、オンプレミスなど、あらゆる環境でLLM推論ワークロードを自動的にスケーリングします。宣言型インフラストラクチャ管理のためのHelmベースのGitOpsサポートが標準で組み込まれています。
大規模推論向けに最適化:TrueFoundryはvLLMとネイティブに統合され、400ms未満のレイテンシを実現し、GPUあたり100人以上の同時ユーザーを処理します。混合精度、量子化、バッチ処理が標準でサポートされており、トークンあたりのコストを削減します。
完全な可視性と制御:リアルタイムのトークンレベルのアナリティクス、レイテンシメトリクス、レート制限、自動ロードバランシングにより、エンジニアリングチームは本番推論を完全に把握および制御できます。
プロンプト&バージョン管理:プラットフォーム内でプロンプトを直接管理、バージョン管理、テストできます。A/Bテストとロールバックサポートを有効にして、迅速な反復と実験を可能にします。
セキュリティ&コンプライアンス:ビルトインのRBAC、暗号化通信、SOC2準拠のプラクティスを備えたVPCまたはオンプレミスにLLMをデプロイできます。モデルデータやプロンプトデータがインフラストラクチャの外に出ることはありません。

NVIDIA Enterprise AIは、エンタープライズ環境で拡張性の高いAI、機械学習、生成AIワークロードを推進するために構築された、ソフトウェアとGPUアクセラレーションインフラストラクチャのフルスタック・スイートです。ハイブリッドおよびオンプレミスデプロイメント向けに設計されており、パフォーマンス、セキュリティ、サポートのために最適化されたソフトウェア層であるNVIDIA AI Enterpriseを使用して、NVIDIA認定システム上でLLM、コンピュータービジョン、予測分析を含む最先端のAIを実行できるようにします。
プライベートデータセンターにモデルをデプロイする場合でも、ハイブリッドクラウドインフラストラクチャにデプロイする場合でも、NVIDIA Enterprise AIを使用すると、企業はネットワーク外にデータを送信することなく、安全で低レイテンシのAIアプリケーションを構築できます。完全なデータ主権を備えたオンプレミスAIを必要とするヘルスケア、金融、製造などの業界に最適です。
主な機能

Red Hat OpenShift AI(旧Red Hat OpenShift Data Science)は、組織がハイブリッドクラウド環境全体でAI/MLモデルを構築、トレーニング、デプロイ、監視できるようにするエンタープライズ対応のMLOpsプラットフォームです。OpenShiftを介したKubernetes上に構築されており、モデル開発と本番環境のための完全に統合された環境を提供し、オンプレミス、クラウド、エッジ環境へのデプロイメントの柔軟性を備えています。
OpenShift AIは、オープンソースツールとエンタープライズサポートを統合し、データサイエンティスト、MLエンジニア、DevOpsチーム間のシームレスなコラボレーションを可能にします。カスタムモデルに加えて、オープンソースおよび商用LLMとの統合をサポートし、機密性の高いワークロードに対して安全でコンプライアンスに準拠したインフラストラクチャを提供します。
主な機能

Rayは、LLMのトレーニングから高スループットでのサービングまで、AIアプリケーションの構築とデプロイのために設計された、拡張可能な分散コンピューティングフレームワークです。完全にオンプレミスにデプロイできるため、インフラストラクチャの完全な制御を必要とする組織にとって最適な選択肢となります。
Rayは、vLLM、DeepSpeed、Hugging Face Transformersなどの現代のAIスタックを駆動し、Ray Serveを介して拡張可能な推論をサポートします。KubernetesおよびGPUスケジューリングのネイティブサポートにより、LLMOpsワークロード用にプライベートデータセンターでRayクラスタを安全に実行できます。
主な機能:

IBM Watson AIは、信頼、透明性、ガバナンスを強く重視して、企業が人工知能をワークフローに統合できるように設計されたAIサービスおよびツールのスイートです。現在はIBM watsonxの一部であり、モデルの構築とチューニングのためのwatsonx.ai、拡張可能なデータ管理のためのwatsonx.data、ライフサイクル全体で責任あるAIの利用を保証するためのwatsonx.governanceが含まれています。
Watson AIは、IBM Cloud Pak for DataおよびRed Hat OpenShiftを使用してハイブリッドクラウドおよびオンプレミス環境用に最適化されており、企業にデータとモデルデプロイメントの完全な制御を提供します。基盤モデル、カスタムモデルのファインチューニング、オープンソースLLMとの統合をサポートし、すべてエンタープライズSLAによってバックアップされています。
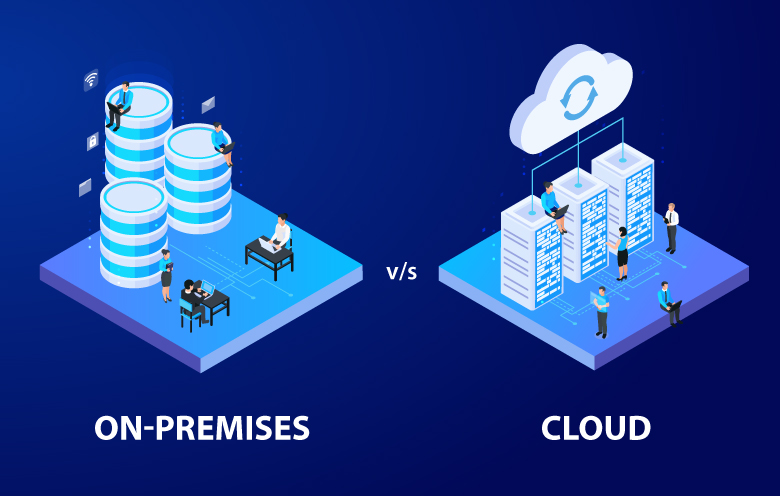
オンプレミスGenAIは、インフラストラクチャ、モデル、データを完全に制御することを企業に提供します。GDPRやHIPAAなどのプライバシー標準への準拠が不可欠である、ヘルスケア、金融、政府機関など、規制の厳しい業界で運営されている組織にとって好ましい選択肢です。オンプレミスデプロイメントにより、チームは機密データを自社環境内に保持し、モデルの動作をカスタマイズし、長期的なコスト予測可能性のためにインフラストラクチャを最適化できます。初期設定にはより多くの労力と投資が必要になる場合がありますが、より大きな柔軟性、監査可能性、内部システムとの統合が実現します。
一方、クラウドGenAIは、スピード、拡張性、利便性を提供します。インフラストラクチャ管理を心配することなく、チームがAIアプリケーションを迅速にプロトタイプ化しデプロイすることを可能にします。クラウドプロバイダーがオートスケーリング、ハードウェアプロビジョニング、モデルアップデートを処理するため、より迅速な市場投入が可能になります。ただし、データ居住地、ベンダーロックイン、予測不可能な従量課金制価格設定に関する懸念が生じる可能性があります。多くの組織にとって、この選択はコンプライアンスのニーズと運用の敏捷性のバランスをとることに帰着します。
結論として、オンプレミスの生成AIは、もはや規制業界のためだけの代替手段ではありません。データ主権、インフラストラクチャ制御、長期的スケーラビリティを必要とする企業にとって、急速に戦略的優位性となりつつあります。TrueFoundry、NVIDIA Enterprise AI、Red Hat OpenShift AI、IBM Watson AI、Rayなどのソリューションは、自社のインフラストラクチャ内で完全にGenAIモデルを構築し提供するための、強力で本番グレードの機能を提供します。
AIシステムがより複雑化し、データの機密性が高まる中、オンプレミスデプロイメントは将来を見据えた基盤を提供します。これにより、企業や組織は自信を持ってイノベーションを推進し、コンプライアンスを遵守しながら、モデルとデータの両方に対して完全な所有権を維持できるようになります。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























