


novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.




Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
50 questions à poser à chaque fournisseur en 2026
Les évaluations de plateformes d'IA d'entreprise échouent de manière prévisible. La démo du fournisseur s'exécute avec une invite de test soigneusement préparée. Leur diapositive de prix utilise des hypothèses de 5 000 jetons par appel qui ne correspondent pas à votre charge de travail réelle. Le diagramme d'architecture de sécurité qu'ils présentent concerne un mode de déploiement que vous n'avez pas demandé. La capacité MCP qu'ils affirment être disponible « dans notre prochaine version ». Six semaines plus tard, vous signez un contrat pour un produit qui correspond à 70 %, et votre équipe plateforme passe la durée du contrat à combler les 30 % restants avec du travail personnalisé.
Une demande de propositions notée change la dynamique. Chaque fournisseur répond aux mêmes questions, par écrit, avant toute démonstration. Leurs non-réponses (une question évitée, une capacité qui « nécessite notre partenaire d'intégration », une allégation de conformité qui ne résiste pas à une question de portée) apparaissent dans le dossier écrit où elles ne peuvent pas être reformulées lors d'un appel de suivi. Ce même dossier tient le fournisseur responsable lorsque la réalité post-signature commence à diverger du discours pré-signature, ce qui est la plainte d'approvisionnement la plus courante lors du renouvellement de la première année.
Trois éléments poussent ce modèle au-delà de ce que les cadres génériques d'approvisionnement d'entreprise couvrent déjà. Gouvernance MCP, la pile de protocoles que vos agents IA utiliseront pour communiquer avec les outils, là où la plupart des produits de passerelle IA ajoutent encore des contrôles d'accès pour lesquels ils n'ont pas été conçus. Contrôles d'IA agentique, la corrélation des traces, l'attribution des coûts et les limites d'isolation qui transforment une tâche d'agent en plusieurs étapes en une unité débogable, facturable et gouvernable, au lieu d'un brouillard d'appels LLM déconnectés. Conformité spécifique à l'IA, y compris la parité des champs de journal d'audit entre les invocations de LLM et d'outils, des réponses structurées sur la résidence des données qui tiennent compte du routage des fournisseurs de modèles à travers les régions, et les contrôles architecturaux BAA qui rendent l'application de la HIPAA réelle plutôt qu'une simple formalité administrative.
Utilisez ceci comme point de départ. Ajustez les pondérations à votre environnement. Envoyez le même document à chaque fournisseur de votre liste restreinte. L'équipe de solutions de TrueFoundry est prête à répondre aux 50 questions par écrit avec des preuves dans le cadre de l'évaluation formelle de l'entreprise.
Passons maintenant aux questions elles-mêmes.
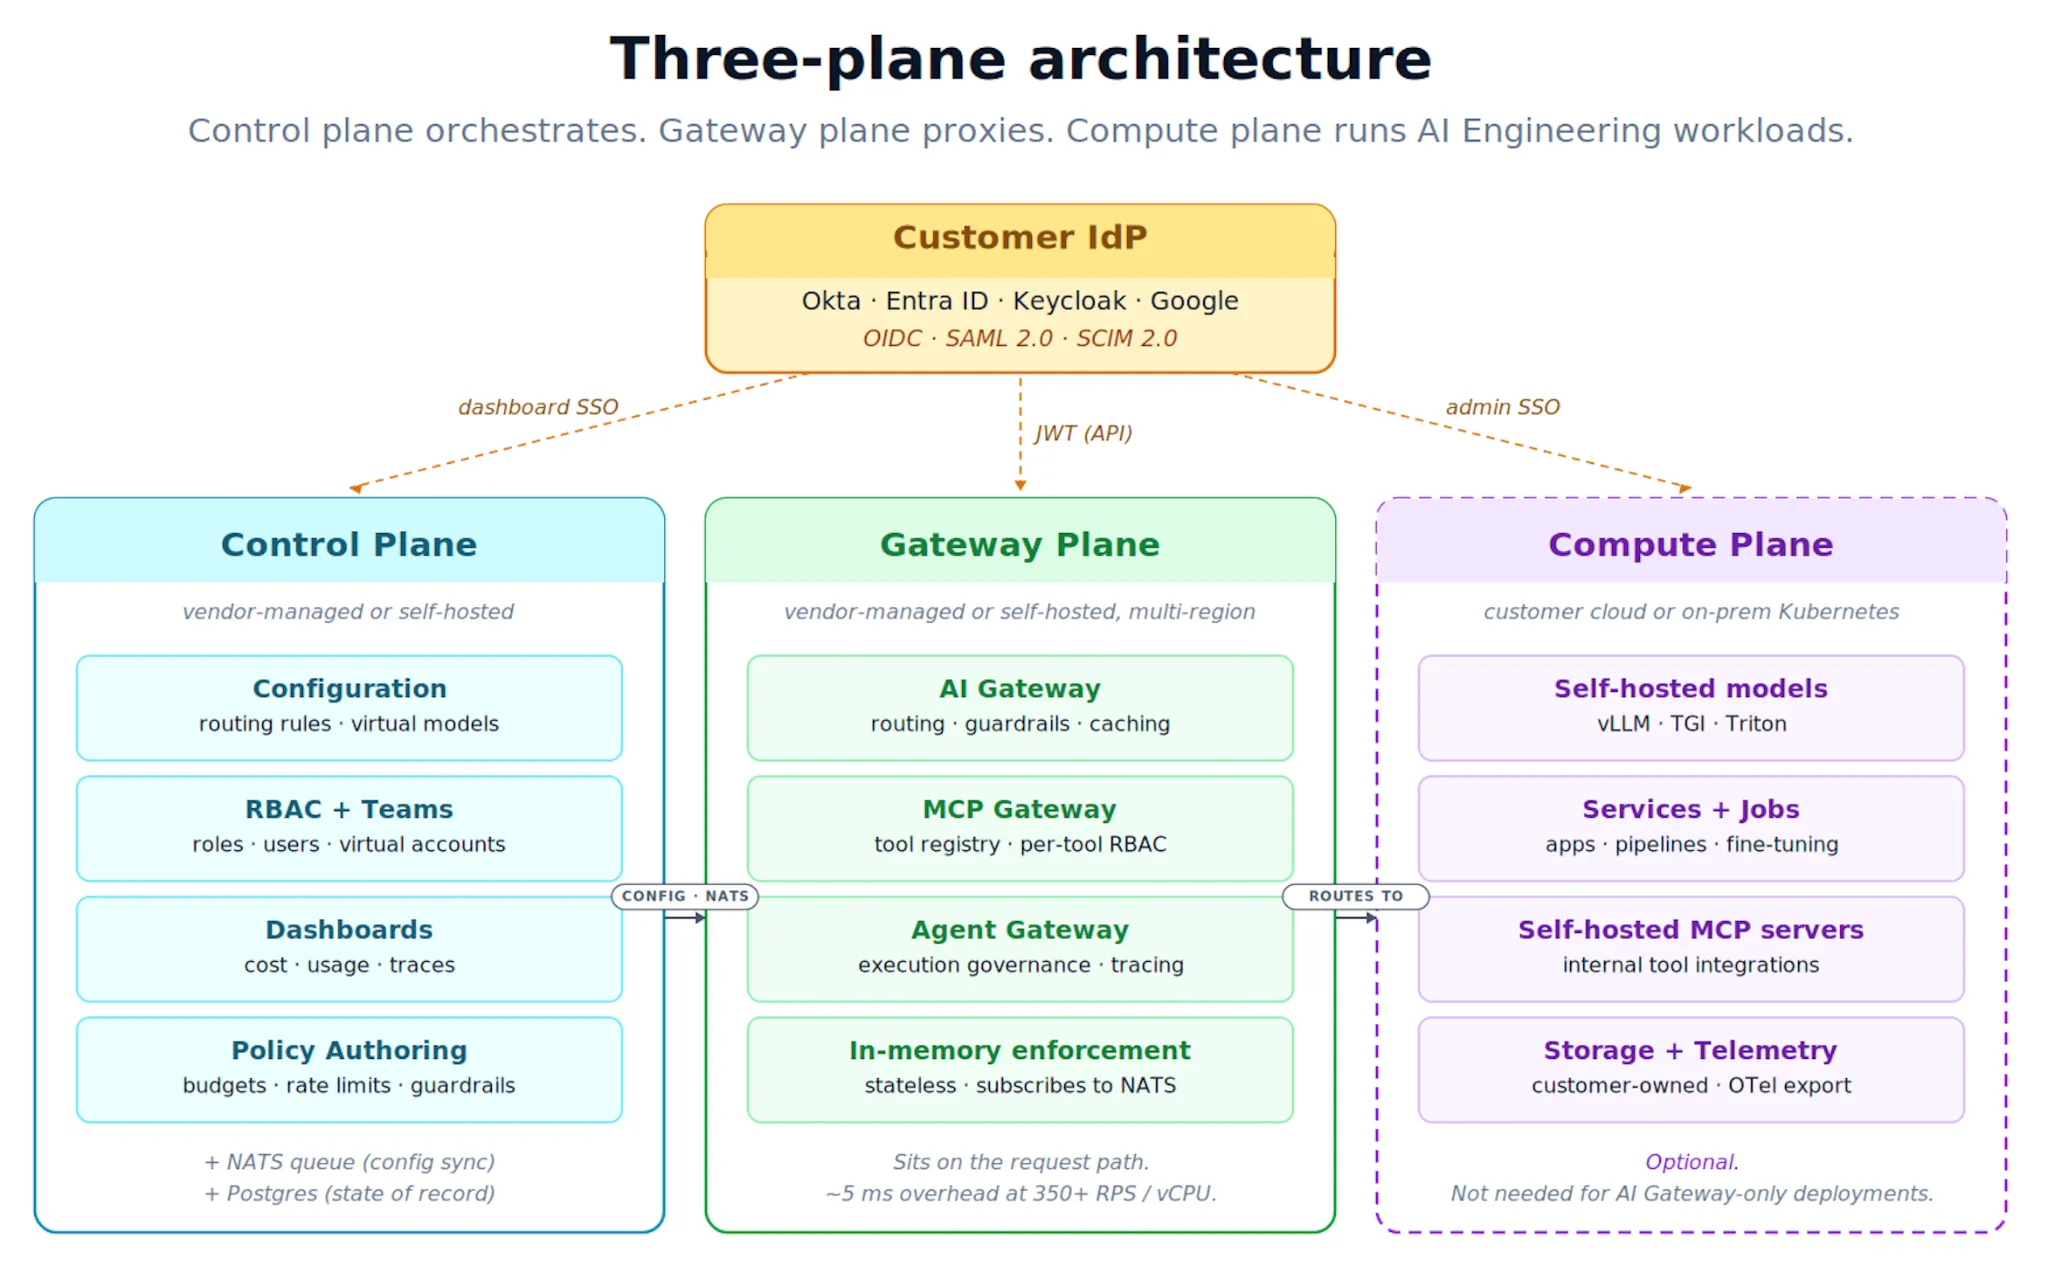
Figure 1. Architecture de référence à plans séparés : plan de contrôle et plan de calcul séparés par une limite de métadonnées uniquement, avec un seul IdP alimentant l'identité dans les deux.
L'ordre des opérations est plus important que les questions elles-mêmes. La plupart des évaluations échouées sautent la première étape : obtenir des réponses écrites au modèle complet avant qu'un fournisseur ne soit autorisé à faire une démonstration. Les démonstrations servent à vérifier les affirmations écrites, et non à la découverte. Si la première communication d'une fonctionnalité par un fournisseur provient d'une diapositive, vous leur avez cédé le contrôle du récit de l'évaluation.
Envoyez le modèle à chaque fournisseur de votre liste restreinte simultanément, avec une date limite de réponse écrite dans deux semaines. Utilisez les réponses pour noter selon une grille pondérée. Ce n'est qu'après la notation que vous réservez des démonstrations, et lors de ces démonstrations, le travail de votre équipe plateforme est de vérifier que ce qui est écrit correspond à ce qui fonctionne. Traitez toute affirmation qui apparaît lors de la démonstration mais qui ne figurait pas dans la réponse écrite comme une découverte à investiguer, et non comme une fonctionnalité à noter positivement.
Quelques précisions pour une bonne exécution :
Si vous avez déjà participé à un examen de sécurité où la portée de la conformité du fournisseur ne couvrait que l'option SaaS que vous ne comptiez pas utiliser, vous connaissez le coût d'ignorer l'étape de la grille d'évaluation. Un appel d'offres noté fait ressortir ce détail avant le contrat.
La sécurité et la conformité sont les points où la plupart des évaluations de plateformes IA échouent lors de la deuxième réunion. Non pas parce que les fournisseurs manquent de certifications. La plupart ont un SOC 2 Type II quelque part. Le mode d'échec est l'alignement : la portée de la certification, les contrôles architecturaux qui la mettent en œuvre et le mode de déploiement que vous achetez réellement ne correspondent pas. Un SOC 2 couvrant le portail marketing du fournisseur n'apporte rien à une passerelle IA traitant des PHI sur site. Un BAA qui existe sous forme de modèle mais ne décrit pas comment les PHI sont isolées dans le plan de données est de la paperasse, pas un contrôle. Les questions ci-dessous forcent l'alignement entre la portée de la certification et la réalité architecturale, ce qui empêche les réponses « nous sommes certifiés » d'avoir un poids qu'elles ne devraient pas avoir.
L'autre mode d'échec qu'il convient de mentionner tôt : les fournisseurs qui répondent aux questions de sécurité de manière abstraite parce que leur architecture concrète est divisée entre deux produits avec des postures de contrôle différentes. Leur version sur site est pauvre en fonctionnalités et n'est pas certifiée séparément. Leur version SaaS possède les certifications mais ne correspond pas à votre environnement. Identifiez cela en posant la même question deux fois, en spécifiant le mode de déploiement à chaque fois. Si les réponses diffèrent, vous avez affaire à deux produits commercialisés comme un seul.
Notez cette section sans concession.
Un déploiement à plan divisé où le plan de données (le proxy qui gère les invites, les réponses des modèles, les embeddings, les invocations d'outils MCP) s'exécute entièrement dans le VPC du client et n'ouvre jamais de connexion sortante vers l'infrastructure du fournisseur pour les charges utiles des requêtes. Le plan de contrôle (configuration, paramètres RBAC, tableaux de bord) peut s'exécuter dans l'infrastructure du fournisseur ou du client selon le mode de déploiement, mais n'échange que des métadonnées. Les journaux d'audit, les données d'invite-réponse et les embeddings atterrissent dans un stockage d'objets blob contrôlé par le client (S3, GCS, Azure Blob), et non dans des bases de données gérées par le fournisseur. Si le « déploiement VPC » du fournisseur envoie toujours les invites à un agrégateur de journaux géré par le fournisseur, il s'agit d'un déploiement SaaS sous un emballage différent.
Vérifiez la section Description du système pour la désignation explicite des modes de déploiement couverts. Recherchez des formulations telles que « l'environnement SaaS multi-locataire hébergé dans [cloud] » par opposition à « les composants de passerelle et de plan de contrôle déployés par le client ». Si la description n'en nomme qu'un, la certification ne couvre qu'un seul. Vérifiez les critères des services de confiance couverts. La sécurité est la base, mais la disponibilité, la confidentialité et l'intégrité du traitement sont importantes pour les charges de travail IA traitant des données réglementées. Un SOC 2 ne couvrant que la sécurité n'est que la moitié de l'histoire.
La plateforme extrait les clés des fournisseurs de modèles du Vault ou du Secrets Manager du client au démarrage de la passerelle ou à la demande, en utilisant un rôle IAM géré par le client, avec des références de clés (pas les valeurs des clés) stockées dans la configuration de la plateforme. La rotation est une opération du Vault : la clé est réécrite dans le Vault, la passerelle récupère la nouvelle valeur lors de la prochaine lecture ou à un intervalle de rafraîchissement configurable. La plateforme ne persiste jamais les clés des fournisseurs au repos. Si la réponse du fournisseur est « vous téléchargez les clés dans notre interface d'administration et nous les stockons chiffrées », il s'agit d'un modèle de sécurité différent (et plus faible). Les clés se trouvent alors dans l'infrastructure du fournisseur, même dans un déploiement « VPC ».
{
  "event_type": "llm_inference",
  "timestamp": "2026-04-28T14:22:31.482Z",
  "request_id": "req_01H8X2YZ...",
  "trace_id": "4bf92f3577b34da6a3ce929d0e0e4736",
  "user": {
    "id": "u_4821",
    "email": "[email protected]",
    "team": "applied-ml"
  },
  "application": {
    "id": "app_chat_support",
    "env": "prod"
  },
  "model": {
    "provider": "anthropic",
    "id": "claude-sonnet-4-6",
    "version": "20260217"
  },
  "tokens": {
    "input": 1842,
    "output": 619,
    "cached": 1200
  },
  "latency_ms": {
    "ttft": 312,
    "total": 2180
  },
  "cost_usd": 0.01443,
  "policy": {
    "guardrails_evaluated": [
      "pii",
      "content_filter"
    ],
    "decision": "allow"
  },
  "status": "success"
}
Le journal d'invocation de l'outil MCP devrait avoir une parité de champs pour les dimensions partagées (timestamp, request_id, trace_id, user, application, latency_ms, status, policy decision) ainsi que les champs spécifiques à l'outil :
{
  "event_type": "mcp_tool_invocation",
  "timestamp": "2026-04-28T14:22:32.014Z",
  "request_id": "req_01H8X2YZ...",
  "trace_id": "4bf92f3577b34da6a3ce929d0e0e4736",
  "user": {
    "id": "u_4821",
    "email": "[email protected]",
    "team": "applied-ml"
  },
  "application": {
    "id": "app_chat_support",
    "env": "prod"
  },
  "mcp_server": {
    "id": "github-prod",
    "version": "1.4.2"
  },
  "tool": {
    "name": "github.create_issue",
    "schema_version": "v2"
  },
  "parameters_hash": "sha256:7c8b...a31e",
  "response_size_bytes": 412,
  "latency_ms": 528,
  "policy": {
    "rules_evaluated": [
      "repo_allowlist",
      "rate_limit"
    ],
    "decision": "allow"
  },
  "status": "success"
}
Notez le même trace_id sur les deux : l'appel LLM et l'invocation MCP sont corrélés à une seule requête utilisateur, ce qui concrétise la réponse à la question 8 de la Section 4. Hachez les paramètres plutôt que de les enregistrer en clair. L'enregistrement complet des paramètres présente un risque de fuite de données dans les environnements réglementés. Si l'exemple de journal MCP du fournisseur ne contient pas policy.decision, trace_id ou l'attribution d'utilisateur, la gouvernance MCP est un rapport a posteriori, et non une application.
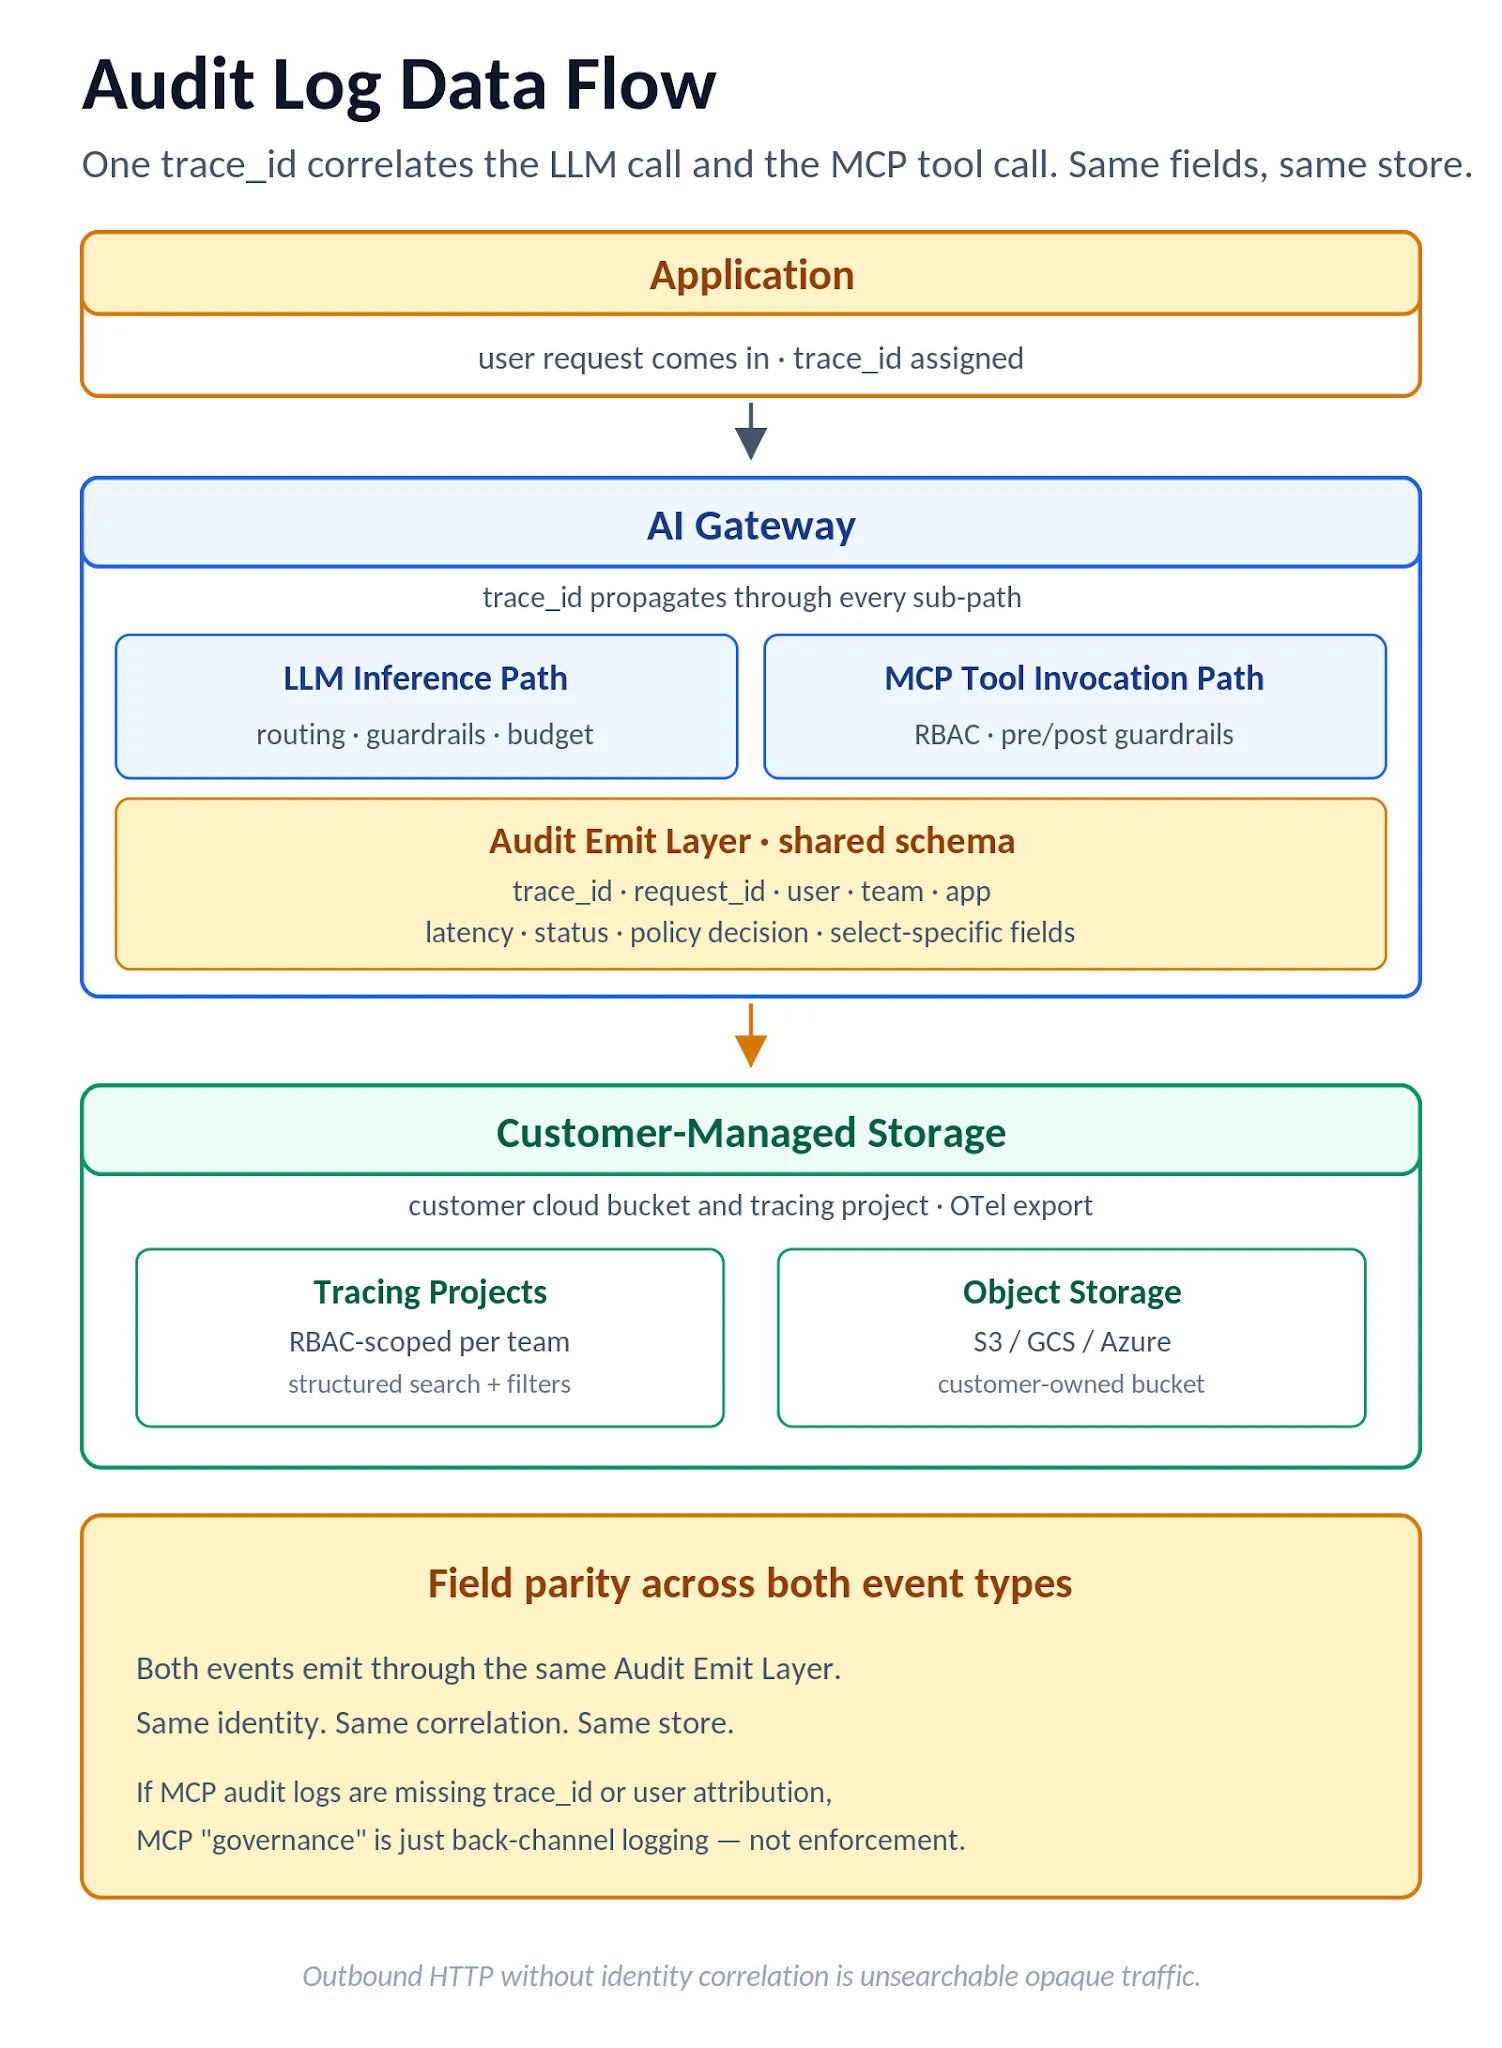
Figure 2. Flux de données des journaux d'audit : parité des champs entre les événements d'inférence LLM et les événements d'invocation d'outils MCP, tous deux corrélés par un seul trace_id.
« Chiffré au repos » est universel. La clé qui effectue le chiffrement est le véritable contrôle. Dans un déploiement auto-hébergé, les clés contrôlées par le client sont réalisables car les magasins de données se trouvent dans le compte du client ; dans un déploiement SaaS, les clés contrôlées par le client sont une capacité côté fournisseur qui doit être conçue dès le départ. Posez la question en spécifiant le mode de déploiement.
Pour les déploiements auto-hébergés, la « disponibilité des correctifs » signifie une version étiquetée que l'équipe plateforme du client peut déployer. La « fenêtre d'application par le client » est le SLA auquel le client s'engage en interne. Si le fournisseur propose une fenêtre de 30 jours pour le client pour les CVE critiques, c'est une longue période d'exposition ; insistez pour un délai plus court.
La plupart des acquisitions d'entreprise échouent au moment du déploiement. La plateforme semble excellente lors de la démo SaaS, puis l'examen de sécurité révèle trois éléments qui la bloquent : la connectivité sortante vers l'infrastructure du fournisseur pour la télémétrie, une base de données de configuration hébergée dans le cloud du fournisseur, et un plan de contrôle étroitement lié à une région de cloud spécifique. Au moment où ces contraintes deviennent visibles, vous avez déjà négocié le prix d'un mauvais produit, et la voie à suivre est soit de renégocier à partir d'une position de coût irrécupérable, soit d'accepter un déploiement qui crée une dette de conformité.
Cette section met en évidence les contraintes de déploiement dès le départ. Les fournisseurs qui peuvent y répondre clairement sont ceux qui ont déjà déployé dans des environnements similaires au vôtre. Les fournisseurs qui ont besoin d'un appel de découverte pour répondre à la Section 2 ne l'ont pas fait, et vous ferez l'ingénierie d'intégration lors de l'appel de découverte que vous leur payez.
Examinez attentivement les réponses.
┌──────────────────────────────────────────────────────┐
│  Customer VPC (one region, two AZs for HA)           │
│                                                       │
│   [ALB / NLB]                                         │
│       │                                               │
│       ├──> Gateway pods (3+ replicas, HPA enabled)    │
│       │      ↕ reads keys from                        │
│       │      [Secrets Manager / Vault]                │
│       │      ↕ writes audit + metrics to              │
│       │      [S3 / GCS / Azure Blob]                  │
│       │      ↕ reads config from                      │
│       │      [Postgres (HA, multi-AZ)]                │
│       │                                               │
│       └──> egress to: model provider APIs,            │
│                       MCP servers (in-VPC or          │
│                       allowlisted external)           │
│                                                       │
│   [Control plane endpoint]  ──> metadata only,        │
│       (vendor or self-hosted)    no payload data      │
└──────────────────────────────────────────────────────────┘
Dimensionnement d'ordre de grandeur pour ~500 RPS soutenus : 3 à 4 répliques de passerelle à 2 vCPU / 4 Go de RAM chacune, Postgres à 4 vCPU / 16 Go de RAM avec 100 Go de SSD, stockage d'objets binaires (blob storage) dimensionné en fonction de la rétention (une rétention de 90 jours à 10 Ko/entrée de journal et 500 RPS représente environ 1,2 To). Le fournisseur devrait fournir de tels chiffres par écrit avant la signature, et non « cela dépend de la charge de travail ».
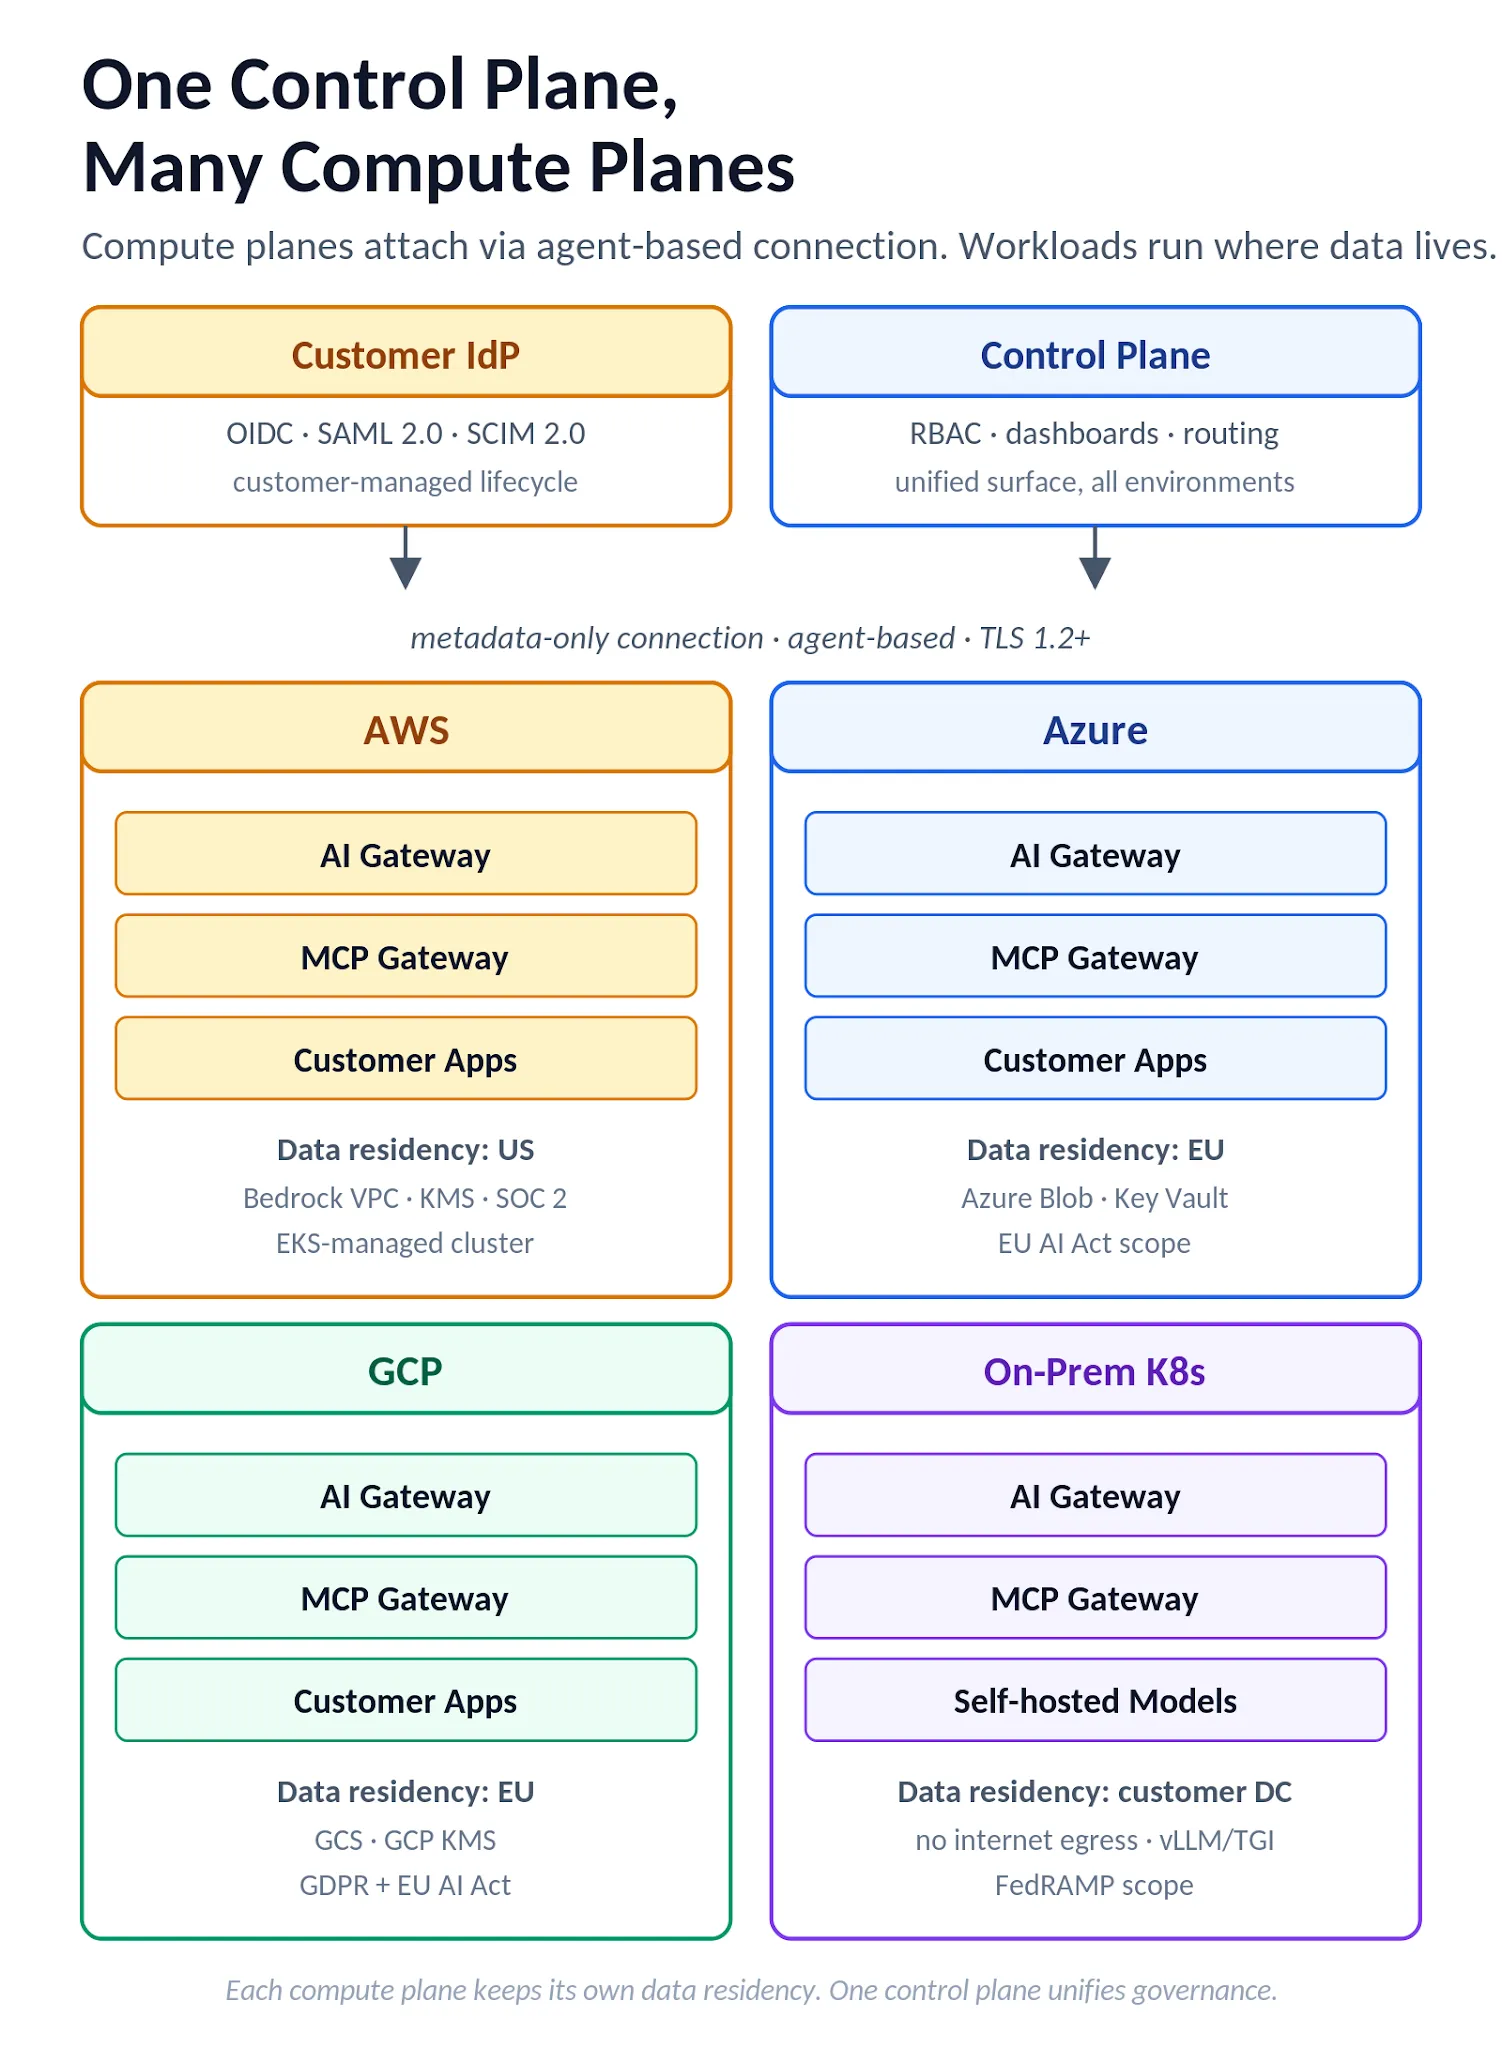
Figure 3. Un plan de contrôle gérant simultanément des plans de calcul sur AWS, Azure, GCP et Kubernetes sur site, chacun avec sa propre limite de résidence des données.
Tout ce qui est pire que cela pour une configuration de production multi-régions devrait être accompagné d'une explication écrite. « Nous ne prenons pas en charge le multi-régions » est acceptable de la part d'un petit fournisseur ; « nous le prenons en charge mais ne nous engageons pas sur le RTO » ne l'est pas.
Chaque page produit de passerelle IA se lit de la même manière : API unifiée, routage intelligent, contrôle des coûts, observabilité. Les spécificités derrière ces mots sont ce qui distingue une passerelle que vous pouvez exécuter en production d'un simple proxy avec un site marketing. Le « routage intelligent » peut signifier n'importe quoi, d'un round-robin statique entre deux modèles à une véritable politique en cascade avec des plafonds de coûts, une correspondance des capacités et des chaînes de secours. Les « contrôles des coûts » peuvent signifier un tableau de bord qui vous montre la facture d'hier, ou cela peut signifier des budgets de jetons stricts qui renvoient réellement un 429 à l'application lorsqu'une équipe atteint sa limite.
Les questions de cette section forcent à obtenir les détails. Rejetez les réponses qui se contentent de répéter le texte marketing. Le fournisseur qui dit « nous prenons en charge le routage intelligent » sans décrire le langage de règles, le comportement en cascade, la gestion des échecs et l'intégration budgétaire n'a pas de routage. Il a un simple drapeau de configuration.
Faites-leur prouver que l'architecture existe.
route: chat-support
match:
  application: app_chat_support
  team: applied-ml
strategy: cascade
cascade:
  - model: claude-sonnet-4-6
    provider: anthropic
    conditions: { max_input_tokens: 1000000 }
  - model: gpt-5.5
    provider: openai
    conditions: { fallback_on: ["rate_limit", "5xx"] }
  - model: claude-haiku-4-5
    provider: anthropic
    conditions: { fallback_on: ["all_above_failed"] }
guardrails: [pii, content_filter]
budget_ref: budget_applied_ml_q2
L'application envoie une requête standard compatible OpenAI. La passerelle choisit le fournisseur en fonction de la règle, descend la cascade en cas d'échec, associe la référence budgétaire pour l'attribution des coûts et applique les garde-fous en ligne. Aucune modification du code de l'application lorsque la route est reconfigurée. Si le « routage intelligent » du fournisseur nécessite des modifications au niveau de l'application pour chaque variante, ce n'est pas du routage au niveau de la passerelle. C'est un wrapper.
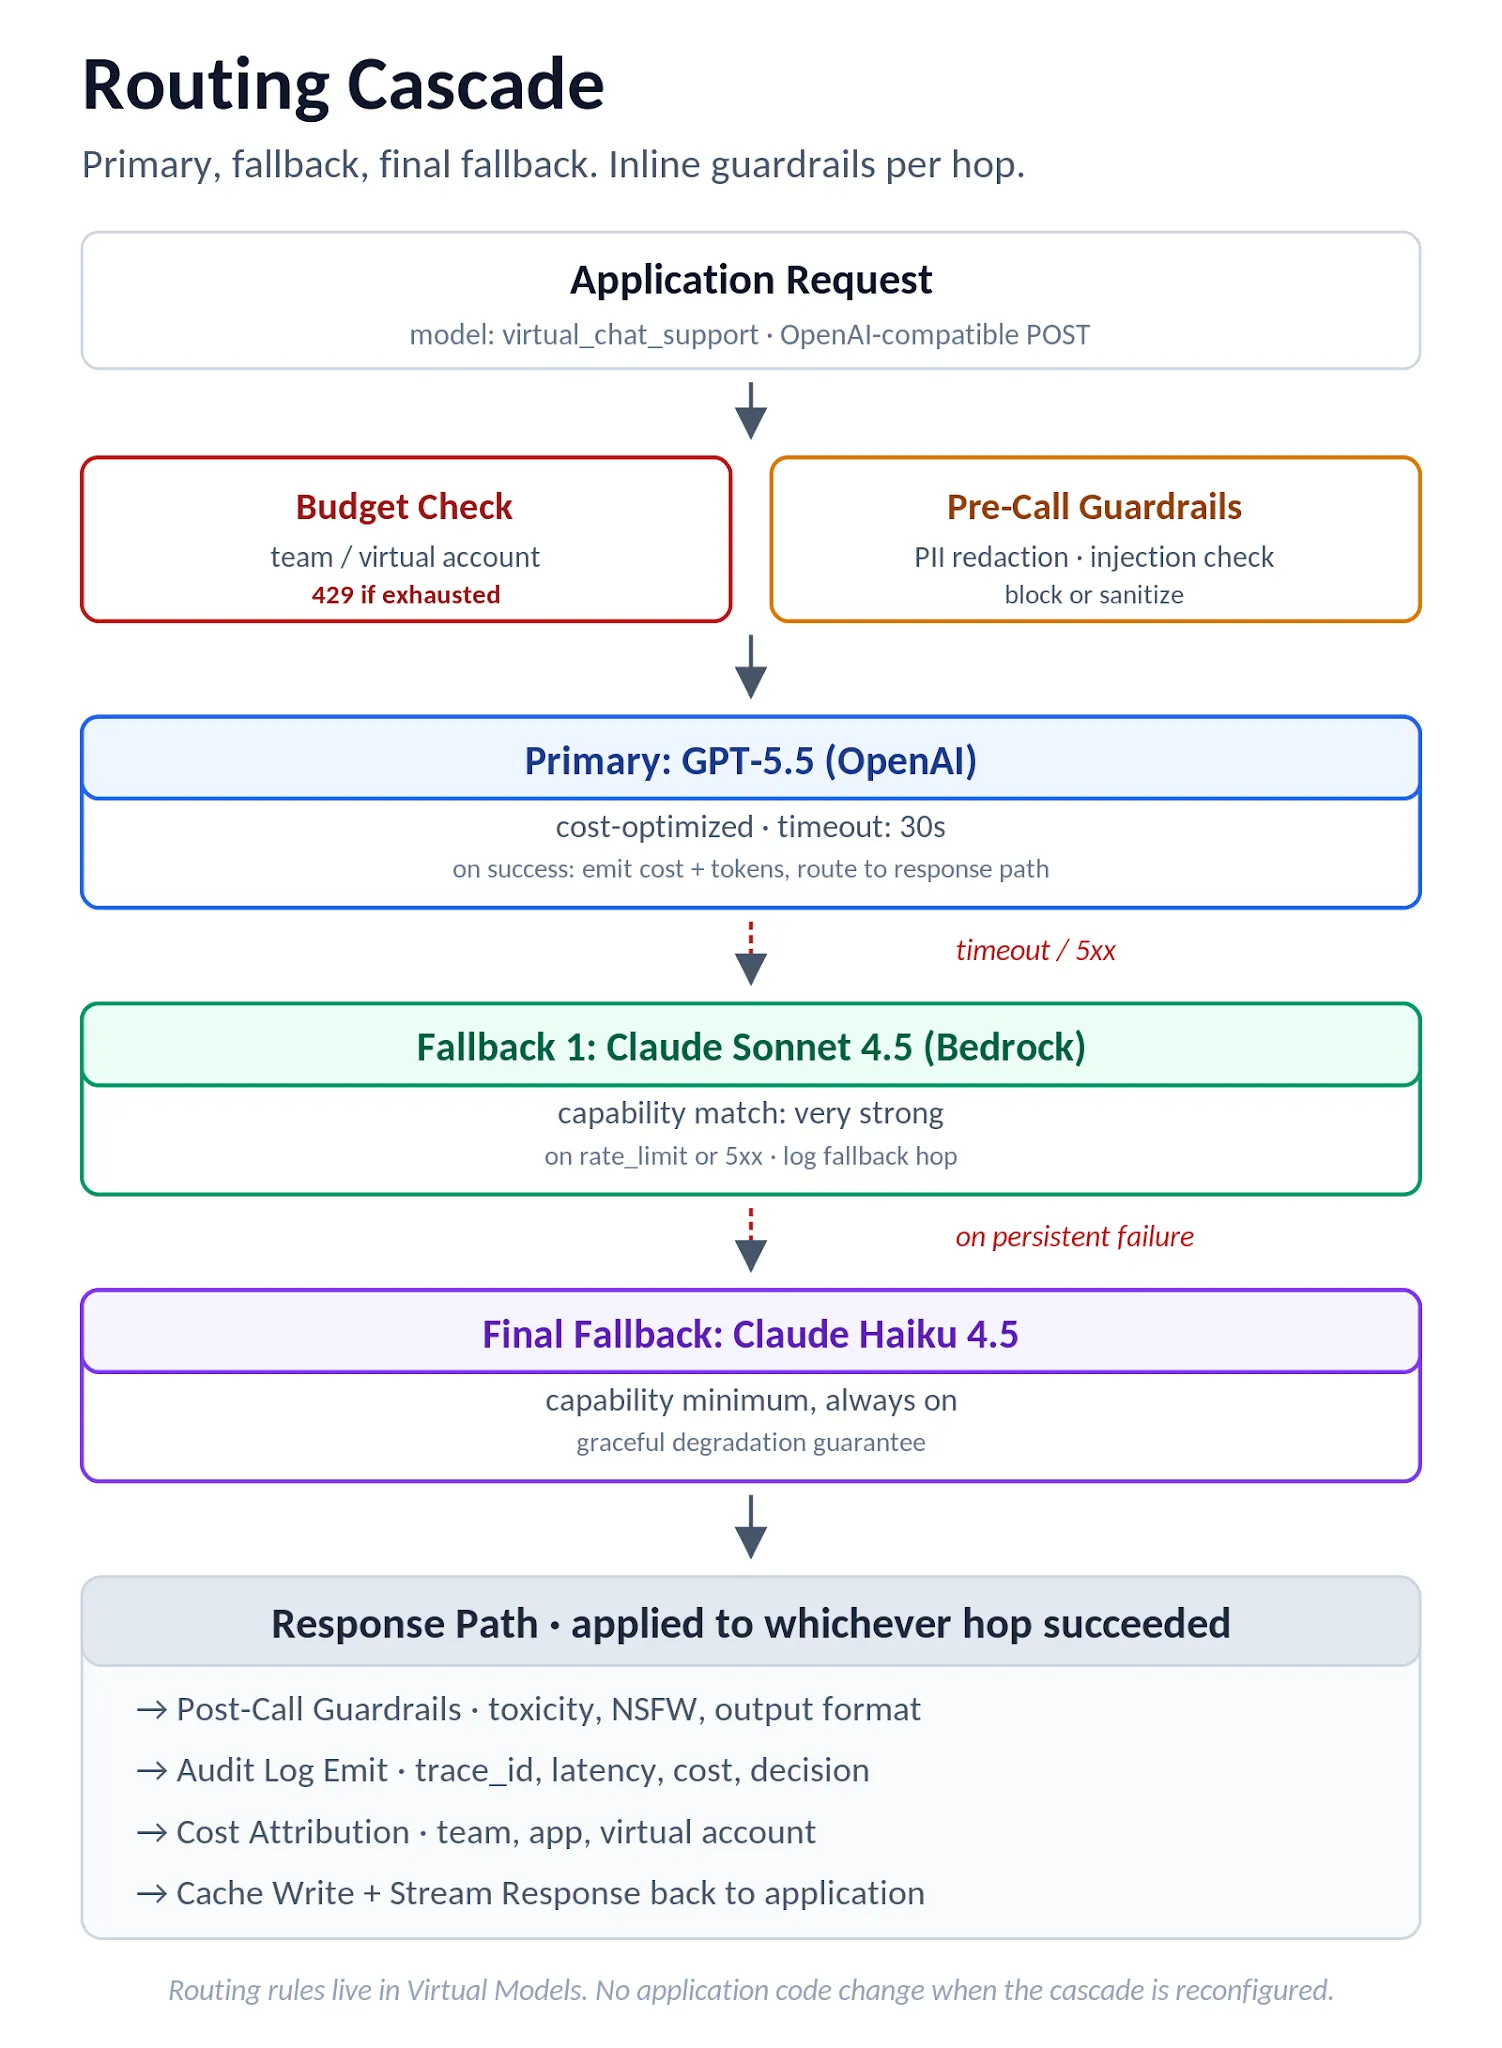
Figure 4. Flux de la cascade de routage : vérification du budget, garde-fous pré-appel, tentative de modèle principal, chaîne de repli, et un chemin de réponse unifié avec audit, coût et cache.
C'est dans cette section que la plupart des produits de passerelle IA rencontreront des difficultés, car la plupart d'entre eux ont été conçus pour l'ère des appels LLM et sont antérieurs au moment où le MCP a commencé à apparaître dans de véritables environnements d'entreprise. Le MCP n'est pas « plus d'observabilité pour les appels d'outils ». C'est un plan de gouvernance distinct : un registre de serveurs approuvés, un point d'application pour les outils que chaque rôle peut invoquer, des journaux d'audit qui correspondent aux journaux d'appels LLM en termes de couverture de champs, et un moteur de politiques qui s'exécute au moment de l'invocation plutôt que comme un rapport a posteriori. Les fournisseurs qui n'ont pas ce plan essaieront de répondre aux questions de la section 4 avec des descriptions de l'observabilité des LLM. Soyez attentif à la substitution. Plus la réponse est directe, plus la capacité est réelle.
Le modèle à attendre : un fournisseur de passerelle IA solide décrira la passerelle MCP comme une surface de produit distincte avec son propre registre, sa propre cartographie RBAC, son propre schéma de journal d'audit et son propre langage de politique. Un fournisseur plus faible la décrira comme une « observabilité étendue » par rapport à sa pile d'observabilité LLM existante, ce qui est le signe que la gouvernance est lacunaire. Évaluez spécifiquement la section 4 ; ne l'intégrez pas à la section 3.
Lisez chaque réponse pour un langage d'application directe.
policy: github-write-restriction
applies_to:
  mcp_server: github-prod
  tool_pattern: "github.*"
rules:
  - match:
      tool: github.delete_repo
    action: deny
    reason: "Destructive operations require change-management ticket"
  - match:
      tool: github.create_pr
      user.team: ["junior-engineers"]
      parameters.target_branch: "main"
    action: deny
    reason: "Direct-to-main PRs require senior-engineer approval"
  - match: {tool: "github.*"}
    action: allow
    log_level: full
Les mises à jour de cette règle devraient se propager à la passerelle en quelques secondes (poussée de configuration, pas de redéploiement). Si la réponse du fournisseur est « les politiques sont évaluées par le serveur MCP lui-même », ce n'est pas une politique appliquée par la passerelle. C'est une politique appliquée par le serveur, et vous devrez maintenir la parité des politiques sur chaque serveur MCP du catalogue. C'est un autre problème.
traceparent: 00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01
                └─ trace-id (32 hex)             └─ span-id (16 hex)
La passerelle préserve l'identifiant de trace (trace-id) à travers chaque appel en aval (fournisseur LLM, serveur MCP, saut de passerelle secondaire) en l'injectant dans les en-têtes sortants, et émet chaque appel comme une étendue (span) sous le même identifiant de trace. Dans Datadog, Grafana Tempo ou Jaeger, le résultat est une cascade unique montrant : requête utilisateur → appel LLM (claude-sonnet-4-6, 2.1s) → appel d'outil (github.create_issue, 528ms) → appel LLM (formateur de sortie, 380ms) → réponse. Sans cela, le même flux apparaît comme quatre entrées non liées et l'analyse des causes profondes devient une conjecture.
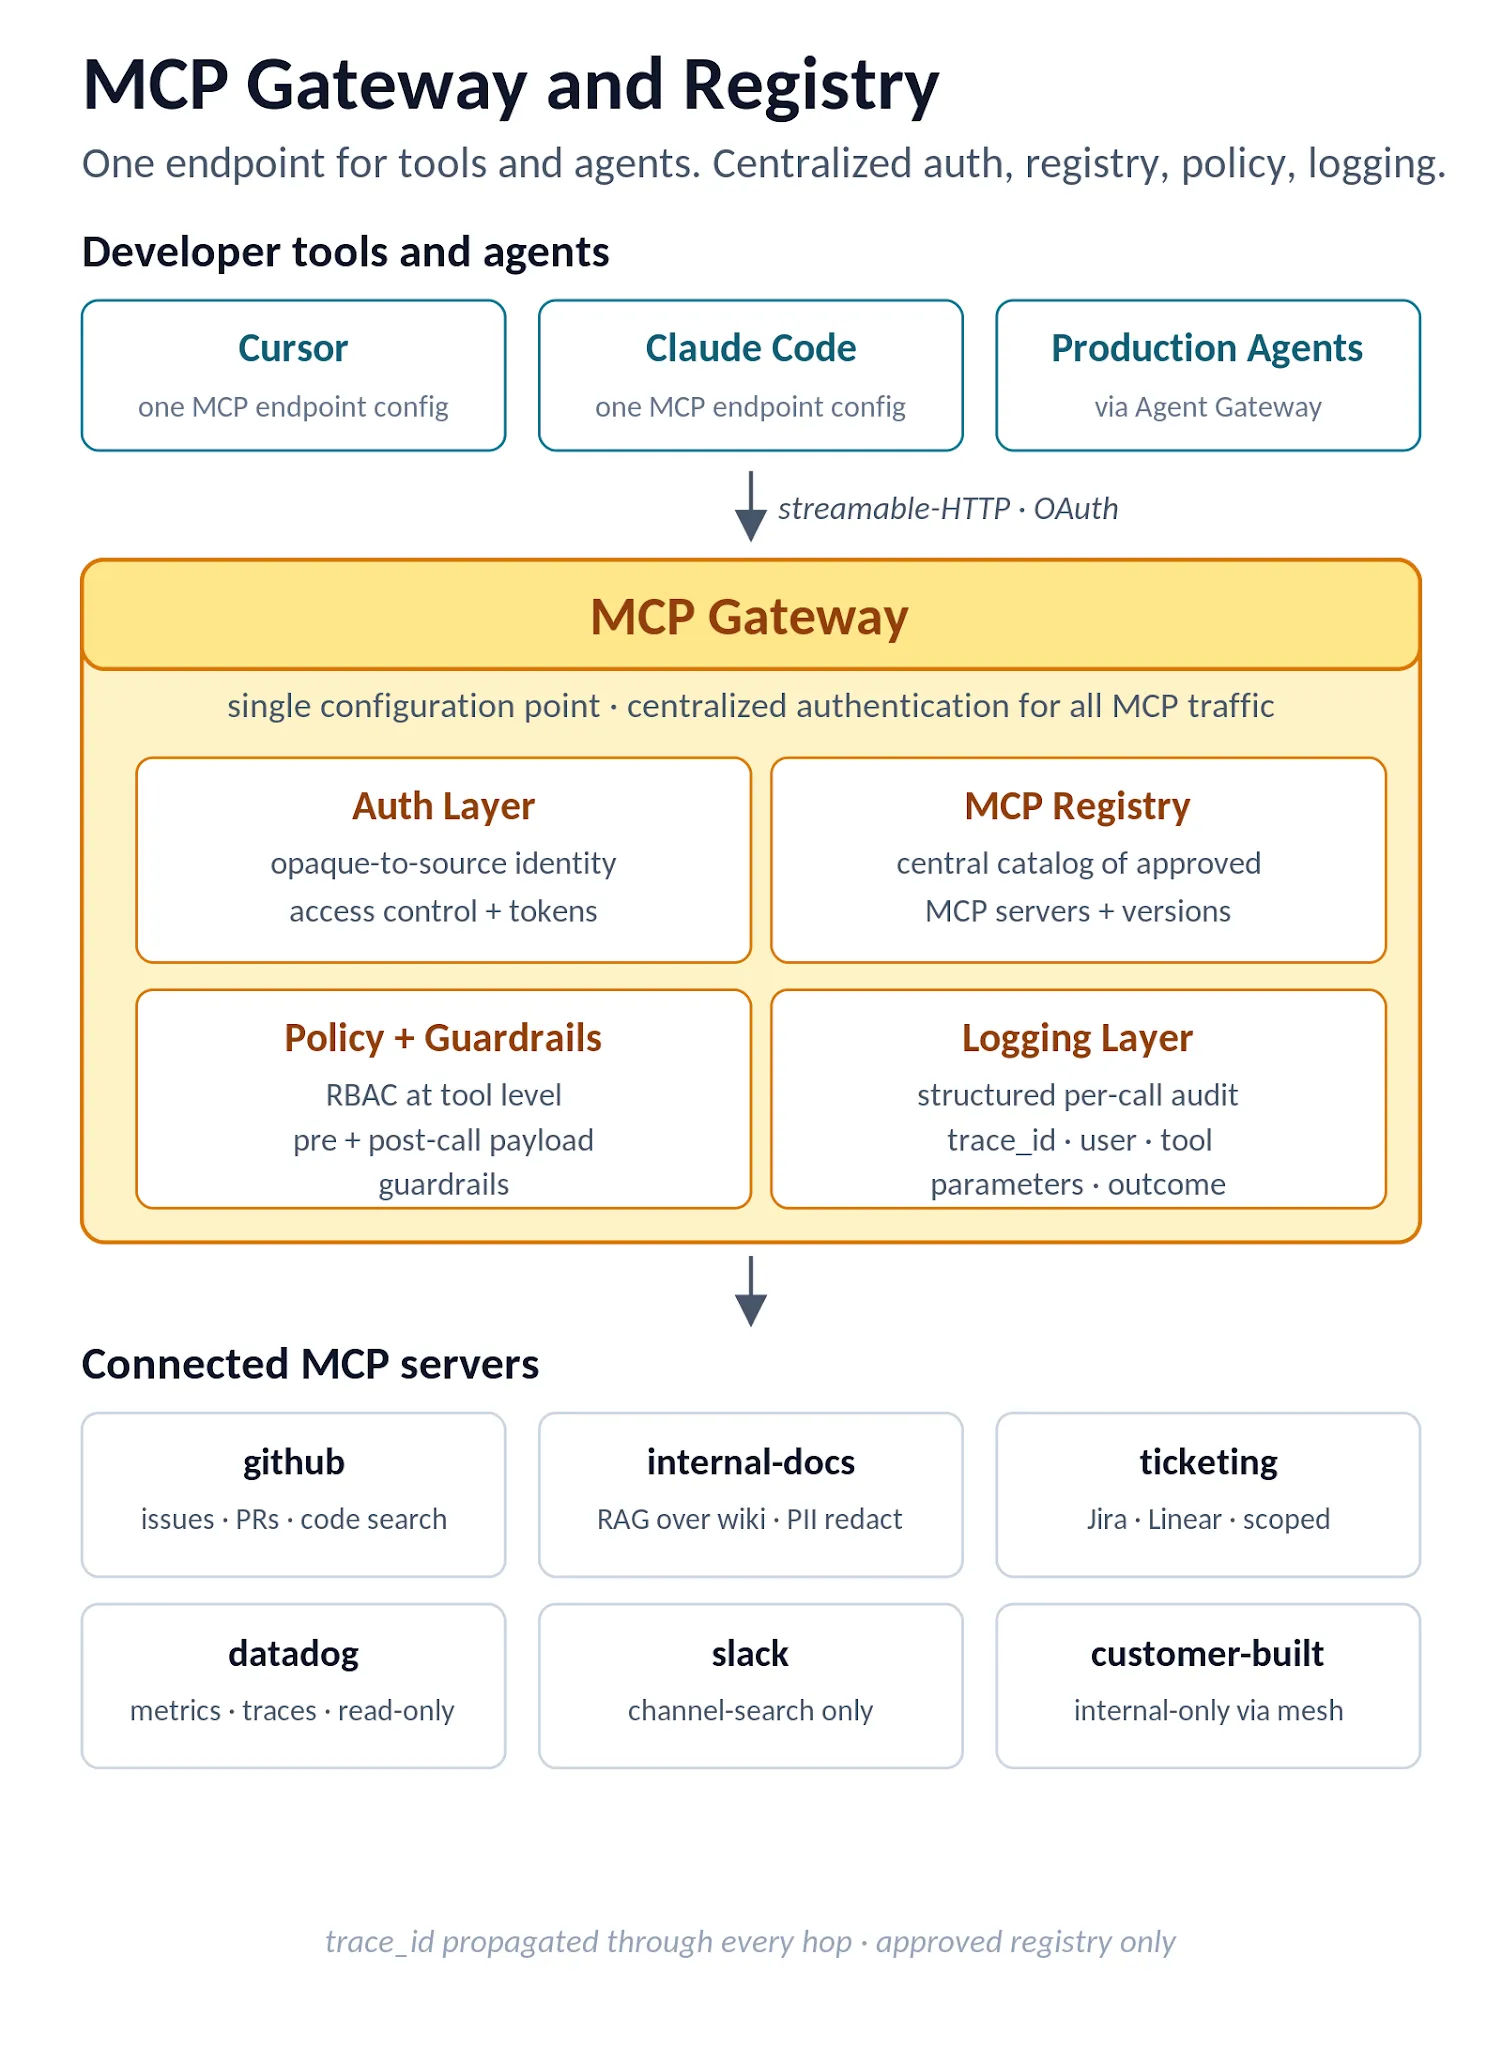
Figure 5. Architecture de la passerelle MCP : un point d'accès unique pour les outils de développement et les agents, avec des couches d'authentification, de registre, de politique et de journalisation entre les clients et les serveurs MCP.
La différence entre une plateforme d'IA qui surveille bien et une qui observe bien se manifeste dans les questions que votre équipe financière pose en fin de mois. La surveillance vous dit que la facture a augmenté de 40 %. L'observabilité vous dit que le chatbot de l'équipe marketing a commencé à boucler sur un cas limite de fenêtre de contexte il y a trois semaines, que 70 % de l'augmentation provient d'une seule application, et que les requêtes incontrôlées ont une signature spécifique que vous pouvez acheminer vers un modèle moins cher. La première réponse met la finance en colère. La seconde réponse fait de la finance un allié.
La même distinction apparaît dans le débogage des agents. La surveillance vous dit qu'une tâche d'agent a échoué. L'observabilité vous dit quel appel LLM a renvoyé une réponse malformée, quelle invocation d'outil en aval a expiré en conséquence, et à quelle requête utilisateur l'échec était lié. Sans traçage corrélé à travers les plans LLM et MCP (Section 4 question 8), chaque échec d'agent est un exercice médico-légal. Les questions ci-dessous obligent le fournisseur à décrire ce qui est réellement capturé par appel, comment il est interrogeable, et comment les données sortent de la plateforme lorsque votre système financier en a besoin.
Les spécificités comptent ici.
agent_task: trace_id 4bf92f35...
  user: [email protected] (team: applied-ml)
  initiating_request: app_chat_support, 2026-04-28 14:22:31
  duration: 4.8s
  components:
    - llm: claude-sonnet-4-6    | tokens 1842 in / 619 out  | $0.0144
    - tool: github.create_issue | latency 528ms             | n/a
    - llm: claude-haiku-4-5     | tokens 412 in / 87 out    | $0.0011
  total_cost_usd: $0.0155
  total_tokens: 2960
C'est ce qui fait de « l'attribution des coûts d'agent » un signal de qualité financière plutôt qu'une curiosité technique.
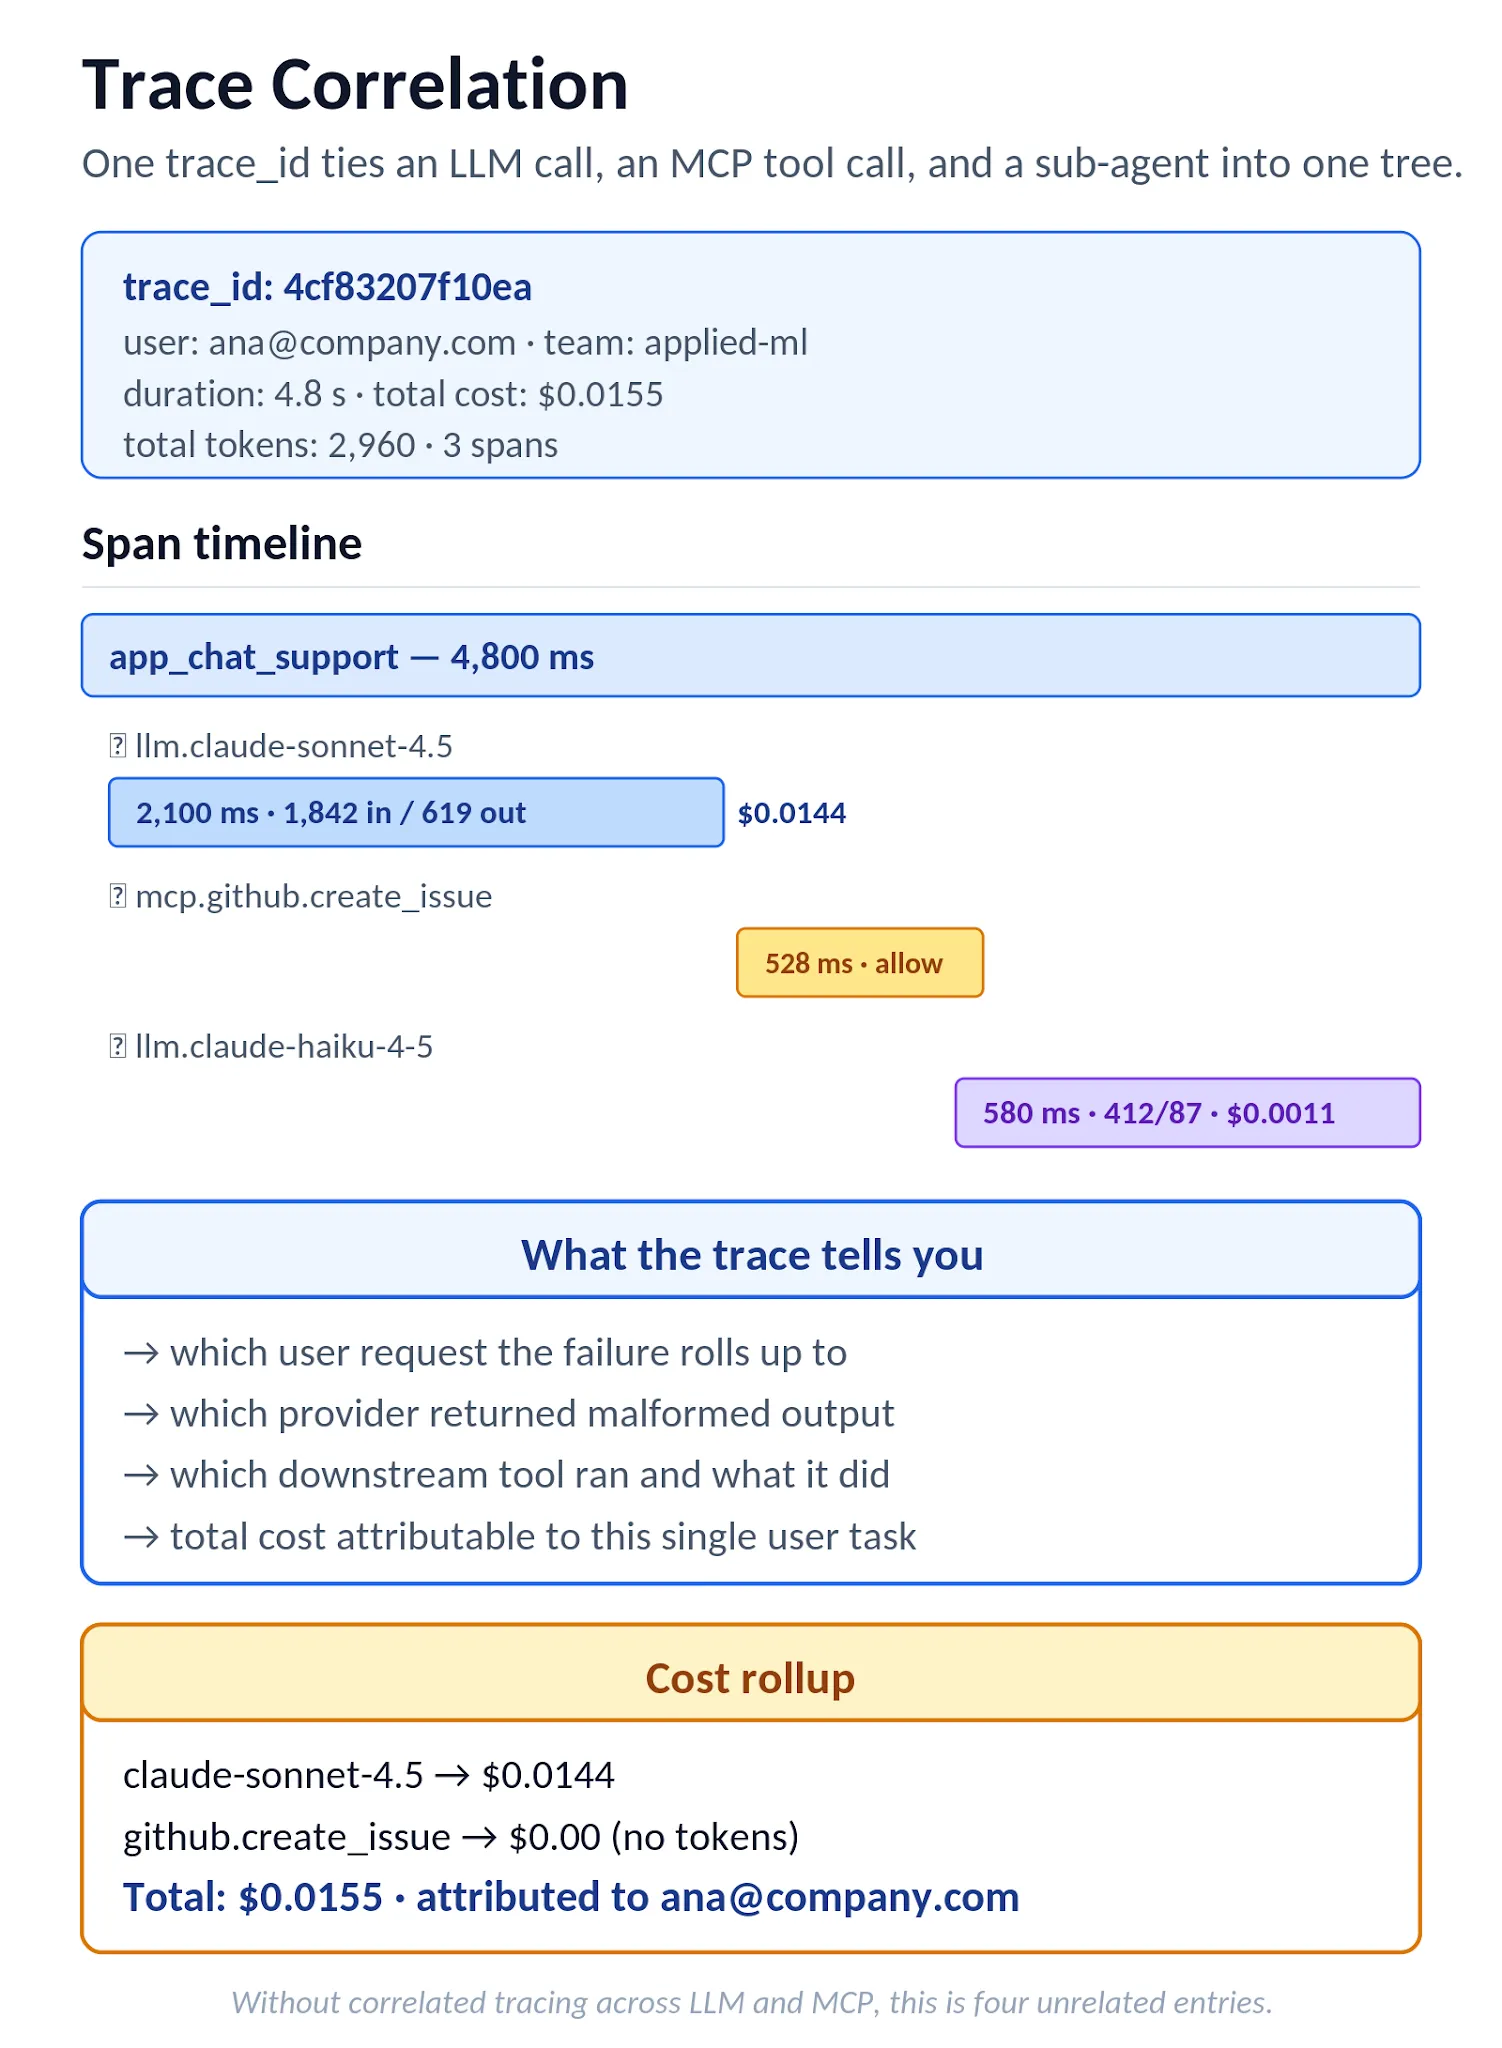
Figure 6. Vue en cascade de trace d'une seule tâche d'agent : appel LLM, appel d'outil MCP et deuxième appel LLM, tous sous un seul trace_id avec le coût agrégé sur les étendues (spans).
Le coût d'un manque d'intégration est rarement visible lors de l'acquisition. Il apparaît six mois plus tard, lorsque l'accès d'un employé licencié prend 48 heures à révoquer parce que SCIM n'est pas réel, lorsqu'une panne P1 à 2h du matin reçoit une réponse automatique « nous répondrons pendant les heures ouvrables » parce que le SLA est un objectif ambitieux, lorsqu'un renommage de groupe Okta rompt les attributions de rôles parce que l'intégration SSO de la plateforme n'a jamais été testée avec les événements de cycle de vie des groupes. Chacun de ces éléments représente un coût d'ingénierie fini, mais ils s'accumulent pour former la taxe opérationnelle qui pousse les équipes plateforme à migrer discrètement vers d'autres produits pourtant performants lors du renouvellement de la troisième année.
La section 6 met en lumière les réalités opérationnelles. Deux schémas de diagnostic : toute réponse « oui » à une question de support de protocole mérite un suivi pour savoir quels clients utilisent ce protocole en production aujourd'hui par rapport à ceux qui seront les premiers à l'essayer. Et tout engagement SLA sans crédits explicites doit être traité comme un objectif marketing. Les SLA contractuels sont assortis de crédits car les fournisseurs évaluent le risque de ne pas les respecter ; les SLA ambitieux sont rédigés par le marketing et n'en ont pas.
Obtenez les crédits par écrit.
Si la plateforme ne peut consommer qu'un seul format de revendication fixe, l'intégration avec autre chose qu'Okta/Azure AD devient difficile. La flexibilité mentionnée ci-dessus est un coût de configuration unique ; sans elle, chaque intégration d'IdP devient un engagement personnalisé.
POST /scim/v2/Users
Authorization: Bearer <scim-token>
Content-Type: application/scim+json

{
  "schemas": ["urn:ietf:params:scim:schemas:core:2.0:User"],
  "userName": "[email protected]",
  "name": {"givenName": "Ana", "familyName": "Ruiz"},
  "emails": [{"value": "[email protected]", "primary": true}],
  "groups": [{"value": "applied-ml"}, {"value": "ai-platform-developer"}],
  "active": true
}
Lorsque l'utilisateur est déprovisionné dans l'IdP, le même point de terminaison reçoit une requête PATCH qui fait passer « active » à « false », et la plateforme devrait révoquer l'accès de l'utilisateur rapidement plutôt qu'à la prochaine tentative de connexion. Testez cela dans la preuve de concept : déprovisionnez un utilisateur de test dans l'IdP, puis tentez d'utiliser un jeton de plateforme toujours valide, et confirmez que le cycle de vie du déprovisionnement fonctionne de bout en bout. Si la plateforme ne respecte le déprovisionnement qu'à la prochaine connexion de l'utilisateur, c'est une lacune de conformité qui mérite d'être signalée par écrit.
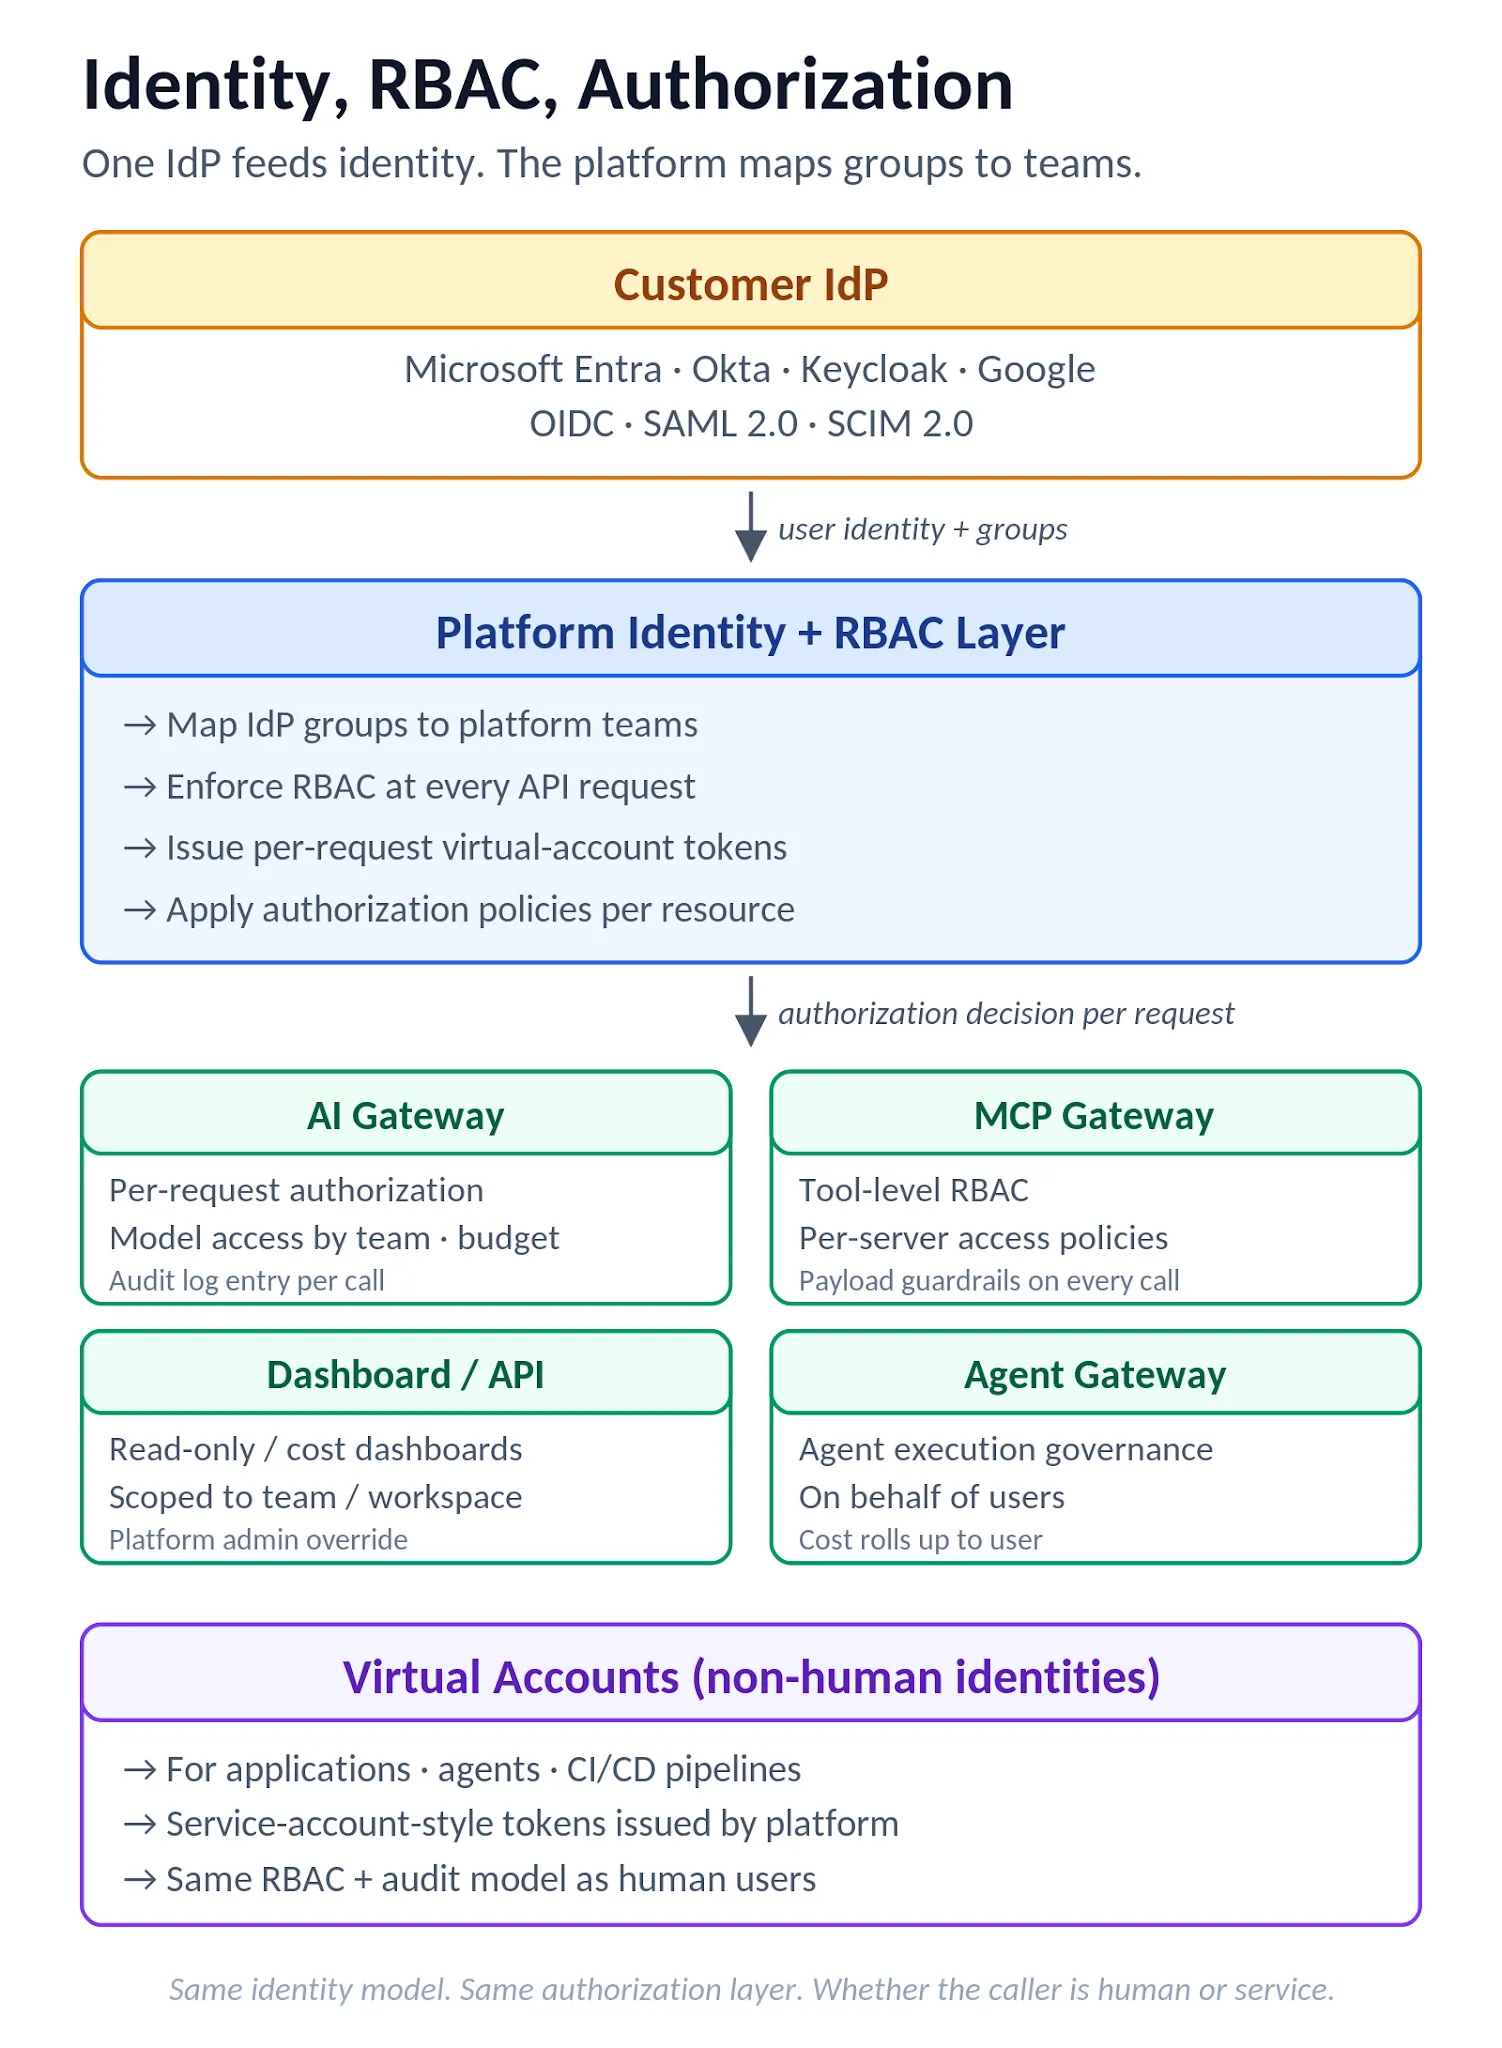
Figure 7. Flux d'identité et de RBAC : l'IdP fournit l'identité, la plateforme mappe les groupes aux équipes et aux comptes virtuels, avec application au niveau de la passerelle IA, de la passerelle MCP, du tableau de bord et de la passerelle Agent.
Méfiez-vous des « temps de réponse » définis comme « un e-mail automatique indiquant que nous avons reçu votre ticket ». Ce n'est pas une réponse. Une vraie réponse, c'est un ingénieur qui s'occupe du problème. Et la clause de crédit est le test : les SLA contractuels sont assortis de crédits, les SLA marketing non.
L'équipe de solutions de TrueFoundry considère cet appel d'offres comme une évaluation formelle, et non comme un document commercial. Chaque question reçoit une réponse écrite étayée par des preuves : rapports SOC 2 Type II, documentation BAA pour les déploiements dans le secteur de la santé, résumés de tests d'intrusion, architectures de référence, exemples de journaux d'audit, références clients. Le résultat est un document que vos équipes de sécurité, d'approvisionnement et de plateforme utilisent pour prendre une décision sans avoir besoin d'un appel de découverte pour combler les lacunes.
L'architecture sous-jacente aux réponses correspond directement à la structure des sections de ce modèle, c'est pourquoi la plupart des questions sont résolues de manière claire. En voici le détail :
Le modèle de déploiement est à plan divisé. Le plan de contrôle est le cerveau de l'orchestration, hébergeant la configuration, le RBAC et les tableaux de bord. Les plans de calcul se connectent via un agent et hébergent les charges de travail réelles, y compris l'AI Gateway, le MCP Gateway et toutes les applications déployées ou les modèles auto-hébergés. Les plans de calcul peuvent s'exécuter dans les comptes cloud des clients (AWS, GCP, Azure) ou sur Kubernetes sur site, et plusieurs plans de calcul se connectent à un seul plan de contrôle pour permettre des opérations multi-environnements sous une surface de contrôle unique. L'AI Gateway peut être auto-hébergée dans l'infrastructure du client (les options de déploiement sont documentées séparément) pour les contrôles de résidence et de souveraineté des données. Les journaux d'audit et les données de traçage sont stockés à l'aide de projets de journalisation des requêtes et de traçage de la passerelle, avec un RBAC régissant l'accès aux traces et aux journaux. L'architecture à plan divisé est ce qui rend la même posture de résidence des données disponible pour les déploiements SaaS, mono-cloud, multi-cloud et auto-hébergés, plutôt que de traiter chacun comme un produit distinct avec des postures de contrôle distinctes.
La souveraineté des données est l'architecture, pas un argument marketing.
L'authentification utilise le SSO d'entreprise via OIDC ou SAML 2.0 avec une validation optionnelle du jeton IdP directement au niveau de l'AI Gateway pour le contrôle d'accès API. Les IdP courants (Microsoft Entra ID, Okta, Keycloak, Google) sont pris en charge, avec des revendications d'identité et des appartenances aux groupes mappées de l'IdP vers les équipes TrueFoundry pour gérer le RBAC à grande échelle. Le provisionnement SCIM est pris en charge sur toutes les configurations SSO — OIDC et SAML — de sorte que la déprovisionnement dans l'IdP se propage plutôt que d'attendre la prochaine connexion de l'utilisateur. Le RBAC fonctionne au niveau du locataire (rôles Admin/Membre) ainsi que des rôles personnalisés avec des permissions ciblées sur les utilisateurs, les équipes, les clusters, les espaces de travail, les déploiements, les comptes de fournisseur AI Gateway, les serveurs MCP et les projets de traçage. Les identités non humaines (applications, agents) obtiennent des comptes virtuels avec des jetons de type compte de service, et l'autorisation par requête aux limites de l'AI Gateway (modèles, agents, serveurs et outils MCP) prend en charge les modèles de moindre privilège. Les clés de fournisseur s'intègrent aux magasins de secrets gérés par le client ; l'authentification de la passerelle est superposée à l'IdP plutôt que de le remplacer, de sorte que la MFA et l'accès conditionnel restent appliqués par l'IdP du client.
L'AI Gateway achemine plus de 1 000 LLM via un seul point d'accès compatible OpenAI : OpenAI, Anthropic (directement et via AWS Bedrock), Azure OpenAI, GCP Vertex AI, Groq, Mistral, et les modèles auto-hébergés servis via vLLM, TGI ou Triton. Le routage est configuré via des modèles virtuels, qui exposent une interface de modèle et équilibrent la charge ou basculent entre plusieurs fournisseurs et modèles sous-jacents. TrueFailover superpose un routage conscient des pannes et des dégradations, avec une résilience multi-régions et multi-cloud intégrée. Des limites strictes de jetons et de requêtes par utilisateur, équipe ou compte virtuel renvoient un rejet structuré lorsqu'une équipe atteint son budget, plutôt qu'une alerte douce laissant la requête passer. Le basculement de fournisseur est automatique et la pénalité de latence est capturée comme une métrique distincte lors de l'appel plutôt que d'être noyée dans la latence totale. La mise en cache sémantique utilise des embeddings et la similarité cosinus avec un seuil et un TTL configurables ; la documentation cite une amélioration de la latence allant jusqu'à ~20x pour les requêtes répétées ou similaires. Les garde-fous sont basés sur des règles (ciblées par modèle, utilisateur ou métadonnées), chacun peut valider (bloquer) ou muter (réécrire/expurger), et le "Bring-Your-Own Guardrail" est pris en charge via un serveur de garde-fous personnalisé utilisant un modèle FastAPI.
Ici, le routage est le produit, pas un simple paramètre de configuration.
La pile MCP et agentique est le facteur de différenciation. TrueFoundry exécute une passerelle MCP native et un registre MCP qui enregistrent, découvrent et connectent de manière sécurisée les serveurs et outils MCP via des contrôles d'accès gouvernés et des flux d'authentification d'entreprise. Les transports MCP modernes, y compris le HTTP streamable pour les connexions proxy, sont pris en charge, et la couche protocolaire utilise la messagerie JSON-RPC standard selon la spécification MCP. L'authentification est multicouche : authentification de la passerelle, contrôle d'accès aux serveurs MCP, et authentification par serveur ou par outil (y compris les modèles basés sur OAuth documentés pour les serveurs MCP d'entreprise). La configuration centralisée signifie que les outils de développement communiquent avec un seul point d'accès de passerelle au lieu que chaque développeur configure ses propres connexions MCP, ce qui est le modèle d'outillage "fantôme" que le registre est conçu pour prévenir. Agent Hub fournit un catalogage et une orchestration organisationnels pour les agents complexes et préexistants, et Agent Gateway fournit la couche de gouvernance d'entreprise (accès sécurisé aux outils, observabilité, contrôles des coûts) pour l'exécution de ces agents en production. La même identité qui régit l'accès aux LLM régit l'accès aux outils, de sorte que l'autorisation pour les deux réside dans une seule configuration IdP. Et le même contexte de trace qui relie une tâche d'agent LLM multi-étapes relie les invocations MCP qui en découlent, ce qui rend le calcul des coûts par tâche et le débogage de bout en bout réalisables plutôt que théoriques.
L'observabilité utilise la journalisation des requêtes de la passerelle avec des traces. Les nombres de jetons, les coûts, la latence (TTFT et totale), les décisions des garde-fous, les décisions de politique, et l'attribution aux équipes et aux applications sont capturés par appel, stockés sous forme de traces, et accessibles via des projets de traçage avec leur propre RBAC. L'exportation de télémétrie est basée sur des standards : exportation de données OpenTelemetry plus exportation de journaux et de traces vers des systèmes externes tels que Grafana, Datadog et Prometheus, afin que les clients s'intègrent aux piles d'observabilité existantes plutôt que d'en apprendre une propriétaire. Les tableaux de bord des coûts sont en temps réel et partageables avec les chefs d'équipe via un RBAC en lecture seule. Le même magasin de journaux/traces est ce qui crée l'ensemble de données auditable des tentatives d'injection de prompt, des violations de politique et des schémas d'abus que les clients peuvent exploiter pour l'ajustement des garde-fous au fil du temps.
Votre pile d'observabilité existante reste votre pile d'observabilité existante.
Les preuves de débit derrière tout cela : 10 milliards de requêtes par mois traitées sur l'ensemble de la clientèle, plus de 1 000 clusters Kubernetes gérés par la plateforme, une surcharge côté passerelle inférieure à 10 ms p95 (TTFT) et plus de 350 RPS maintenus sur un seul vCPU. Parmi les clients en production figurent Resmed, Siemens Healthineers, Automation Anywhere, Zscaler et Nvidia. La série A a été menée par Intel Capital en février 2025, portant le financement total à environ 21 millions de dollars avec la participation de Peak XV Partners (Surge), Eniac Ventures et Jump Capital.
À l'échelle de la production, pas à l'échelle pilote.
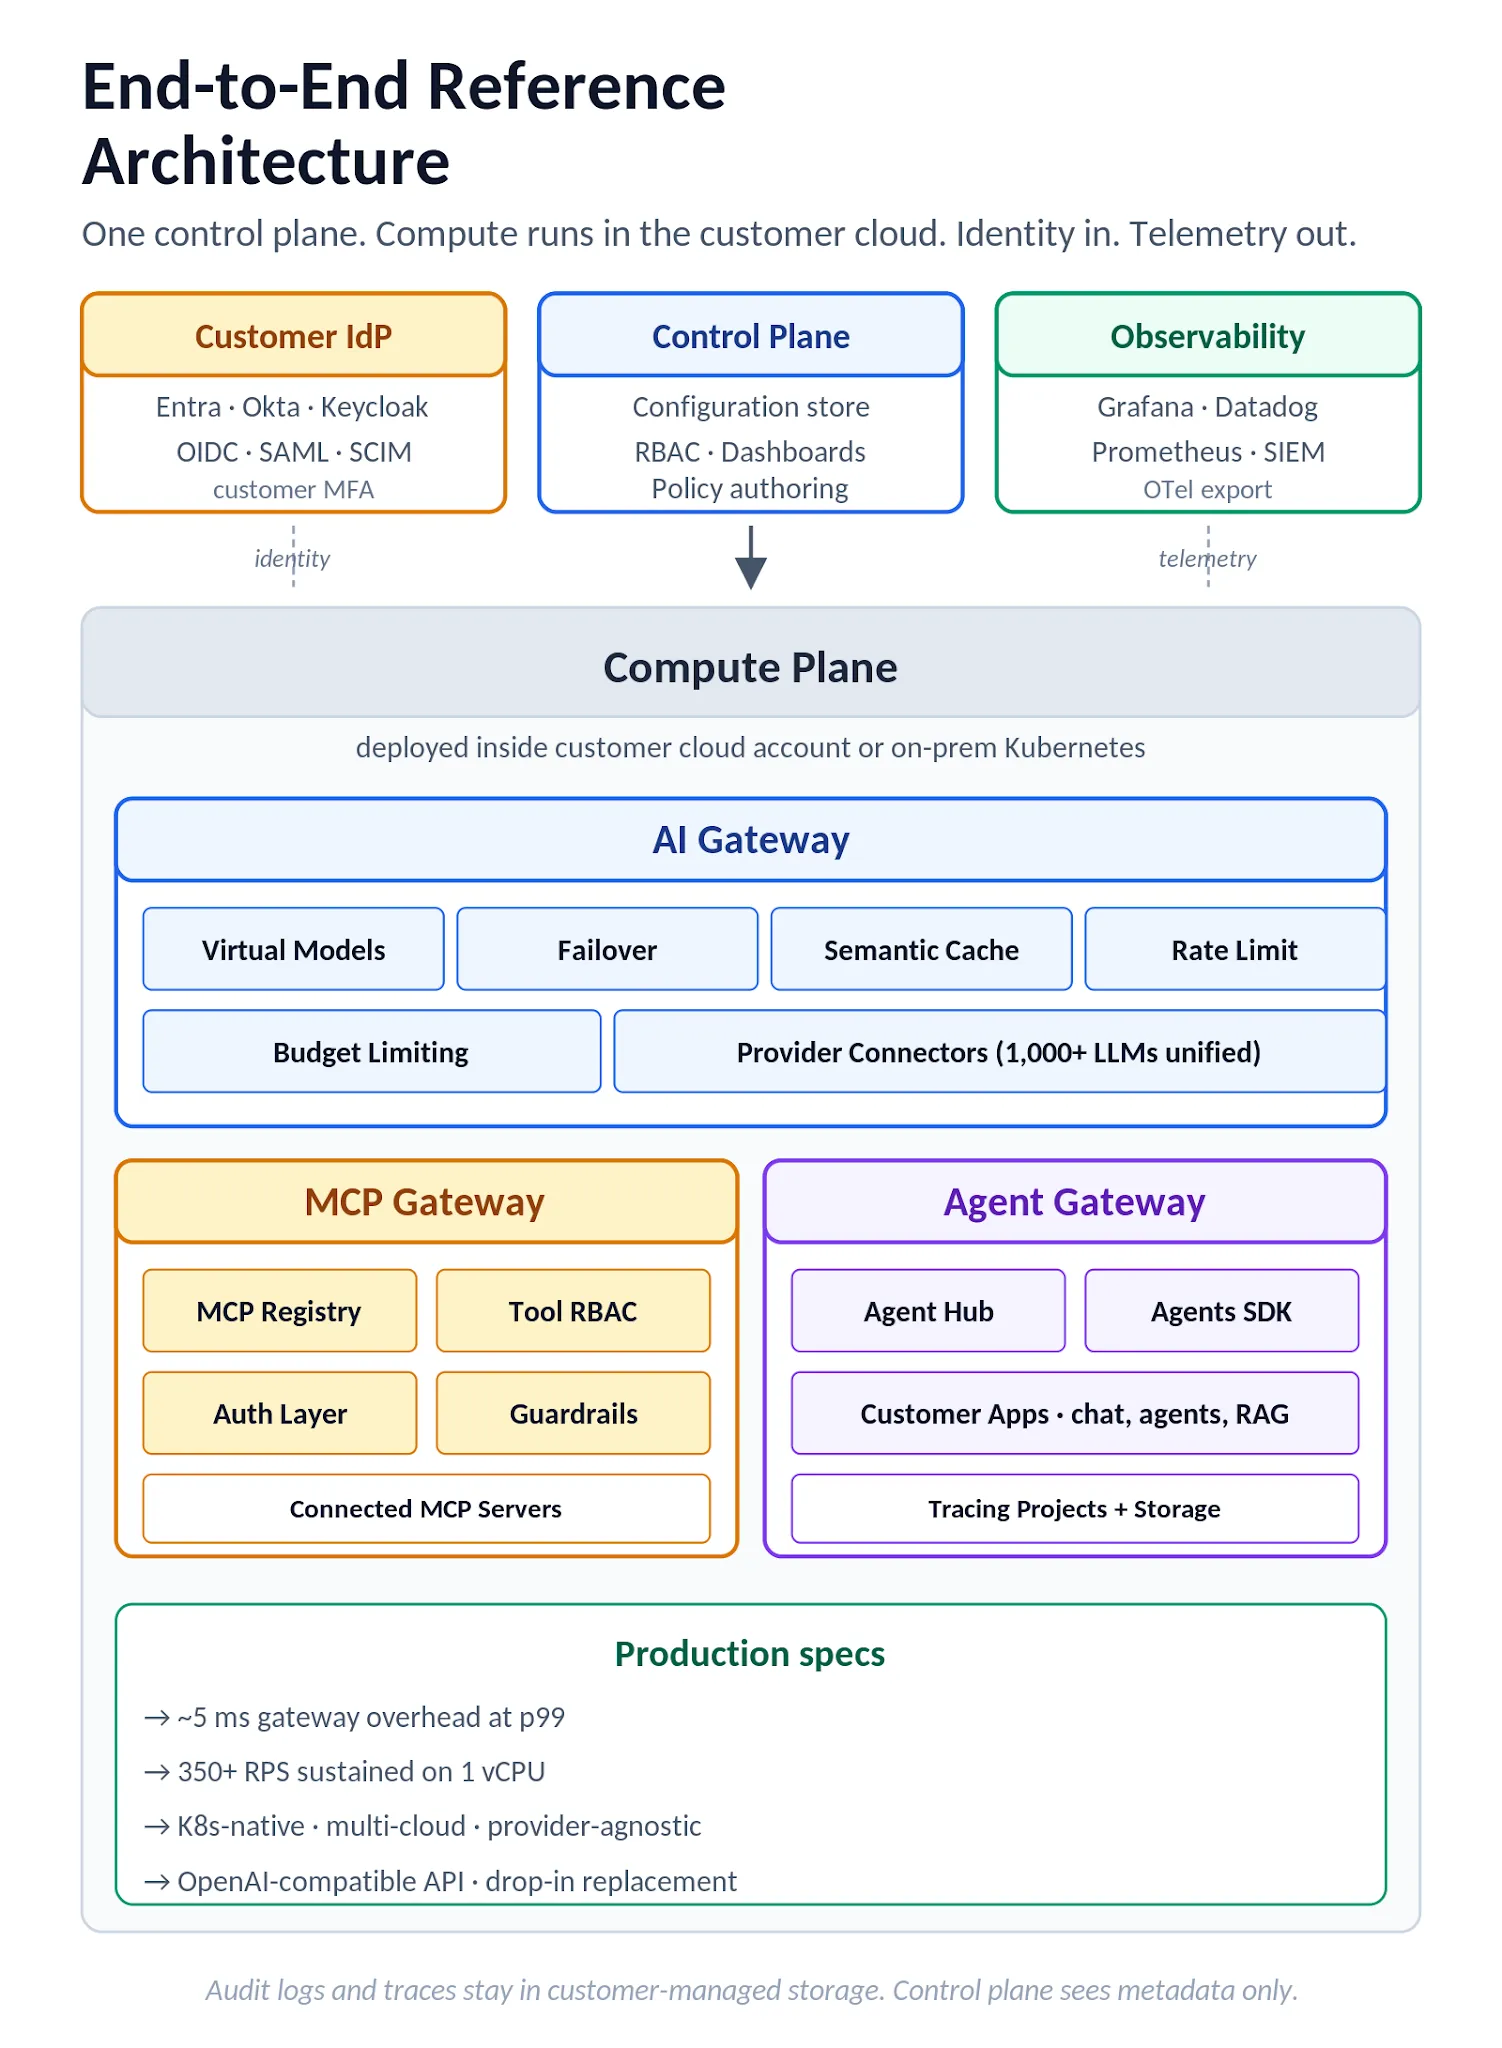
Figure 8. Architecture de référence de bout en bout TrueFoundry : plan de contrôle, plan de calcul (avec AI Gateway, MCP Gateway, Agent Gateway et applications client), IdP client et cibles d'observabilité.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



