



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Bifrost apparaît sur presque toutes les sélections d'« AI gateways » en 2026, généralement associé aux mots le plus rapide et open source. Aucune de ces affirmations ne résiste à une lecture directe des chiffres du fournisseur. Nous l'avons donc vérifié par la méthode forte : en le benchmarkant nous-mêmes sur un environnement contraint de 1 vCPU.
Cet article analyse la solidité des promesses de performance de Bifrost sous des mesures réelles — sur un banc d'essai fixe de 1 vCPU / 2 Go de RAM, le même standard auquel nous soumettons chaque gateway de ce comparatif.
C'est la section à laquelle toute affirmation sur « la gateway la plus rapide » doit répondre.
Le chiffre du fournisseur : ~5 000 RPS avec ~11 microsecondes d'overhead moyen — sur une t3.xlarge (4 vCPU), face à un upstream simulé (mock). Avant de comparer cela à quoi que ce soit, lisez ce qu'il mesure réellement. Selon le code source de Bifrost, ce chiffre en microsecondes est mesuré sans la gestion des requêtes HTTP ni la sérialisation JSON — il s'agit donc du temps passé dans le pipeline interne de la gateway, et non de la latence nette ajoutée à la requête d'un appelant. La même source l'évalue à 59 µs sur une t3.medium, ce qui montre une dégradation d'environ 5x sur une machine plus petite. Il s'agit également d'une moyenne, et non d'un percentile, sur 4x la capacité de calcul que la plupart des équipes attribuent réellement à un conteneur de gateway.
Rien de tout cela ne rend ce chiffre malhonnête ; il répond simplement à une question différente de « à quoi ressemble ma p99 ? ». Tout ce qui suit représente l'autre mesure : la latence ajoutée de bout en bout pour des tailles de charges utiles réelles et documentées, sérialisation et HTTP inclus — la taxe complète payée par l'appelant pour la présence de la gateway sur le trajet. Les microsecondes et les millisecondes sont toutes deux exactes ici, car elles mesurent des éléments différents.
Nous avons construit un banc d'essai fixe — 1 vCPU, 2 Go de RAM, charge en boucle ouverte, le même standard appliqué à chaque gateway de ce comparatif — et mesuré Bifrost directement, sur trois tailles de charges utiles : petite (200 tokens d'entrée / 100 de sortie), moyenne (2 000/500) et grande (20 000/1 000). L'upstream simulé derrière Bifrost était également fixe, afin que tout ralentissement soit imputable à Bifrost et non à un environnement de test instable : 50 ms de temps de « réflexion » + 50 ms jusqu'au premier token pour les appels non-streamés, et une durée de stream fixe de 500 ms pour les appels streamés — ce sont les planchers d'environ ~55 ms et ~530–627 ms que vous verrez dans les graphiques ci-dessous, présents pour chaque taille de payload.
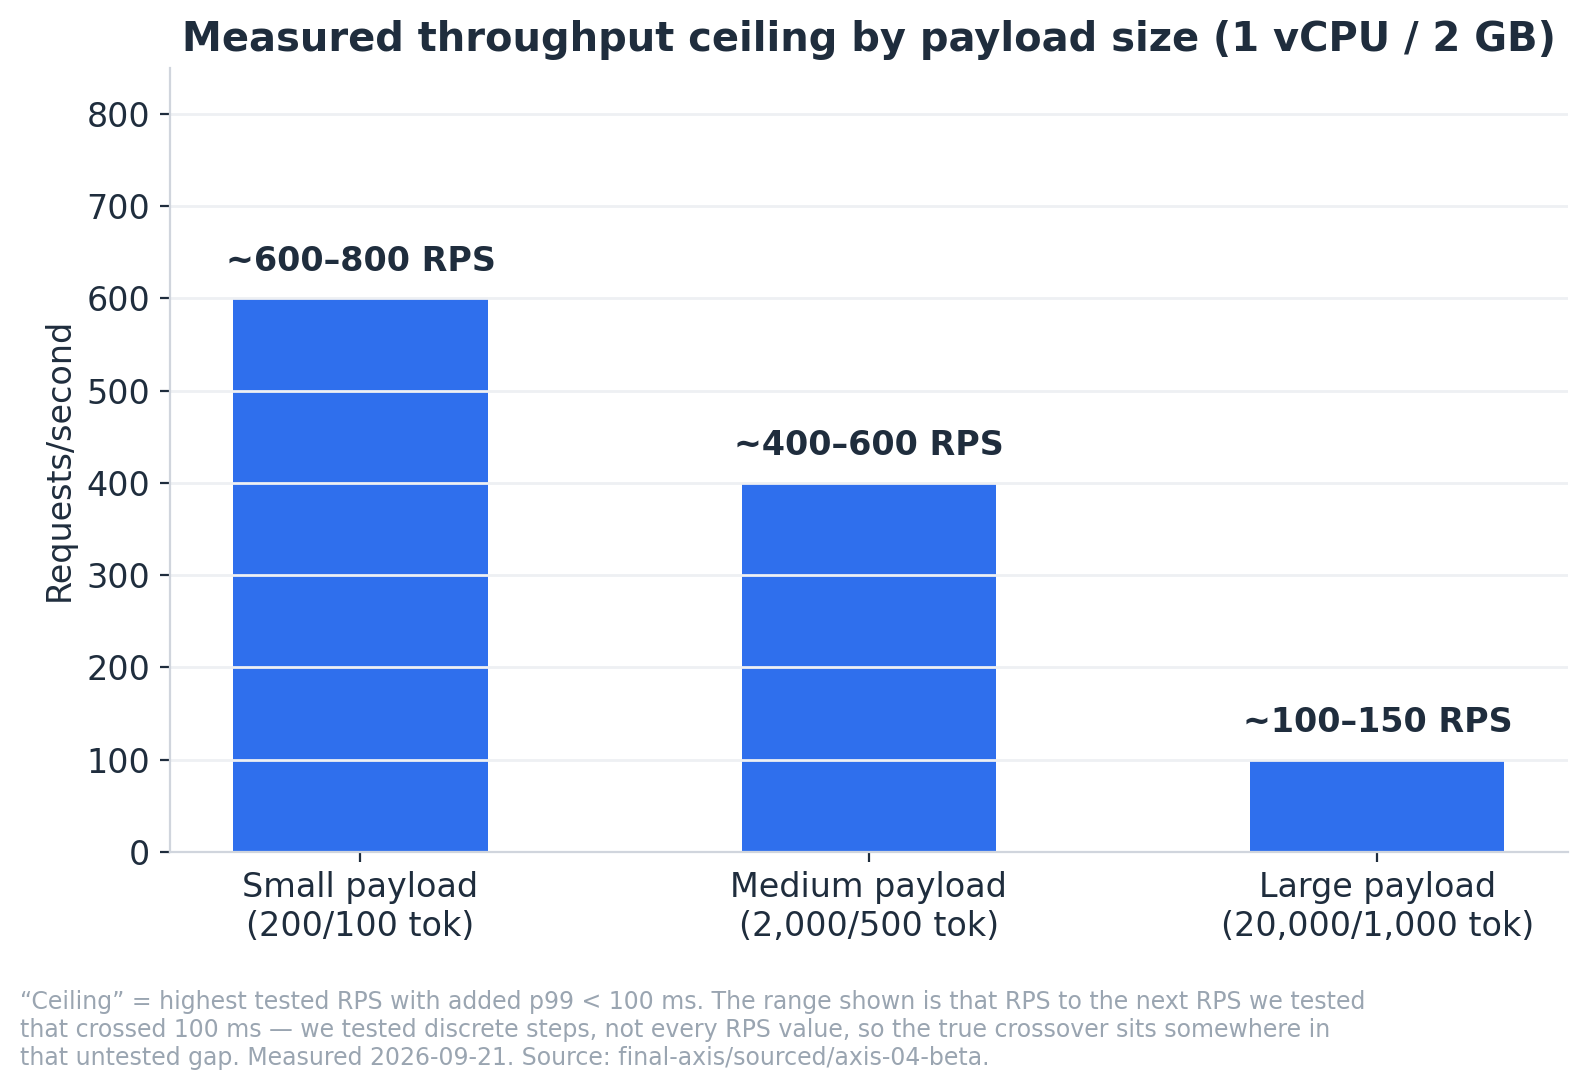
Plafonds de débit réels, pour un budget de latence ajoutée de 100 ms : ~600–800 RPS pour les petites charges utiles, ~400–600 pour les moyennes, ~100–150 pour les grandes. Ce sont des plages et non des chiffres exacts, à dessein — nous avons testé des paliers de RPS distincts et non chaque valeur, chaque plafond correspond donc à « la dernière valeur RPS confirmée comme correcte, jusqu'à la suivante confirmée comme ne l'étant plus ». Sous la limite basse de ces plages, la requête médiane paie 2 à 6 ms pour la gateway. Cette médiane est le chiffre le plus favorable de cette section et le moins utile pour la planification de capacité : elle varie à peine avec la charge — 2,1 à 3,1 ms pour les petites charges sur une plage de trafic multipliée par 60 — elle reste donc rassurerante jusqu'au moment précis où la gateway s'effondre. Le chiffre qui varie réellement est la p99. La p99 ajoutée passe de +5,6 ms (petite), +7.5 ms (moyenne) et +15,2 ms (grande) à 10 RPS à +60 ms pour la petite à 600 RPS, +75 ms pour la moyenne à 400, et +41 ms pour la grande à seulement 100 RPS — puis dépasse le budget de 100 ms dès le palier suivant testé dans les trois cas. Au-dessus de la limite haute, aucune des trois tailles de payload ne se dégrade de manière fluide, et chacune flanche différemment. Voici chaque charge utile côte à côte, la gateway face à sa propre mesure directe vers le mock (et non une ligne de base approximative unique partagée entre les tailles — les petites, moyennes et grandes ont toutes un plancher direct réellement différent de ~55–62 ms, et le graphique montre le chiffre réel pour chacune) :
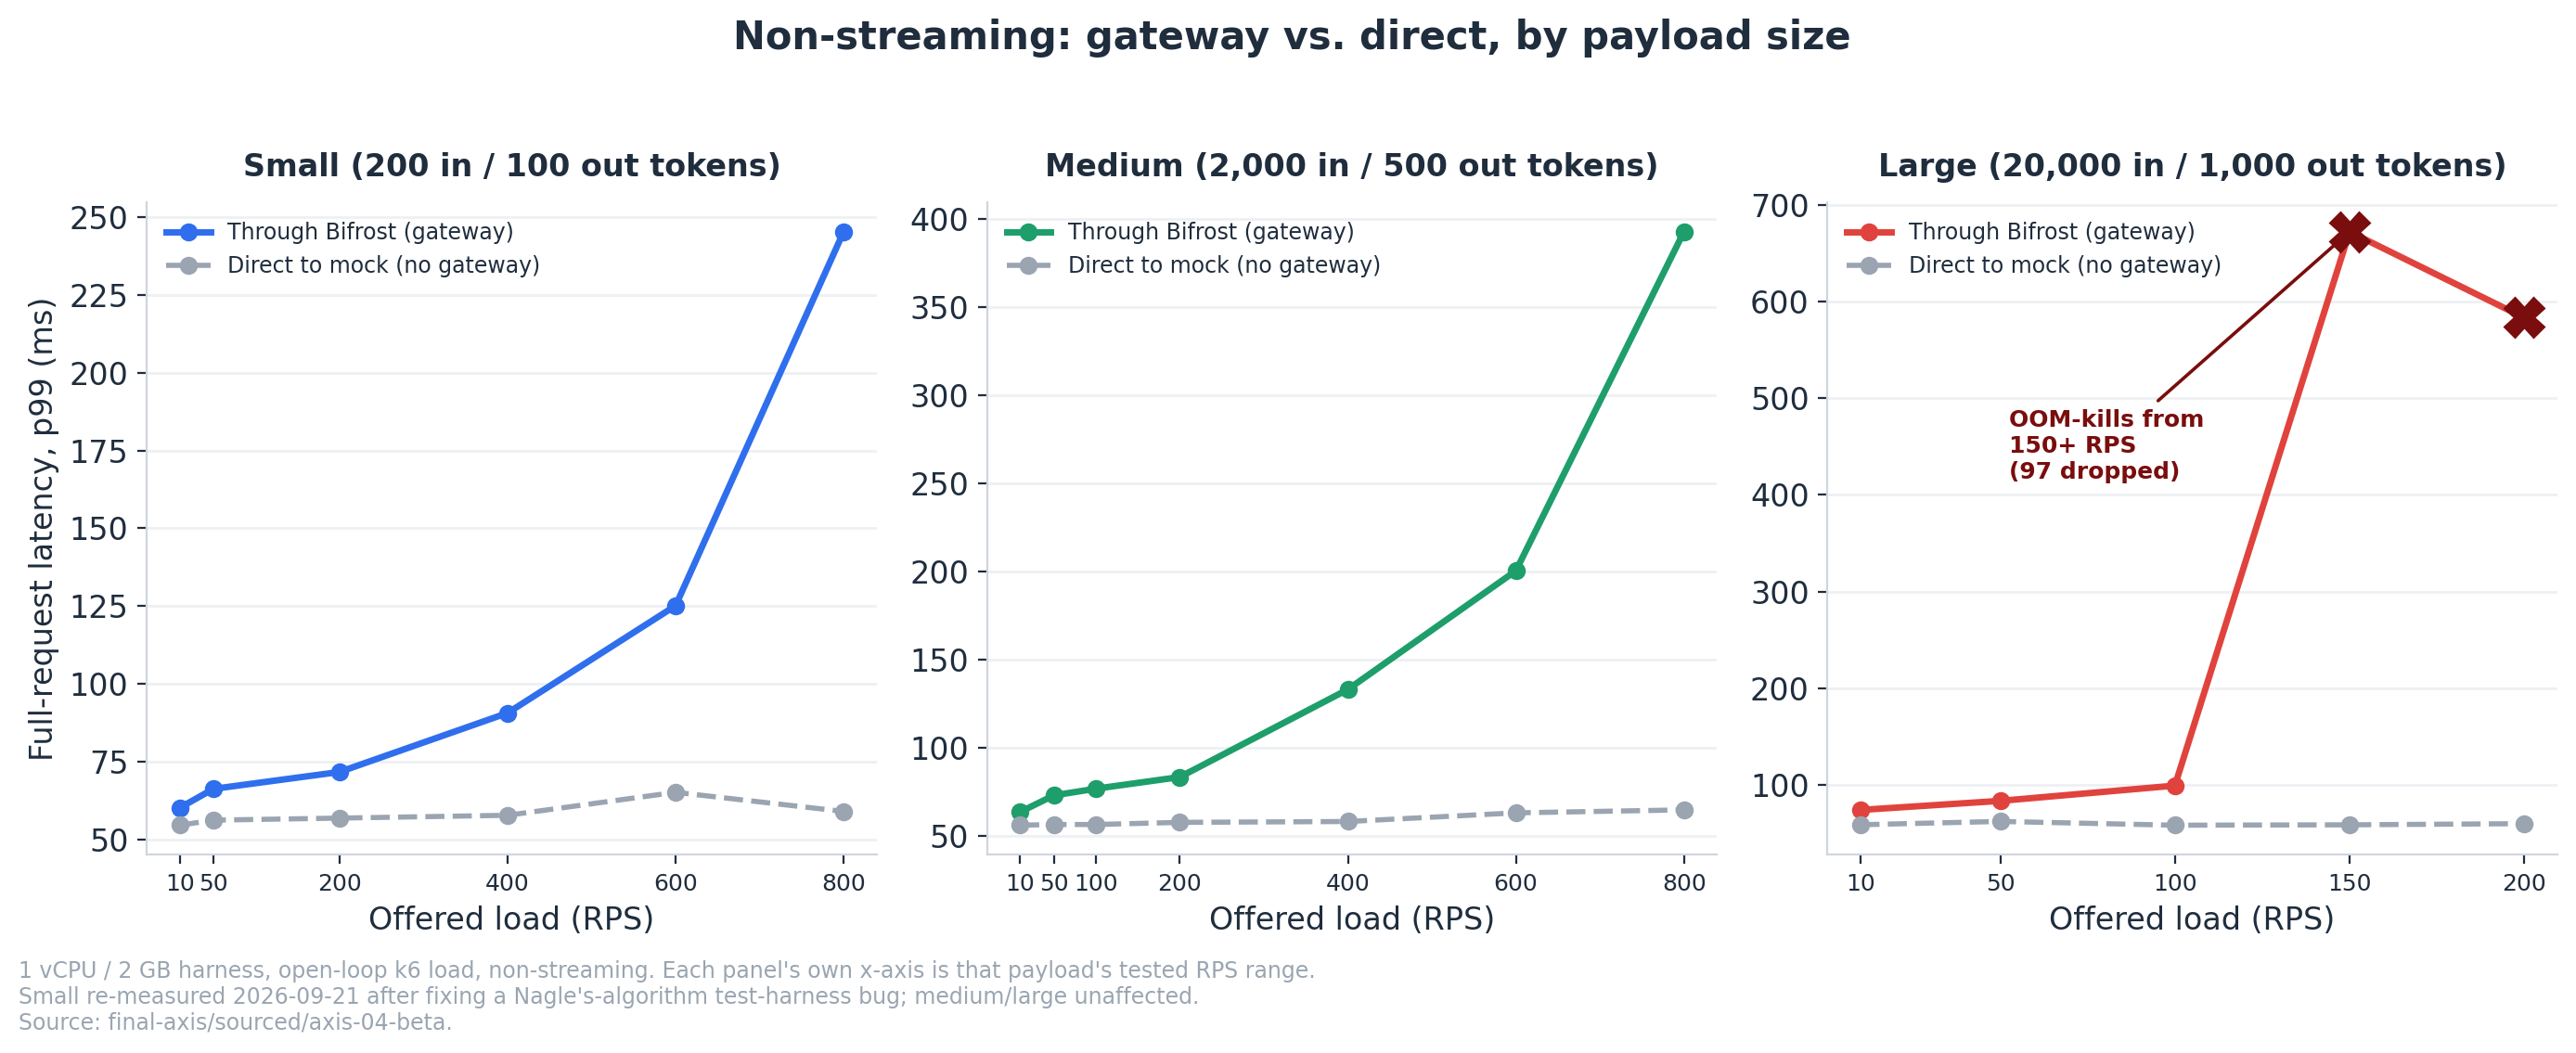
Les petites et moyennes suivent la même courbe — plate, puis une queue de p99 qui augmente — mais à des RPS différents. La hausse pour la petite commence vers 400–600 RPS ; celle de la moyenne commence plus tôt par requête, mais son mur plus critique se situe plus loin (400+ RPS) car son entrée de 2 000 tokens maintient un coût par requête plus élevé tout au long du test. La grande ne monte pas progressivement : elle reste plate de 10 à 100 RPS, puis s'effondre brutalement à 150 RPS, où le pod commence à subir des OOM-kills en cours d'exécution (61 requêtes abandonnées à 150 RPS, 97 de plus à 200). Il ne s'agit pas d'un point d'engorgement de file d'attente comme pour les petites/moyennes — c'est un mur de ressources strict, qui se traduit par un saut presque vertical plutôt que par une courbe.
Le streaming heurte le même mur, mais plus rapidement, car chaque stream ouvert conserve ses buffers en mémoire plus longtemps — même traitement, gateway vs direct, par payload :
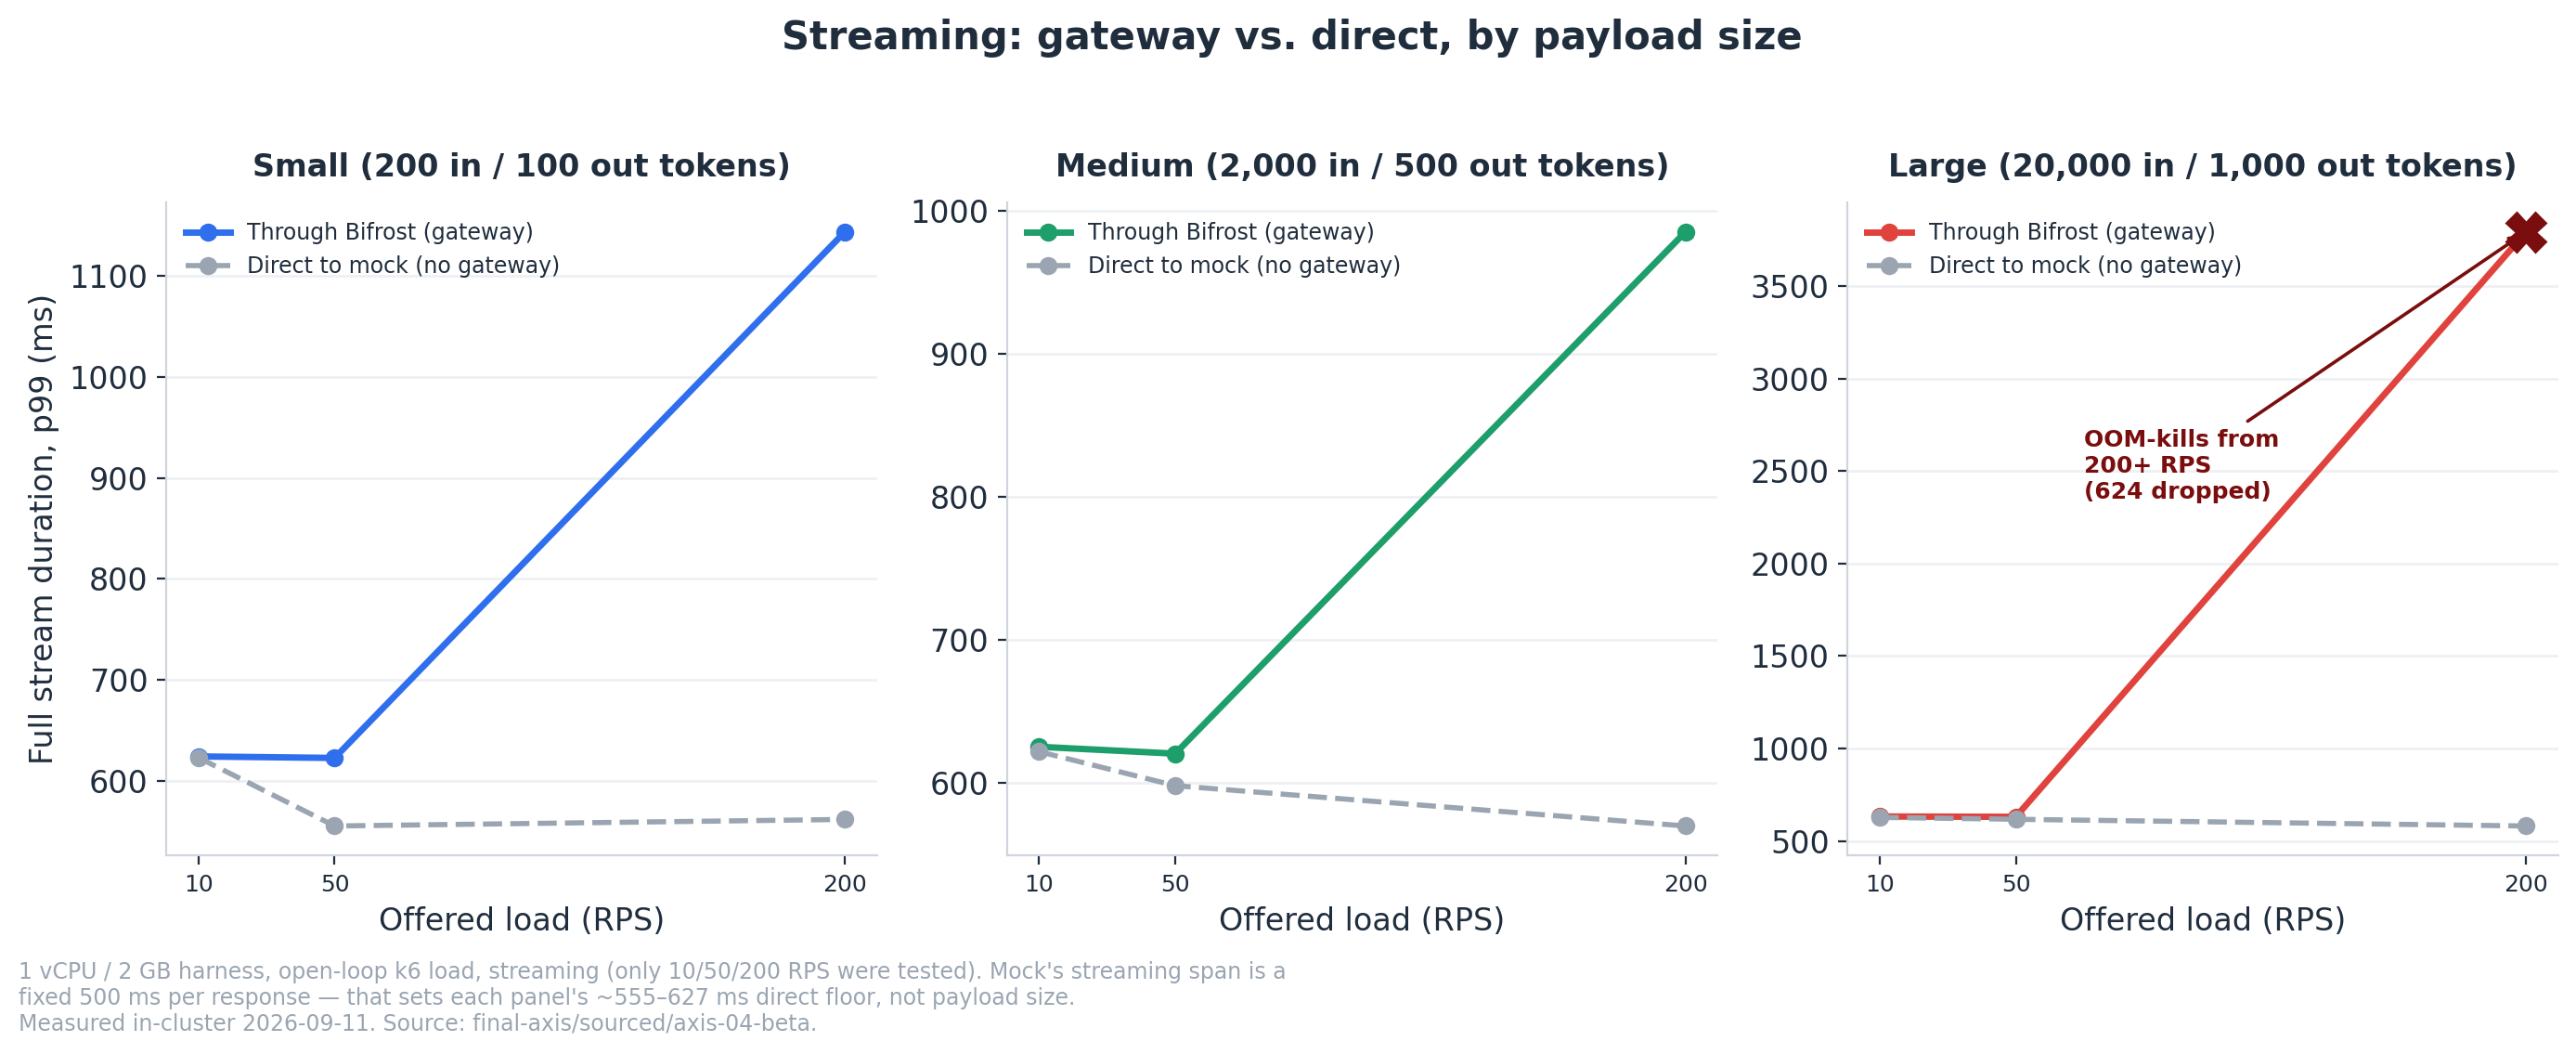
Les streams de petite et moyenne taille suivent de près leur propre plancher direct de ~555–627 ms jusqu'à 50 RPS, puis commencent à monter à 200 RPS (la p99 de la petite atteint ~1,14 s, la moyenne ~985 ms — dans les deux cas dus à la file d'attente, pas à un OOM). Le streaming de grande taille ne connaît pas non plus cette montée progressive : à 200 RPS, il s'effondre par OOM en cours d'exécution, entraînant l'échec de 624 streams sur 12 001 et faisant exploser la p99 à ~3,8 secondes. Si votre charge de travail traite de grands documents en streaming, 200 RPS sur un vCPU ne représente pas un palier « plus lent » — c'est un palier d'« échec ».
La durée totale du stream n'est toutefois pas la mesure principale si votre interface utilisateur a seulement besoin d'afficher le premier token — nous l'avons donc mesurée séparément, avec une sonde asynchrone couplée qui chronomètre le premier token de contenu réel, et non le TTFB de k6 (qui n'est pas valide pour le SSE ici, puisque le mock libère les en-têtes avant qu'aucun token n'existe) :
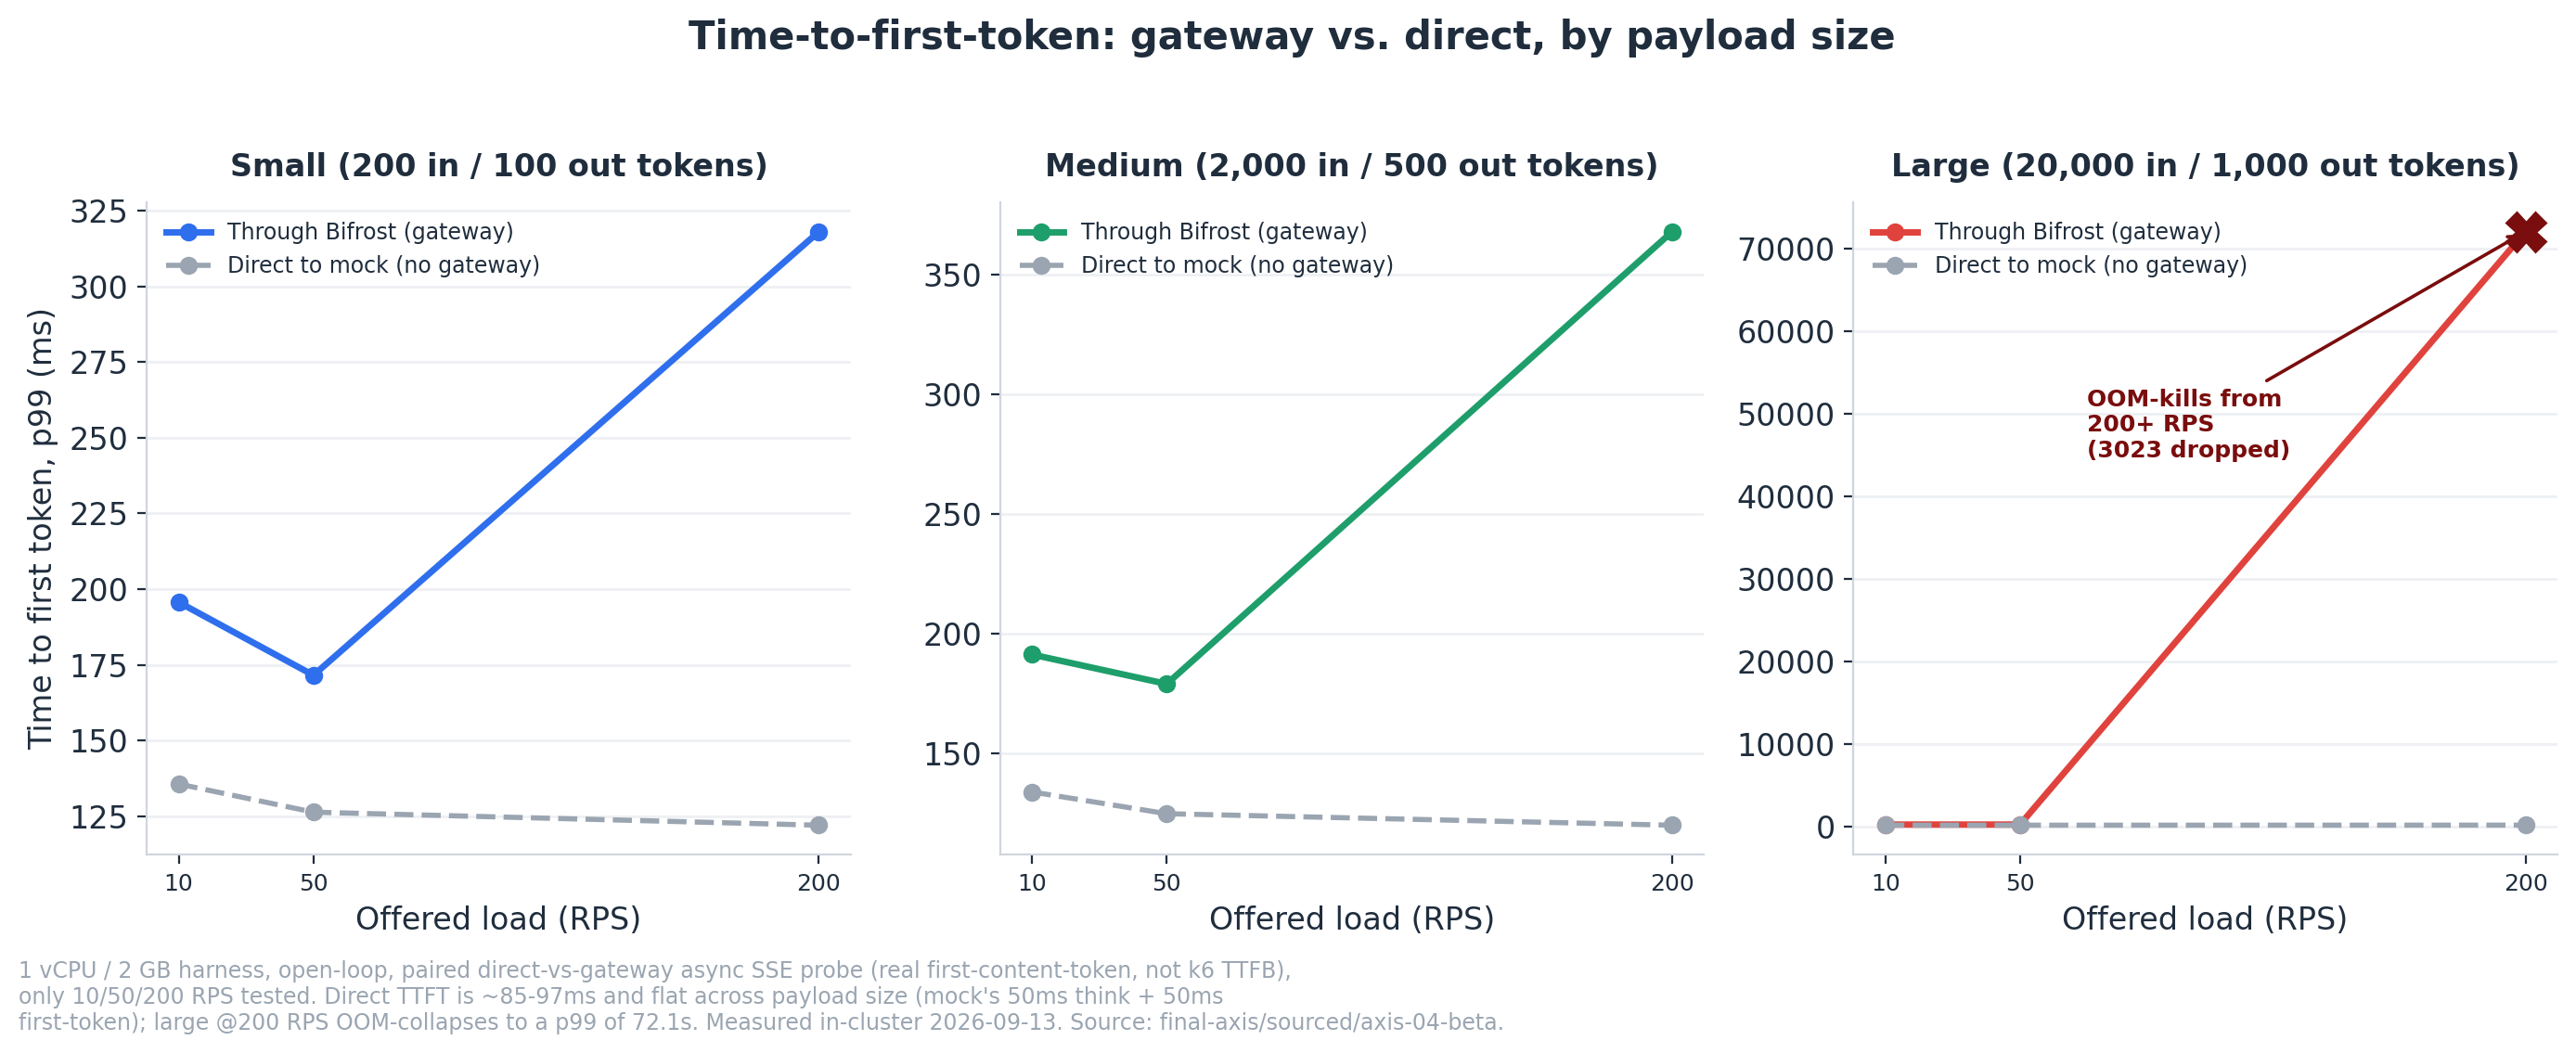
Le TTFT direct est de ~85–97 ms et reste plat sur les trois tailles de payload — la preuve que la longueur d'entrée ne modifie pas le temps d'apparition du premier token. Tout ce qui dépasse ce plancher représente donc le coût d'initialisation propre au streaming par requête de Bifrost. Ce coût ajouté est de ~27–46 ms et indépendant de la taille à 10–50 RPS (grande @10 RPS ajoute +46 ms, petite @10 RPS ajoute +43 ms — même ordre de grandeur, payload différent). À 200 RPS, les médianes des petites et moyennes se maintiennent encore (+57 à +71 ms), mais la queue explose — la p99 ajoutée atteint +196 à +248 ms — et 10 à 13 % des streams de la gateway échouent complètement, le même engorgement de file d'attente visible sur le graphique de stream complet ci-dessus. La grande @200 RPS n'a pas un problème de queue de latence, mais un effondrement complet : seuls 128,8 des 200 RPS proposés sont servis, la p99 du TTFT explose à 72,1 secondes, et 3 023 des 12 001 streams échouent — le mur OOM, vu cette fois du côté du premier token au lieu de la réponse complète.
Lors d'un pic de surcharge délibéré, les deux modes de Bifrost ont conservé une gestion sûre de la mémoire : le mode « blocking » finit par servir tout le monde (la requête la plus lente a attendu ~5 secondes), le mode « drop » échoue rapidement avec un code 503 propre.
Le plafond des grandes charges utiles a une cause totalement différente de celui des petites/moyennes. Ce n'est pas le CPU — et la façon la plus claire de s'en rendre compte est d'observer la mémoire et le CPU séparément, détaillés par taille de payload et par charge proposée, et non comme un simple chiffre maximal par payload :
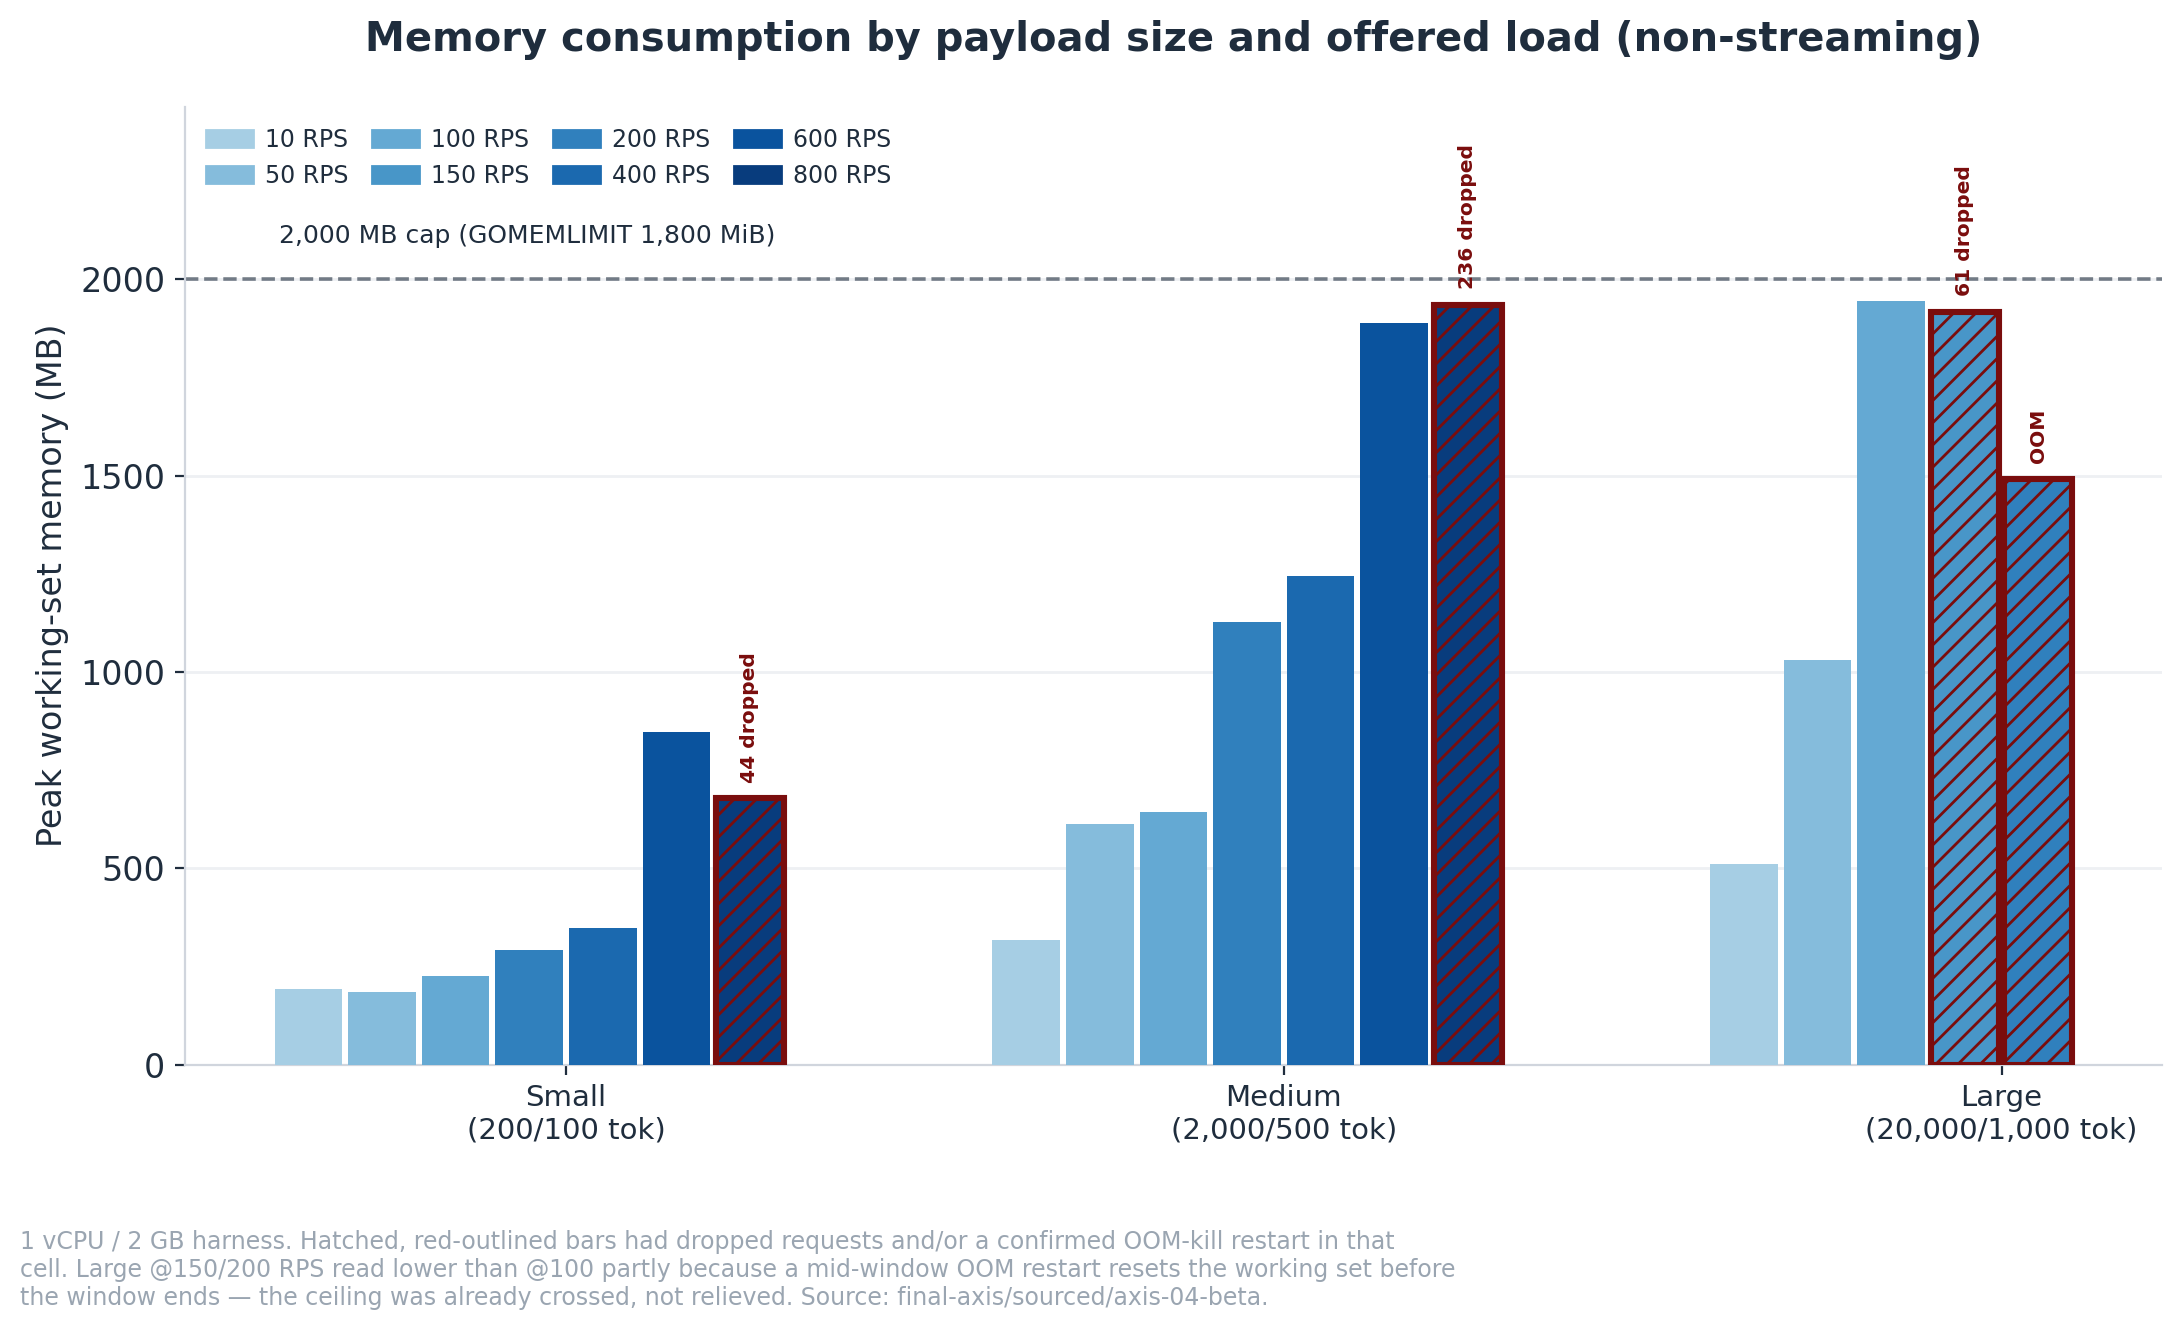
Les petites et moyennes augmentent progressivement et ne s'approchent jamais de la limite des 2 000 Mo, même à leur RPS testé le plus élevé (848 Mo et 1 935 Mo respectivement). La grande montre une autre réalité : elle atteint déjà 1 944 Mo — soit 97 % de la limite — dès 100 RPS, soit 50 à 700 RPS avant son « plafond » mesuré. Les barres entourées et hachurées en rouge (grande @150, @200) affichent en réalité des valeurs inférieures à la barre des 100 RPS, ce qui ressemble à une récupération mais n'en est pas une — un OOM-kill en milieu de fenêtre redémarre le pod et réinitialise le compteur de working set avant la fin de la fenêtre de mesure. Ces barres sous-estiment donc le pic réel au lieu de le surestimer.
Le CPU montre l'histoire inverse, ce qui confirme notre constatation :
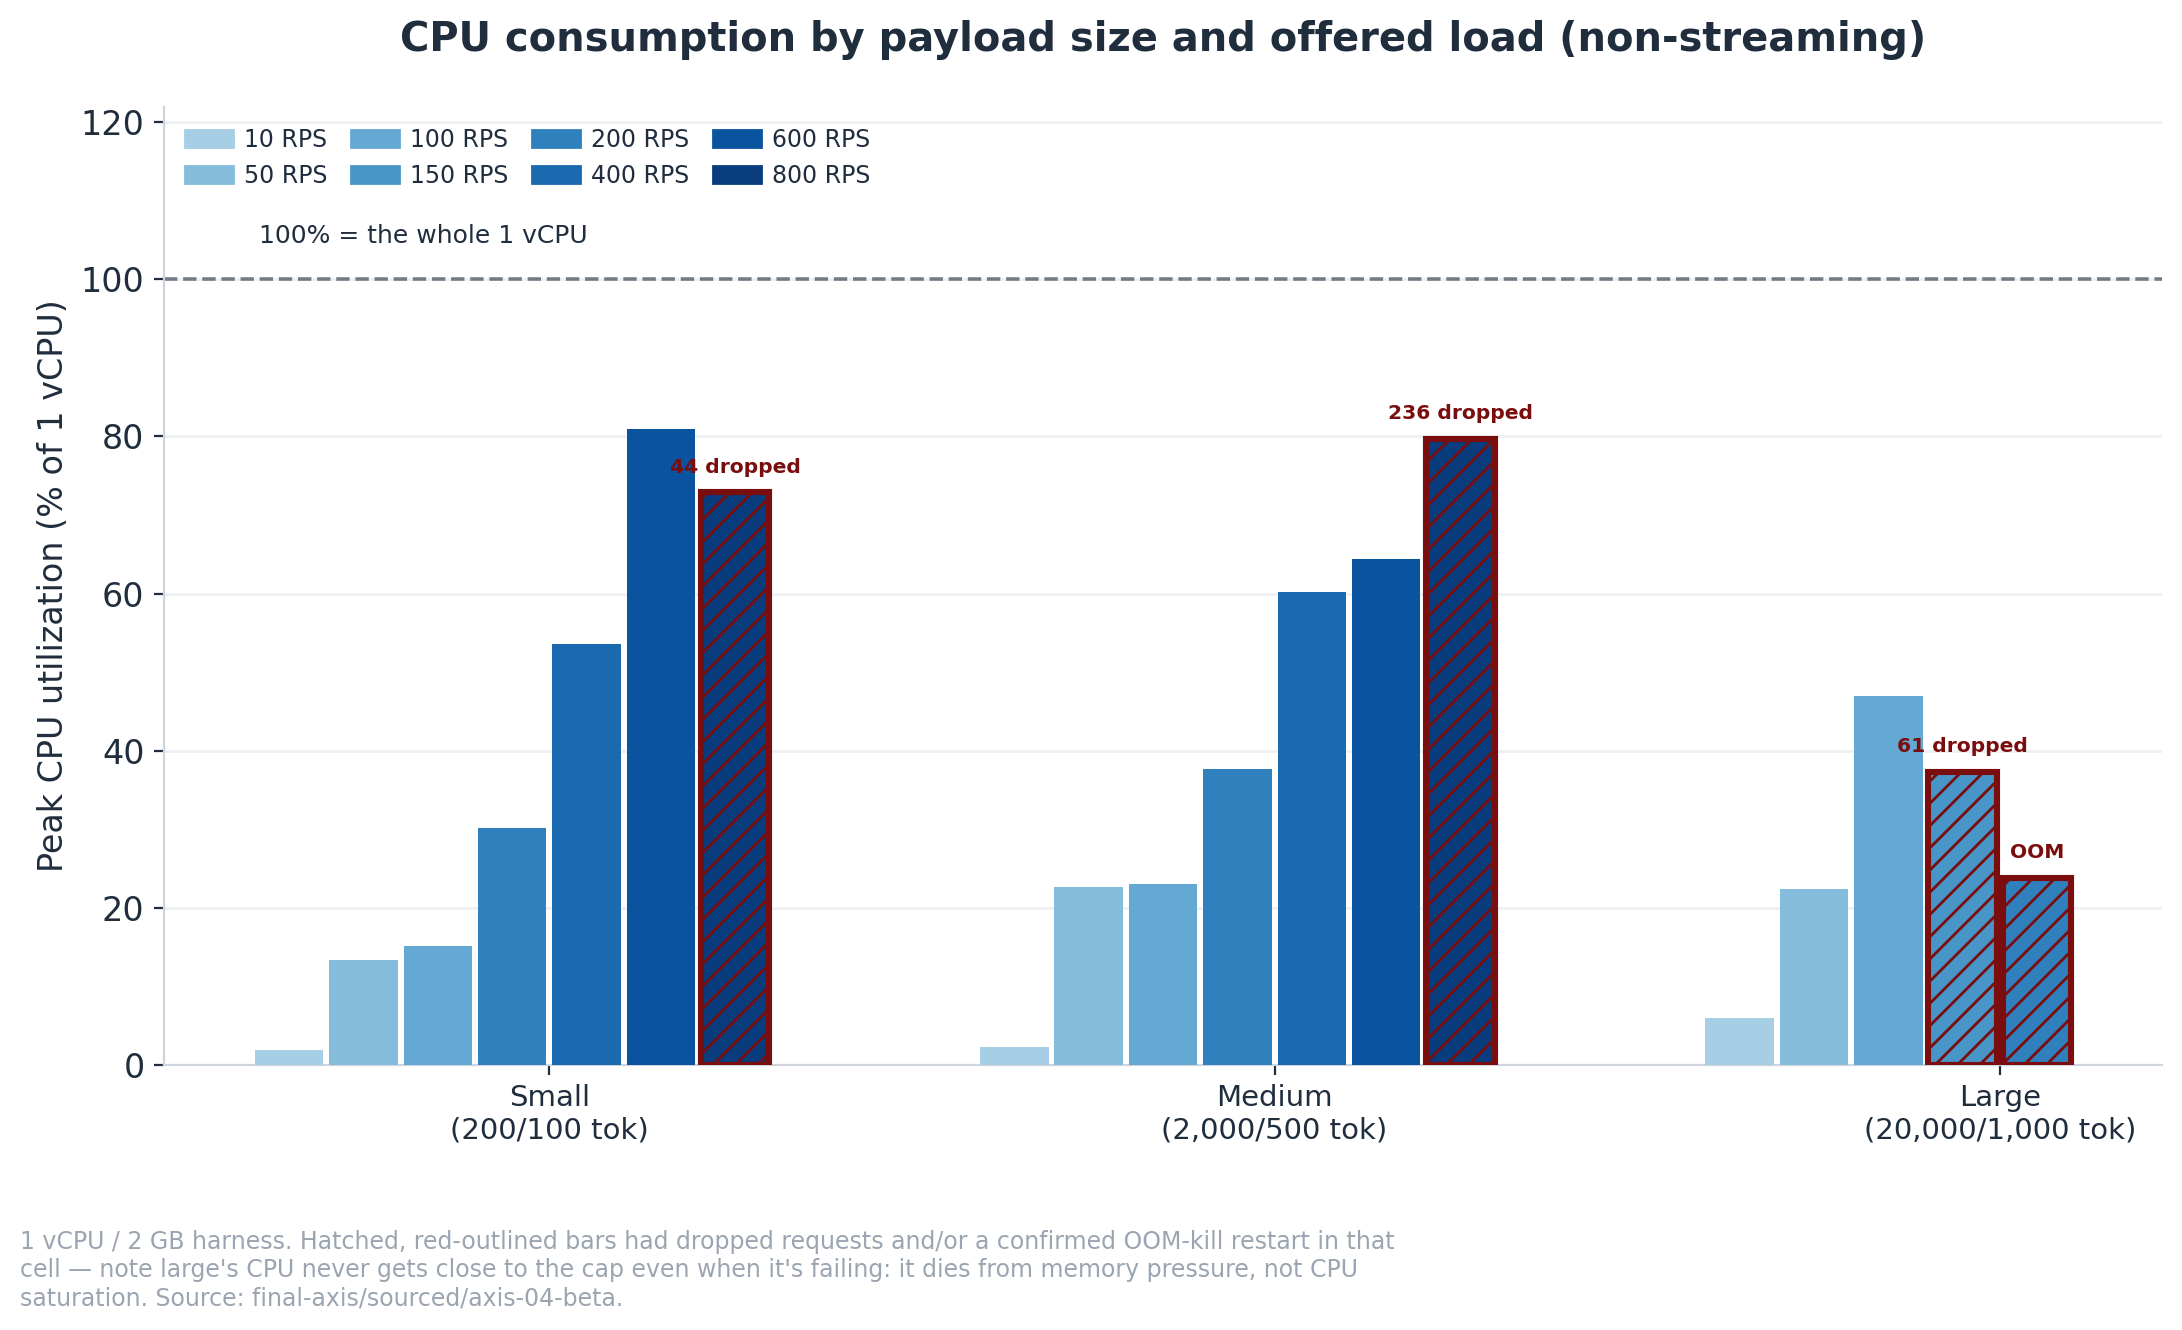
Les petites et moyennes grimpent toutes deux dans la plage des 73–80 % à leur RPS le plus élevé — véritablement limitées par le CPU, sollicitant fortement le vCPU unique. La grande ne le fait jamais : même dans les cellules où elle abandonne activement des requêtes et subit des OOM-kills (entourées et hachurées en rouge), son CPU maximal plafonne à 37 % et 24 %. La grande n'échoue pas par manque de CPU — elle échoue parce que la mémoire est saturée, alors que le CPU conservait de la capacité disponible. Si votre charge de travail comporte de longs documents, c'est ce chiffre qu'il faut prendre en compte pour votre planification, et non le nombre de vCPU.
Un accès direct en correspondance exacte transforme un appel de ~59 ms en ~4 ms. Le caching sémantique — qui capte une répétition formulée différemment d'une même question — entraîne un coût d'embedding réel, mais reste deux fois plus rapide qu'un appel direct :
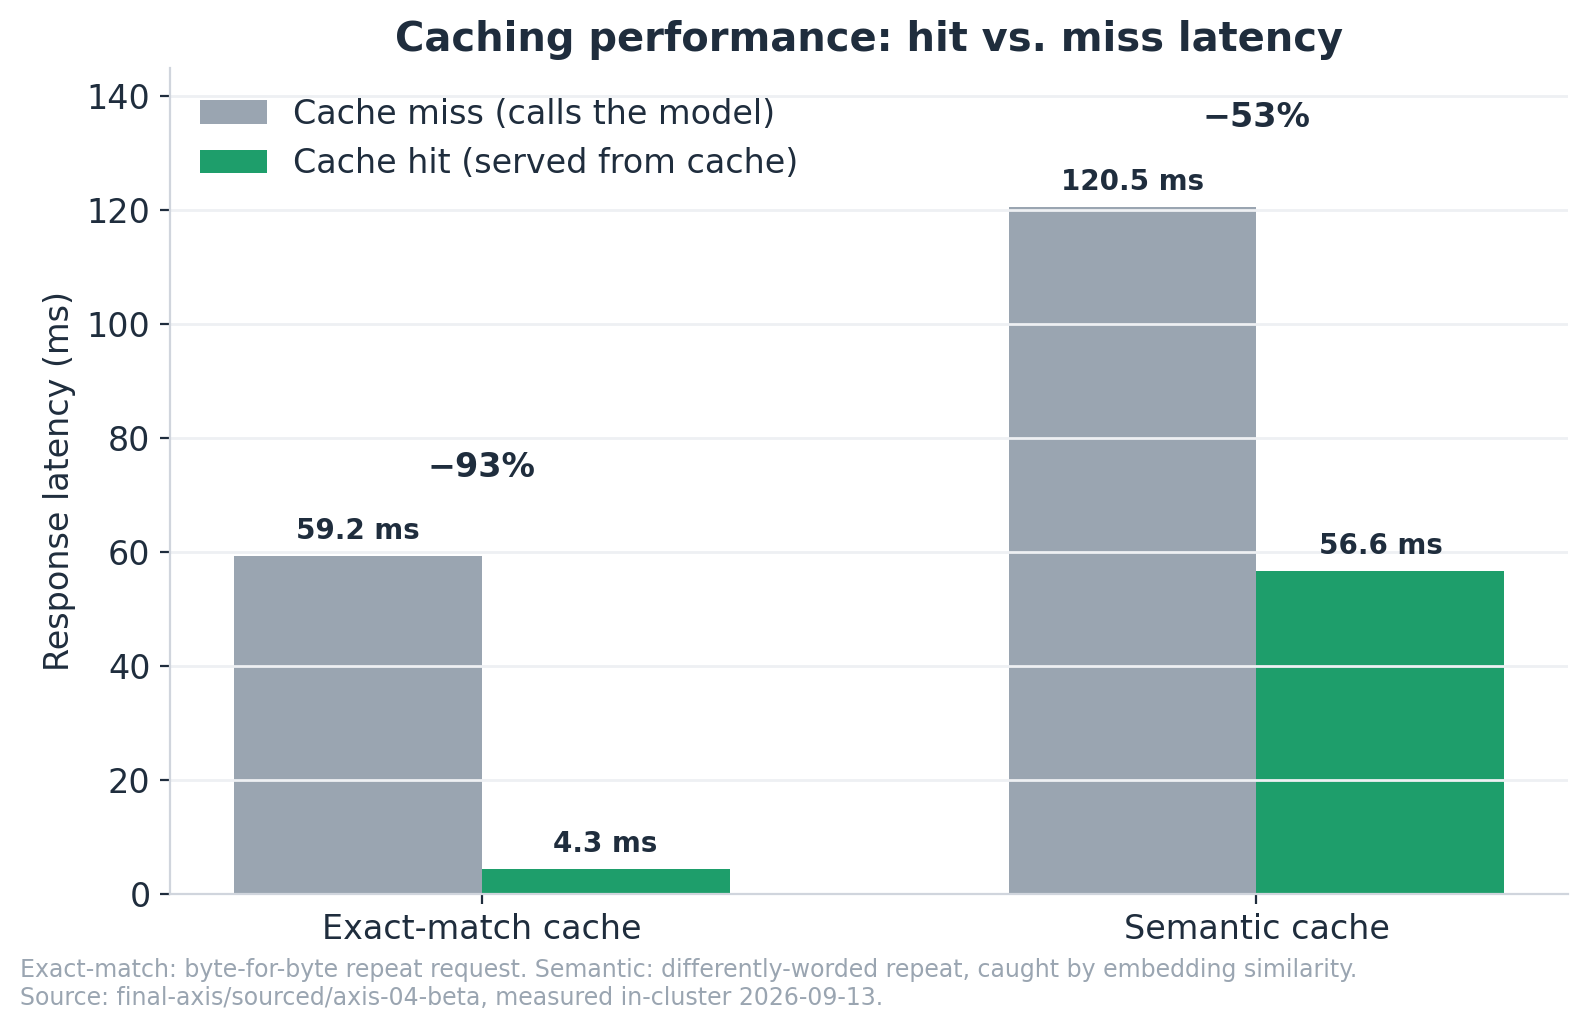
Aucun des deux résultats n'est surprenant en soi — le caching est censé être plus rapide que l'appel au modèle, et il l'est. Les chiffres présentés ici apportent la mesure exacte de ce gain : 93 % pour un hit en correspondance exacte, 53 % pour un hit sémantique une fois le coût de l'embedding payé.
Deux chiffres complémentaires : le cold start s'établit à une médiane de 8,7 secondes, dont 8,2 secondes sont consacrées au re-téléchargement obligatoire du catalogue à chaque redémarrage dans une configuration conteneurisée classique — un point qui peut être corrigé avec du stockage persistant, non re-testé ici.
Une note de transparence sur les chiffres ci-dessus : concernant la cellule des petites charges utiles, nous avons détecté et corrigé un bug dans notre propre banc de test (une interaction réseau liée à l'algorithme de Nagle qui rendait notre ligne de base instable) — après correction, le plafond des petites charges utiles de Bifrost est en réalité remonté, passant de ~400 à ~600–800 RPS. Nous le mentionnons car c'est le genre de détail facile à manquer lors du benchmarking d'une gateway, Bifrost inclus, et nous préférons exposer notre démarche plutôt que de masquer la correction.
Sur une seule instance, l'overhead de Bifrost est particulièrement bas à la médiane : 2 à 6 ms en plus d'un appel upstream de ~55 ms, stable quelle que soit la taille du payload et presque constant face à la charge. C'est la version justifiable de l'affirmation « la gateway la plus rapide », et elle a sa valeur — rapportée à la durée d'un véritable appel LLM, cette valeur devient négligeable. La queue de latence présente un comportement différent. La p99 ajoutée dépend fortement de la charge, atteignant +41 à +75 ms aux plafonds mesurés, et les grandes charges utiles ne se ralentissent pas progressivement : elles s'arrêtent net sous le coup d'OOM-kills à 150 RPS, entraînant des pertes de requêtes. Le caching fonctionne comme annoncé (réductions de latence mesurées de 93 % et 53 %). Le chiffre de 5 000 RPS mis en avant par le fournisseur décrit une machine plus puissante et une charge de travail différente de ce que la plupart des équipes déploient. Ainsi, pour un nœud unique : la vitesse médiane ne pose pas de problème — la latence p99 sous charge et la marge mémoire sur le trafic à forte densité de documents en posent en revanche.
La question principale est de savoir ce qui se passe lorsque vous exécutez plusieurs nœuds. Une gateway en production doit pouvoir passer à l'échelle, réduire sa voilure et supporter la perte d'un pod de manière transparente. Sur la version open source, c'est là que les difficultés apparaissent. Les modifications de configuration ne se propagent pas en direct entre les répliques ; le fonctionnement documenté implique un fichier de configuration partagé suivi d'un redémarrage. Chaque modification de routage, rotation de clé ou mise à jour de budget se transforme ainsi en un déploiement coordonné sur l'ensemble de vos pods de gateway, plutôt qu'en un simple changement d'option. Si l'on ajoute un tableau de bord d'administration accessible à toute personne pouvant l'atteindre jusqu'à la création du premier compte administrateur, la version open source s'avère plus adaptée à un nœud unique étroitement surveillé qu'à une flotte de conteneurs.
Bifrost Enterprise comble une grande partie de cet écart : son maillage gRPC diffuse les changements de configuration à chaque réplique en quelques secondes, sans aucun redémarrage. Cependant, même la version Enterprise reste une infrastructure que vous devez déployer, faire évoluer, patcher et surveiller vous-même. L'achat de la licence ne transfère pas la charge opérationnelle à un tiers.
La vraie décision ne consiste donc pas à savoir si « Bifrost est rapide », mais plutôt « qui va l'administrer ? ». Une équipe disposant de ressources dédiées aux opérations/DevOps, ou soumise à des exigences strictes de maintien de l'ensemble des composants dans son propre environnement, peut exploiter Bifrost efficacement, idéalement sur la version Enterprise si elle nécessite plus d'une réplique. Une petite équipe ayant simplement besoin d'une gateway fiable devant ses appels LLM tirera généralement plus de bénéfices d'une offre gérée que de la gestion en propre de l'exploitation de sa gateway.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





