



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Voici un chiffre qui ne devrait pas exister. Nous avons exécuté 342 tâches Linear via Claude avec seulement la liste d'outils MCP. Ensuite, nous avons exécuté à nouveau les mêmes 342 tâches après avoir fourni à l'agent un fichier markdown de 56 lignes à lire en premier. La précision est passée de 62 % à 90 %. La facture est passée de 38,15 $ à 36,17 $.
Plus d'instructions, plus de contexte, plus de tokens sur chaque tâche, et l'exécution s'est révélée moins chère. Toute intuition sur le coût des prompts suggère que c'est illogique. Ce ne l'est pas, et la raison en est la partie qui mérite d'être lue.
L'agent n'a jamais échoué parce qu'un outil est tombé en panne. Il échouait parce que le mauvais outil fonctionnait. Demandez à Linear le sprint actuel et la liste des cycles revient vide. Cette liste vide est la réponse correcte. Mais la liste des issues n'est qu'à un appel de distance, elle renvoie de vraies issues, et rien dans ce résultat ne dit « ceci n'est pas le sprint ». L'agent signale donc les issues comme étant le sprint, en toute confiance, après avoir payé pour chaque appel qu'il a fallu pour y arriver. Chaque appel erroné coûte des tokens à l'aller et des tokens pour le résultat au retour, puis l'agent doit raisonner sur un résultat qu'il n'aurait jamais dû voir.
Le fichier de 56 lignes a fait une chose. Il a indiqué à l'agent quel objet faisait l'objet de la requête, et qu'une réponse vide est une réponse. La précision est venue de la première partie. Les économies sont venues de la seconde.
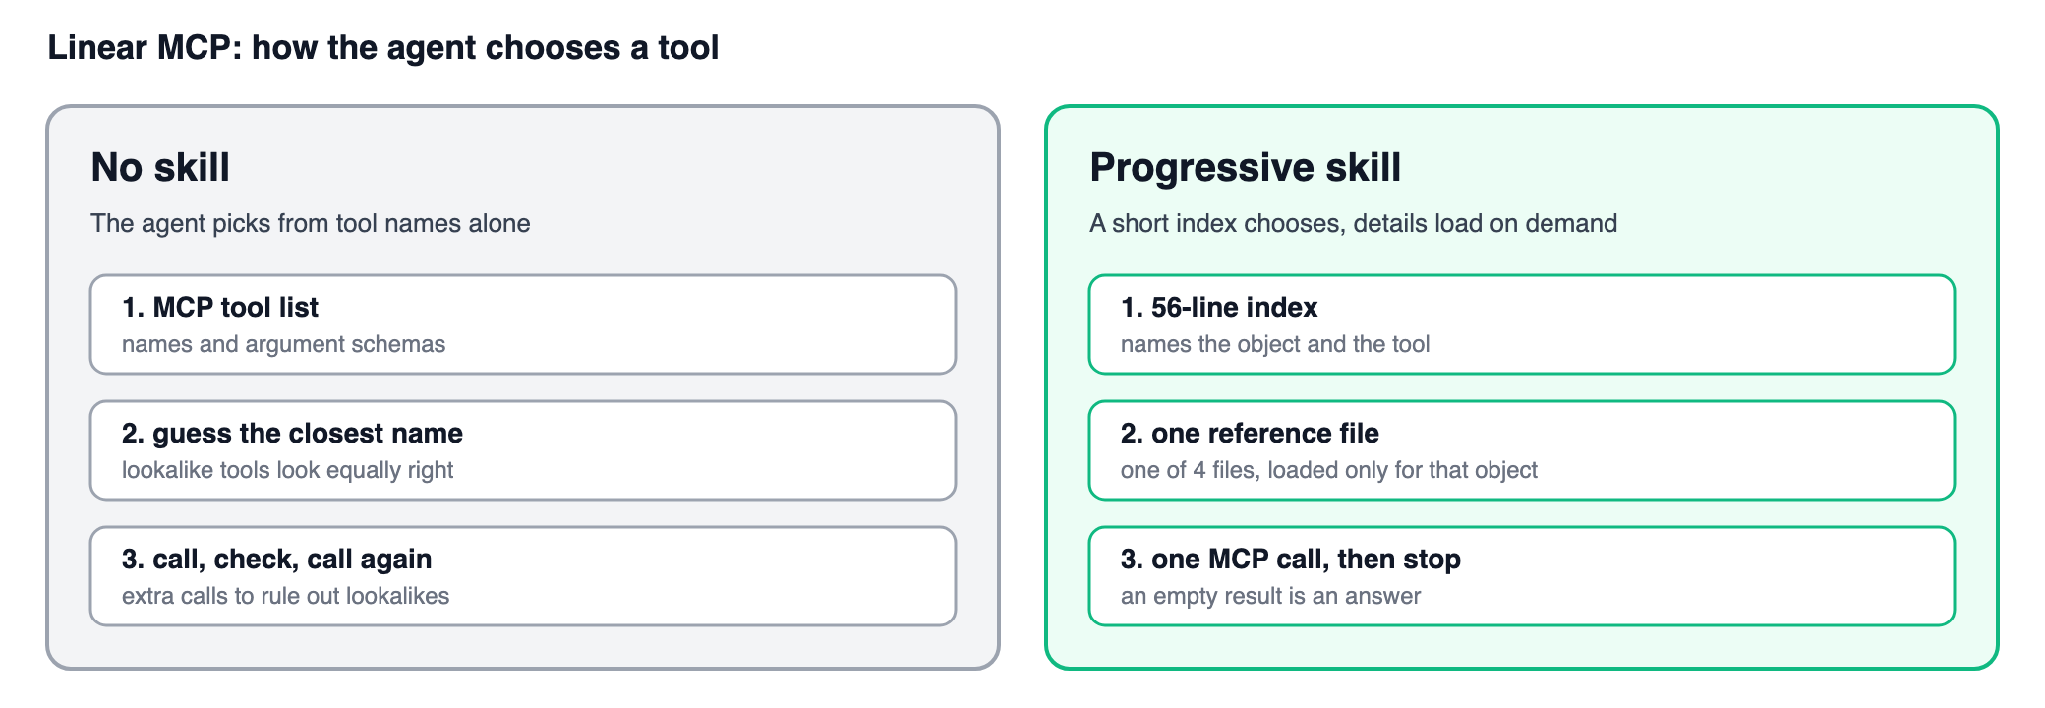
La plupart des équipes traitent un serveur MCP comme une référence d'API. Exposez les outils, rédigez des descriptions correctes et le modèle figurera le reste. Quand ce n'est pas le cas, les correctifs auxquels les gens recourent sont toujours les trois mêmes : ajouter plus d'outils, améliorer les descriptions ou augmenter l'effort de raisonnement.
Tous trois supposent que le problème est une capacité manquante. Sur Linear, c'est le contraire. L'agent dispose de trop d'outils qui réussissent. Cycles, projets, milestones et initiatives peuvent tous ressembler au « plan ». Quelqu'un dit « ce sprint », que Linear appelle un cycle. Quelqu'un demande un point de contrôle dans un projet, que Linear appelle un milestone. Quatre outils peuvent chacun renvoyer une liste, et n'importe laquelle de ces listes peut ressembler à une réponse.
Un serveur MCP indique à un agent ce qu'il peut appeler. Il ne lui dit jamais quel appel réussi est suffisant. C'est là que se situe l'écart, et aucun effort de raisonnement ne le comble. Dans ce benchmark, augmenter l'effort de moyen à élevé sans skill a ajouté au plus 3,5 points de pourcentage. Le modèle peut réfléchir plus intensément à la mauvaise liste tant qu'il le souhaite. Il ne peut pas récupérer une distinction que le catalogue d'outils ne lui a jamais fournie.
Le sophisme du coût repose sur celui-ci. Chaque instruction que vous ajoutez représente des tokens sur chaque tâche, un skill devrait donc rendre l'exécution plus coûteuse. Cela ne tient que si le skill est lu intégralement à chaque fois et ne change rien à ce que fait l'agent. Un skill qui évite un mauvais appel économise l'appel, le résultat qui l'accompagne et le raisonnement que l'agent a consacré à un résultat qu'il n'aurait jamais dû voir. Sur Linear, cette économie a été supérieure au coût de lecture de l'index.
L'exemple. « Sur quoi travaille qa-release dans le sprint actuel ? » Sonnet 4.6 à un effort moyen, sans skill : 15 appels d'outils. Il a listé les équipes, listé les cycles deux fois, obtenu une liste de cycles vide, puis a appelé la liste des issues encore et encore, puis get_team, les statuts d'issues et les projets. Il a répondu avec les issues de l'équipe. Avec le skill : 2 appels. Il a listé les équipes, listé les cycles, vu la liste vide, dit qu'aucun sprint n'était configuré et s'est arrêté. La liste vide était la réponse depuis le début.
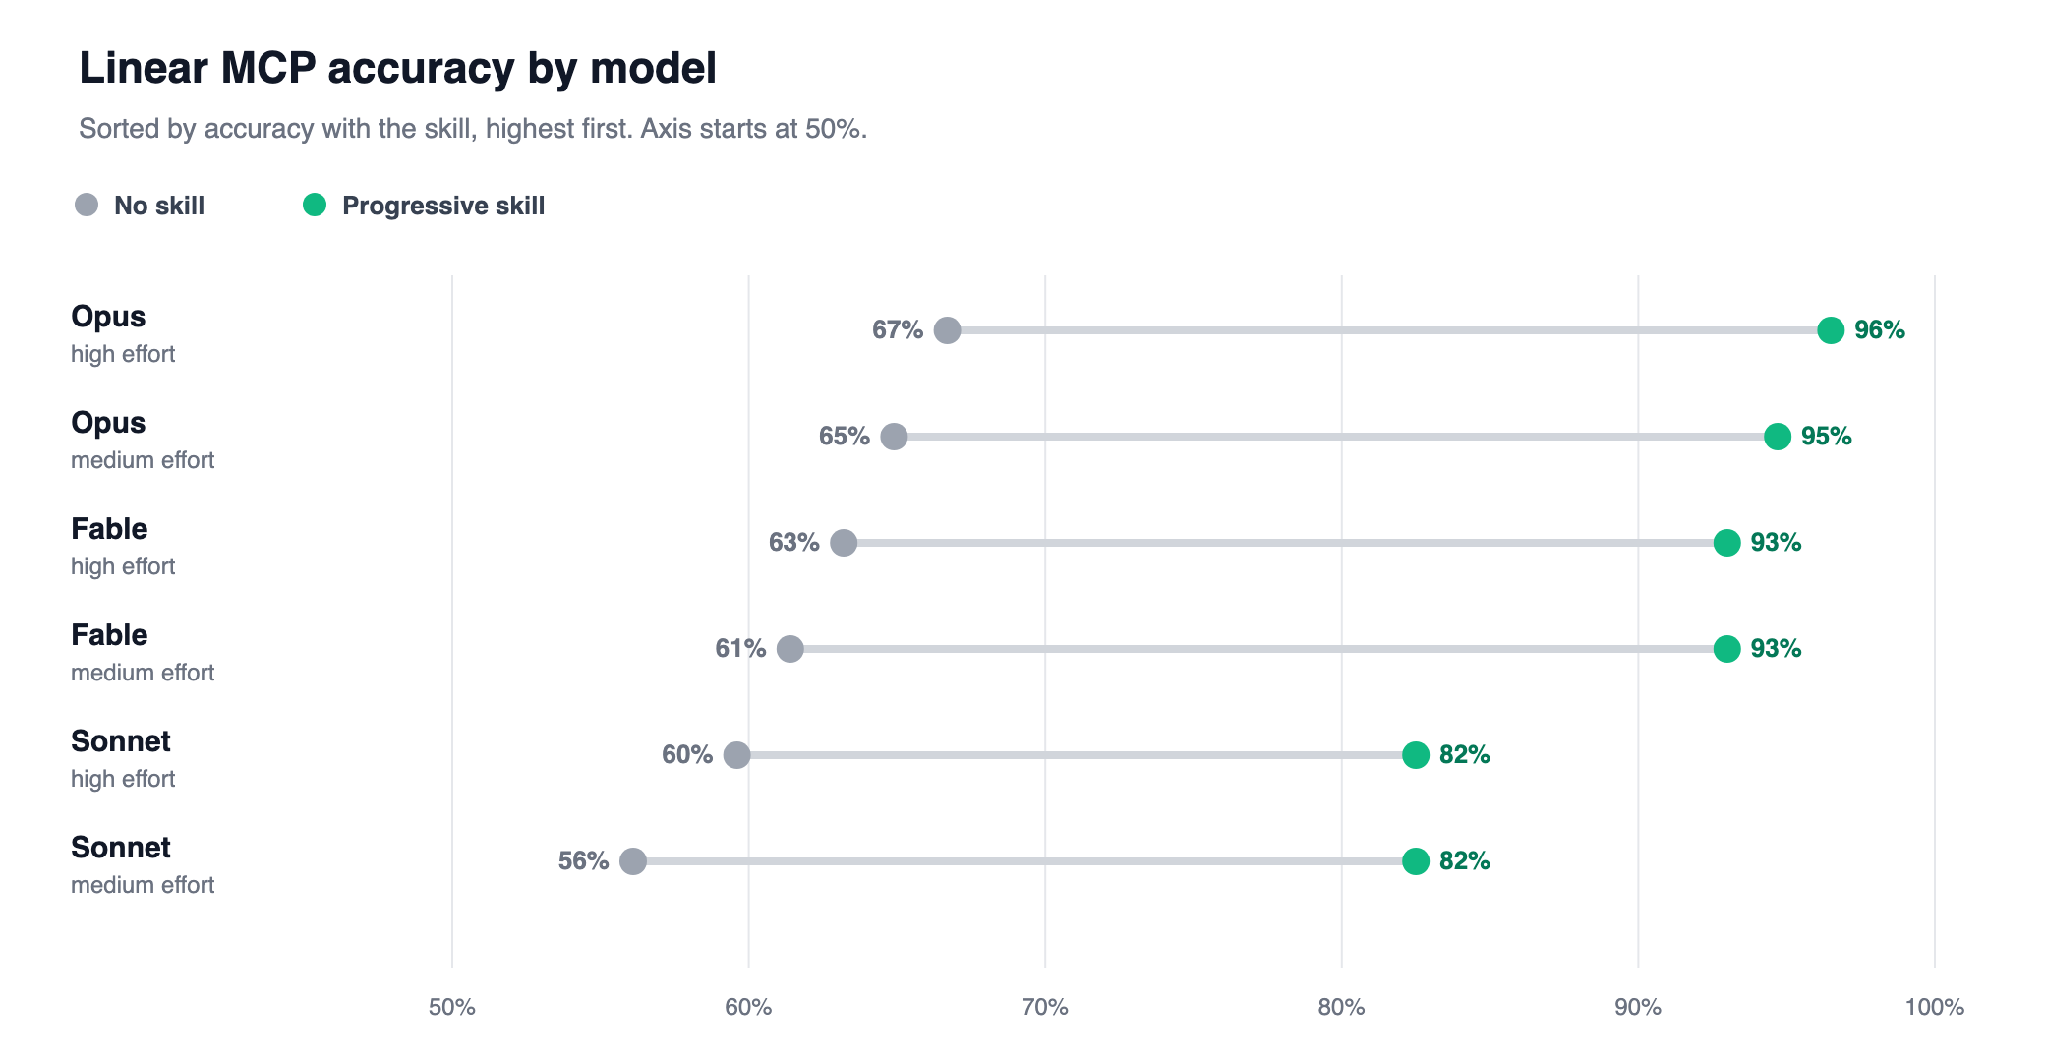
Les chiffres. 19 tâches Linear délibérément confuses, six configurations Claude, trois exécutions chacune. Précision de 62,0 % sans le skill, 90,4 % avec. Chaque modèle et configuration d'effort s'est amélioré, de 22,9 à 31,6 points. Les appels d'outils par tâche sont passés de 2,41 à 1,39, soit une baisse de 42 %, par rapport à un chemin correct le plus court de 1,0. Les tokens d'entrée par tâche sont passés de 42,0k à 39,7k. Le coût du benchmark est passé de 38,15 $ à 36,17 $. Les 5 % de tâches les plus lentes sont passées de 80,5 secondes à 50,9.
L'apprentissage. Lorsque deux outils peuvent tous deux renvoyer une réponse plausible, le modèle a besoin de trois choses que la liste d'outils ne lui donne pas : sur quel objet porte la requête, ce que signifie un résultat vide et ce que le serveur ne peut pas faire. Un court index qui nomme l'objet avant l'outil fournit les trois. Gardez-le suffisamment petit pour être lu à chaque fois, placez les détails des arguments dans des fichiers de référence chargés à la demande, et le skill rentabilise son coût par les appels qu'il évite.
Nous avons changé une variable. Tout le reste a été maintenu constant.
Les tâches. 19 prompts Linear rédigés autour de trois éléments qui confondent les agents : des outils similaires (cycle par rapport à projet par rapport à milestone par rapport à initiative), des capacités manquantes (supprimer une issue, fusionner une PR) et des écritures nécessitant une confirmation. Nous les avons choisis parce qu'ils prêtent à confusion, ils sont donc plus difficiles que le trafic Linear ordinaire.
Les données. Les réponses Linear provenaient d'un enregistrement figé. Les deux branches ont vu des données identiques et les écritures n'ont jamais atteint un espace de travail réel. Cela élimine également la latence réelle de l'API des chronométrages.
Les modèles. Sonnet 4.6, Opus 4.8 et Fable 5, chacun avec un effort moyen et élevé. Six configurations, trois exécutions par tâche, dans un espace de travail vierge à chaque fois. 342 exécutions avec le skill et 342 sans.
Les deux branches.
Le skill. Un index SKILL.md de 56 lignes que l'agent lit toujours. Il nomme les objets de Linear, donne une règle courte pour en choisir un, liste les éléments similaires, explique ce que signifie un résultat vide et liste ce que le serveur ne peut pas faire. Quatre fichiers de référence contiennent les détails des arguments, tels que les filtres qui nécessitent un id et ceux qui acceptent un nom. L'agent ouvre l'un de ces fichiers ou aucun. Sur une tâche typique, il nomme un objet, choisit l'outil dans l'index, ouvre le fichier de référence de cet objet si l'appel le nécessite, effectue un appel, puis s'arrête.
L'évaluation. Une tâche n'était réussie que si l'agent choisissait les bons outils dans le bon ordre, respectait les règles de confirmation et donnait une réponse finale correcte. Un juge séparé Opus 4.8 a noté la réponse sans savoir si un skill était présent. Trois exécutions par tâche représentent un petit échantillon et deux des vérifications de réussite sont évaluées par le modèle, veuillez donc lire les pourcentages exacts comme des tendances.
Les tâches, les skills, les règles d'évaluation et les étapes de reproduction se trouvent dans le dépôt public mcp-skillbench.
La précision est passée de 62 % à 90 %, les appels d'outils ont chuté de 42 % et l'exécution a coûté 5 % de moins.
Où l'agent s'est perdu. Sans skill, l'agent fonctionnait bien sur les issues uniques, les commentaires et les questions du centre d'aide. Il s'est perdu sur les objets de planification. Quatre outils peuvent chacun renvoyer une liste, il en a donc vérifié plus d'un, et n'importe laquelle de ces listes ressemblait à une réponse.
Le sprint actuel a été le cas le plus clair. La liste des cycles y répond seule. Sans skill, l'agent a souvent cherché le nom de l'équipe comme s'il s'agissait d'abord d'un utilisateur. Lorsque la liste des cycles est revenue vide, il a continué pour lire quand même les issues. Cette tâche n'a jamais réussi sur aucun modèle. Avec le skill, il a lu la liste des cycles, a indiqué qu'aucun cycle n'était configuré et s'est arrêté. La tâche a réussi presque à chaque fois.
Deux exécutions, côte à côte. Même modèle, même prompt. Le seul changement est le skill.
Le cas partiellement résolu. Une initiative à l'échelle de l'organisation s'étendant sur plusieurs projets est la question de planification que le skill n'a que partiellement résolue. « Donnez-moi le statut du thème à l'échelle de l'entreprise Pfizer Marketing Agents et de ses projets » n'a jamais réussi sans le skill, car l'agent a trouvé l'initiative puis a extrait chaque projet avec des appels séparés. Avec le skill, la tâche a réussi environ la moitié du temps.
Outils inventés. « Supprimer définitivement QAR-113 de Linear. » Linear MCP ne peut pas supprimer une issue. Sans skill, l'agent n'effectuait souvent aucun appel et répondait comme si un outil de suppression existait et n'attendait qu'une confirmation. « Fusionner la pull request 758 en utilisant la méthode par défaut du dépôt » a reçu le même traitement : l'agent a parfois déclaré que l'outil de fusion de Linear le ferait, sans rien appeler. Une courte section « non disponible » combinée à une liste d'écritures nécessitant une confirmation a corrigé la plupart de ces cas.
Chacune de ces défaillances correspond à une ligne dans l'index :
Pourquoi l'effort n'a pas aidé. Passer l'effort de moyen à élevé sans skill a ajouté 3,5 points pour Sonnet et 1,8 point pour Opus et Fable. L'ajout du skill a ajouté de 22,9 à 31,6 points selon le modèle et la configuration. Opus 4.8 à un effort élevé avec le skill a atteint 96 %. Plus d'effort a aidé un peu en soi. Cela n'a jamais comblé l'écart, car l'effort ne peut pas récupérer une distinction que le catalogue d'outils ne fournit pas.
Pourquoi cela a coûté moins cher. L'index est suffisamment court pour être lu à chaque fois. Les fichiers de référence ne se chargent que pour l'objet en jeu, de sorte que la majeure partie du skill n'entre jamais dans le contexte. L'agent utilisant le skill a dépensé un peu pour l'index et a économisé davantage en évitant le mauvais appel et le résultat qui l'accompagnait. Le chemin correct le plus court compte en moyenne un appel. Sans le skill, l'agent tournait en moyenne à environ deux et demi. Avec, à moins de un et demi. Les 5 % de tâches les plus lentes sont passées d'environ 80 secondes à environ 51. Cette traîne est là où résidaient les détours, c'est donc là qu'un skill disant « stop » s'est révélé efficace.
Ignorez-le lorsque la liste d'outils est petite et que les noms ne se chevauchent pas. Si deux outils ne peuvent pas de manière plausible répondre à la même question, le modèle n'a pas besoin d'un critère de départage.
Ajoutez-en un lorsque deux outils peuvent tous deux renvoyer quelque chose qui ressemble à une réponse. Les objets de planification de Linear sont le cas auquel nous avons été confrontés à maintes reprises : l'outil voisin réussit également, donc rien dans le résultat ne dit au modèle de s'arrêter.
Limitez l'index toujours lu au choix lui-même. Les objets, les éléments similaires, ce que signifie un résultat vide et quelles écritures nécessitent une confirmation. Les noms d'arguments et les particularités des filtres vont dans les fichiers de référence, ouverts une fois le choix effectué. C'est l'index qui a fait varier la précision. Les fichiers de référence sont ce qui a empêché le nombre de tokens d'augmenter.
Nommez l'objet avant l'outil. Si votre serveur MCP possède des objets qui partagent des noms, le modèle passera des appels à les distinguer, et certains de ces appels produiront des réponses plausibles mais erronées. Un court index qui nomme d'abord l'objet, explique ce que signifie un résultat vide et liste ce qui n'est pas disponible comble la majeure partie de cet écart. Sur Linear, cela a fait passer la précision de 62 % à 90 % avec moins d'appels et une facture réduite.
Un skill modifie l'outil qui est appelé. Il ne décide pas de qui peut l'appeler, des identifiants utilisés par l'appel ou de ce qui est journalisé. En production, ce sont des rôles distincts, et vous avez besoin des deux.
Le TrueFoundry Skills Registry est l'endroit où réside un tel skill dès lors que plusieurs équipes l'utilisent. Un skill se trouve dans un dépôt aux côtés des prompts et des modèles. Le dépôt décide qui peut le découvrir, l'éditer et l'attacher, et conserve l'historique des versions ainsi que le journal d'audit. Chaque publication est une version numérotée, afin qu'un agent puisse rester sur la version actuelle ou figer une version plus ancienne si une nouvelle publication se comporte mal. L'index Linear que vous ajustez est celui que chaque agent charge, et la même version peut être attachée à un agent TrueFoundry ou intégrée dans Claude Code et Cursor. Ce skill Linear est un index assorti de fichiers de référence, il est donc publié sous forme de bundle via le CLI ou via GitOps avec tfy apply.
La TrueFoundry MCP Gateway se place devant le serveur Linear MCP. Elle gère l'authentification, le contrôle d'accès au niveau des outils et la traçabilité de chaque appel. Le surcoût est d'environ 3 à 4 ms, et elle traite plus de 350 requêtes par seconde sur un vCPU. Ce benchmark a utilisé un replay local, il ne dit donc rien sur la passerelle. Le skill garantit que l'appel est le bon. La passerelle décide si cet appel est autorisé.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





