



October 10, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: October 10, 2026
¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Dos cifras dominan la mayoría de las conversaciones sobre Claude Sonnet 4.5 y GPT-5. Anthropic fija el precio de Claude Sonnet 4.5 en 3 dólares por millón de tokens de entrada y 15 dólares por millón de tokens de salida. OpenAI fija el precio de GPT-5 en 1,25 y 10 dólares, respectivamente. GPT-5 gana claramente en la lista de precios publicada.
Las tarifas oficiales dicen poco sobre la producción real. Un agente de programación que vuelve a ejecutar una tarea fallida dos veces ya ha consumido el ahorro de tokens. Un flujo de trabajo de resumen con un prefijo estable de 40.000 tokens se comporta de forma distinta a un agente que reescribe el contexto en cada turno.
Ambos proveedores han ido más allá de estos lanzamientos. OpenAI describe GPT-5 como su modelo de razonamiento anterior y remite a los desarrolladores a GPT-5.6. Anthropic posiciona ahora modelos Claude más recientes por encima de Claude Sonnet 4.5 para muchas necesidades de desarrollo. Los equipos que codifican de forma rígida el nombre de cualquiera de estos modelos generan deuda de migración desde el principio.
Ambos modelos están dirigidos a cargas de trabajo de IA generativa avanzada, aunque sus enfoques de diseño son distintos. Leer el planteamiento de cada proveedor aporta más información que cualquier tabla de clasificación. La decisión práctica entre Claude Sonnet 4.5 y GPT-5 comienza por el caso de uso principal.
Anthropic ha posicionado a Claude Sonnet 4.5 en torno a tareas de programación exigentes, agentes de larga duración y uso informático. La nota de lanzamiento lo describe como un lanzamiento importante para agentes del mundo real, manteniendo los precios de 3 y 15 dólares de Claude Sonnet 4. El ID del modelo de la API es `claude-sonnet-4-5-20250929`, una instantánea fija en lugar de un puntero dinámico.
GPT-5 es el modelo de razonamiento de OpenAI para tareas de programación y agentes en diversos dominios, disponible a través de Chat Completions y la API de respuestas. Su instantánea es `gpt-5-2025-08-07`. El modelo acepta entradas de texto e imagen y devuelve texto, con soporte para tokens de razonamiento y un parámetro `reasoning.effort` que admite los valores `minimal`, `low`, `medium` y `high`.
Una diferencia práctica resulta evidente de inmediato. Según la documentación de OpenAI, GPT-5 no admite ajuste fino ni salidas predichas. Claude Sonnet 4.5 ofrece controles para agentes, incluido el pensamiento entrelazado a través de una cabecera beta para el razonamiento conectado a herramientas.
El precio es donde ambos modelos se diferencian con mayor claridad. Todas las tarifas que figuran a continuación provienen de la documentación de precios publicada por los proveedores. Aun así, los compradores deberían modelar los costes según su carga de trabajo, ya que los costes de entrada, la longitud de salida, el comportamiento de la caché y los reintentos afectan a la factura final.
Dos ratios son más importantes que las cifras absolutas. La entrada es 2,4 veces más cara en Claude Sonnet 4.5. La salida es 1,5 veces más cara. Dado que estas diferencias varían, el sobrecoste combinado depende del número de tokens que consuma y genere su carga de trabajo.
Tomemos 1.000 solicitudes con 30.000 tokens de entrada y 2.000 de salida cada una, sin caché. Claude Sonnet 4.5 cuesta 90,00 dólares por la entrada y 30,00 dólares por la salida. GPT-5 cuesta 37,50 dólares por la entrada y 20,00 dólares por la salida.
Esto nos lleva a una comparación de 120,00 dólares frente a 57,50 dólares. Claude cuesta 2,09 veces más en este ejemplo. La ventaja de costes de GPT-5 es clara en cuanto a la economía de tokens brutos, especialmente para flujos de trabajo de gran volumen como soporte, clasificación y gestión de contenidos.
Ahora, sirvamos el 90% de esa entrada desde la caché. Claude Sonnet 4.5 baja a 8,10 dólares por lecturas en caché, 9,00 dólares por entrada nueva y 30,00 dólares por salida. GPT-5 se sitúa en 27,13 dólares. El sobrecoste disminuye porque el almacenamiento en caché reduce la parte de la entrada.
La contabilidad de la caché es una trampa que merece la pena mencionar. Anthropic factura las escrituras en caché de cinco minutos a 1,25 veces la entrada base. La lista de precios publicada de GPT-5 de OpenAI no incluye un cargo separado por escritura en caché. Por lo tanto, los precios de los tokens de respuesta y la rotación de la caché pueden cambiar la elección más rentable.
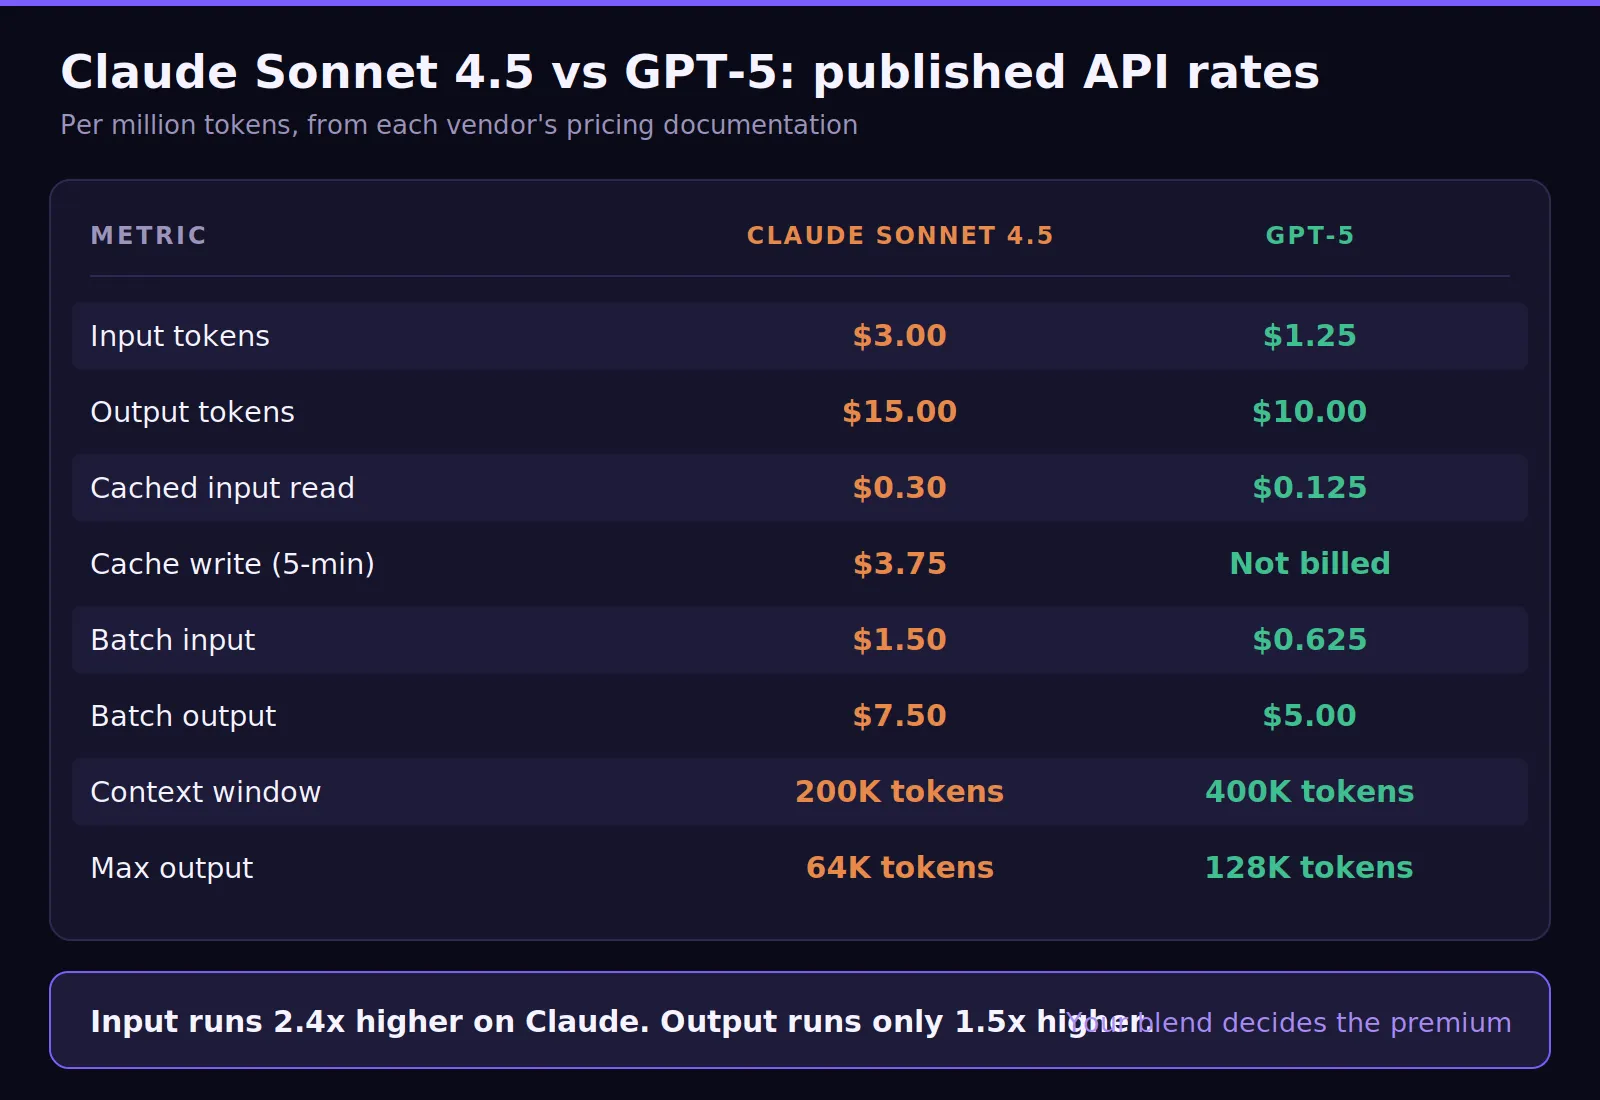
El coste responde a una pregunta. Si un modelo de IA puede mantener la tarea en memoria el tiempo suficiente para terminarla, responde a una pregunta más difícil. En la comparativa entre Claude Sonnet 4.5 y GPT-5, la ventana de contexto, los límites de salida y los controles de razonamiento merecen un análisis detallado.
La diferencia en el contexto es fácil de subestimar. GPT-5 acepta el doble de entrada y emite el doble de salida máxima. Esto es importante para grandes refactorizaciones, páginas de texto, flujos de trabajo complejos y seguimientos de agentes largos que llegan como una única tarea de gran tamaño.
Sonnet 4.5 responde con una funcionalidad de la que carece GPT-5. El comportamiento de reconocimiento de contexto de Anthropic inyecta el presupuesto restante del modelo directamente en la solicitud, como `<budget:token_budget>200000</budget:token_budget>` en el prompt del sistema y una `<system_warning>` continua después de cada llamada a herramientas. Los planes del modelo se basan en la capacidad real restante en lugar de estimarla.
Claude Sonnet 4.5 también admite razonamiento intercalado con herramientas a través de una cabecera beta. Esto ayuda en tareas de razonamiento complejo, razonamiento profundo, razonamiento científico, análisis financiero, razonamiento matemático y operaciones empresariales con agentes donde los resultados de las herramientas afectan al siguiente paso.
GPT-5 admite niveles de esfuerzo de razonamiento a través del modo estándar y configuraciones de razonamiento superior. Esto ofrece a los equipos otra forma de ajustar la latencia, la calidad analítica y la eficiencia de costes. El modelo adecuado sigue dependiendo de la calidad medida dentro de la carga de trabajo objetivo.
Los benchmarks pueden guiar la selección inicial, aunque no deben sustituir las pruebas internas. Artificial Analysis publica un índice de inteligencia y comparativas de modelos, mientras que otras fuentes cubren el rendimiento ART, la inteligencia de análisis y las puntuaciones de razonamiento especializado. Considéralos señales de partida, no pruebas de adquisición.
El posicionamiento de Anthropic se centra en la ingeniería de software, el uso de herramientas y el trabajo con agentes de larga duración. Esto hace que Claude Sonnet 4.5 sea relevante para la programación con agentes, la generación de código, la revisión de código y la operación autónoma. El modelo resulta especialmente interesante cuando la calidad reduce los ciclos de revisión.
En cualquier caso, trata la calidad del modelo como algo específico de la carga de trabajo. Los benchmarks de programación miden tareas públicas, mientras que tus ingenieros trabajan en repositorios privados. Las convenciones del repositorio, los grafos de dependencias, la cultura de revisión y la estructura de pruebas determinan si Claude Sonnet ofrece un rendimiento superior.
Ejecuta ambos modelos con los mismos 20 tickets internos y puntúalos con una rúbrica fija. Cuenta los intentos fallidos, los prompts de seguimiento, los errores de herramientas y las solicitudes de extracción (pull requests) aceptadas. Un modelo que cuesta más por llamada puede seguir siendo rentable si requiere menos revisiones.
La comparación más precisa rara vez es el resultado de una tabla de clasificación universal. Un equipo puede encontrar una clara ventaja de Claude en un repositorio y de GPT-5 en otro. Por eso, la respuesta a Claude Sonnet 4.5 frente a GPT-5 debe provenir de pruebas con cargas de trabajo reales.
Los precios por token publicados para GPT-5 se sitúan por debajo de Claude Sonnet 4.5 en entrada, salida, lecturas en caché y uso por lotes. Eso cambia la aritmética para cargas de trabajo de producción de alto volumen. La automatización de soporte, la clasificación, los controles de calidad del lenguaje natural y las herramientas internas suelen inclinarse hacia GPT-5.
La ventana de contexto más amplia de 400.000 tokens ayuda a otro tipo de carga de trabajo. Los procesos de tratamiento de documentos pueden caber en una sola llamada en lugar de fragmentar y unir respuestas. Menos fragmentos pueden significar menos uniones, menos fallos y menos pegamento operativo.
El coste por sí solo no debería decidir la elección. La calidad de salida, el comportamiento de reintento, la tasa de aciertos en caché y la revisión humana afectan al gasto total. El corte de conocimiento de GPT-5 también es anterior al de Claude Sonnet 4.5, lo cual puede ser importante para marcos de trabajo, API y flujos de trabajo empresariales más recientes.
GPT-5 también puede adaptarse a audiencias generales y casos de uso amplios de plataformas de IA. Puede admitir contenido similar en soporte, resúmenes, análisis y flujos de trabajo de CMS. Para la fundamentación en la Búsqueda de Google, Gemini 3 Pro, Cosmic AI u otro modelo especializado podrían convertirse en una comparación aparte.
La mayoría de los equipos plantean la decisión como una elección fija. Ese suele ser el enfoque equivocado. La mejor versión divide por carga de trabajo y luego se pregunta si un modelo debería encargarse de todo. Esto hace que la comparativa entre GPT-5 y Claude Sonnet 4.5 sea más útil operativamente.
Elige Claude Sonnet 4.5 cuando:
Elija GPT-5 cuando:
Elija una capa de modelo gobernada cuando:
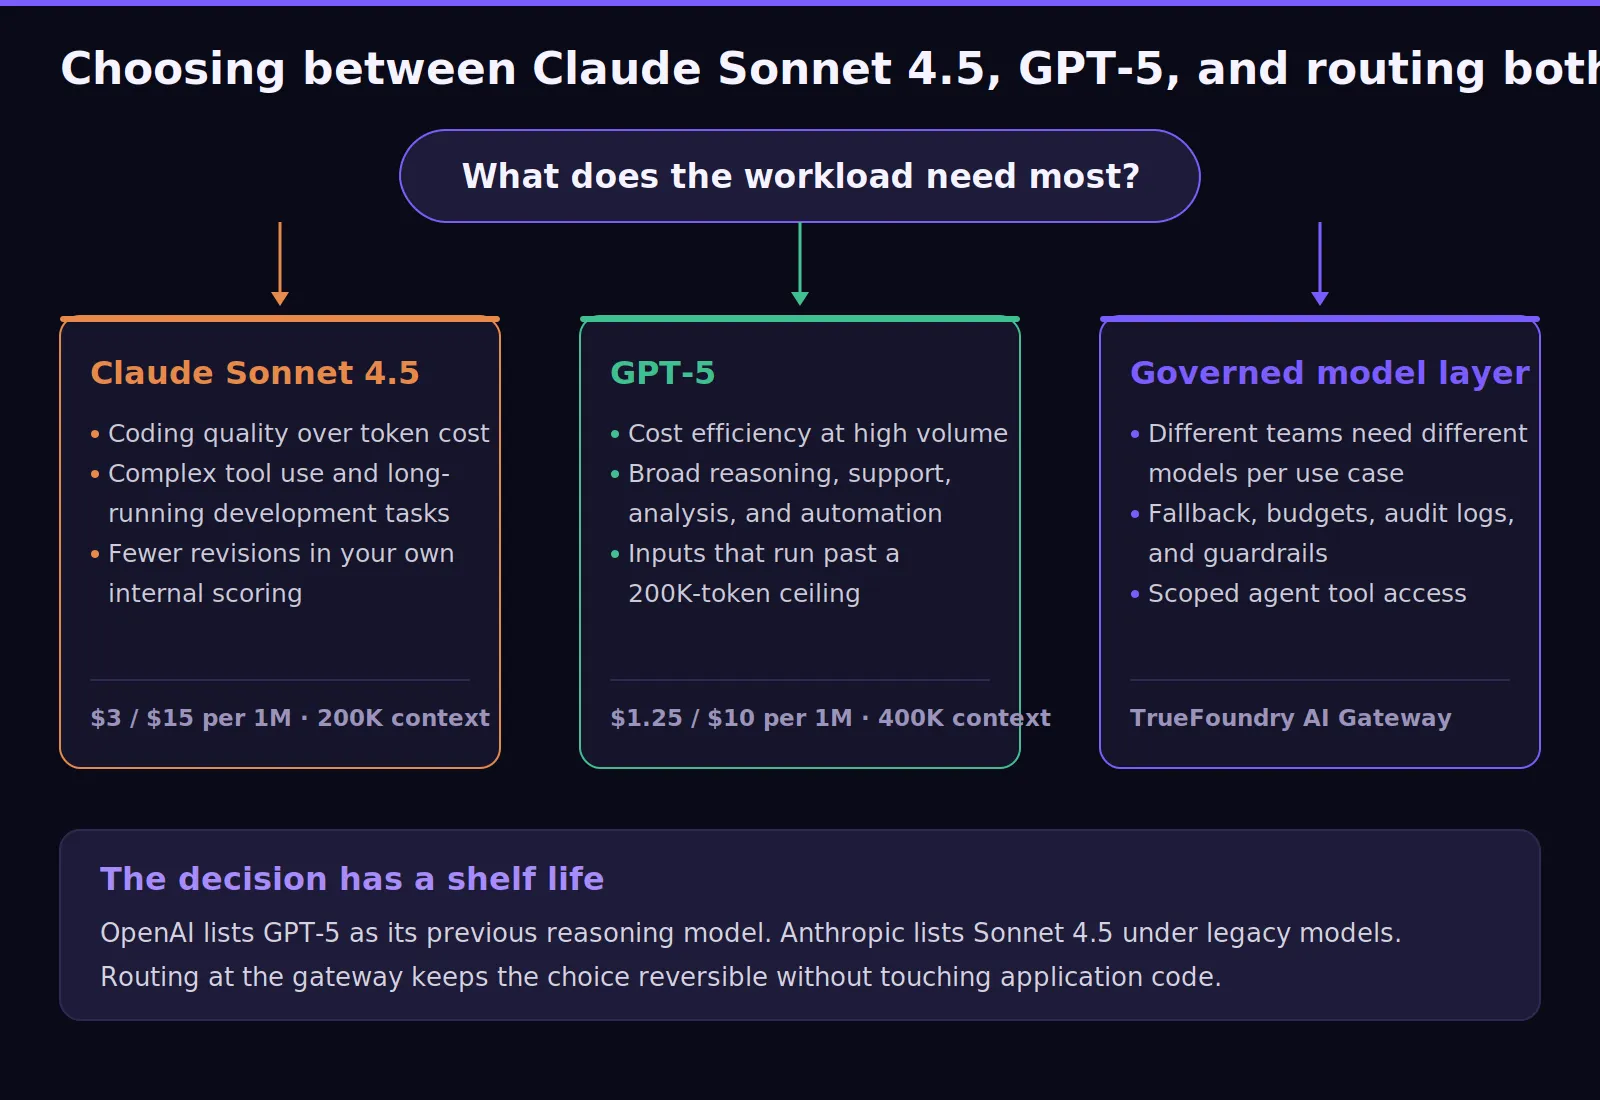
La comparación anterior tiene fecha de caducidad. GPT-5 ya lleva la etiqueta de un modelo anterior. Anthropic tiene modelos más nuevos después de Claude Sonnet 4.5. El panorama de la IA cambia rápidamente y TrueFoundry mantiene la rotación de modelos fuera del código de la aplicación.
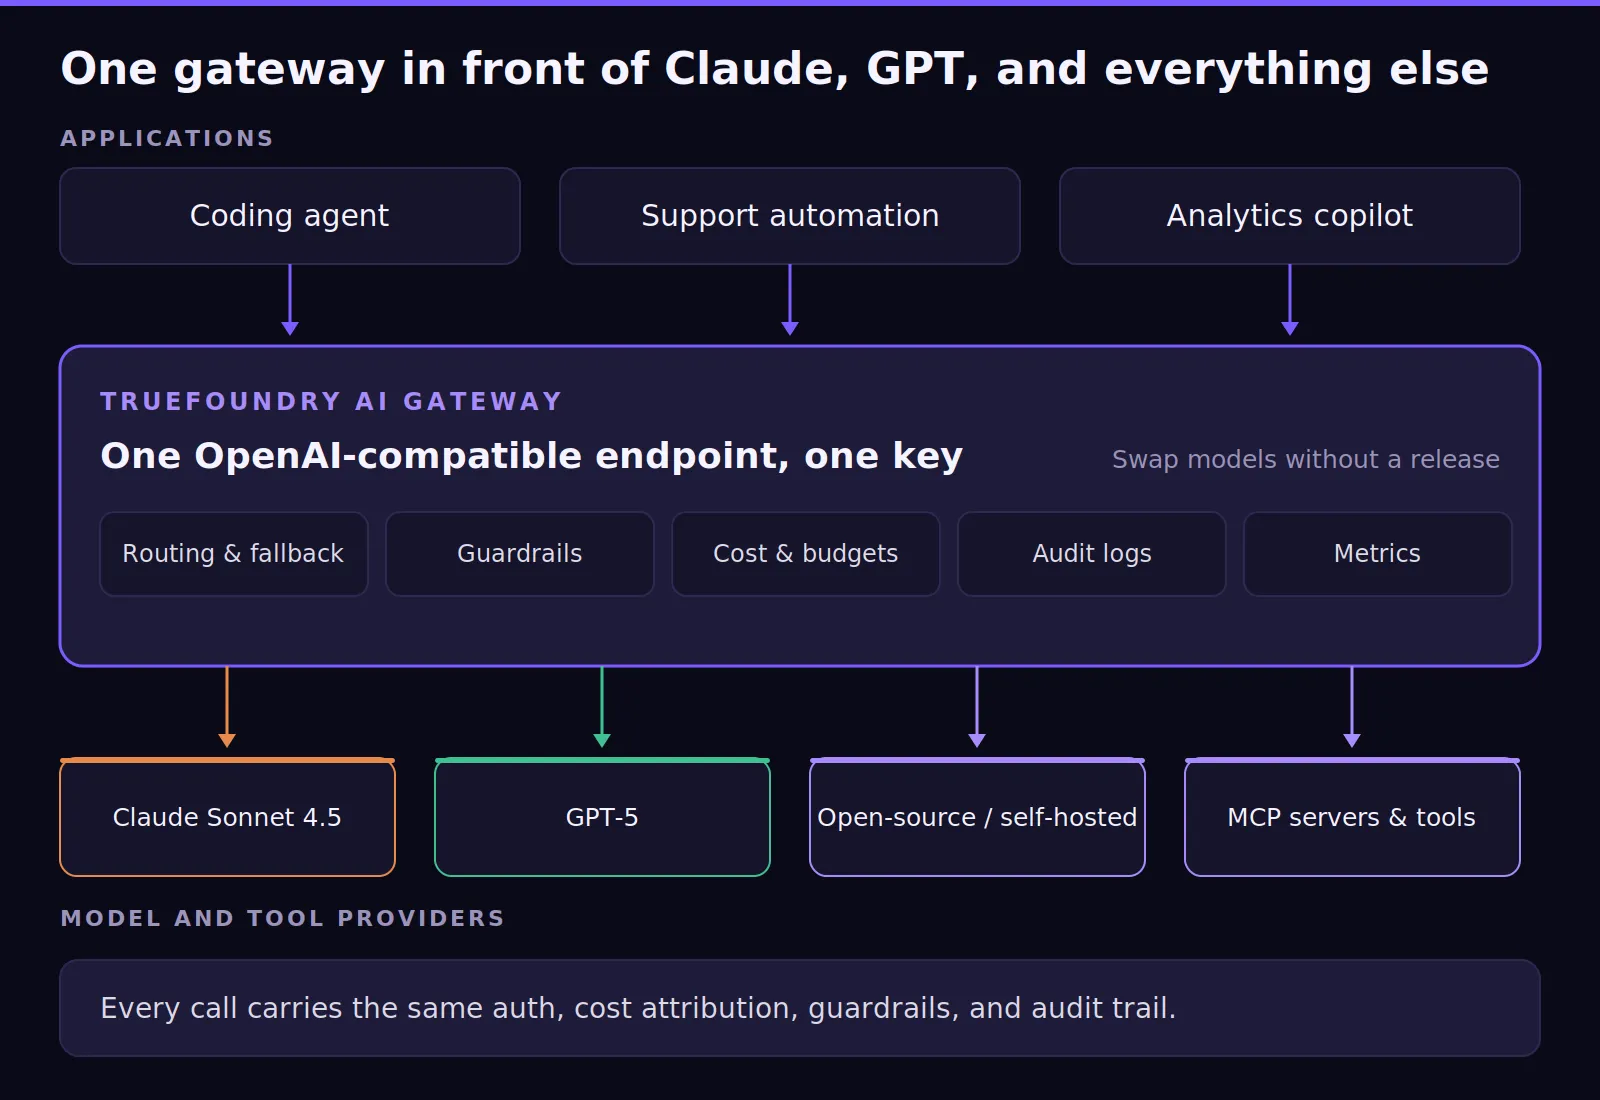
Los equipos pueden evaluar Claude Sonnet 4.5 y GPT-5 en función de la calidad, el coste, la latencia y la profundidad de razonamiento. La capa de gobernanza permanece independiente de ambos proveedores. De este modo, diferentes grupos pueden ejecutar distintos modelos para la programación, la automatización del soporte, la analítica y los copilotos internos.
Elpuerta de enlace de IA (AI Gateway) se sitúa entre las aplicaciones y los proveedores de modelos. Ofrece un único punto de conexión compatible con OpenAI, al tiempo que aplica autenticación, registro, medidas de seguridad y control de costes. Esta misma capa puede gestionar modelos de Claude, GPT, de código abierto y autohospedados.
from openai import OpenAI

client = OpenAI(
    api_key="your-truefoundry-pat",
    base_url="https://{your-gateway-host}/api/llm/api/inference/openai",
)

# Same client, same call shape, different backend model.
for model in ["anthropic-main/claude-sonnet-4-5", "openai-main/gpt-5"]:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Refactor this handler for idempotency."}],
        extra_headers={"X-TFY-METADATA": '{"team":"platform","environment":"staging"}'},
    )
    print(model, response.usage)
Pasarela LLM para enrutamiento multimodelo.Elpuerta de enlace de LLM (LLM Gateway) enruta las solicitudes entre proveedores a través de una interfaz única, de modo que GPT-5 puede encargarse de resúmenes de gran volumen mientras Sonnet 4.5 gestiona las rutas de codificación y agentes. Un modelo virtual proporciona un nombre único y estable para ambos, convirtiendo el cambio de destino en una modificación de configuración en lugar de un nuevo lanzamiento.
routing_config:
  type: priority-based-routing
  load_balance_targets:
    - target: anthropic-main/claude-sonnet-4-5
      priority: 0
      retry_config:
        attempts: 2
        delay: 100
        on_status_codes: ["429", "500", "503"]
      fallback_status_codes: ["429", "500", "502", "503"]
    - target: openai-main/gpt-5
      priority: 1
      fallback_candidate: true
Las reglas se evalúan en orden y la primera coincidencia es la que prevalece. La configuración `retry_config` por destino gestiona los fallos transitorios del mismo modelo, mientras que `fallback_status_codes` redirige la solicitud cuando es poco probable que los reintentos funcionen. TrueFoundry también detecta un destino con problemas basándose en sus solicitudes, tokens y fallos por minuto, y lo aparta temporalmente para un periodo de enfriamiento.
Pasarela MCP para un acceso seguro a herramientas.ElMCP Gateway regula cómo las aplicaciones y los agentes acceden a herramientas, API, bases de datos y sistemas empresariales. El acceso restringido es fundamental cuando un agente basado en Claude o GPT puede recuperar registros, llamar a servicios o activar flujos de trabajo.
Pasarela de agentes para la gobernanza a nivel de flujo de trabajo.ElAgent Gateway añade gobernanza a nivel de flujo de trabajo en tareas autónomas. Ayuda a controlar el comportamiento multipaso, los límites de ejecución, la mensajería entre agentes y el seguimiento consciente de la sesión. Los bucles descontrolados y las acciones inseguras se convierten en telemetría, no en sorpresas a final de mes.
Medidas de seguridad, control de costes y pistas de auditoría. Convierten a GPT-5 y Claude Sonnet 4.5 en una decisión de producción regulada. El panel de métricas puede informar sobre la latencia, el tiempo hasta el primer token, el coste de inferencia, los tokens de entrada, los tokens de salida, las métricas de caché y los bloqueos por límite de presupuesto.
Esa capacidad convierte la comparación en una respuesta operativa en lugar de una opinión puntual. Dirigir el 10% del tráfico a otro modelo y analizar el coste por tarea resuelta es mucho más eficaz que leer una lista de precios. Además, ayuda a los equipos a tomar decisiones fundamentadas.
Mantenga la flexibilidad en la elección de modelos mientras la gobernanza de producción permanece constante. Reserve una demostración para ver cómo TrueFoundry enruta modelos de Claude, GPT, código abierto y personalizados a través de una única pasarela de IA gobernada.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada




















