


September 18, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: October 7, 202615
¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
La portabilidad de los agentes de IA es la capacidad de mantener la lógica de un agente intacta aunque cambie el modelo subyacente. El agente hace referencia a un modelo por su nombre y llama a una interfaz estable. Qué proveedor atiende realmente la solicitud y qué credenciales se utilizan son aspectos que quedan totalmente fuera del agente.
Compárelo con el punto de partida habitual. Un agente se escribe utilizando el SDK de un proveedor específico, la clave de API del proveedor reside en el entorno del agente y el nombre del modelo aparece disperso por todo el código. Cada uno de estos elementos es un vínculo que ata al agente a un proveedor concreto. La portabilidad es lo que se consigue al romper esos tres vínculos.
La ventaja es práctica: puede adoptar un modelo más reciente el mismo día de su lanzamiento, recurrir a un segundo proveedor cuando el primero sufra una caída, dirigir las solicitudes económicas a un modelo más pequeño y mantener modelos autohospedados y comerciales tras la misma interfaz. Nada de esto debería requerir modificar el agente.
Para un chatbot de una sola interacción, cambiar de modelo ya es casi una tarea de una sola línea. Los agentes aumentan la dificultad por varias razones que merece la pena mencionar, ya que determinan lo que debe gestionar una buena capa de portabilidad.
Una capa de portabilidad que solo intercambia la cadena del modelo pero deja las credenciales, el enrutamiento y las alternativas de respaldo dentro del agente no ha hecho que el agente sea realmente portátil. Solo ha trasladado el problema.
El enfoque de TrueFoundry consiste en gestionar el acceso al modelo una sola vez, en la puerta de enlace de IA (AI Gateway), y permitir que cada agente haga referencia a los modelos por su nombre. La pasarela almacena las credenciales del proveedor, aplica políticas de acceso y enruta el tráfico. Los agentes heredan todo esto.
Todos los modelos, ya sean de OpenAI, Anthropic, Azure OpenAI, Google Vertex, AWS Bedrock, Databricks, Together AI o uno que usted mismo aloje, se sitúan detrás de una única API compatible con OpenAI. Solo tiene que apuntar su código a la pasarela una vez y cambiar de modelo modificando el nombre en la solicitud. Misma URL, mismas credenciales.
from openai import OpenAI

client = OpenAI(
    api_key="your-truefoundry-api-key",   # a gateway token, never a provider key
    base_url="https://gateway.truefoundry.ai",
)

# Today:
resp = client.chat.completions.create(
    model="openai-main/gpt-4o",
    messages=[{"role": "user", "content": "Draft the release notes"}],
)

# Tomorrow, swap the model. Nothing else changes:
resp = client.chat.completions.create(
    model="anthropic-main/claude-sonnet-4",
    messages=[{"role": "user", "content": "Draft the release notes"}],
)
El código del agente no ha cambiado de forma significativa. Las credenciales tampoco han cambiado. La única modificación es el nombre del modelo, e incluso eso puede abstraerse, que es el siguiente punto.
En el Agent Harness de TrueFoundry, el modelo es una selección en el constructor, no un valor en el código. Puedes elegir cualquier modelo habilitado para ti en la pasarela (gateway), y el cambio se realiza con un solo clic, sin editar código ni añadir nuevas credenciales.
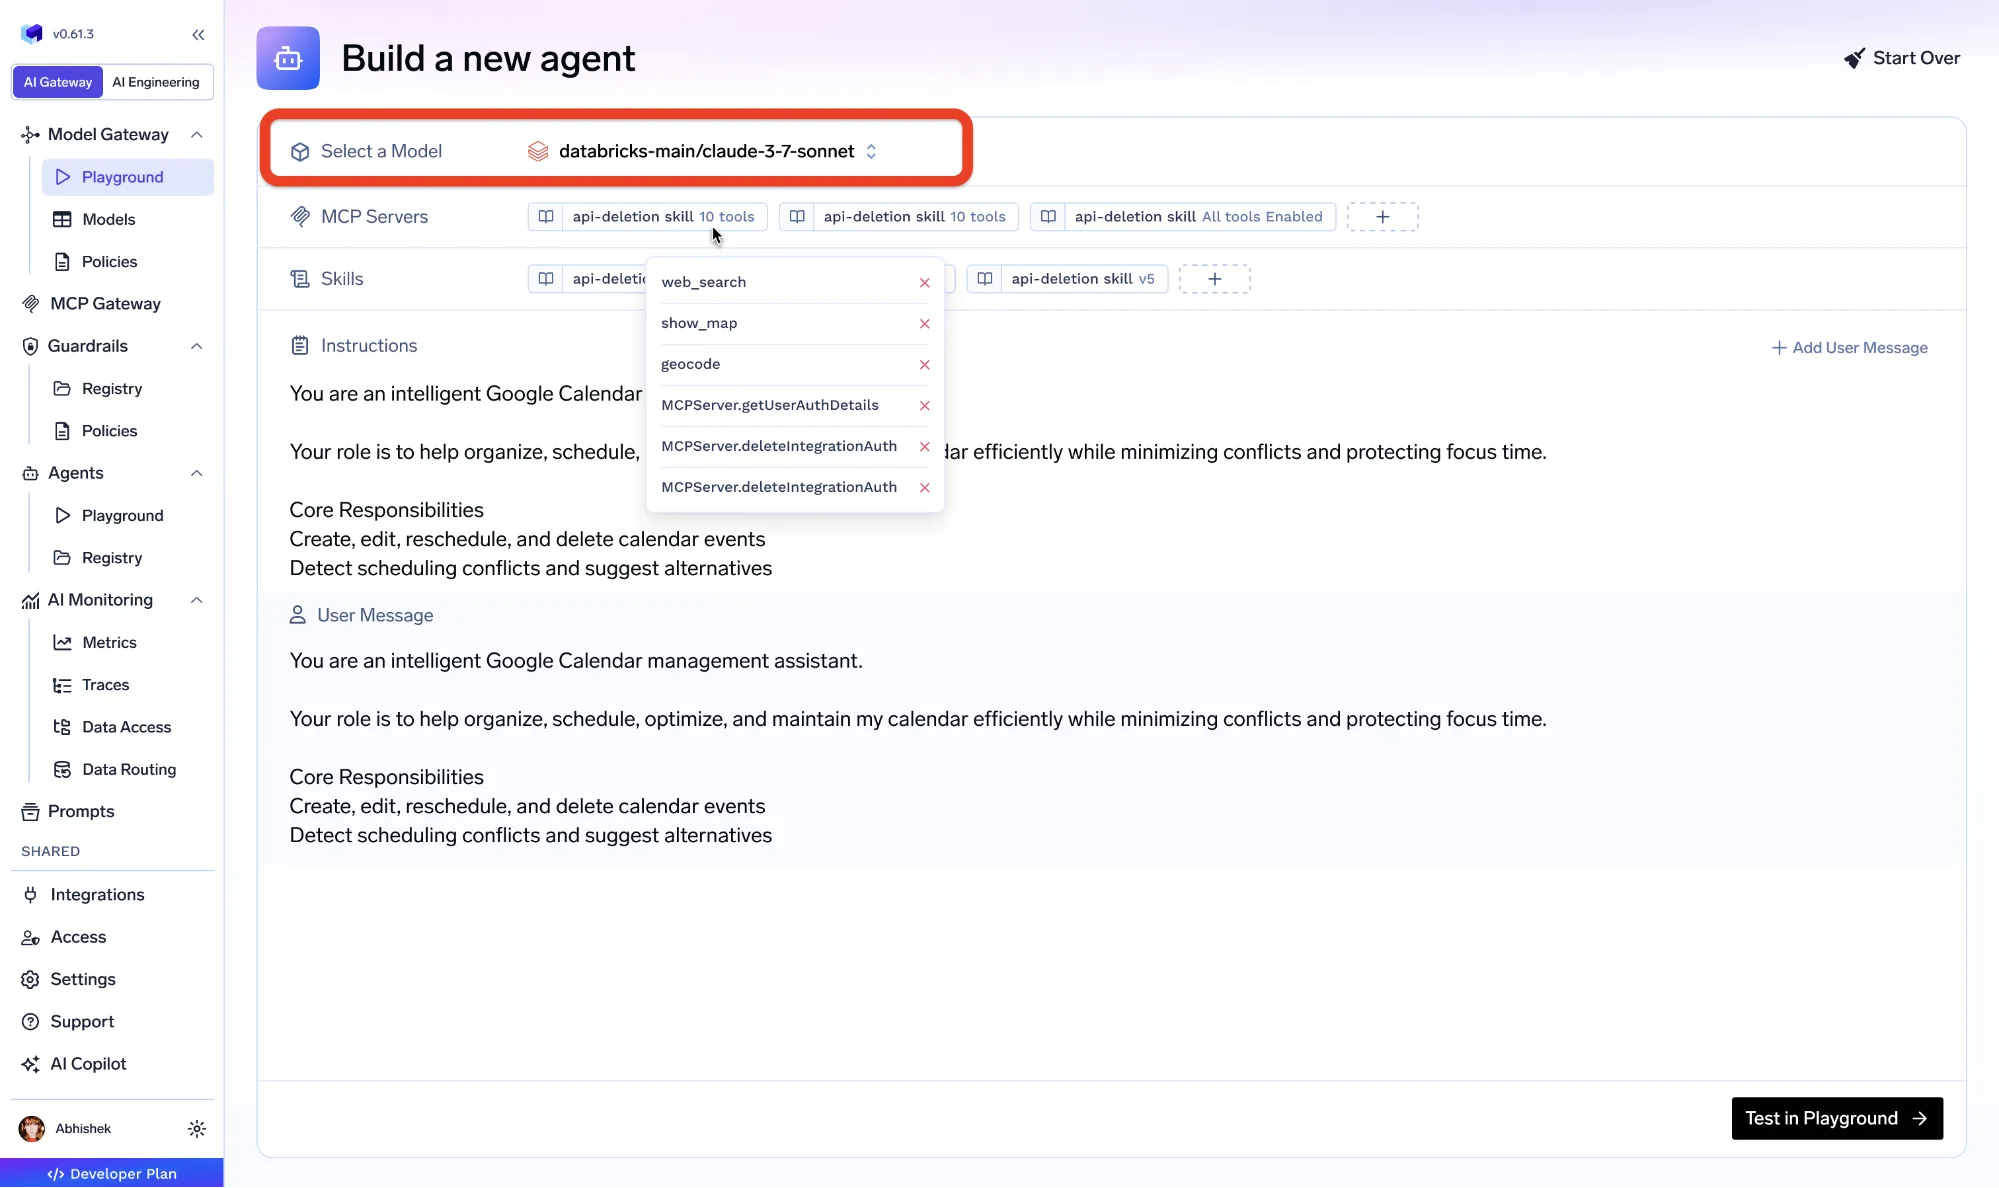
La diferencia con otros productos de agentes gestionados radica en dónde residen las credenciales. En muchos de ellos, debes proporcionar las claves API del proveedor al crear un agente o registrarlas por espacio de trabajo. En TrueFoundry, el acceso a los modelos se gestiona una sola vez en la capa de la pasarela y los agentes simplemente hacen referencia a los nombres de los modelos.
Dado que la gobernanza reside en la pasarela, un equipo de plataforma puede añadir un nuevo proveedor, rotar una clave o cambiar una política sin que nadie tenga que tocar la definición de un agente. Eso es portabilidad a nivel de flota, no solo para un único agente.
La portabilidad no consiste solo en cambios manuales. Un modelo virtual permite que un agente llame a un nombre estable mientras la pasarela decide qué modelo real atiende cada solicitud, utilizando enrutamiento basado en peso, prioridad, latencia o complejidad, con reintentos y alternativas de respaldo entre proveedores integradas. Si un proveedor devuelve un error o agota el tiempo de espera, la solicitud pasa automáticamente al siguiente candidato, por lo que una caída en un proveedor no deja a tus agentes fuera de servicio.
name: smart-chat
type: gateway-load-balancing-config
rules:
  - id: primary-with-fallback
    type: priority-based-routing
    when:
      models: ["my-group/smart-chat"]
    load_balance_targets:
      - target: openai-main/gpt-4o
        priority: 1
        fallback_status_codes: ["429", "500", "502", "503"]
      - target: anthropic-main/claude-sonnet-4
        priority: 2      # takes over automatically if the primary fails
El enrutamiento automático va un paso más allá al clasificar cada solicitud como simple, media o compleja y enviarla al modelo más económico capaz de procesarla. En las pruebas de rendimiento de TrueFoundry, esto redujo los costes entre un 50 y un 70 por ciento manteniendo aproximadamente un 98 por ciento de la calidad. El agente sigue llamando a un único nombre de modelo. La portabilidad es lo que convierte todo esto en una decisión de configuración en lugar de una reescritura.
La razón estratégica para preocuparse por la portabilidad es la ventaja competitiva. Cuando cambiar de proveedor es un cambio de una sola línea, nunca te quedarás atrapado con un modelo que se ha vuelto más caro, más lento o que simplemente ha sido superado. Puedes realizar una comparativa entre dos modelos con tráfico real de agentes, desviar un porcentaje de las solicitudes al modelo aspirante con enrutamiento basado en peso y promocionarlo cuando gane, todo ello sin necesidad de un proyecto de migración.
También permite que los modelos autohospedados sean ciudadanos de primera clase. Dado que la pasarela gestiona los modelos de pesos abiertos en backends como vLLM de la misma forma que las API comerciales, un agente puede moverse entre un modelo de frontera alojado y un modelo que se ejecuta en tu propio clúster sin notar la diferencia. Esa opcionalidad es difícil de recuperar una vez que los agentes están vinculados a un solo proveedor, por lo que integrar la portabilidad desde el principio es más importante de lo que parece. Se combina de forma natural con identidad de agenteycontrol de acceso: el agente sigue siendo el mismo principal con los mismos permisos, independientemente del modelo que lo atienda.
La pasarela realiza todo esto en la ruta crítica sin convertirse en un cuello de botella, añadiendo aproximadamente de 3 a 4 ms de sobrecarga y manteniendo más de 350 RPS en una sola vCPU a través de más de 1.000 modelos.
La portabilidad de agentes de IA convierte la constante agitación de los lanzamientos de modelos de una carga en una ventaja. Cuando el modelo detrás de un agente es un nombre que la pasarela resuelve, y no un SDK y una clave integrados en el código, puedes adoptar el mejor modelo del mes, recurrir a otros proveedores durante una caída y dirigir el tráfico económico a modelos más pequeños, todo sin reconstruir nada. Eso es lo que mantiene a una flota de agentes flexible en lugar de estancada.
Descubre cómo TrueFoundry permite a tus agentes cambiar entre más de 1.000 modelos desde un único plano de control. Reserve una demostraciónoempezar gratis.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada





















