



November 6, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
El ámbito de los agentes tiene un problema de vocabulario. Tras una etapa en la que conceptos como "harness", "scaffold", "skill" y "agente" significaban algo distinto en cada conversación, Hugging Face publicó un glosario ampliamente difundido que dota al sector de un vocabulario de trabajo muy útil. Merece la pena leerlo. Sin embargo, un glosario responde a la pregunta "¿qué significa esta palabra?", mientras que la siguiente cuestión —la que realmente afrontan los equipos de plataforma— es: "¿dónde reside este elemento en mi stack?". Este artículo toma ese vocabulario práctico y vincula cada término con la pieza de la infraestructura de producción que lo implementa. Los conceptos proceden de un vocabulario comunitario emergente; la integración técnica es lo que los equipos de producción deben concretar.
Elif, responsable de ingeniería de plataformas, observó cómo una reunión de dirección consumía cuarenta minutos en una pregunta que no debería haber llevado ni cinco: "¿cuántos agentes tenemos?". Ingeniería contó los despliegues de harness y dijo que nueve. El equipo de datos contó los prompts con herramientas y dijo que más de treinta. Una presentación de un proveedor contó cada flujo de trabajo con una llamada a un LLM y dijo que doscientos. Nadie se equivocaba según su propia definición; nadie compartía una definición. En la misma reunión surgieron dudas sobre si una "habilidad" (skill) era una herramienta (tool), si el nuevo "subagente" (sub-agent) era un agente a efectos de inventario y qué estaba comprando exactamente el equipo cuando un producto indicaba "harness incluido". La conclusión de Elif no fue que sus compañeros fueran descuidados. Fue que la terminología del sector había avanzado más rápido que su comprensión compartida y que, hasta que las palabras no estuvieran vinculadas a elementos del stack, cada conversación sobre arquitectura sería en secreto una disputa sobre vocabulario.
La comunidad ha estado trabajando para aclarar estas definiciones, de forma muy visible en el glosario de agentes de Hugging Face, que surgió precisamente de este tipo de confusión en ICLR 2026 y en el que nos apoyaremos (dándole el debido crédito) a lo largo de este texto. Lo que aporta este artículo es la segunda columna que Elif necesitaba: para cada término, el componente de producción que lo implementa y la gobernanza que se le aplica una vez que se convierte en infraestructura real y no en una mera etiqueta de diagrama. Esto no sustituye al glosario de Hugging Face; es la columna de infraestructura junto a él. Recorreremos el stack de dentro a fuera —modelo, scaffold, harness, agente— y, a continuación, el vocabulario de trabajo que lo rodea: ingeniería de contexto, el espectro herramienta/habilidad/subagente, la política y los términos de entrenamiento que resultan ser relevantes también en producción. Tras este artículo se incluyen cuatro análisis detallados; esta es la guía de referencia.
Comencemos donde empieza el glosario. El modelo es el propio LLM: entrada y salida de texto, sin memoria entre llamadas, sin bucle, sin capacidad para ejecutar nada por sí mismo. Puede expresar la intención de llamar a una herramienta (emitiendo una solicitud estructurada), pero algo externo debe ejecutar esa herramienta y devolverle el resultado. Llamar al modelo "el agente" es el error categórico de origen: el modelo es el motor de razonamiento y, por sí solo, responde a un prompt y se detiene.
En términos de producción, el modelo es también la parte más intercambiable, razón por la cual debe situarse tras una abstracción. En TrueFoundry, los modelos se identifican por su nombre a través de la API única compatible con OpenAI de AI Gateway: modelos comerciales punteros, modelos de código abierto autoalojados y puntos de control (checkpoints) ajustados bajo una interfaz de gateway común, con RBAC, presupuestos, observabilidad y barreras de protección (guardrails) aplicados de forma centralizada por donde fluye el tráfico. La consecuencia arquitectónica de que "el modelo sea solo un componente" es que cambiarlo debería ser un simple cambio de configuración —tema de nuestro artículo sobre API unificada— y todo lo demás en este glosario es lo que se mantiene inalterado al cambiarlo.
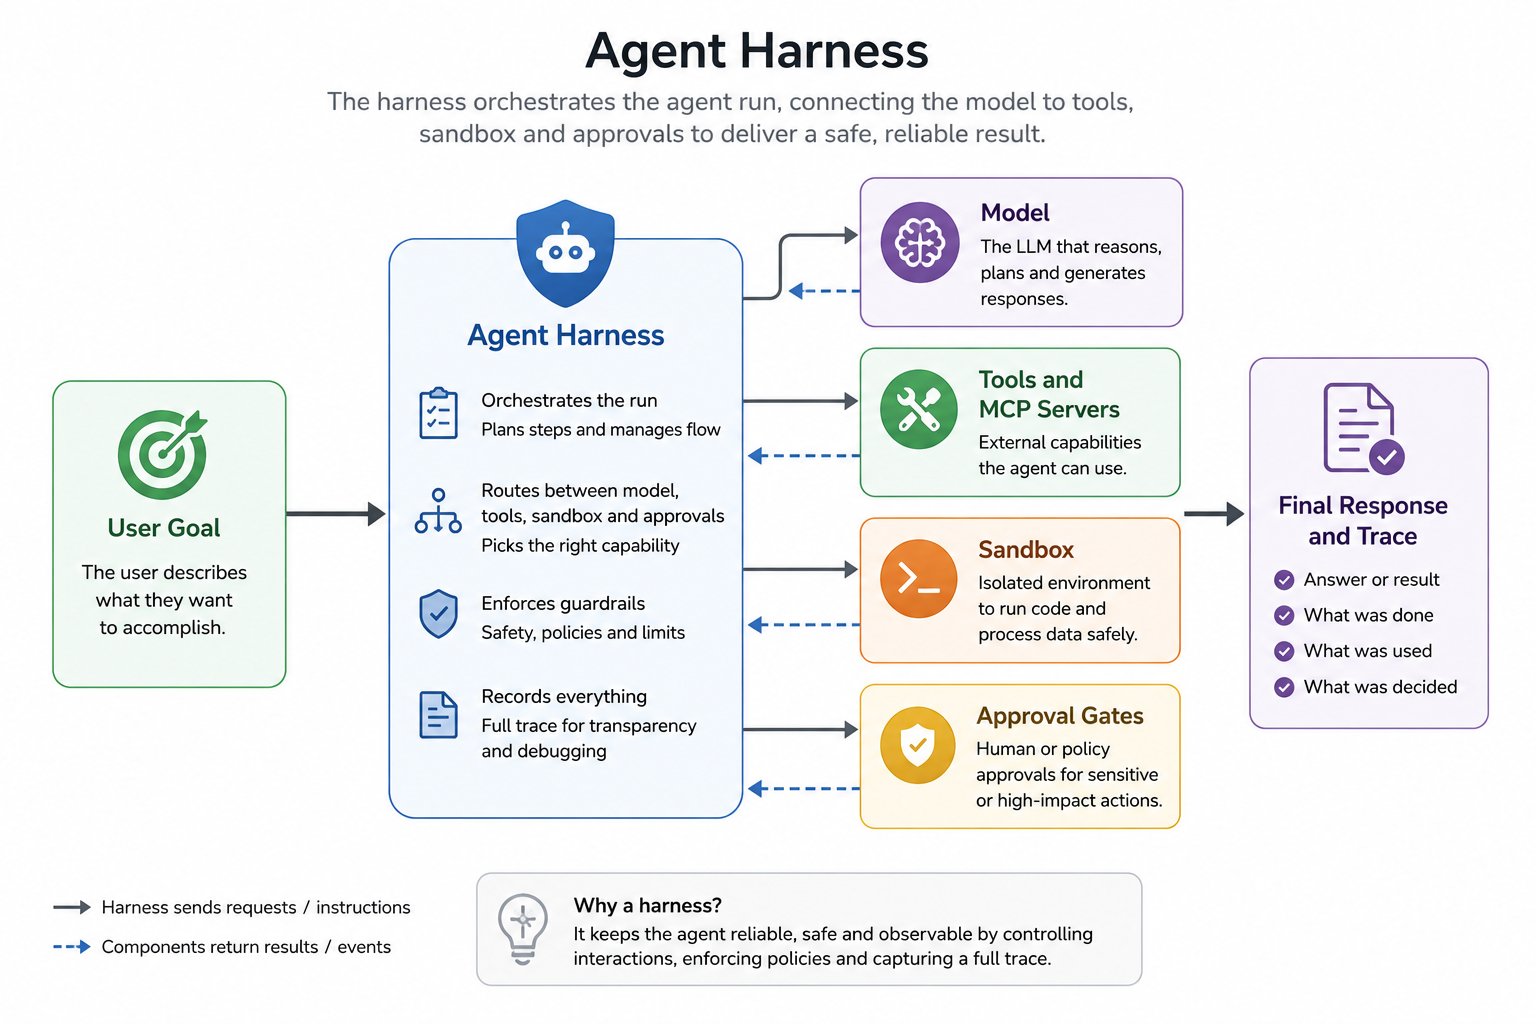
Esta es la distinción para la que existe el glosario y la que más confusión genera en la práctica. El scaffold es la capa que define el comportamiento desde la que trabaja el modelo: el prompt del sistema, las descripciones de las herramientas, los formatos de salida que debe seguir y las reglas sobre qué se mantiene a lo largo de los pasos. Determina cómo ve el modelo su entorno. El harness es la capa de ejecución que hace funcionar al agente: el bucle que llama al modelo, analiza sus solicitudes de herramientas, las ejecuta realmente, devuelve los resultados, gestiona los errores y decide cuándo parar. El scaffold son instrucciones; el harness es maquinaria. Productos como Claude Code suelen utilizar "harness" de forma imprecisa para referirse a todo lo que no es el modelo, lo cual es aceptable como abreviatura; la distinción demuestra su valor cuando hay que analizar las capas por separado, algo fundamental en producción: la edición de un prompt es un cambio de scaffold que se puede desplegar en minutos; un cambio en las condiciones de parada o en la gestión de errores es un cambio de harness con un radio de impacto considerable.
En TrueFoundry, las dos capas tienen dos ubicaciones diferentes, lo que resulta muy esclarecedor. Los artefactos del scaffold (instrucciones, versiones de prompts, descripciones de herramientas, habilidades) son contenidos gestionados: versionados, revisables y controlados por RBAC. El harness es el entorno de ejecución gestionado: el Agent Harness de TrueFoundry ejecuta el bucle planificar→actuar→observar, ejecuta herramientas a través de gateways gobernados, gestiona el sandbox, aplica puertas de aprobación y registra los pasos de las ejecuciones gobernadas del Agent Harness. Usted crea el scaffold; la plataforma opera el harness. El análisis detallado que sigue a este artículo se centra plenamente en esta división y en la disciplina que la comunidad denomina ahora ingeniería de harness.
Una vez definidas esas dos capas, el concepto de agente deja de ser algo místico: un agente es un modelo más todo lo que lo rodea para permitirle actuar en lugar de limitarse a responder; este enfoque lo resume la comunidad como agente = modelo + harness. Su origen proviene del aprendizaje por refuerzo, donde un agente es simplemente lo que recibe observaciones y devuelve acciones en un bucle; la versión para LLM mantiene ese bucle y completa el paso de "decisión" con un modelo. De esta ecuación se derivan dos consecuencias prácticas que conviene interiorizar.
En primer lugar, lo que los usuarios perciben como un "producto agente" es a menudo el harness y el scaffold que rodean al modelo. Cuando dos productos basados en el mismo modelo subyacente ofrecen experiencias completamente distintas, la diferencia radica en el harness y el scaffold: el diseño de su bucle, su gestión del contexto y sus conjuntos de herramientas. El modelo, el harness y el producto son tres elementos diferentes, y evaluar "un agente" sin especificar en qué harness se ha ejecutado carece prácticamente de sentido. En segundo lugar, el inventario pasa a ser algo factible. La pregunta de Elif de "¿cuántos agentes tenemos?" obtiene respuesta una vez que un agente es un elemento concreto y registrado: una definición (modelo + scaffold + concesiones de herramientas) más un entorno de ejecución. Para los agentes ejecutados a través del Agent Harness de TrueFoundry, el agente se convierte en una definición registrada que hace referencia a un modelo, servidores MCP y habilidades por su nombre, con credenciales guardadas en el plano del gateway en lugar de estar integradas en la definición, lo que hace que la parte gobernada del conjunto de agentes se pueda contar y auditar en lugar de ser un debate sobre vocabulario.
Una definición de agente, anotada con el glosario (ilustrativo)
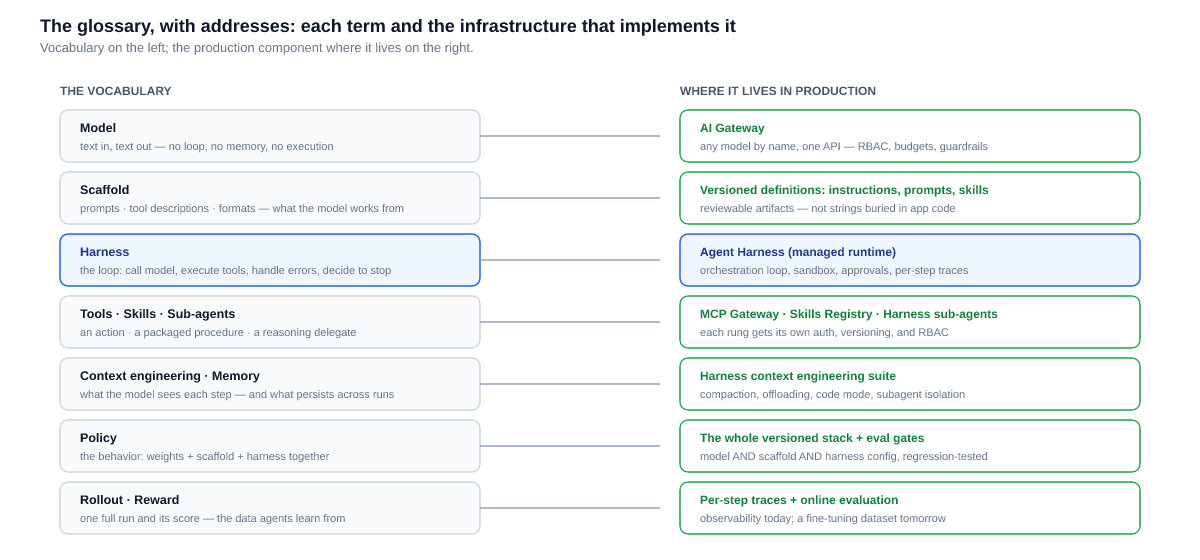
Si nos alejamos del entorno de ejecución, todo el vocabulario se alinea de la misma manera: cada término de la izquierda es un concepto y cada uno tiene una ubicación de producción concreta a la derecha.
La ingeniería de contexto es la disciplina de decidir qué ve el modelo en cada paso: qué instrucciones, qué descripciones de herramientas, qué fragmento del historial, qué datos recuperados. No es una decisión de prompt puntual, porque en un agente el contexto está vivo: la salida de cada turno condiciona la entrada del siguiente, y un harness que no gestione activamente esa acumulación verá cómo su agente se degrada a medida que se llena la ventana. El glosario divide la memoria con claridad: la memoria a corto plazo es la que permanece en la ventana durante una ejecución; la memoria a largo plazo persiste entre sesiones de forma externa y se vuelve a recuperar cuando es relevante.
En producción, esto es responsabilidad del harness, no del autor del prompt: ningún ser humano puede seleccionar manualmente el contexto de una ejecución de 40 pasos. El Agent Harness de TrueFoundry incluye un suite de ingeniería de contexto que realiza la selección de forma automática: la compactación resume un historial largo y continúa; la descarga de grandes resultados mantiene una respuesta de herramienta voluminosa fuera de la ventana y la carga bajo demanda; el modo código permite al agente procesar datos pesados mediante código en lugar de leerlos en el contexto; y los subagentes (siguiente sección) aíslan subtareas en ventanas independientes. Cubrimos el modo de fallo que esto evita —denominado por la comunidad deterioro del contexto (context rot)— en su propio artículo; aquí lo importante es la correspondencia: "ingeniería de contexto" define el trabajo que, en un entorno de ejecución gestionado, el harness realiza por usted.
La aclaración más útil del glosario a nivel práctico es la línea divisoria entre tres conceptos que parecen "el agente haciendo algo". Una herramienta (tool) es una acción: una única llamada a función (ejecutar este comando, consultar esta API) ejecutada por el harness y devuelta. Una habilidad (skill) es conocimiento empaquetado: un procedimiento estructurado y reutilizable para un objetivo de múltiples pasos ("investigar el error, formular una hipótesis, escribir la solución"), cargado en el contexto bajo demanda en lugar de ejecutarse como una sola llamada. Un subagente (sub-agent) es un delegado de razonamiento: un agente invocado por otro agente, con su propio modelo, scaffold y contexto, que trabaja en la subtarea de forma independiente y devuelve un resultado. Esta división varía según el framework —el glosario lo reconoce abiertamente—, pero el espectro en sí es estable: acción, procedimiento, delegado.
La razón por la que esta distinción es importante en producción es que cada nivel requiere una gobernanza diferente. Una herramienta necesita autenticación y autorización por llamada, que es lo que proporciona el MCP Gateway: registro, autenticación centralizada, RBAC por herramienta y guardrails previos/posteriores a la llamada. Una habilidad necesita versionado y procedencia (quién escribió este procedimiento, qué versión está ejecutando un agente), que es lo que proporciona el Skills Registry de TrueFoundry: artefactos SKILL.md versionados con RBAC, montados bajo demanda. Un subagente necesita identidad y un contexto acotado (su propia traza, sus propios permisos, aislamiento de la ventana del elemento primario), algo que el Agent Harness ofrece de forma nativa. Si simplifica el espectro bajo el término "herramientas", acabará gobernando un delegado de razonamiento como una simple llamada a función; el análisis detallado sobre este espectro desglosa cada uno de estos niveles.
Política (policy) es el término más discreto del glosario y, para los equipos de operaciones, tal vez el más importante. Tomado del aprendizaje por refuerzo (RL), una política es el comportamiento en sí mismo: qué hará el sistema ante cualquier situación. La frase fundamental es que, en los agentes basados en LLM, solo una parte de la política reside en los pesos del modelo: el resto lo determinan el scaffold y el harness. El mismo punto de control tras un prompt de sistema diferente, distintas descripciones de herramientas o un bucle diferente es, conductualmente, una política distinta. Una política no es un agente: la política es el comportamiento; el agente es el sistema desplegado cuyo comportamiento representa esa política.
Si se toma esto en serio, una práctica operativa común deja de tener sentido: rastrear "qué versión del modelo está en producción" como si eso respondiera a "qué hará el sistema". Eso solo responde a un tercio de la pregunta. La traducción en producción de "política" es que todo el stack que determina el comportamiento (nombre del modelo, prompts, conjunto de herramientas y sus descripciones, habilidades, configuración del harness) es un único elemento versionado, que se modifica deliberadamente y se somete a pruebas de regresión de forma conjunta, ya que la edición de una sola línea en un prompt es un cambio de política de la misma manera que lo es un cambio de modelo. Ese es el argumento del cuarto artículo de esta serie; la infraestructura que lo hace viable incluye las definiciones como artefactos (la definición declarativa de agente del Agent Harness), el versionado de prompts y el bucle de evaluación en línea que detecta cualquier cambio de comportamiento, independientemente de la capa que lo haya provocado.
La última sección del glosario aborda el vocabulario de entrenamiento en RL (entorno, entrenador, rollout, reward) y un equipo de producción podría verse tentado a saltársela. No lo haga, porque dos de esos términos describen elementos que ya utiliza. Un rollout es una ejecución completa de un agente de principio a fin: lo que vio el agente, lo que hizo y lo que obtuvo como resultado, paso a paso. Los equipos de producción llaman a eso una traza (trace). Un reward es la puntuación que indica si una ejecución ha sido buena: verificable (se pasan las pruebas, la respuesta coincide) o aprendida (preferencias, LLM como juez). Los equipos de producción llaman a eso una señal de evaluación (eval signal). El pipeline de entrenamiento y el bucle de producción comparten la misma estructura; uno actualiza los pesos y el otro actualiza los paneles de control.
La consecuencia merece una reflexión: si su harness registra trazas completas paso a paso y su capa de evaluación las puntúa, ya está recopilando el material base para conjuntos de datos de rollout/reward: trazas más señales de calidad que pueden seleccionarse para un ajuste fino (fine-tuning) o mejoras basadas en RL. Los equipos que alojan internamente modelos de código abierto (nuestro artículo sobre autoalojamiento) pueden cerrar ese bucle deliberadamente: trazas del Agent Harness, puntuaciones de la capa de evaluación y ajuste fino en TrueFoundry, desplegando el punto de control mejorado tras el mismo nombre de gateway. El último artículo de esta serie explica este bucle en su totalidad. La lección sobre el vocabulario es más sencilla: "rollout" y "reward" no son jerga de entrenamiento de terceros, sino su propia observabilidad vista desde una perspectiva futura.
La reunión de cuarenta minutos de Elif no fue una pérdida de tiempo por ignorancia, sino por ambigüedad, y la ambigüedad en el vocabulario se traslada a los sistemas. Cuando "agente" no tiene un referente fijo, el inventario de agentes no puede existir. Cuando "harness" puede significar un producto, un bucle o todo lo que no sea el modelo, una conversación sobre comprar frente a desarrollar harness se convierte en tres conversaciones distintas bajo una misma apariencia. Cuando "habilidad" y "herramienta" se confunden, el modelo de gobernanza se difumina con ellos, y una capacidad no protegida es precisamente como comienzan los problemas de dispersión de recursos y agentes no autorizados (shadow agents). Definir con precisión las palabras es el primer paso, y el más accesible, para definir la arquitectura.
La correspondencia que aporta este artículo es el segundo paso: cada término debe tener una ubicación. En TrueFoundry la tiene: los modelos tras el AI Gateway, las herramientas tras el MCP Gateway, las habilidades en el Skills Registry, el bucle y los subagentes en el Agent Harness, la ingeniería de contexto como maquinaria del harness, la política como un conjunto versionado y los rollouts como trazas que alimentan la evaluación. Nada de esto requiere TrueFoundry de forma exclusiva; requiere alguna respuesta concreta a "dónde reside este término y quién lo gobierna allí". Los cuatro artículos siguientes analizan individualmente los términos más complejos: harness frente a scaffold, el espectro herramienta/habilidad/subagente, la política como elemento real que se versiona y el bucle de rollout a reward en producción.
¿Es "agente = modelo + harness" la definición oficial? No existe un organismo oficial y el propio glosario señala que muchos términos carecen de definiciones aceptadas universalmente; diferentes frameworks utilizan las mismas palabras con distintos significados. Es preferible considerarlo como un modelo de trabajo práctico y útil: separa claramente el motor de razonamiento de la maquinaria que le permite actuar, que es la separación que requiere la arquitectura de producción. Utilícelo como modelo de trabajo, reconozca la fuente y prevea futuros ajustes.
¿Dónde termina el scaffold y dónde empieza el harness? La línea divisoria más clara: el scaffold es el punto de partida desde el que trabaja el modelo (prompts, descripciones de herramientas, formatos: el contenido); el harness es lo que hace que el agente se ejecute (el bucle, la ejecución, la gestión de errores, las paradas: la maquinaria). Los productos a menudo usan "harness" para referirse a ambos, lo cual es aceptable hasta que se necesita modificar uno sin alterar el otro. En la práctica, esta división marca también una responsabilidad: los autores son propietarios del scaffold; la plataforma es propietaria del harness.
¿Un subagente es solo una herramienta desde la perspectiva de quien lo llama? A nivel mecánico suele invocarse como tal, motivo por el cual los términos se confunden. La diferencia radica en lo que hay al otro lado: una herramienta ejecuta una función; un subagente razona, contando con su propio modelo, scaffold, contexto y, posiblemente, sus propias herramientas. Esta diferencia es invisible para el código que realiza la llamada, pero resulta enorme para la gobernanza: un subagente requiere identidad, permisos y rastreo propios, no solo una entrada en la lista de herramientas del elemento primario.
¿Realmente necesitan los equipos de producción los términos de RL? Dos de ellos sí. En términos de producción, un rollout equivale a una traza y un reward equivale a una puntuación de evaluación: vocabulario para elementos que ya se generan. Comprender el enfoque de entrenamiento resulta fundamental el día que desee que sus agentes mejoren a partir de su propio historial: las trazas completas junto con las puntuaciones de calidad constituyen el material base, y los equipos que las hayan registrado correctamente dispondrán de un conjunto de datos en lugar de simples registros.
¿Estandarizar el vocabulario cambia realmente algo a nivel técnico? De forma indirecta pero sustancial. Compartir términos permite que el inventario se pueda contabilizar ("agente" = definición registrada + entorno de ejecución), que la contratación sea comparable (cada afirmación de "harness incluido" se desglosa en bucle, sandbox, aprobaciones y trazas) y que la gobernanza se pueda asignar (cada ubicación de un término tiene un responsable). El problema de la reunión de Elif era un problema de sistemas con apariencia de problema semántico, como ocurre habitualmente.
Un glosario es la leyenda de un mapa; este artículo ha intentado dibujar dicho mapa. El vocabulario de la comunidad (modelo, scaffold, harness, agente, habilidad, subagente, política, rollout, reward) describe con notable precisión una arquitectura de producción, término a término, siempre que cada uno tenga su ubicación. Asígnela y las palabras dejarán de ser objeto de discusión para convertirse en la base del diseño.
Elif es un personaje ilustrativo y no representa a una persona, organización o incidente específicos. Las definiciones de este artículo están parafraseadas a partir del glosario de agentes de Hugging Face (mayo de 2026) y del debate comunitario más amplio al que hace referencia, dándole el debido crédito; el propio glosario señala que muchos términos carecen de definiciones aceptadas universalmente y que el uso varía según el framework. Las capacidades de TrueFoundry mencionadas reflejan la documentación pública del producto en el momento de la redacción; verifique los detalles específicos en la documentación actualizada.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















