



November 6, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
El modelo rara vez vuelve a ser la parte más difícil. Los modelos frontera son lo suficientemente capaces como para que, en muchas cargas de trabajo de agentes, cambiar entre ellos sea tan sencillo como modificar un campo de configuración. Lo que separa a un agente que funciona en una demo de uno que sigue funcionando de manera fiable tras tres meses en producción es todo lo que rodea al modelo: el bucle (loop), el contexto, las herramientas, el sandbox, las aprobaciones y los controles que evitan que haga algo irreversible.
Esa capa es el agent harness, y las decisiones que se toman ahí pueden tener un impacto mayor en la fiabilidad y el coste que la propia elección del modelo. Aprendimos esto mientras desarrollábamos y ejecutábamos TrueForge, nuestro agent harness de código abierto. Estas son las 10 buenas prácticas para agent harness que recomendamos si vas a crear agentes para producción a día de hoy.
Empecemos con una cifra, porque replantea todo lo que viene a continuación. Utilizamos el benchmark Enterprise-Bench de DevRev: 14 tareas multisistema de variada dificultad que simulan trabajo real de operaciones B2B. Para responder a cualquiera de ellas, un agente debe planificar, llamar a herramientas MCP a través de tres sistemas (un CRM estilo Salesforce, un gestor de proyectos estilo Jira y un almacenamiento de documentos y transcripciones de llamadas estilo Drive), combinar los resultados correctamente y presentar la respuesta con el nivel de detalle adecuado.
La precisión está prácticamente empatada. El modelo marca el techo; el harness no hace que el modelo subyacente sea más inteligente.
Lo que sí determina el harness es cuánto trabajo cuesta alcanzar ese techo.
En este benchmark, TrueForge resolvió aproximadamente el mismo número de tareas que Claude Managed Agents utilizando cerca de un 62% menos de tokens y con un coste por ejecución aproximadamente un 28% menor. En comparación con deepagents, la diferencia de tokens fue aún mayor.
Esa es la parte de la infraestructura de agentes que resulta fácil pasar por alto. Dos agentes pueden usar el mismo modelo, tener acceso a las mismas herramientas e intentar la misma tarea y, aun así, generar costes de ejecución muy diferentes.
La diferencia proviene de lo que ocurre alrededor del modelo: cuánto contexto arrastra, qué herramientas carga, cómo gestiona respuestas voluminosas, cuándo compacta el estado y con qué eficiencia ejecuta el bucle.
Lee la metodología completa del benchmark →
Casi toda la brecha de costes en este benchmark se reduce a las primeras cuatro prácticas.
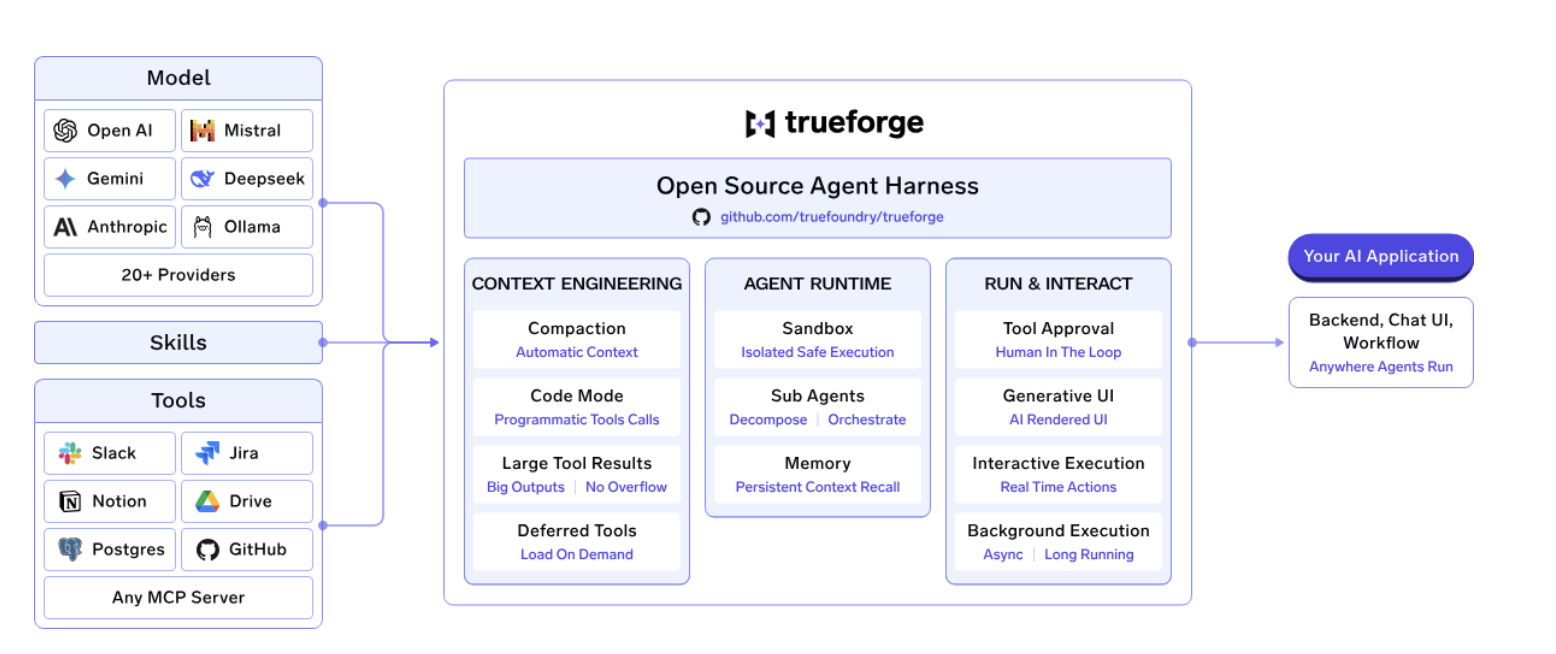
TrueForge es el agent harness de código abierto y neutral respecto al proveedor de TrueFoundry, diseñado para equipos que desean un mayor control sobre cómo se ejecutan sus agentes en producción. En lugar de vincular el runtime a un único proveedor de modelos, TrueForge te permite aportar tus propios modelos, servidores MCP e infraestructura, mientras gestiona el bucle del agente, la ejecución de herramientas, la gestión del contexto, las aprobaciones y el sandboxing.
Mientras que un agente autoalojado como Hermes deja gran parte de la infraestructura de producción en manos del desarrollador, TrueForge proporciona el plano de control perimetral necesario para operar agentes entre distintos equipos y entornos. Esto incluye acceso centralizado a MCP y credenciales, aprobaciones human-in-the-loop, ejecución aislada en sandbox, observabilidad y gobernanza.
Puedes ejecutarlo de forma local con npx @truefoundry/trueforge o desplegarlo para un equipo mediante Docker Compose o Helm.
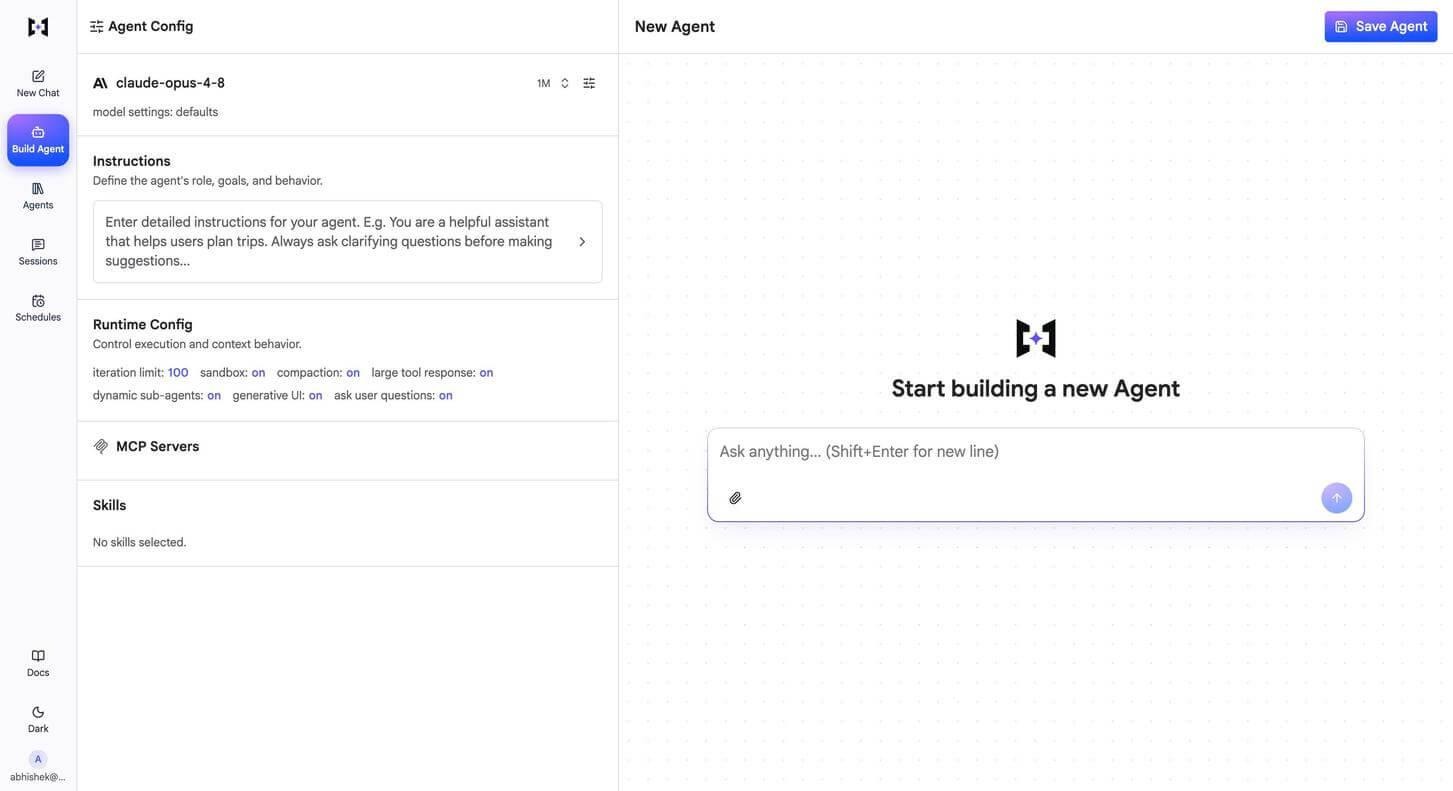
TrueForge también separa el runtime del agente de la capa del modelo. Esto significa que los equipos pueden cambiar de modelo o enrutar cargas de trabajo a diferentes proveedores sin necesidad de reestructurar el agente. Combinado con el AI Gateway de TrueFoundry, los equipos también pueden aplicar enrutamiento de modelos y controles de costes para evitar el uso de modelos frontera costosos en tareas que no lo requieren. El resultado es un punto medio entre un runtime totalmente gestionado y la construcción completa de la infraestructura de agentes por cuenta propia: un agent harness de código abierto con los controles operativos necesarios para ejecutar agentes en producción a escala.
TrueFoundry ofrece además una segunda palanca para reducir los costes del modelo mediante el Auto Routing de su AI Gateway. En lugar de enviar cada solicitud a un modelo frontera, el Auto Routing clasifica las peticiones por complejidad y las enruta a diferentes niveles de modelos. En el benchmark de TrueFoundry sobre 550 prompts, el enrutamiento entre Haiku, Sonnet y Opus redujo los costes en un 69% manteniendo un 98% de la calidad base, mientras que la latencia media descendió de 7.6 segundos a 4.0 segundos. En tráfico con patrones de producción, la reducción total de costes alcanzó el 80%.
Estas dos capas abordan partes distintas de la ecuación de costes. TrueForge reduce la sobrecarga de ejecutar el propio agente, mientras que el enrutamiento de modelos evita utilizar un modelo caro cuando la tarea no lo exige. Para los equipos que operan agentes a escala, contar con ambos controles puede ser más relevante que el precio del modelo por sí solo.
TrueForge es de código abierto con licencia MIT, mientras que el AI Gateway de TrueFoundry añade la capa operativa que los equipos necesitan al pasar de agentes individuales a producción: acceso centralizado a modelos, presupuestos, guardrails, gestión de credenciales y trazas unificadas.
Si estás comparando Claude Managed Agents con una arquitectura más configurable, merece la pena considerar TrueFoundry cuando la flexibilidad de modelos, el control de la infraestructura y la optimización de costes de los agentes son aspectos clave junto al propio runtime.
Aquí es donde se gestiona el gasto. La ingeniería de contexto (context engineering) es la disciplina de decidir qué ve el modelo en cada turno, y en un agente de larga ejecución, su impacto se acumula turno tras turno.
Lo que sale mal: conectas cinco servidores MCP, cada esquema de herramienta se carga al inicio y el agente consume decenas de miles de tokens en definiciones de herramientas que nunca llegará a llamar. Cada turno posterior sigue arrastrándolas.
Lo que se debe hacer: carga los esquemas de herramientas bajo demanda en lugar de hacerlo por adelantado. Una buena gestión del contexto del agente comienza antes de la primera llamada al modelo, no después de que la ventana se haya llenado.
En TrueForge: la carga diferida de herramientas (deferred tool loading) proporciona al agente un índice ligero y recupera el esquema completo únicamente cuando intenta utilizar esa herramienta específica.
Lo que sale mal: la ventana se llena, el harness descarta el contenido más antiguo y el agente olvida silenciosamente la restricción que le diste en el turno tres. No genera ningún error; simplemente empeora, y el fallo es difícil de detectar porque el resultado sigue pareciendo plausible.
Lo que se debe hacer: resume el historial antiguo en un registro estructurado y conserva dicho resumen. Establece el umbral por debajo del límite máximo para que la compactación se produzca bajo tus condiciones y no por presión de espacio.
En TrueForge: la compactación se activa al alcanzar el 80% de la longitud del contexto del modelo y reemplaza el historial antiguo con un resumen estructurado. El truncamiento es aceptable para un agente de soporte breve, pero resulta activamente perjudicial en una tarea de varias horas.
Un matiz importante que conviene conocer: la compactación conlleva su propio riesgo si las políticas y restricciones residen únicamente en la conversación. Hemos escrito sobre cómo la compactación erosiona la gobernanza y por qué su aplicación debe estar fuera de la ventana de contexto.
Lo que sale mal: una herramienta devuelve una carga útil JSON de 200 KB, todo acaba dentro de la ventana de contexto y el agente solo necesitaba tres campos de esa respuesta.
Lo que se debe hacer: escribe la carga útil en un lugar accesible para el agente y pásale una referencia en lugar de todo el contenido.
En TrueForge: la externalización de respuestas voluminosas de herramientas escribe la respuesta en un archivo dentro del sandbox y la sustituye por una ruta y una vista previa. El modo código (Code Mode) va más allá, permitiendo al agente encadenar varias llamadas a herramientas dentro de un mismo script de sandbox, de modo que solo el resultado impreso entra en el contexto. Cinco viajes de ida y vuelta se convierten en un solo resumen.
Lo que sale mal: un subagente hereda todo el hilo del agente primario, realiza su trabajo y devuelve la traza completa de su razonamiento al contexto principal. En ese punto has pagado dos veces por el mismo historial y has contaminado el hilo principal.
Lo que se debe hacer: la delegación debe reducir el contexto del agente primario, no aumentarlo.
En TrueForge: los subagentes se ejecutan con su propio contexto limpio y solo devuelven el resultado final.
Pruébalo: npx @truefoundry/trueforge ejecuta localmente un harness con estas cuatro opciones activadas por defecto en aproximadamente un minuto. Danos una estrella en GitHub.
Lo que sale mal: el harness envuelve cada sesión en un contenedor, independientemente de si el agente llega a ejecutar código o no. Pagas tiempo de contenedor por conversaciones que solo fueron texto, y un solo servidor soporta muchos menos agentes concurrentes.
Lo que se debe hacer: aprovisiona el sandbox únicamente cuando el agente necesite ejecutar algo. El sandboxing de agentes consiste en limitar el radio de impacto, y se obtiene el mismo aislamiento sin pagar por él en cada turno.
En TrueForge: el sandbox es una herramienta que se inicia solo cuando el agente necesita ejecutar código, de modo que un solo servidor puede gestionar muchos agentes y los turnos que no tocan código se mantienen económicos. Los proveedores de sandbox se pueden integrar libremente (bring-your-own).
Merece la pena leer el argumento más profundo sobre permitir que los modelos ejecuten sin darles libertad absoluta de acceso si estás diseñando esto desde cero.
Lo que sale mal: los equipos abordan las aprobaciones desde uno de dos extremos. O no se controla nada y el agente termina eliminando algo, o se controla absolutamente todo y una persona hace clic en aprobar cuarenta veces por hora hasta que deja de leer lo que aprueba.
Lo que se debe hacer: establece controles basados en la irreversibilidad: enviar un correo electrónico, escribir en producción, realizar un gasto o eliminar cualquier dato. Las lecturas y borradores deben ejecutarse libremente. Y no intentes cumplir un requisito de cumplimiento describiéndolo en el prompt del sistema y esperando que se respete, porque un prompt es solo una sugerencia, mientras que los guardrails que inspeccionan cada llamada a herramientas son un control real.
En TrueForge: el servidor central pausa la ejecución y espera la aprobación para acciones sensibles antes de que la llamada se emita, no después.
Dónde reside ese punto de aprobación importa tanto como su propia existencia, un tema que abordamos en el diseño de aprobaciones para herramientas MCP en el límite del gateway.
Lo que sale mal: un portátil entra en reposo, un balanceador de carga reinicia una conexión y cuarenta minutos de trabajo del agente se pierden. En tareas que se ejecutan durante una hora, esto deja de ser un caso aislado.
Lo que se debe hacer: persiste el estado de la sesión para que una conexión interrumpida se reanude en lugar de reiniciar desde cero.
En TrueForge: las sesiones persisten tras reconexiones y reinicios. La reanudabilidad (resumability) es una de esas propiedades que nadie solicita en la revisión del diseño pero que todo el mundo necesita en la segunda semana.
Lo que sale mal: dispones del recuento de tokens y la latencia por llamada al modelo, pero no tienes idea de qué paso falló en una ejecución de 60 pasos. La depuración se convierte en arqueología.
Lo que se debe hacer: emite eventos estructurados para cada paso, de modo que el historial de ejecución se lea como una línea de tiempo y no como un muro de logs. Verifica que el propio bucle sea observable antes de tener que depurarlo en un momento crítico.
En TrueForge: cada paso se transmite en tiempo real a medida que ocurre, y el contrato en tiempo de ejecución para eventos del agente está publicado para que tus propias herramientas puedan consumirlo.
El enfoque expuesto en ingeniería de bucles (loop engineering) resulta muy útil aquí: el bucle es el middleware, por lo que debe tratarse como infraestructura.
Lo que sale mal: el agente se escribe adaptado al SDK y las particularidades de un único proveedor. Cuando se lanza un modelo más barato o mejor, cambiarlo implica reescribir código, por lo que finalmente no se cambia.
Lo que se debe hacer: comunícate con los modelos mediante interfaces compatibles con OpenAI y mantén los detalles específicos del proveedor fuera de la lógica de tu agente.
En TrueForge: los modelos, servidores MCP y proveedores de sandbox son completamente intercambiables mediante interfaces abiertas. Esto no es un valor hipotético. En el mismo benchmark, ejecutar TrueForge sobre GLM-5.2 en lugar de Opus 4.8 resolvió las mismas ~11 de 14 tareas a un coste de $2.90 por ejecución frente a $8.50. Ese ahorro solo está al alcance si el cambio se reduce a un ajuste de configuración.
Lo que sale mal: cada equipo gestiona sus propias claves de modelo y credenciales MCP. Nadie puede limitar el gasto, el enmascaramiento de PII es inconsistente y responder a una auditoría exige recopilar logs de nueve servicios distintos.
Lo que se debe hacer: coloca un gateway entre tus agentes y todos los servicios a los que llaman.
En TrueForge: esto no forma parte del cometido del harness por diseño. En la modalidad autoalojada, aportas tus propias claves y las gestionas tú mismo, lo cual funciona hasta que ejecutas un volumen elevado de agentes. Llegado ese punto, conéctalo a AI Gateway de TrueFoundry, que sitúa más de 1.000 LLM detrás de una única API compatible con OpenAI añadiendo apenas de 3 a 4 ms de latencia y soportando más de 350 RPS en una sola vCPU, con RBAC, presupuestos, guardrails, rotación de credenciales y trazas de OpenTelemetry hacia Grafana, Datadog o Prometheus.
¿Ejecutas más de unos pocos agentes? Descubre cómo el AI Gateway los gobierna de forma centralizada, o reserva una sesión guiada si deseas adaptarlo a tu infraestructura.
Nueve de las diez reglas están integradas en el harness. La décima se excluye deliberadamente, ya que un harness que intenta actuar también como plano de control suele resentirse en ambas funciones.
Reconstruir un bucle que ya existe. Si estás escribiendo la lógica planificar-actuar-observar desde cero, comprueba si un harness ya la incluye. El diseño de un agent harness solo justifica el esfuerzo cuando el problema a resolver es verdaderamente atípico.
Buscar el control únicamente mediante prompts. Los pasos de cumplimiento, los límites de gasto y los controles de aprobación deben residir en el código o en un gateway. A un modelo al que se le piden las cosas por favor se le puede persuadir para que las ignore.
Aislar todo en sandboxes por defecto. El aislamiento en cada turno genera un coste real sin aportar valor en turnos donde jamás se ejecuta código.
Medir el modelo en lugar de la ejecución completa. El recuento de tokens por llamada puede parecer correcto mientras el coste total por tarea completada se triplica silenciosamente. Mide la ejecución global.
P: ¿Cuáles son las buenas prácticas para un agent harness?
R: Las más críticas son las relativas al contexto: cargar esquemas de herramientas bajo demanda, compactar el historial en lugar de truncarlo, externalizar respuestas voluminosas a archivos y mantener el contexto de los subagentes separado del agente principal. Además, se deben aprovisionar sandboxes únicamente cuando se ejecute código, solicitar aprobación para acciones irreversibles, persistir sesiones ante reconexiones y emitir eventos estructurados en cada paso. En nuestro benchmark, estas decisiones supusieron una diferencia de más de 4 veces en tokens por ejecución para las mismas tareas.
P: ¿Cómo evitar que un agente se quede sin contexto en una tarea larga?
R: Mediante compactación, no truncamiento. Resume el historial antiguo en un registro estructurado al alcanzar un umbral (alrededor del 80% de la capacidad de contexto del modelo), de modo que el agente mantenga el hilo en lugar de perderlo silenciosamente. Combina esto con la carga diferida de herramientas y la externalización de respuestas para ralentizar el llenado inicial de la ventana.
P: ¿Se debe aislar en sandbox cada sesión de un agente?
R: No. Aisla la ejecución de código, no la sesión. Mantener un contenedor abierto durante toda una conversación genera costes en turnos que nunca ejecutan código y limita la cantidad de agentes que un servidor puede soportar. Aprovisionar bajo demanda ofrece el mismo nivel de aislamiento a una fracción del coste.
P: ¿Puedo ejecutar un agent harness en mi propia VPC o en entorno local (on-prem)?
R: Sí, con cualquier opción autoalojada. TrueForge se ejecuta desde un único comando npx en local, o mediante Docker Compose y Helm para despliegues de equipo con Postgres, Redis, réplicas y autenticación OIDC. La plataforma gestionada de TrueFoundry también se puede ejecutar en modo autoalojado, on-prem, air-gapped o híbrido, garantizando que ningún dato salga de tu dominio.
P: ¿Soporta TrueFoundry MCP y agentes desarrollados en otros frameworks?
R: Sí. La plataforma incluye un MCP Gateway, Agent Gateway y un registro con control de acceso a nivel de herramienta. Los agentes creados sobre LangGraph, CrewAI, AutoGen o un framework personalizado pueden gobernarse a través de la misma capa, por lo que no es necesario adoptar un único stack técnico.
Las buenas prácticas para agent harness se reducen a un hábito fundamental: decidir deliberadamente qué ve el modelo y qué se le permite hacer, midiendo luego la ejecución completa en lugar de cada llamada individual. Los equipos que aplican esto consiguen agentes que cuestan una cuarta parte y cuyos fallos son fácilmente diagnosticables.
No tienes que dar por sentadas nuestras cifras. TrueForge cuenta con licencia MIT y la metodología del benchmark es pública, por lo que puedes probarla con tus propias tareas.
Utiliza npx @truefoundry/trueforge para probarlo en aproximadamente un minuto, consulta la documentación o reserva una sesión guiada si prefieres ver cómo aplicarlo a tu stack actual.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















