October 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Published: October 6, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Fast alle paar Wochen erscheinen neue Inferenz-Anbieter für Open-Weight-Modelle, die jeweils schnellere Tokens pro Sekunde für dieselbe Handvoll Modelle versprechen, die ohnehin schon jeder nutzt. Für Engineering-Teams stellt sich selten die Frage, ob ein Anbieter schnell genug ist. Das Problem ist das Danach: eine neue Basis-URL, ein neuer API-Schlüssel, eine neue Observability-Anbindung und eine Reihe von Anwendungspfaden, die nun gegen ein weiteres Schema getestet werden müssen. Die Integration von Wafer in das TrueFoundry AI Gateway löst dieses zweite Problem und lässt nur die erste Frage offen: Ist das Modell schnell genug für die jeweilige Arbeitslast?
Das TrueFoundry AI Gateway fungiert als Schnittstelle zwischen Anwendungen und allen aufgerufenen Modellen. Es stellt eine einheitliche, OpenAI-kompatible Schnittstelle bereit, unabhängig davon, welcher Anbieter die Anfrage im Hintergrund tatsächlich verarbeitet. Anstatt dass eine Anwendung für jeden Anbieter einen anderen Client, einen anderen Schlüssel und eine andere Wiederholungsrichtlinie verwalten muss, sendet sie alle Anfragen an einen einzigen Endpunkt und überlässt es dem Gateway, das Ziel der Anfrage zu bestimmen.
Diese Auflösung erfolgt über sogenannte Virtual Models: logische Modellkennungen, die auf einen oder mehrere physische Anbieter verweisen, wobei das Routing nach Priorität, Gewichtung oder Latenz erfolgt. Neue Anbieter erfordern keinen neuen Integrationscode auf Anwendungsseite. Sie werden einfach als Anbieterkonto mit einer Reihe registrierter Modelle hinzugefügt, und jede Anwendung, die bereits auf das Gateway zugreift, kann sie sofort nach der Aktivierung nutzen.
Wafer ist ein gehosteter Inferenz-Anbieter, der speziell auf die schnelle Bereitstellung von Open-Weight-Modellen ausgelegt ist. Das Versprechen ist kein breiterer Modellkatalog, sondern eine schnellere Ausführung der Modelle, die Teams ohnehin bereits nutzen möchten. Dies wird durch die Optimierung des gesamten Inferenz-Stacks für spezifische Hardware erreicht, anstatt Modelle auf einem generischen Stack bereitzustellen. Über TrueFoundry ist diese Geschwindigkeit für GLM 5.2 verfügbar, bereitgestellt als serverlose Chat-Vervollständigung mit Streaming und Tool-Calling.
Wafer behandelt die Datenverarbeitung zudem als Standardfunktion und nicht als kostenpflichtiges Enterprise-Add-on. Anfragen können pro Anfrage als datenfrei (Zero Data Retention) markiert werden. Wafer isoliert den Datenverkehr und bietet SLA-gestützte Verfügbarkeit für Arbeitslasten, die diese Garantien benötigen, ohne dass dafür ein separater Vertrag erforderlich ist.
Die Verbindung der beiden erfolgt durch die Registrierung von Wafer als Anbieterkonto im Bereich „Models“ des Gateways. Das Kontenformular fragt nach einer Basis-URL (standardmäßig der Endpunkt pass.wafer.ai/v1 von Wafer), einem API-Schlüssel und einem Schalter für die Datenaufbewahrung (Zero Data Retention), der standardmäßig aktiviert ist. Die Aktivierung weist das Gateway an, bei jeder an Wafer gesendeten Anfrage den Header Wafer-ZDR: required anzuhängen, sodass das Aufbewahrungsverhalten auf Anfrageebene erzwungen wird, anstatt es einer kontoweiten Konfiguration zu überlassen.
Sobald das Konto existiert, werden einzelne Chat-Modelle über ihren Anzeigenamen und ihre exakte Wafer-Modell-ID registriert, wie zum Beispiel glm-5.2. Was diese Integration so unkompliziert macht, ist, dass die API von Wafer das OpenAI-Schema für Chat-Vervollständigungen bereits nativ unterstützt. Der Anbieter-Adapter des Gateways, der Anfragen normalerweise in das Format des jeweiligen Partners übersetzt, muss hier nichts konvertieren. Er leitet die Anfrage weitgehend unverändert weiter – genau aus diesem Grund können bestehende OpenAI-kompatible Clients direkt auf Wafer zugreifen, indem sie lediglich die Basis-URL und den Schlüssel austauschen.
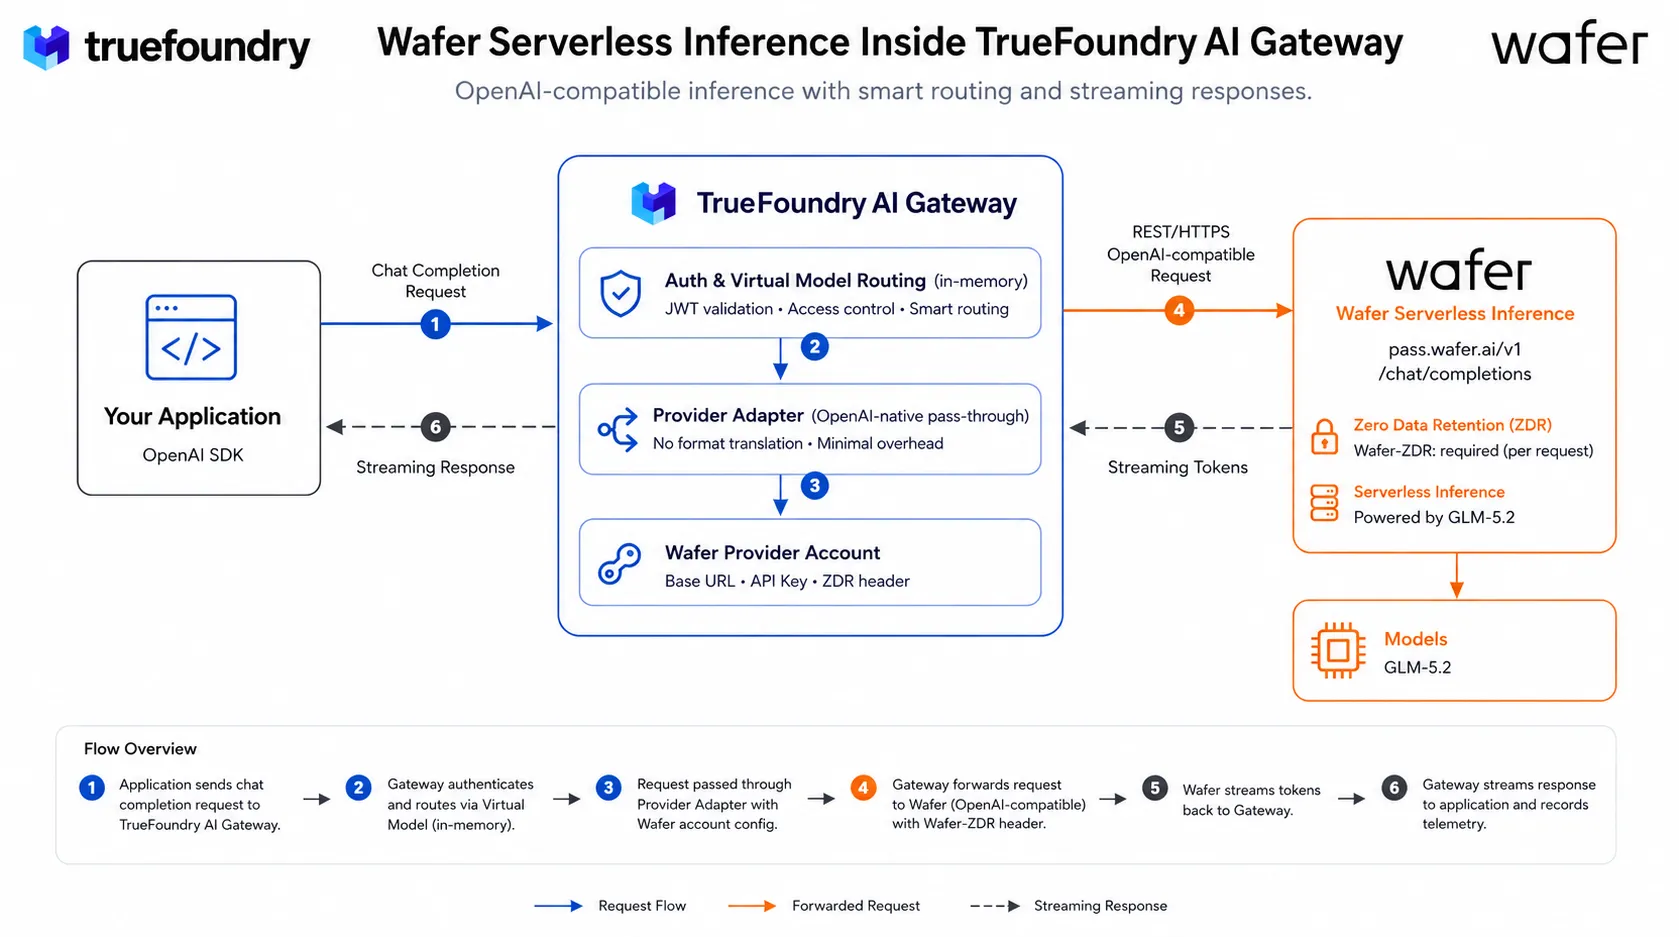
Eine Anfrage, die auf ein Wafer-basiertes Modell abzielt, durchläuft denselben Pfad wie jedes andere Modell auf dem Gateway:
1. Eine Anwendung ruft den Chat-Vervollständigungs-Endpunkt des Gateways mit einer Modellkennung in der Form your-wafer-account/glm-5.2 unter Verwendung des Standard-OpenAI-SDK auf.
2. Das Gateway validiert das JWT der Anfrage anhand zwischengespeicherter öffentlicher Schlüssel und prüft den Zugriff des Aufrufers anhand einer In-Memory-Zuordnung von Benutzern zu Modellen – beides ohne externen Aufruf.
3. Die Kennung des virtuellen Modells wird in das registrierte Wafer-Anbieterkonto aufgelöst, einschließlich der Basis-URL, des API-Schlüssels und der Einstellung zur Datenaufbewahrung.
4. Die Anfrage wird über HTTPS an pass.wafer.ai/v1/chat/completions weitergeleitet. Da Wafer bereits das OpenAI-Schema verwendet, nimmt der Anbieter-Adapter des Gateways keine Formatänderungen vor, sondern fügt lediglich den Wafer-ZDR-Header hinzu, wenn die Aufbewahrung auf „required“ gesetzt ist.
5. Wafer führt die Inferenz auf dem angeforderten GLM 5.2-Modell aus und streamt die Tokens zurück, sobald sie generiert werden.
6. Das Gateway streamt die Antwort zurück an die Anwendung und veröffentlicht asynchron Token-Anzahl, Latenz und Kosten in seiner Telemetrie-Pipeline, genau wie bei jedem anderen Anbieter.
Keiner dieser Schritte ist spezifisch für Wafer. Genau das ist der Punkt: Ein neuer, schneller Inferenzanbieter wird zu einem Routing-Ziel anstatt zu einer neuen Integrationsschnittstelle. Dadurch kann ein Gateway-Konto neue Anbieter aufnehmen, sobald sie sich bewährt haben, ohne dass jede Anwendung eine Codeänderung benötigt.
Öffnen Sie im TrueFoundry-Dashboard das AI Gateway, gehen Sie zu „Models“ und wählen Sie Wafer aus, um ein Konto hinzuzufügen und Ihre Chat-Modelle zu registrieren. Rufen Sie diese über den Playground oder direkt über den OpenAI-kompatiblen Client auf, wobei das Modell auf Ihren Kontonamen und Ihre Modell-ID eingestellt ist. Die vollständigen Einrichtungsschritte und Codebeispiele finden Sie in der TrueFoundry AI Gateway-Dokumentation für Wafer, zusammen mit Wafers eigener Anleitung zur Router-Einrichtung.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet