



August 26, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Wir freuen uns, Ihnen mitteilen zu können, dass TrueFoundry eine leistungsstarke und dennoch einfach zu bedienende Lösung für die Bereitstellung und das Fine-Tuning von Large Language Models (LLM) über unseren Model Catalouge entwickelt hat. Unser Ziel ist es, Unternehmen dabei zu helfen, ihre Open-Source-LLMs selbst auf Kubernetes zu hosten und so Ihre Inference-Kosten mit 1 Klick um das Zehnfache zu senken. In diesem Blog zeigen wir Ihnen, wie Sie mit TrueFoundry ein Dolly-v2-3b-Modell bereitstellen und ein Pythia-70M-Modell feintunen können.Die TrueFoundry-Plattform wurde entwickelt, um Machine-Learning- und Deep-Learning-Modelle aller Art zu unterstützen, von den einfachsten wie der logistischen Regression bis hin zu State-of-the-Art-Modellen wie Stable Diffusion. Man könnte sich fragen: Warum muss man etwas Neues bauen, wenn es um Large Language Models geht?
Die reine Größe und Komplexität dieser Modelle stellen erhebliche Herausforderungen dar, wenn es darum geht, sie in realen Anwendungen einzusetzen. Obwohl die TrueFoundry-Plattform bereits die skalierbare Bereitstellung von Modellen aller Größen unterstützte, haben wir erkannt, dass wir noch weitere Optimierungen (Kosten + Zeit) und Verbesserungen der Benutzererfahrung für diese Modelle vornehmen konnten.
Large Language Models (LLMs) wie ChatGPT haben unbestreitbar einen erheblichen Hype im Bereich der künstlichen Intelligenz ausgelöst.
Aber nach Gesprächen mit über 50 Unternehmen, die bereits damit beginnen, sie in der Produktion einzusetzen, ist der Wert, den sie bereits schaffen, immens. Wir glauben, dass die Nutzung von LLMs nur noch weiter zunehmen wird, da die Menschen jeden Tag neue Use Cases entdecken.
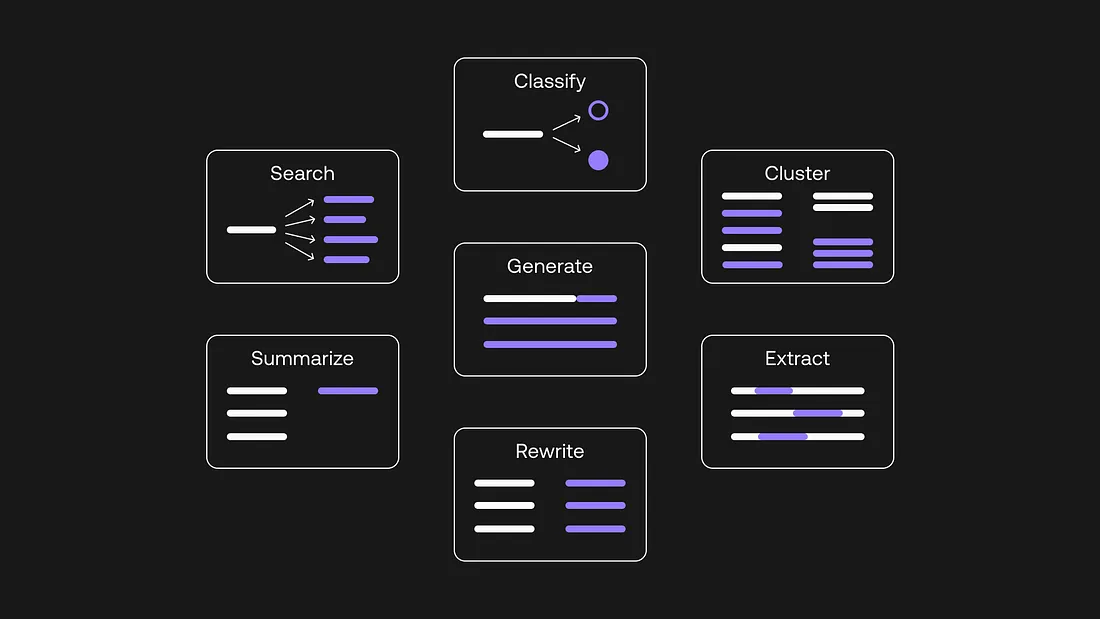
Erstellen eines Proof-of-Concept-Use-Case mit Large Language Models und OpenAI-APIs ist einfach, aber wenn Sie an die Produktion denken 🚀, kommen viel mehr Überlegungen ins Spiel.
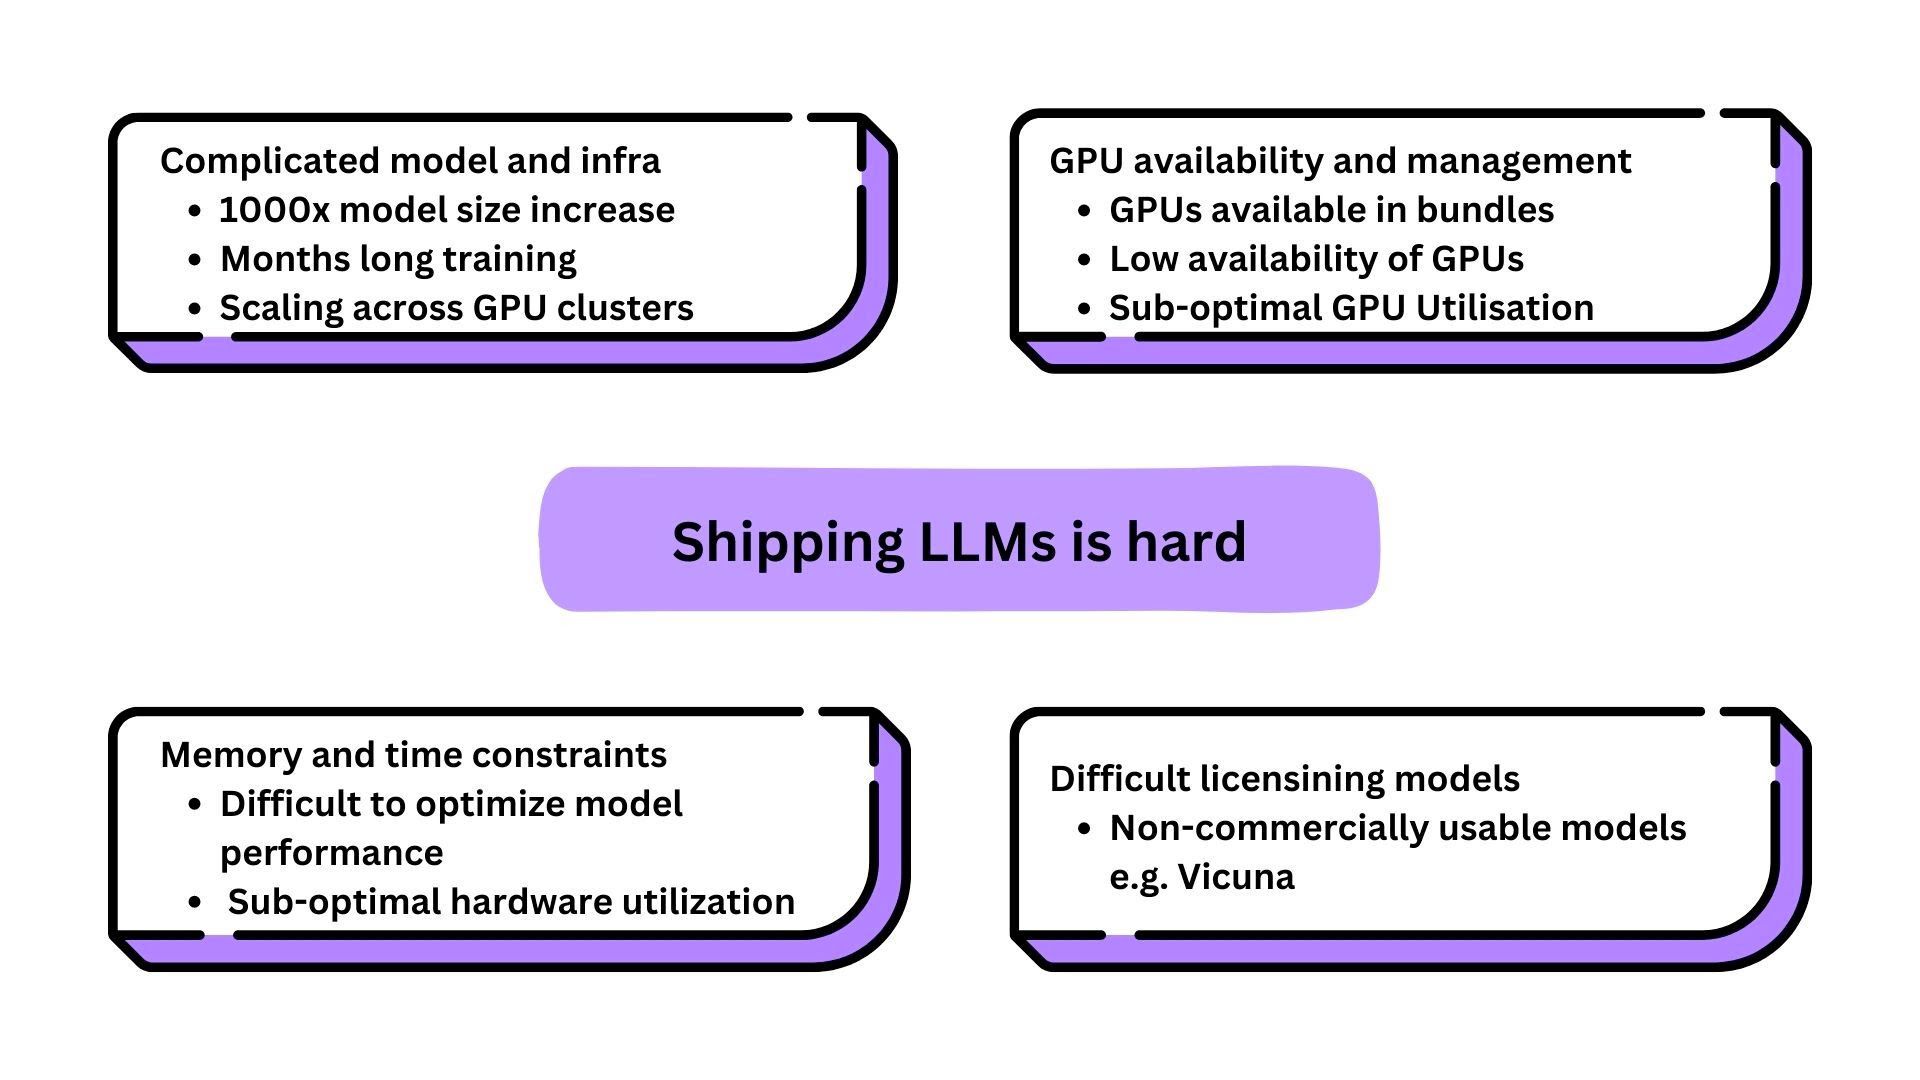
Für die meisten Unternehmen ist der Aufbau der Engineering-Kapazitäten zur zuverlässigen Verwaltung der komplexen GPU-Infrastruktur für das Bedienen von LLMs schwierig und zeitaufwendig. Darüber hinaus wünschen sich die meisten Unternehmen spezifische Modelle, die für ihren Anwendungsfall am besten funktionieren, wofür sie diese Modelle feintunen müssen. Dies kann sowohl technisch anspruchsvoll als auch eine kostspielige Angelegenheit sein.
Unsere Haltung zur Zukunft von LLMs ist, dass Open-Source-Modelle der Weg in die Zukunft sein werden. Lesen Sie hier mehr über unsere Ansichten zu diesem Thema. Wir haben uns entschieden, diese sich rasch innovierende Gemeinschaft von Innovatoren zu nutzen und Unternehmen dabei zu helfen, den vollen Wert dieser Open-Source-LLMs in ihren Organisationen zu nutzen.
TrueFoundry möchte, dass unsere Partner das volle Ausmaß der Vorteile realisieren können, die für ihren spezifischen Anwendungsfall feingetunte Open-Source-LLMs für ihre Organisationen haben können:
Das Verwalten und Bereitstellen von Open-Source-Modellen auf Ihrer eigenen Infrastruktur ist jedoch keine leichte Aufgabe. Während eine On-Premise-LLM-Bereitstellung unerreichte Datenkontrolle, Compliance-Bereitschaft und langfristige Kosteneffizienz bietet, erfordert sie tiefes Fachwissen in GPU-Orchestrierung, Kubernetes-Management und Modelloptimierung.
Aber stellen Sie sich vor, es wäre so einfach wie das Einbinden Ihrer Daten und ein paar Klicks?
Wir verstehen die Herausforderungen, vor denen Unternehmen beim Übergang vom LLM-Proof-of-Concept zur Produktion stehen. Unser Ziel ist es, die Schicht zu bauen, die diesen Prozess für unsere Partner supereinfach macht. So machen wir es:
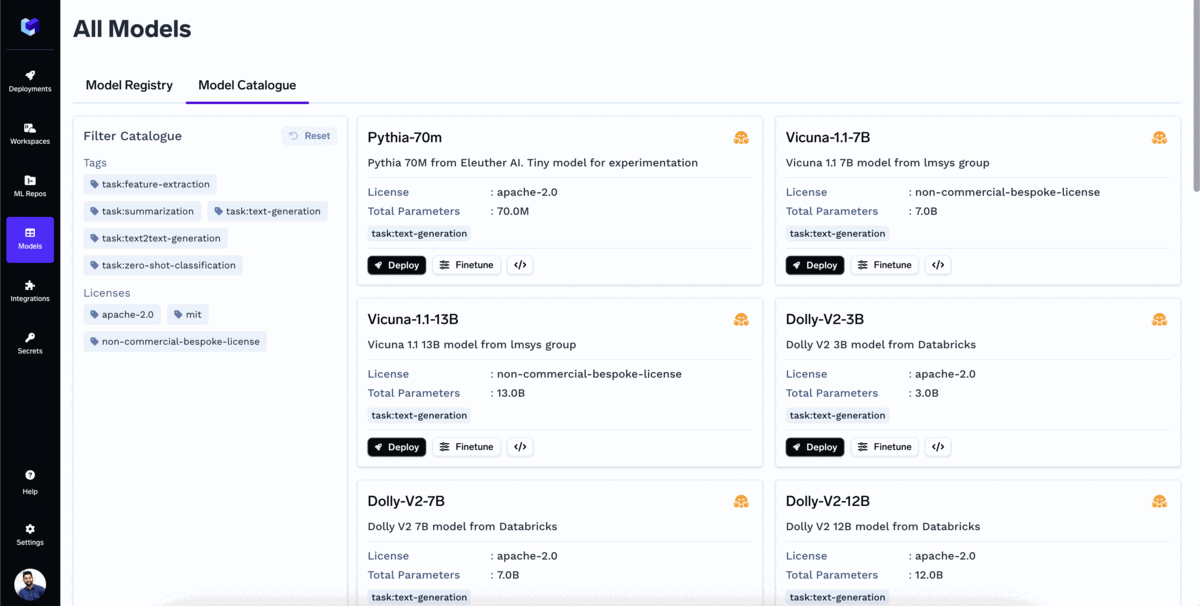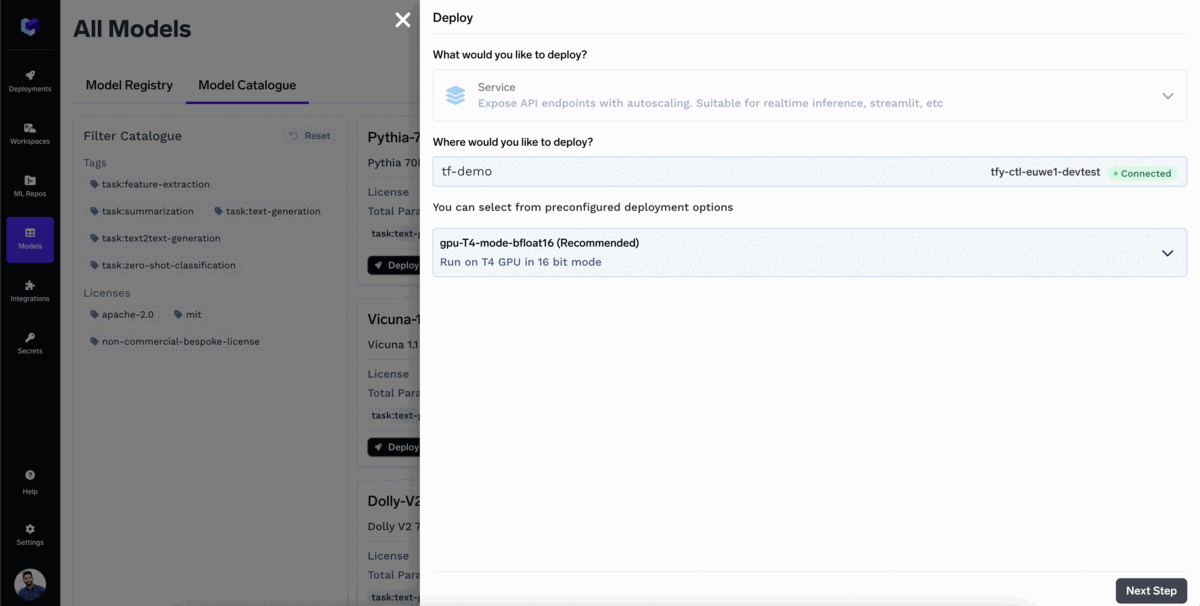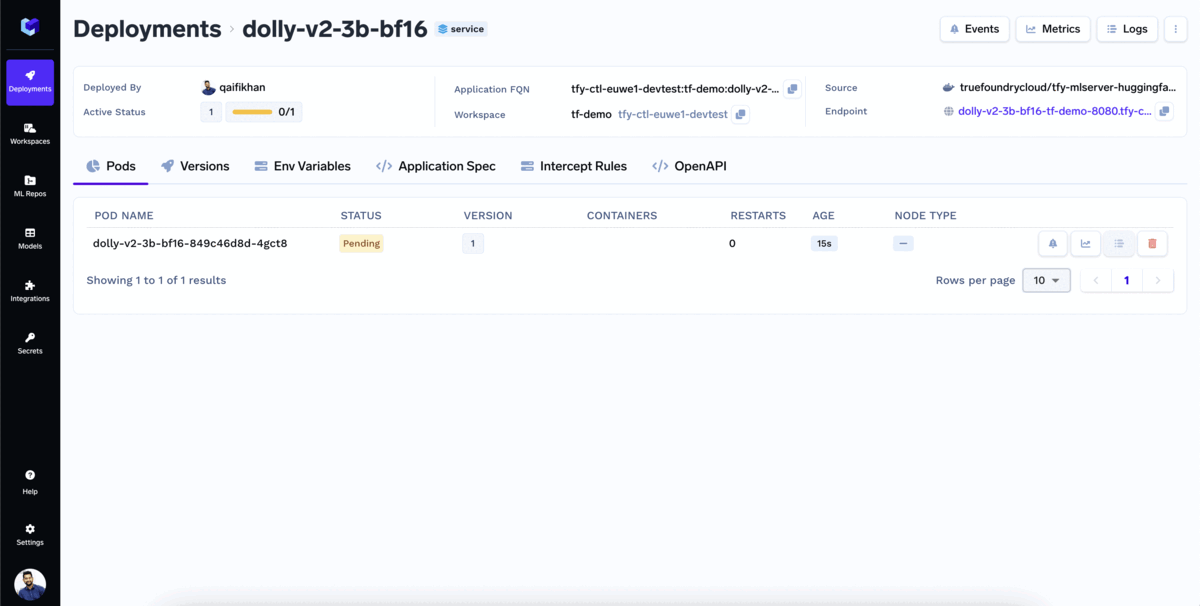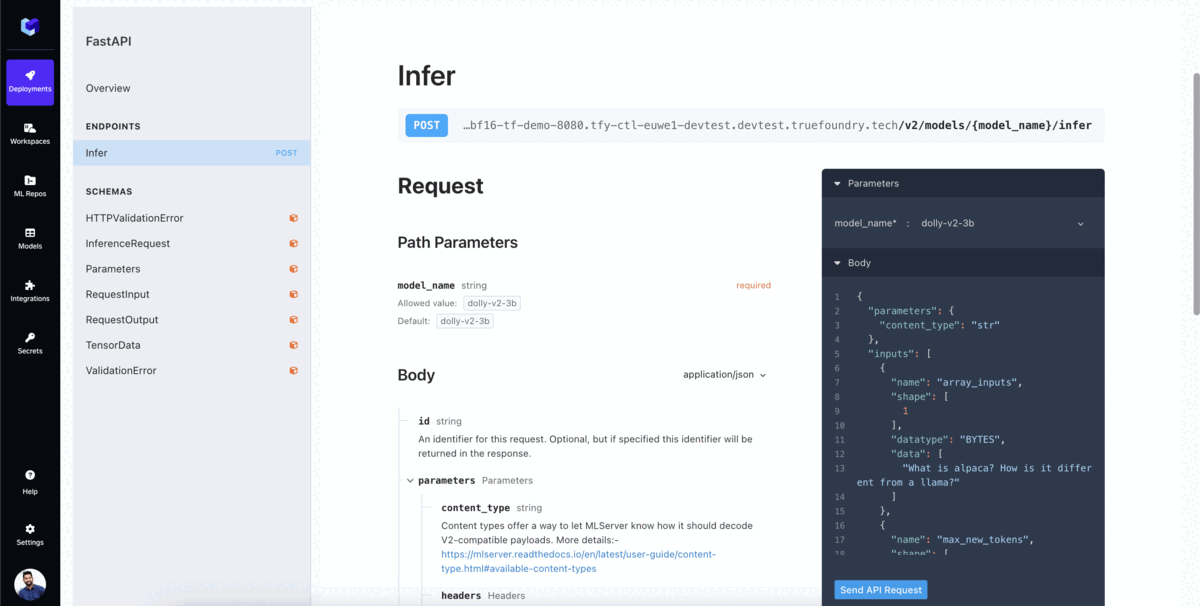
Der Model Catalogue von TrueFoundry ist ein Repository aller beliebten Open-Source Large Language Models (LLMs), die mit einem einzigen Klick bereitgestellt werden können. Der Benutzer kann das Modell auch direkt aus dem Model Catalogue feintunen.
Der Katalog unterstützt bereits die meisten beliebten Modelle, und wir fügen jeden Tag Unterstützung für weitere hinzu. Einige der beliebtesten Modelle, die Sie bereits auf Ihrer eigenen Cloud bereitstellen können, sind:
Und viele mehr.....
Wir sind davon besessen, dass Unternehmen am ersten Tag liefern können. Um dies zu ermöglichen, sind hier die Prinzipien, auf denen wir unsere LLM-Funktionen aufbauen:
ℹ️
Eine detaillierte Anleitung zu den Trainings- und Fine-Tuning-Abläufen auf der Benutzeroberfläche finden Sie in diesem YouTube-Video
Das Bereitstellen Ihrer LLMs ist so einfach wie dreimal klicken!
🚀
Ihr Modell ist jetzt bereitgestellt!
Starten Sie die Inference mit dem Modell-API-Endpunkt. TrueFoundry stellt Ihnen das OpenAPI-Interface zur Verfügung, um Ihr Modell zu testen, sowie den Beispielcode, um das Modell innerhalb Ihrer Anwendungen aufzurufen.
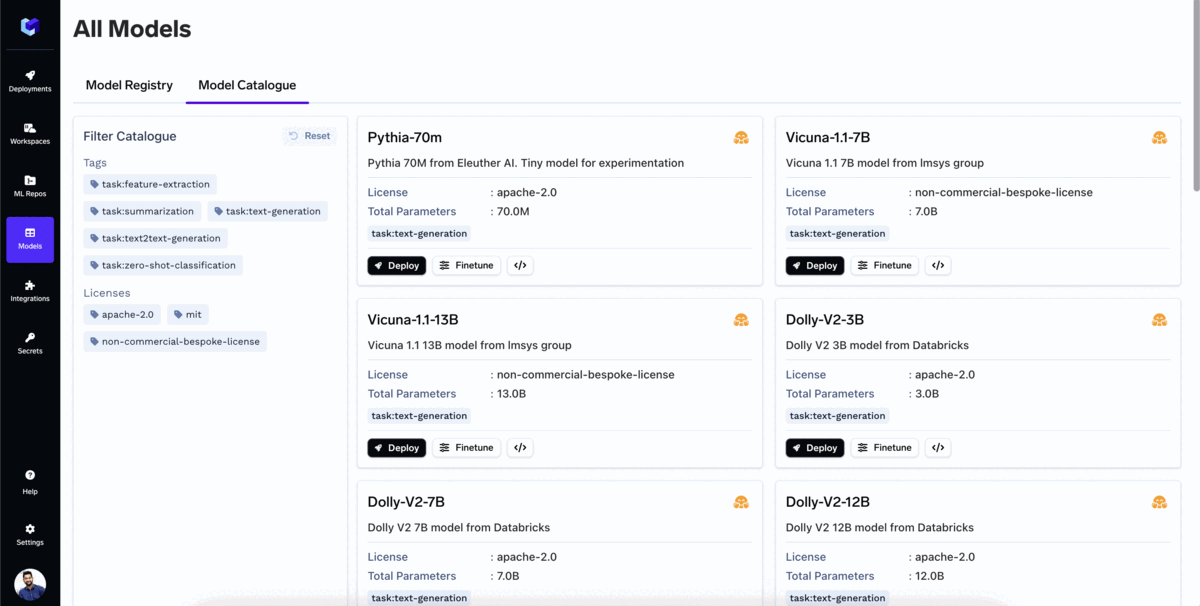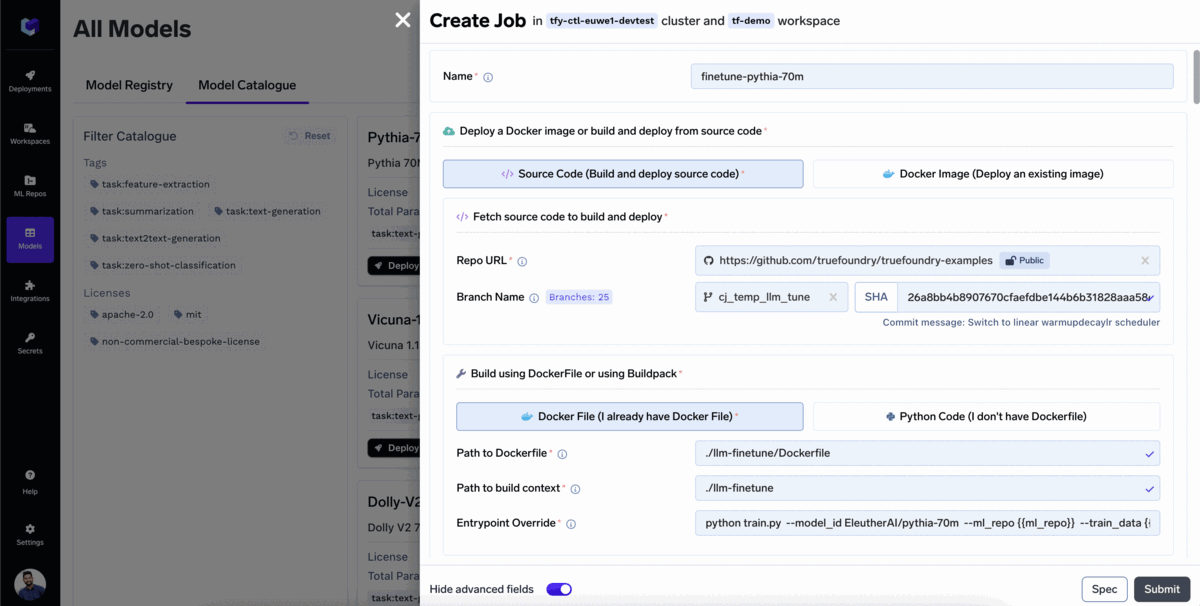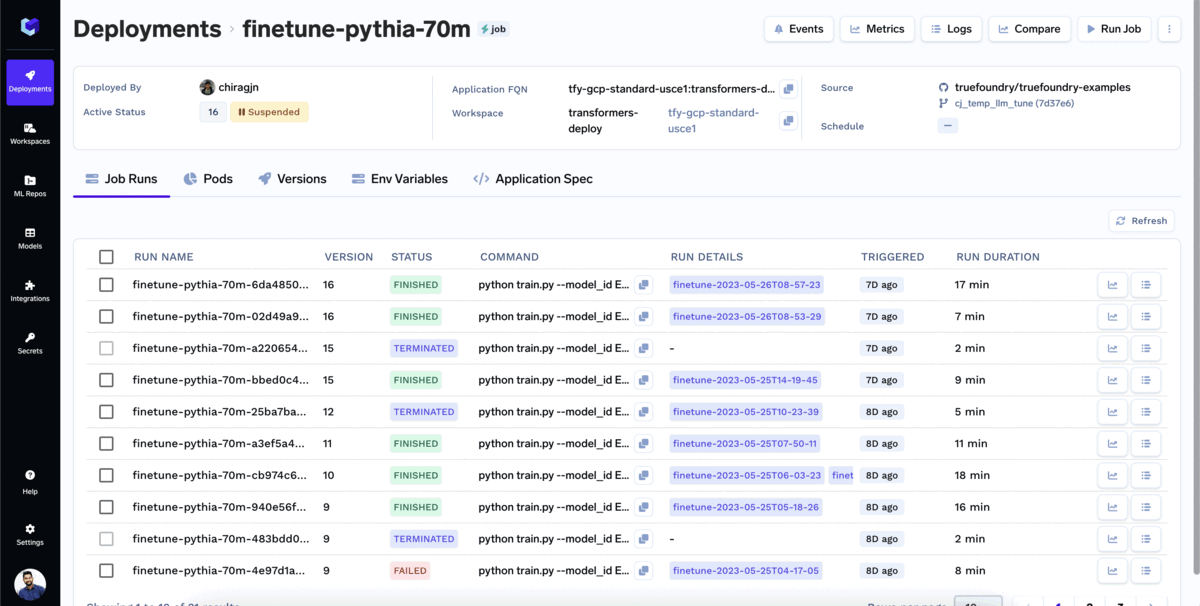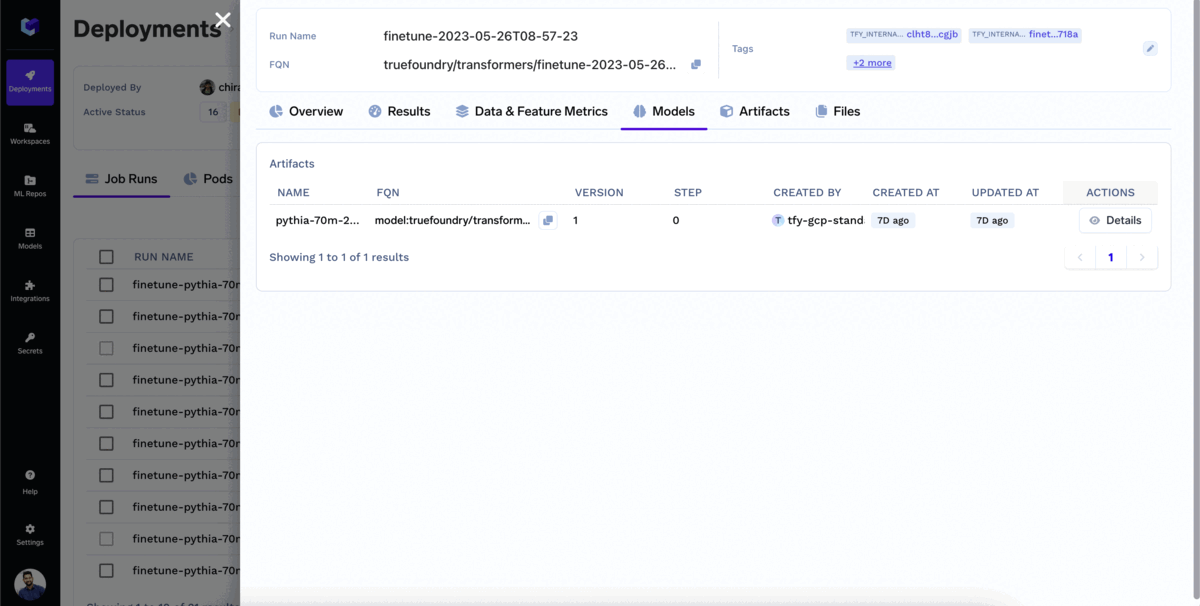
Die meisten Unternehmen möchten Modelle verwenden, die für ihren spezifischen Anwendungsfall feingetunt sind. Um ein Modell mit TrueFoundry feinzutunen:
🚀
Das Modell hat mit dem Fine-Tuning begonnen!
Sie können das Fine-Tuning überwachen, während es fortschreitet. Im Reiter "Job Runs" können Sie alle relevanten Informationen einsehen, die mit dem Trainingsjob verbunden sind, wie z. B. Loss-Metriken, Trainingskurven und Evaluierungsergebnisse. Dies ermöglicht es Ihnen, den Fine-Tuning-Prozess zu verfolgen und fundierte Entscheidungen basierend auf der Leistung des Jobs zu treffen.
Dies ist erst der Anfang unserer Reise mit Large Language Models (LLMs) und Generativer KI. Wir planen, in den kommenden Tagen noch viel mehr zu bauen und werden Sie auf dem Laufenden halten!
Wir lernen in diesem Bereich immer noch dazu, genau wie alle anderen auch. Falls Sie versuchen, Large Language Models in Ihrer Organisation einzusetzen, würden wir uns freuen, uns mit Ihnen zu unterhalten und Erfahrungen auszutauschen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet






















