



November 6, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Das Modell ist selten mehr der schwierigste Teil. Frontier-Modelle sind mittlerweile so leistungsfähig, dass der Wechsel zwischen ihnen bei vielen Agent-Workloads nicht mehr erfordert als das Ändern eines Konfigurationsfelds. Was einen Agenten, der in einer Demo funktioniert, von einem unterscheidet, der auch nach drei Monaten in Production noch zuverlässig arbeitet, ist alles rund um das Modell: der Loop, der Kontext, die Tools, die Sandbox, die Freigaben und die Kontrollmechanismen, die ihn daran hindern, irreversible Aktionen auszuführen.
Diese Schicht ist das Agent Harness, und die Entscheidungen, die Sie dort treffen, können einen größeren Einfluss auf Zuverlässigkeit und Kosten haben als die Modellwahl selbst. Das haben wir bei der Entwicklung und dem Betrieb von TrueForge gelernt, unserem Open-Source Agent Harness. Dies sind die 10 Agent Harness Best Practices, die wir empfehlen, wenn Sie heute Produktions-Agenten bauen.
Beginnen wir mit einer Zahl, da sie alles Folgende in ein neues Licht rückt. Wir haben Enterprise-Bench von DevRev verwendet: 14 systemübergreifende Aufgaben unterschiedlicher Komplexität, die realen B2B-Operations-Aufgaben ähneln. Um eine dieser Aufgaben zu lösen, muss ein Agent planen, MCP-Tools über drei Systeme hinweg aufrufen (ein CRM im Salesforce-Stil, ein Projekt-Tracker im Jira-Stil und ein Dokumenten- sowie Anruf-Transkript-Speicher im Drive-Stil), die Ergebnisse korrekt zusammenführen und die Antwort im passenden Detaillierungsgrad aufbereiten.
Die Genauigkeit ist im Wesentlichen gleichauf. Das Modell setzt die Obergrenze; das Harness macht das zugrundeliegende Modell nicht intelligenter.
Was das Harness jedoch bestimmt, ist, wie viel Aufwand nötig ist, um diese Obergrenze zu erreichen.
In diesem Benchmark löste TrueForge ungefähr dieselbe Anzahl an Aufgaben wie Claude Managed Agents, verbrauchte dabei jedoch etwa 62 % weniger Tokens und kostete pro Durchlauf etwa 28 % weniger. Im Vergleich zu deepagents war der Unterschied bei den Tokens noch größer.
Das ist der Teil der Agent-Infrastruktur, der leicht übersehen wird. Zwei Agenten können dasselbe Modell verwenden, Zugriff auf dieselben Tools haben und dieselbe Aufgabe versuchen, jedoch völlig unterschiedliche Ausführungskosten verursachen.
Der Unterschied entsteht durch das, was um das Modell herum geschieht: wie viel Kontext es mitführt, welche Tools es lädt, wie es mit großen Antworten umgeht, wann es den Zustand kompaktiniert und wie effizient es den Loop ausführt.
Lesen Sie die vollständige Benchmark-Methodik →
Nahezu der gesamte Kostenunterschied in diesem Benchmark lässt sich auf die ersten vier Best Practices zurückführen.
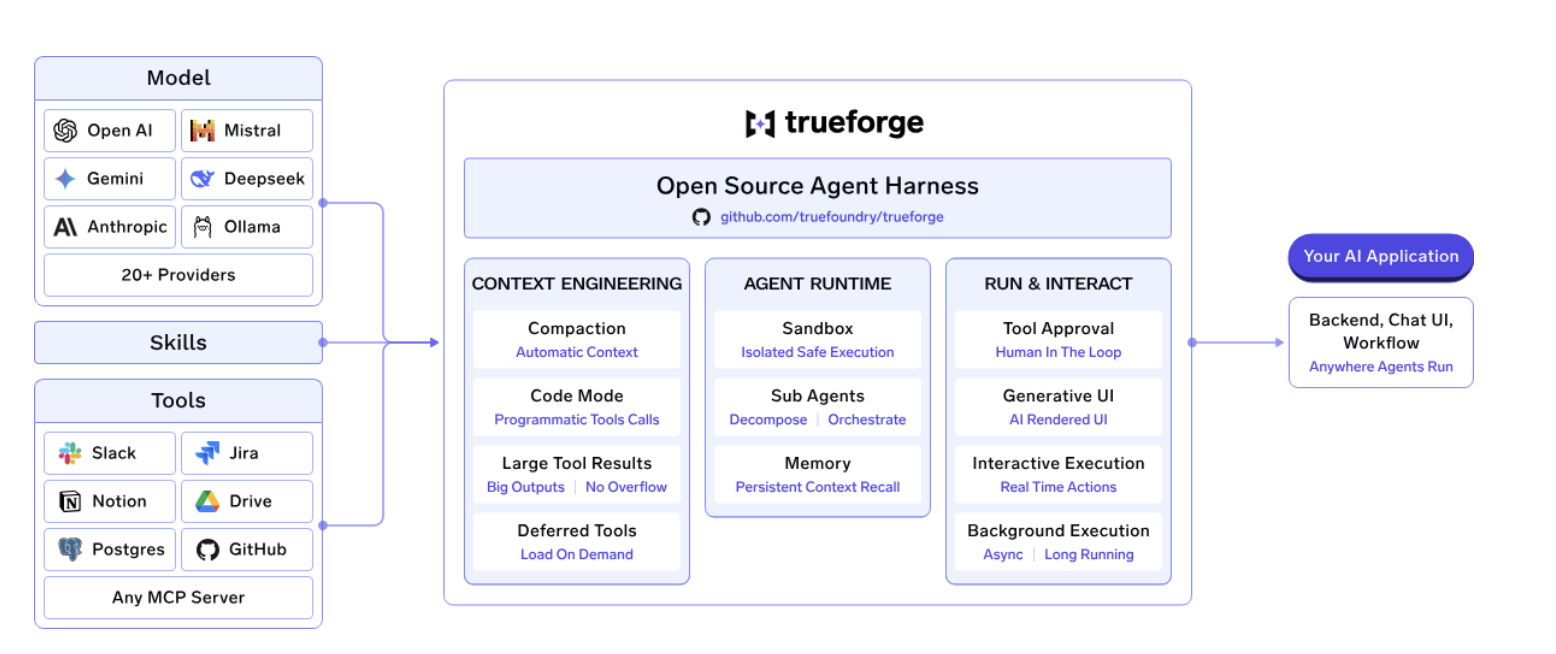
TrueForge ist das Open-Source, herstellerneutrale Agent Harness von TrueFoundry für Teams, die mehr Kontrolle darüber wollen, wie ihre Agenten in Production laufen. Anstatt die Laufzeitumgebung an einen einzelnen Modellanbieter zu binden, können Sie mit TrueForge Ihre eigenen Modelle, MCP-Server und Infrastrukturen nutzen, während es den Agent-Loop, die Tool-Ausführung, das Kontextmanagement, Freigaben und das Sandboxing übernimmt.
Während ein selbstgehosteter Agent wie Hermes einen Großteil der Produktionsinfrastruktur dem Entwickler überlässt, bietet TrueForge die erforderliche Control Plane, um Agenten über Teams und Umgebungen hinweg zu betreiben. Dazu gehören zentraler MCP-Zugriff und Credentials, Human-in-the-Loop-Freigaben, isolierte Ausführung in Sandboxes, Observability und Governance.
Sie können es lokal mit npx @truefoundry/trueforge ausführen oder mit Docker Compose oder Helm für ein ganzes Team bereitstellen.
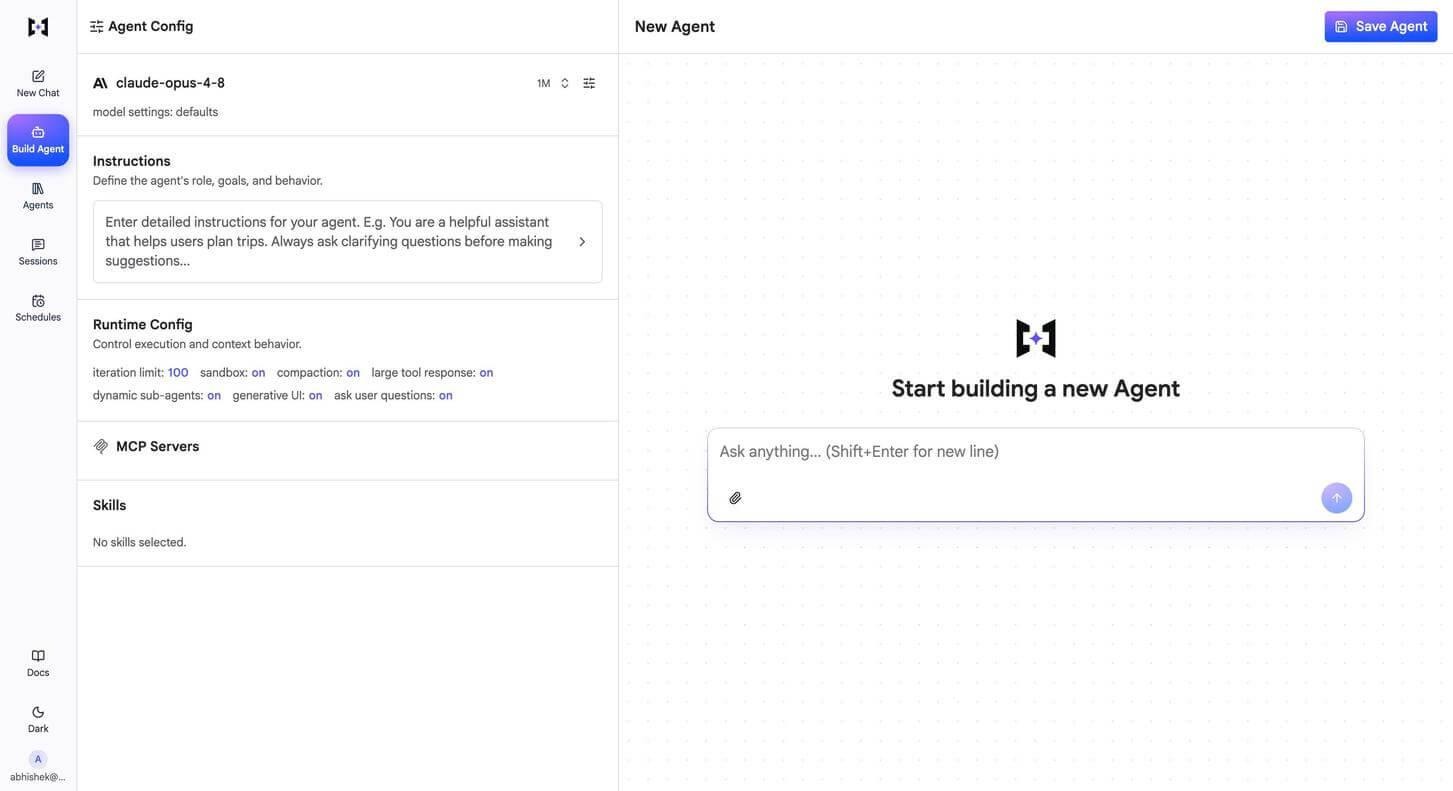
TrueForge trennt außerdem die Agent-Laufzeitumgebung von der Modellschicht. Das bedeutet, dass Teams Modelle wechseln oder Workloads an verschiedene Anbieter routen können, ohne den Agenten selbst neu bauen zu müssen. In Kombination mit dem AI Gateway von TrueFoundry können Teams zudem Modell-Routing und Kostenkontrollen anwenden, um die Nutzung teurer Frontier-Modelle für einfache Aufgaben zu vermeiden. Das Ergebnis ist ein Mittelweg zwischen einer vollständig verwalteten Laufzeitumgebung und dem Eigenbau der gesamten Agent-Infrastruktur: ein Open-Source Agent Harness mit den betrieblichen Kontrollen, die für den skalierbaren Einsatz von Produktions-Agenten erforderlich sind.
TrueFoundry bietet mit dem Auto Routing des AI Gateway einen zweiten Hebel zur Reduzierung von Modellkosten. Anstatt jede Anfrage an ein Frontier-Modell zu senden, klassifiziert Auto Routing Anfragen nach Komplexität und leitet sie an verschiedene Modellstufen weiter. Im Benchmark von TrueFoundry über 550 Prompts reduzierte das Routing zwischen Haiku, Sonnet und Opus die Kosten um 69 % bei 98 % Erhalt der Basisqualität, während die mittlere Latenz von 7,6 Sekunden auf 4,0 Sekunden sank. Bei produktionstypischem Traffic erreichte die Gesamtkostenreduzierung bis zu 80 %.
Diese beiden Schichten adressieren unterschiedliche Teile der Kostenrechnung. TrueForge reduziert den Overhead für die Ausführung des Agenten selbst, während Modell-Routing verhindert, dass teure Modelle für einfache Aufgaben genutzt werden. Für Teams, die Agenten im großen Maßstab betreiben, kann die Verfügbarkeit beider Kontrollmechanismen wichtiger sein als der reine Modellpreis.
TrueForge ist Open Source und unter der MIT-Lizenz verfügbar. Das AI Gateway von TrueFoundry ergänzt die operative Schicht, die Teams beim Übergang von einzelnen Agenten in den Produktionsbetrieb benötigen: zentraler Modellzugriff, Budgets, Guardrails, Credential-Rotation und einheitliche Traces.
Wenn Sie Claude Managed Agents mit einer konfigurierbareren Architektur vergleichen, ist TrueFoundry eine Überlegung wert, wenn Modellflexibilität, Infrastrukturkontrolle und Agent-Kostenoptimierung neben der eigentlichen Agent-Laufzeitumgebung eine Rolle spielen.
Hier geht es ums Geld. Context Engineering ist die Disziplin der Entscheidung, was das Modell in jedem Schritt sieht – und bei einem lang laufenden Agenten summiert sich das Schritt für Schritt auf.
Was schiefgeht: Sie verbinden fünf MCP-Server, jedes Tool-Schema wird beim Start geladen, und der Agent verbrennt Zehntausende Tokens für Definitionen von Tools, die er nie aufrufen wird. Jeder nachfolgende Schritt schleppt diese mit sich herum.
Was zu tun ist: Laden Sie Tool-Schemata bei Bedarf (on Demand) statt im Voraus. Gutes Agent-Kontextmanagement beginnt vor dem ersten Modellaufruf, nicht erst, wenn das Fenster voll ist.
In TrueForge: Deferred Tool Loading gibt dem Agenten einen leichtgewichtigen Index und ruft das vollständige Schema erst ab, wenn er auf dieses Tool zugreift.
What schiefgeht: Das Fenster füllt sich, das Harness verwirft die ältesten Inhalte, und der Agent vergisst stillschweigend die Einschränkung, die Sie ihm im dritten Schritt gegeben haben. Es entsteht kein Fehler. Er wird einfach schlechter, und der Fehler ist schwer zu erkennen, da der Output weiterhin plausibel aussieht.
Was zu tun ist: Fassen Sie die alte Historie in einem strukturierten Datensatz zusammen und behalten Sie diese Zusammenfassung. Setzen Sie den Schwellenwert unterhalb des Limits, damit die Kompaktierung zu Ihren Bedingungen und nicht unter Druck erfolgt.
In TrueForge: Die Kompaktierung wird bei 80 % der Kontextlänge des Modells ausgelöst und ersetzt die alte Historie durch eine strukturierte Zusammenfassung. Truncation ist für einen kurzen Support-Agenten in Ordnung, schadet aber bei einer mehrstündigen Aufgabe massiv.
Ein wichtiger Hinweis: Kompaktierung birgt eigene Risiken, wenn Richtlinien und Constraints nur in der Konversation existieren. Wir haben darüber geschrieben, wie Kompaktierung die Governance aushöhlt und warum die Durchsetzung außerhalb des Kontextfensters hingehört.
Was schiefgeht: Ein Tool liefert eine 200 KB große JSON-Payload zurück, die vollständig im Kontextfenster landet, obwohl der Agent nur drei Felder daraus benötigte.
Was zu tun ist: Schreiben Sie die Payload an einen Ort, den der Agent erreichen kann, und übergeben Sie ihm eine Referenz anstelle des Inhalts.
In TrueForge: Large Tool Response Offloading schreibt die Antwort in eine Sandbox-Datei und ersetzt sie durch einen Pfad und eine Vorschau. Der Code Mode geht noch weiter: Er ermöglicht es dem Agenten, mehrere Tool-Aufrufe innerhalb eines Sandbox-Skripts zu verketten, sodass nur das gedruckte Ergebnis in den Kontext gelangt. Aus fünf Roundtrips wird eine einzige Zusammenfassung.
Was schiefgeht: Ein Subagent erbt den gesamten Parent-Thread, führt seine Arbeit aus und gibt seinen gesamten Reasoning-Trace in den Parent-Kontext zurück. Sie haben nun zweimal für dieselbe Historie bezahlt und den Hauptthread verunreinigt.
Was zu tun ist: Delegation sollte den Kontext des Parents verkleinern, nicht vergrößern.
In TrueForge: Subagenten laufen mit ihrem eigenen, sauberen Kontext und liefern nur das Ergebnis zurück.
Ausprobieren: npx @truefoundry/trueforge führt in etwa einer Minute lokal ein Harness aus, bei dem alle vier Funktionen standardmäßig aktiviert sind. Geben Sie dem Projekt einen Star auf GitHub.
Was schiefgeht: Das Harness verpackt jede Sitzung in einen Container, unabhängig davon, ob der Agent jemals Code ausführt. Sie zahlen für Container-Laufzeit bei Konversationen, die reine Textinteraktionen waren, und ein Server kann deutlich weniger parallele Agenten verwalten.
Was zu tun ist: Stellen Sie die Sandbox erst dann bereit, wenn der Agent tatsächlich etwas ausführen muss. Beim Agent-Sandboxing geht es um den Radius möglicher Schäden (Blast Radius) – Sie erhalten dieselbe Isolierung, ohne in jedem Schritt dafür zu bezahlen.
In TrueForge: Die Sandbox ist ein Tool, das erst gestartet wird, wenn der Agent Code ausführen muss. Dadurch kann ein Server viele Agenten verwalten, und Schritte, die keinen Code berühren, bleiben günstig. Sandbox-Anbieter können frei gewählt werden (Bring-Your-Own).
Das tiefergehende Argument dafür, Modelle ausführen zu lassen, ohne ihnen freien Lauf zu lassen, ist lesenswert, wenn Sie ein solches System von Grund auf konzipieren.
Was schiefgeht: Teams neigen bei Freigaben zu zwei Extremen. Entweder wird nichts abgesichert und ein Agent löscht irgendwann etwas, oder alles wird abgesichert und ein Mensch klickt vierzig Mal pro Stunde auf Freigeben, bis er aufhört zu lesen.
Was zu tun ist: Steuern Sie Freigaben basierend auf der Irreversibilität. Das Senden einer E-Mail, das Schreiben in Production, das Ausgeben von Geld, das Löschen von Daten. Lesezugriffe und Entwürfe laufen frei. Und setzen Sie Compliance-Anforderungen nicht um, indem Sie sie im System-Prompt beschreiben und hoffen – ein Prompt ist eine Empfehlung, während Guardrails, die jeden Tool-Aufruf prüfen, eine echte Kontrolle darstellen.
In TrueForge: Der Core-Server pausiert den Lauf und wartet bei sensiblen Aktionen auf die Freigabe, bevor der Aufruf rausgeht, nicht danach.
Wo dieses Gate liegt, ist genauso wichtig wie seine Existenz. Das haben wir im Artikel über das Design von MCP-Tool-Freigaben an der Gateway-Grenze behandelt.
Was schiefgeht: Ein Laptop geht in den Ruhezustand, ein Load Balancer setzt eine Verbindung zurück, und vierzig Minuten Agentenarbeit sind verloren. Bei Aufgaben, die eine Stunde laufen, ist das kein Edge Case mehr.
Was zu tun ist: Speichern Sie den Session-State persistent, sodass eine unterbrochene Verbindung fortgesetzt wird, anstatt neu zu starten.
In TrueForge: Sitzungen bleiben über Reconnects und Neustarts hinweg bestehen. Resumability gehört zu den Eigenschaften, nach denen beim Design-Review niemand fragt, die aber ab Woche zwei jeder benötigt.
Was schiefgeht: Sie haben Token-Zahlen und Latenzzeiten pro Modellaufruf, aber keine Ahnung, welcher Schritt eines 60-Schritte-Laufs schiefgegangen ist. Debugging wird zur Archäologie.
Was zu tun ist: Senden Sie strukturierte Events für jeden Schritt, sodass sich ein Lauf wie eine Zeitachse und nicht wie eine Wand aus Logs liest. Stellen Sie sicher, dass der Loop selbst beobachtbar ist, bevor Sie ihn unter Stress debuggen müssen.
In TrueForge: Jeder Schritt wird gestreamt, während er passiert, und der Agent-Events-Laufzeitvertrag ist veröffentlicht, damit Ihre eigenen Tools ihn nutzen können.
Die Betrachtungsweise im Artikel Loop Engineering ist hier nützlich: Der Loop ist die Middleware, behandeln Sie ihn also wie Infrastruktur.
Was schiefgeht: Der Agent ist gegen das SDK und die Eigenheiten eines einzelnen Anbieters geschrieben. Ein günstigeres oder besseres Modell erscheint, aber ein Wechsel bedeutet ein Umschreiben des Codes – also wechseln Sie nicht.
Was zu tun ist: Kommunizieren Sie mit Modellen über OpenAI-kompatible Schnittstellen und halten Sie Anbieterspezifika aus Ihrer Agentenlogik heraus.
In TrueForge: Modelle, MCP-Server und Sandbox-Anbieter sind über offene Schnittstellen frei wählbar. Das ist kein theoretischer Mehrwert. Im selben Benchmark löste der Betrieb von TrueForge auf GLM-5.2 anstelle von Opus 4.8 dieselben ~11 von 14 Aufgaben für $2.90 pro Lauf gegenüber $8.50. Diese Ersparnis ist nur verfügbar, wenn der Wechsel eine bloße Konfigurationsänderung ist.
Was schiefgeht: Jedes Team verwaltet seine eigenen Modellschlüssel und MCP-Credentials. Niemand kann Ausgaben begrenzen, PII-Maskierung ist uneinheitlich, und das Beantworten einer Audit-Frage bedeutet das Zusammenfügen von Logs aus neun verschiedenen Diensten.
Was zu tun ist: Schalten Sie ein Gateway zwischen Ihre Agenten und alles, was sie aufrufen.
In TrueForge: Das ist bewusst nicht die Aufgabe des Harnesses. Beim Self-Hosting bringen Sie Ihre eigenen Schlüssel mit und verwalten diese selbst – was funktioniert, bis Sie viele Agenten betreiben. An diesem Punkt verbinden Sie es mit dem AI Gateway von TrueFoundry. Dieses stellt 1.000+ LLMs hinter einer einzigen OpenAI-kompatiblen API bereit – bei nur etwa 3 bis 4 ms zusätzlicher Latenz und 350+ RPS auf einer einzelnen vCPU, inklusive RBAC, Budgets, Guardrails, Credential-Rotation und OpenTelemetry-Traces für Grafana, Datadog oder Prometheus.
Betreiben Sie mehr als nur ein paar Agenten? Erfahren Sie, wie das AI Gateway diese zentral steuert, oder buchen Sie eine Demo, um es auf Ihr Setup abstimmen zu lassen.
Neun von zehn Punkten sind im Harness umgesetzt. Der zehnte ist es bewusst nicht, da ein Harness, das gleichzeitig Ihre Control Plane sein möchte, meist in beiden Bereichen Schwächen zeigt.
Neubau eines bereits existierenden Loops. Wenn Sie Plan-Act-Observe von Grund auf neu schreiben, prüfen Sie zuerst, ob ein Harness dies bereits bietet. Agent Harness Design lohnt sich nur dann, wenn Ihr Problem wirklich außergewöhnlich ist.
Versuch, Kontrollen über Prompts durchzusetzen. Compliance-Schritte, Ausgabenlimits und Freigabe-Gates gehören in den Code oder an ein Gateway. Ein Modell, das man höflich bitten kann, lässt sich auch davon überzeugen, Regeln zu umgehen.
Alles in Sandboxes verpacken. Isolierung bei jedem Schritt kostet reales Geld und bringt keinen Nutzen bei Interaktionen, die niemals Code ausführen.
Das Modell statt des Gesamtlaufs messen. Token-Zahlen pro Aufruf sehen gut aus, während sich die Gesamtkosten pro abgeschlossener Aufgabe stillschweigend verdreifachen. Messen Sie stets den gesamten Lauf.
F: Was sind Agent Harness Best Practices?
A: Die wichtigsten sind Kontext-Practices: Laden Sie Tool-Schemata bei Bedarf, kompaktieren Sie die Historie statt sie abzuschneiden, lagern Sie große Tool-Antworten in Dateien aus und halten Sie den Kontext von Subagenten vom Parent getrennt. Stellen Sie Sandboxes nur bereit, wenn Code ausgeführt wird, sichern Sie nicht rückgängig machbare Aktionen ab, speichern Sie Sitzungen persistent für Reconnects und senden Sie strukturierte Events für jeden Schritt. In unserem Benchmark machten diese Entscheidungen einen mehr als 4-fachen Unterschied bei den Tokens pro Lauf für identische Aufgaben aus.
F: Wie verhindert man, dass einem Agenten bei langen Aufgaben der Kontext ausgeht?
A: Kompaktierung statt Truncation. Fassen Sie ältere Historie ab einem Schwellenwert – etwa 80 % der Kontextlänge des Modells – in einem strukturierten Datensatz zusammen, damit der Agent den Faden behält, anstatt ihn stillschweigend zu verlieren. Kombinieren Sie dies mit Deferred Tool Loading und der Auslagerung von Antworten, damit sich das Fenster gar nicht erst so schnell füllt.
F: Sollte man jede Agenten-Sitzung in einer Sandbox ausführen?
A: Nein. Isolieren Sie die Code-Ausführung, nicht die Sitzung. Einen Container für eine gesamte Konversation offen zu halten, kostet bei jedem Schritt Geld, der keinen Code ausführt, und begrenzt die Anzahl der Agenten, die ein Server verarbeiten kann. Die Bereitstellung bei Bedarf bietet dieselbe Isolierung zu einem Bruchteil der Kosten.
F: Kann ich ein Agent Harness in meiner eigenen VPC oder On-Premises betreiben?
A: Ja, mit jeder selbstgehosteten Option. TrueForge läuft lokal über einen einzelnen npx Befehl oder via Docker Compose und Helm für Team-Deployments mit Postgres, Redis, Replicas und OIDC-Login. Die verwaltete Plattform von TrueFoundry läuft ebenfalls Self-Hosted, On-Prem, Air-Gapped oder Hybrid, sodass keine Daten Ihre Domain verlassen.
F: Unterstützt TrueFoundry MCP und Agenten aus anderen Frameworks?
A: Ja. Die Plattform umfasst ein MCP Gateway, ein Agent Gateway und eine Registry mit Zugriffskontrolle auf Tool-Ebene. Agenten, die auf LangGraph, CrewAI, AutoGen oder einem benutzerdefinierten Framework basieren, können über dieselbe Schicht gesteuert werden. Diese Best Practices erfordern also nicht die Festlegung auf einen einzelnen Stack.
Agent Harness Best Practices lassen sich auf eine Gewohnheit reduzieren: Entscheiden Sie bewusst, was das Modell sieht und was es tun darf, und messen Sie dann den gesamten Lauf anstatt des einzelnen Aufrufs. Teams, die dies umsetzen, erhalten Agenten, die ein Viertel so viel kosten und auf eine Weise fehlschlagen, die sich sauber diagnoseübergreifend nachvollziehen lässt.
Sie müssen uns bei den Zahlen nicht blind vertrauen. TrueForge ist MIT-lizenziert und die Benchmark-Methodik ist veröffentlich, sodass Sie sie gegen Ihre eigenen Aufgaben laufen lassen können.
npx @truefoundry/trueforge, um es in etwa einer Minute auszuprobieren, lesen Sie die Dokumentation oder buchen Sie eine Demo, wenn Sie sehen möchten, wie es auf Ihren Stack angewendet wird.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















