



novembro 20, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: novembro 20, 2026

Blazingly fast way to build, track and deploy your models!
Se você atingiu os rate limits do OpenRouter, o motivo geralmente não é o tráfego. O OpenRouter limita requisições por chave e por conta, e a margem de manobra que você obtém é indexada à quantidade de créditos que você comprou, portanto, um saldo baixo resulta em um rate limit baixo. Essa é uma propriedade de faturamento cumprindo o papel de um controle de disponibilidade, e é o primeiro indício de que o modelo de custos do OpenRouter e o modelo de custos de uma equipe de plataforma foram feitos para pessoas diferentes.
Este artigo cobre o tópico de controle e otimização de custos da nossa série TrueFoundry vs OpenRouter: rate limits, orçamentos e se eles apenas alertam ou bloqueiam, cotas e janelas de redefinição, roteamento consciente de custos e como a tabela de preços é mantida, caching e atribuição para chargeback. Ele foi escrito para o engenheiro encarregado de reduzir os custos com APIs de LLM e para o líder de plataforma que precisa prestar contas sobre eles, e cada afirmação é extraída da documentação pública dos dois provedores. Para entender o papel que um gateway de LLM desempenha nesse cenário, comece pelo nosso guia introdutório.
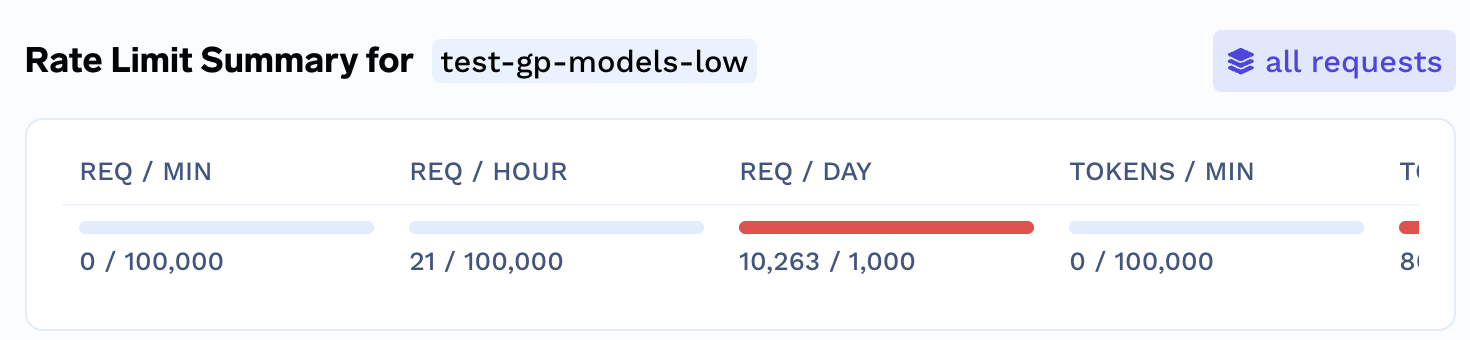
O OpenRouter aplica rate limits por requisições, e esses limites estão atrelados ao seu saldo. Variantes de modelos gratuitos são limitadas a 20 requisições por minuto; contas com menos de $10 em compras acumuladas de crédito recebem 50 requisições diárias para modelos gratuitos, subindo permanentemente para 1.000 por dia assim que $10 forem gastos, e requisições que falharam ainda podem contar contra o limite. Além do nível gratuito, os rate limits de modelos gratuitos dependem dos créditos adquiridos, de modo que a margem de vazão é uma função do saldo da conta, e não uma cota publicada por cliente. Limites baseados em tokens e limites de concorrência não são documentados. As requisições que excedem o limite são rejeitadas imediatamente, sem enfileiramento.
Isso gera duas consequências. Primeiro, um limite de crédito no OpenRouter é tanto um controle de gastos quanto um controle de disponibilidade: se o saldo ficar baixo, o rate limit diminui junto; se chegar a zero, o tráfego é interrompido. Segundo, como os créditos ficam no nível da conta enquanto os workspaces ficam abaixo dela, o tráfego de um workspace plausivelmente consome a margem compartilhada com todos os outros workspaces da organização, e nada no produto isola essa separação.
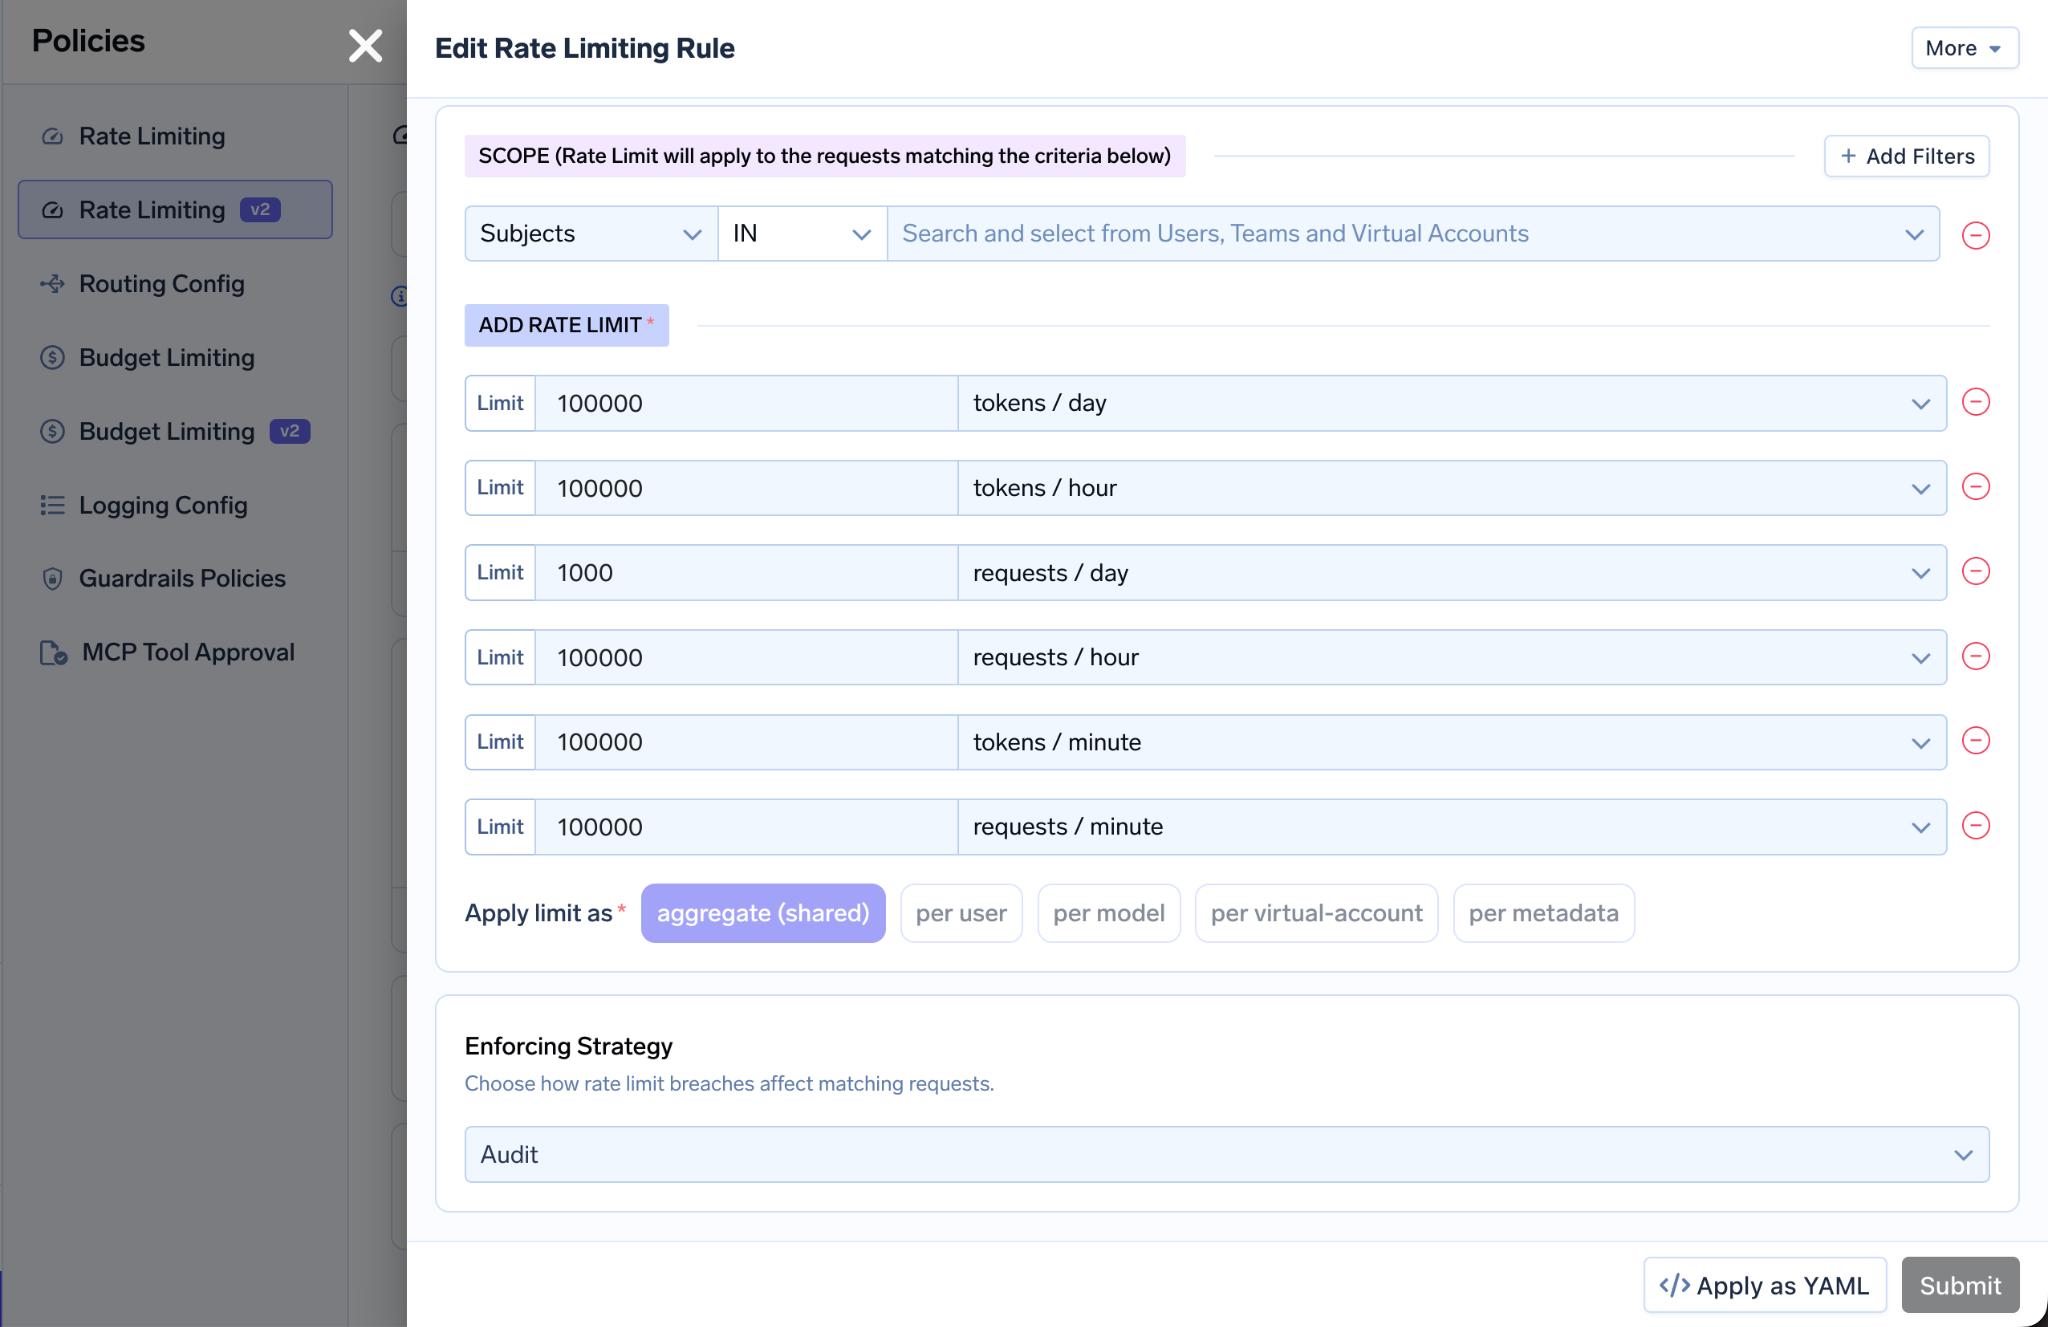
O TrueFoundry aplica rate limits por requisições e por tokens, por minuto, hora ou dia, com regras aplicadas por usuário, equipe, conta virtual, modelo ou metadados da requisição, seguindo a semântica da primeira regra correspondente (rate limiting). Os limites são independentes do que você nos pagou e do tráfego de outras equipes, porque o gateway mantém as regras em memória e nunca consulta um saldo para atender a uma requisição. Limites de concorrência também não são documentados do nosso lado; essa é a única linha em que ambos os produtos devem ser testados na prática, e não apenas lidos. Nosso guia sobre rate limiting em um gateway de LLM explica como dimensionar as regras.
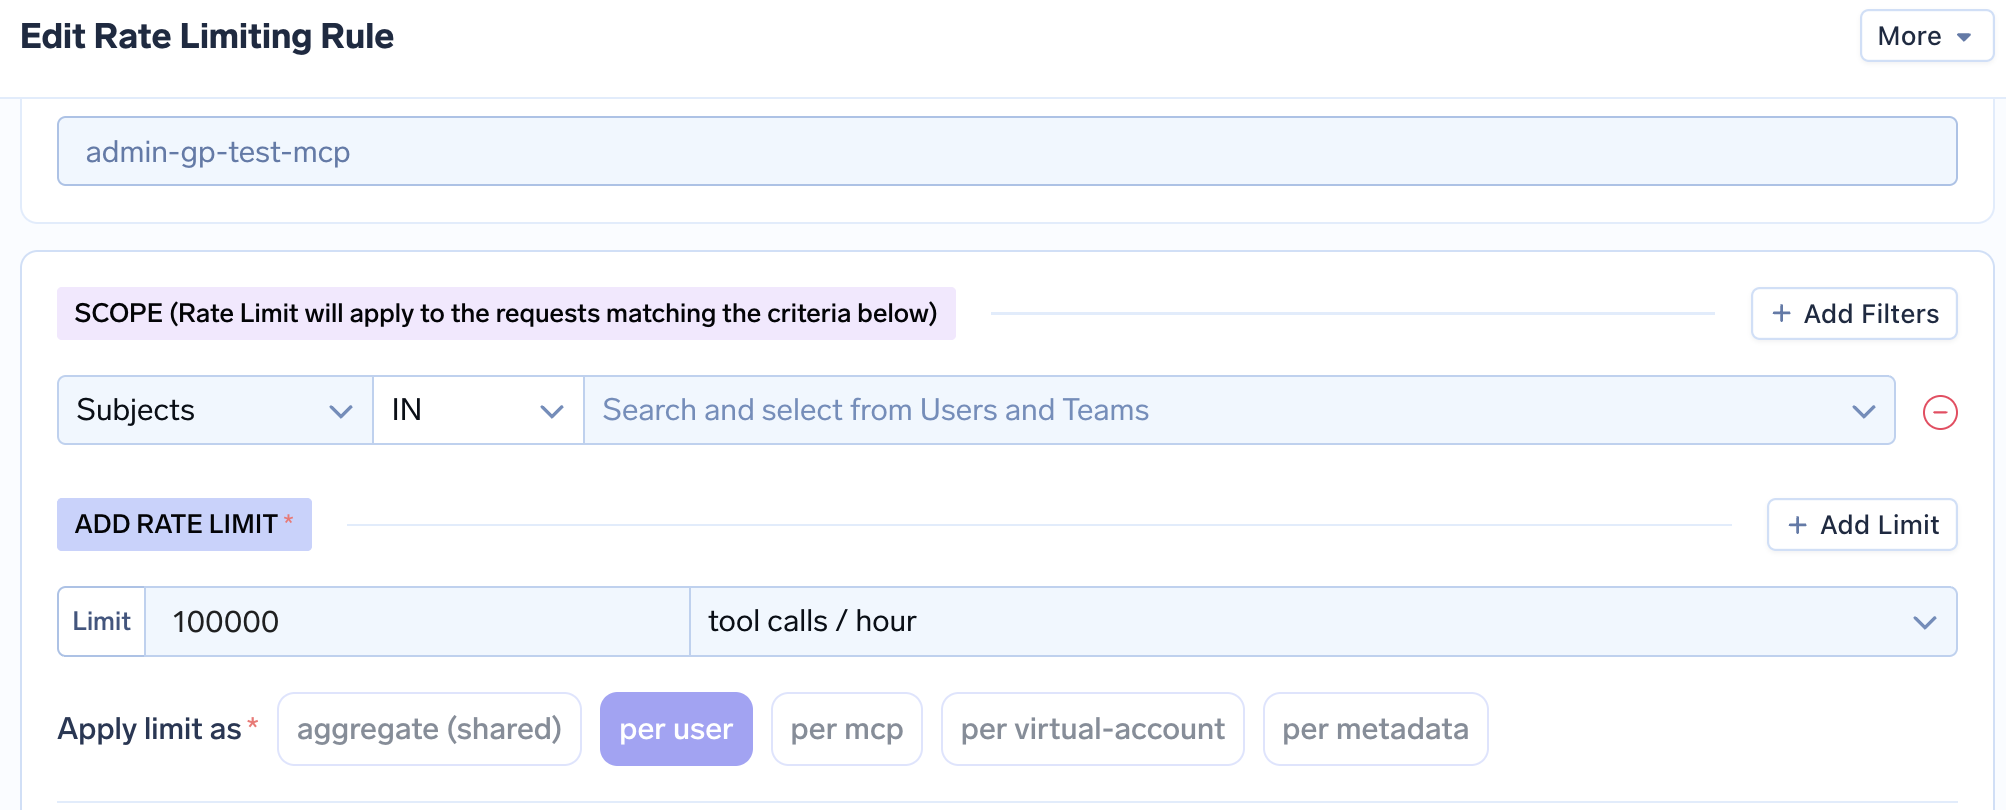
Um orçamento no OpenRouter existe em três níveis. Por chave: um limite de crédito com redefinição opcional diária, semanal ou mensal à meia-noite UTC e desativação automática quando a chave o excede. Por membro e por workspace: limites de proteção que impõem orçamentos, atribuíveis a chaves ou membros, tendo a política em nível de conta como um teto que o workspace só pode estreitar. O Workspace Budgets é um recurso de primeira classe com sua própria API, com intervalos que se aninham (vitalício, mensal, semanal, diário), limites que devem diminuir estritamente à medida que o intervalo encurta e uma chave include_byok_in_budgets que decide se a inferência do tipo traga-sua-própria-chave (BYOK) deve ser contabilizada.
Três escolhas de design são importantes. Os orçamentos nunca são compartilhados em um fundo comum (pooling): a mesma regra de proteção de orçamento diário aplicada a três membros concede a cada um deles esse orçamento separadamente, e uma requisição conta tanto para o orçamento da chave quanto para o do membro proprietário. Não há mecanismo direto por modelo e por aplicação; um orçamento por app funciona apenas quando o app é a própria chave. E os orçamentos são de bloqueio estrito, não de alerta: um modo apenas de alerta não é documentado, e uma requisição acima do limite retorna HTTP 403, que é como uma equipe geralmente descobre que seu orçamento acabou.
O Budget Limiting V2 do TrueFoundry define regras com escopo no tenant ou na equipe, filtradas por usuários, equipes, contas virtuais, modelos (concretos ou virtuais), contas de provedores e metadados da requisição por meio do cabeçalho X-TFY-METADATA, tornando um orçamento por app algo simples de configurar via conta virtual ou tag de metadados (budget limiting v2). As regras funcionam no modo de aplicação (requisição bloqueada) ou apenas alerta; múltiplas regras são combinadas com a lógica E; os limites se aplicam no agregado ou por usuário, por conta virtual, por modelo ou por valor de metadados; e os períodos são diários, semanais, mensais, trimestrais ou vitalícios, empilháveis em uma única regra ($0,50 por dia e $2 por trimestre, onde qualquer violação bloqueia). Alertas de marcos são disparados em 75, 90, 95 e 100% para e-mail, webhook do Slack ou bot do Slack. Um detalhe importante que declaramos claramente: o rastreamento começa quando a regra é criada, não no início do período, portanto o gasto anterior não é contado retroativamente.
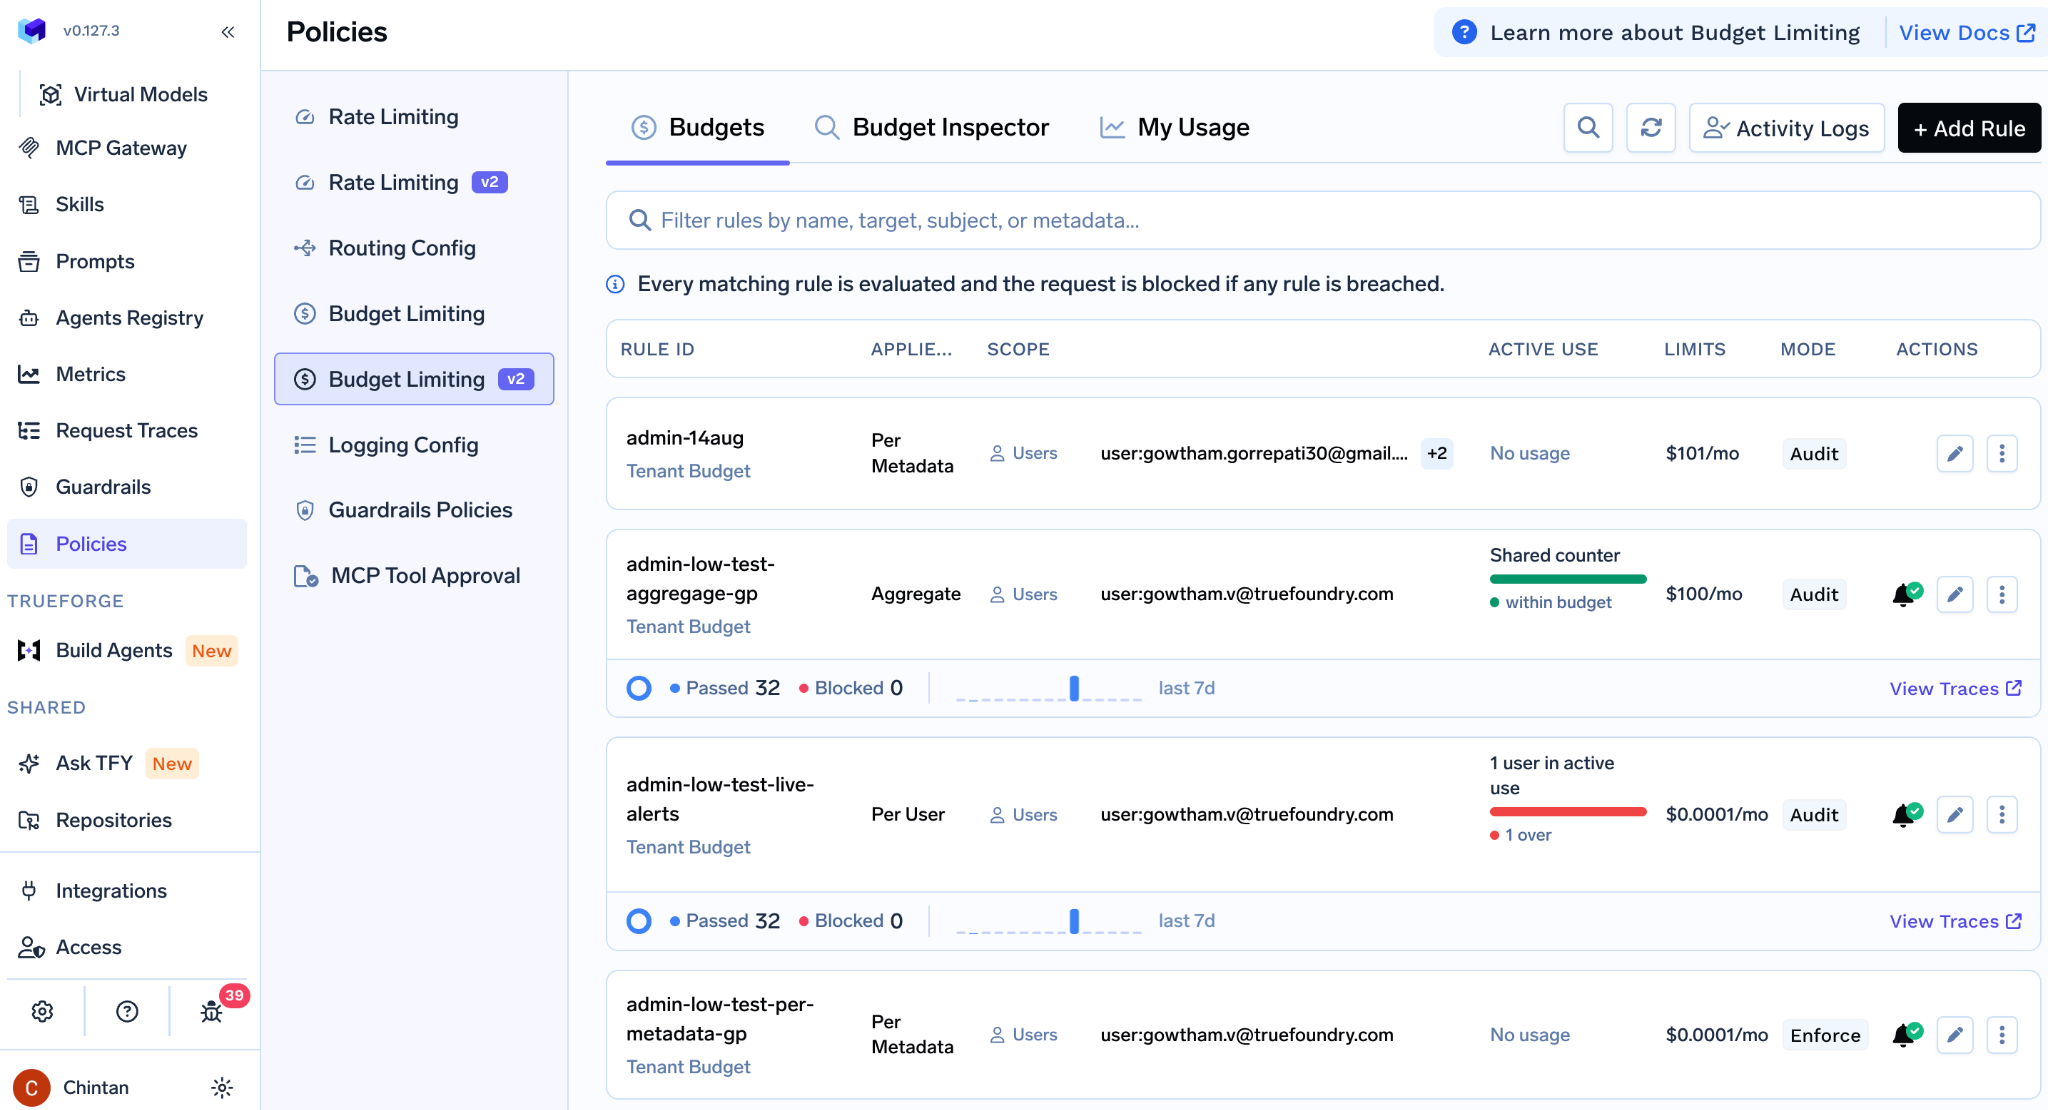
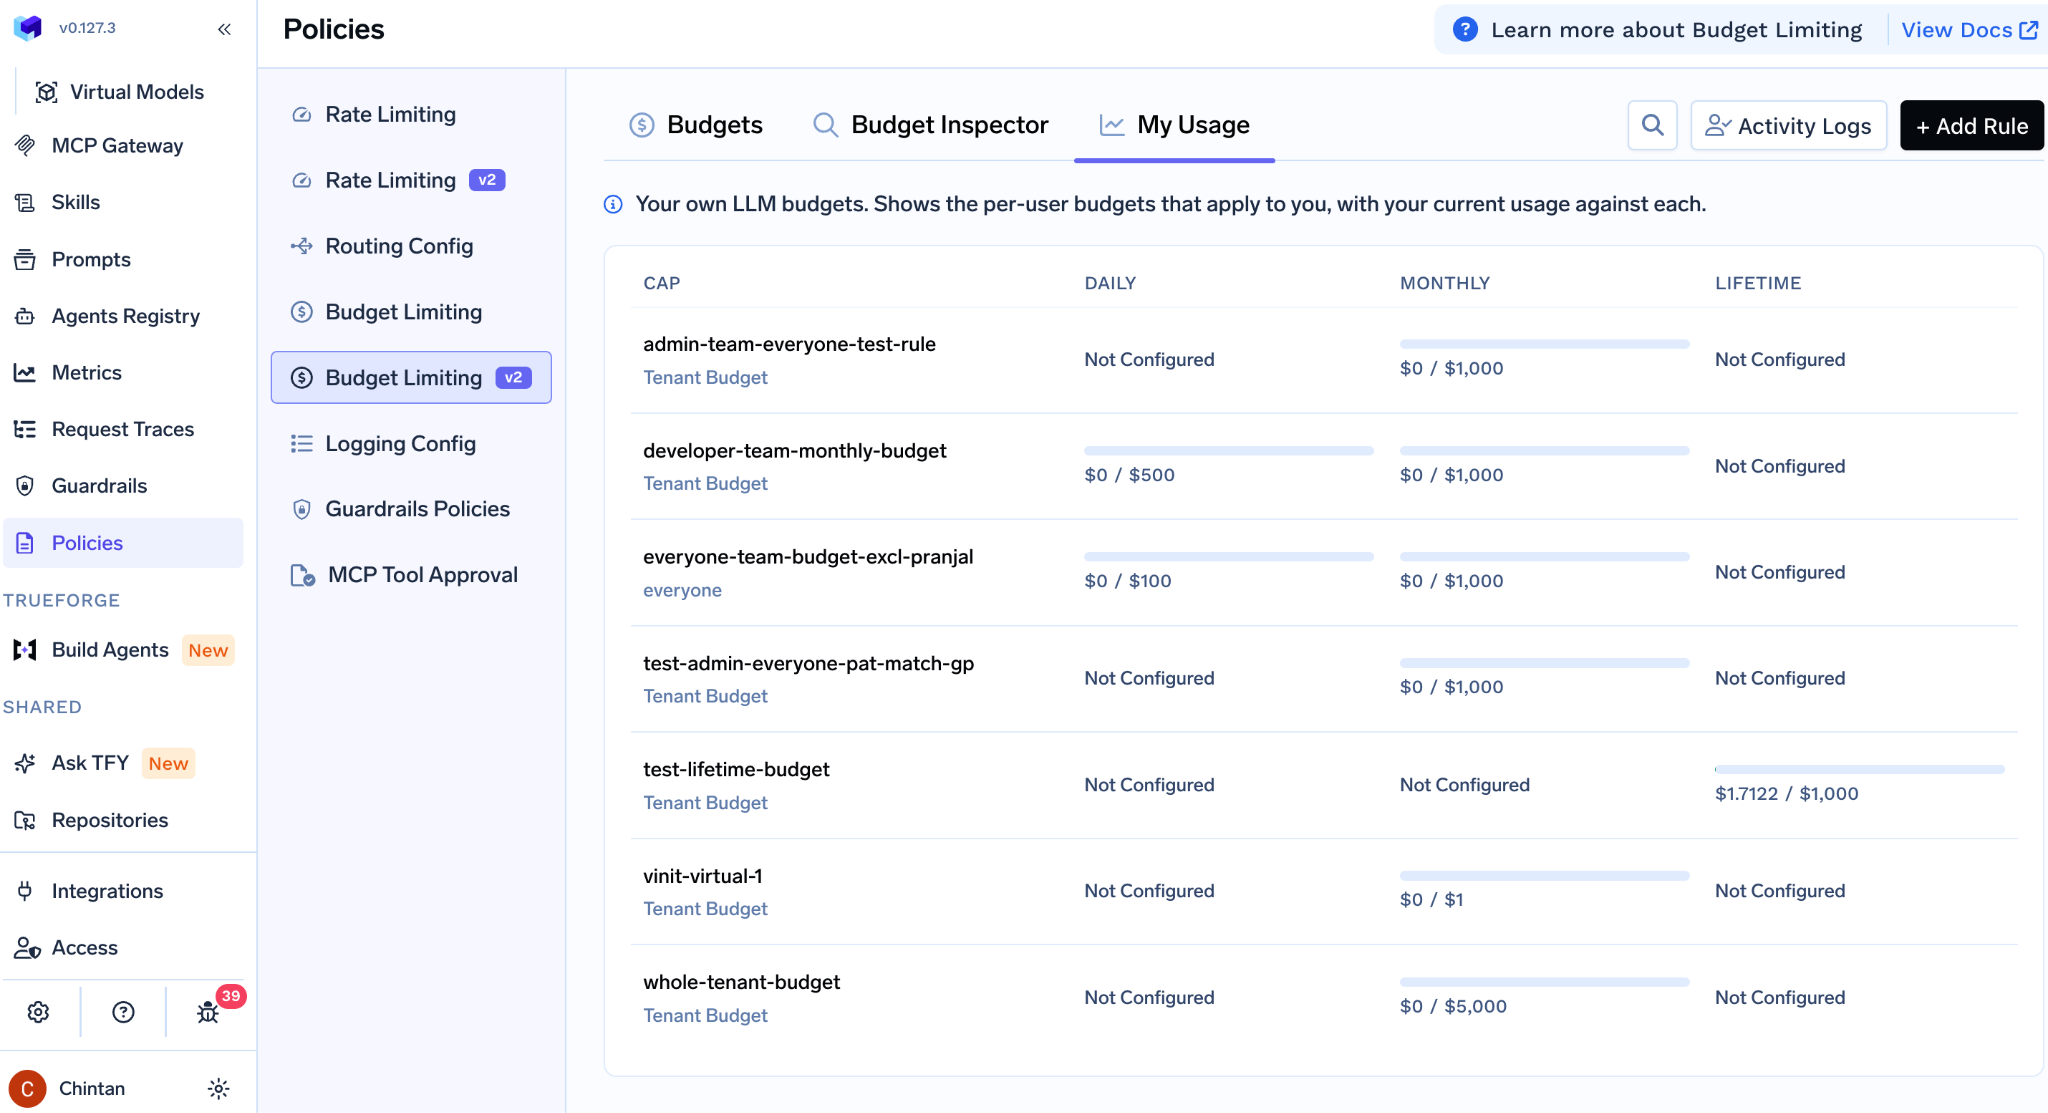
A diferença prática: no TrueFoundry, uma equipe é alertada aos 75% e pode continuar trabalhando após os 100% se a regra for apenas de alerta; no OpenRouter, a equipe descobre quando as requisições começam a retornar 403.
Duas coisas diferentes são chamadas de cache aqui, e confundi-las é o erro mais comum que vemos nas revisões de custo.
O prompt caching do provedor ocorre quando o provedor do modelo cobra menos por tokens de entrada em cache. O OpenRouter repassa isso e faz o roteamento considerando essa vantagem: uma leitura de cache custa cerca de 0,1x a 0,5x do preço normal de entrada, dependendo do provedor, e o session_id mantém a sessão fixa no provedor que possui o cache quente. O TrueFoundry também repassa o prompt caching do provedor, e nossa documentação enquadra explicitamente a combinação dele com o cache do gateway (caching). Nenhum dos fornecedores inventou isso; ambos permitem que você aproveite esse recurso.
O cache de resposta do gateway ocorre quando o próprio gateway responde à requisição, sem nenhuma chamada ao provedor. O Response Caching do OpenRouter, atualmente em beta, é de correspondência exata: duas requisições são idênticas apenas quando compartilham a mesma chave de API, modelo, tipo de endpoint, modo de streaming e corpo completo da requisição. O recurso é opt-in por requisição através do cabeçalho X-OpenRouter-Cache: true, agnóstico ao modelo, cobre chamadas de chat, Responses, Messages e embeddings, mas não inclui chamadas legadas de completude, TTS, STT, rerank ou vídeo, e, ao atingir o cache, retorna a resposta sem cobrança e sem consumo de tokens. Duas propriedades merecem crédito: os acertos de cache não contam para os rate limits do provedor e são visíveis no log de Atividade. Uma propriedade o limita: o cache do OpenRouter é restrito a uma única chave de API, de modo que chaves diferentes sob a mesma conta não o compartilham, e uma frota de serviços, onde cada um possui sua própria chave, não se beneficia do tráfego dos outros. Cache semântico não é oferecido. Em nossos próprios testes, medimos uma taxa de acerto de 100% em re-requisições idênticas, 58,5 ms em um acerto contra 2.866,8 ms em uma falha de cache, e um tempo de vida (TTL) entre dois e cinco minutos.
O TrueFoundry oferece cache de correspondência exata e semântico no gateway, com suporte do Redis. Um acerto retorna a resposta completa com zero chamadas e zero custo do provedor, em todos os provedores, e o cache é compartilhado entre todos os chamadores em vez de ser isolado por chave, de modo que a segunda equipe a fazer uma pergunta se beneficia da primeira. Uma estratégia de LLM com cache semântico é fundamental para cargas de trabalho onde a correspondência exata nunca é atingida: assistentes de suporte ao cliente, busca interna e qualquer template de prompt com um campo variável. Não publicamos taxas de acerto medidas porque elas dependem inteiramente do seu tráfego; o teste correto é usar uma semana dos seus próprios prompts.
Sem diretivas de roteamento configuradas, o OpenRouter já otimiza o preço em três etapas: desprioriza provedores que apresentaram quedas significativas nos últimos 30 segundos, escolhe entre os estáveis a partir dos candidatos de menor custo ponderados pelo inverso do quadrado do preço, e mantém o restante como alternativa de contingência (fallback). Direcionamentos explícitos podem ser adicionados: provider.sort: "price" ou o atalho de modelo :floor roteia priorizando o mais barato, :nitro roteia focando em vazão, provider.max_price define um teto estrito em dólares por milhão de tokens que se combina com a ordenação, e as preferências de provider.only, ignore e quantização restrigem o conjunto de candidatos. A tabela de preços não fica desatualizada porque o OpenRouter é o próprio vendedor: sua lista de preços é o preço real. Duas limitações honestas: isso é uma arbitragem de provedores para um determinado modelo, não uma substituição de modelo, e o roteamento ordenado por preço pode comprometer a consistência da qualidade, já que provedores mais baratos podem servir diferentes quantizações do mesmo modelo.
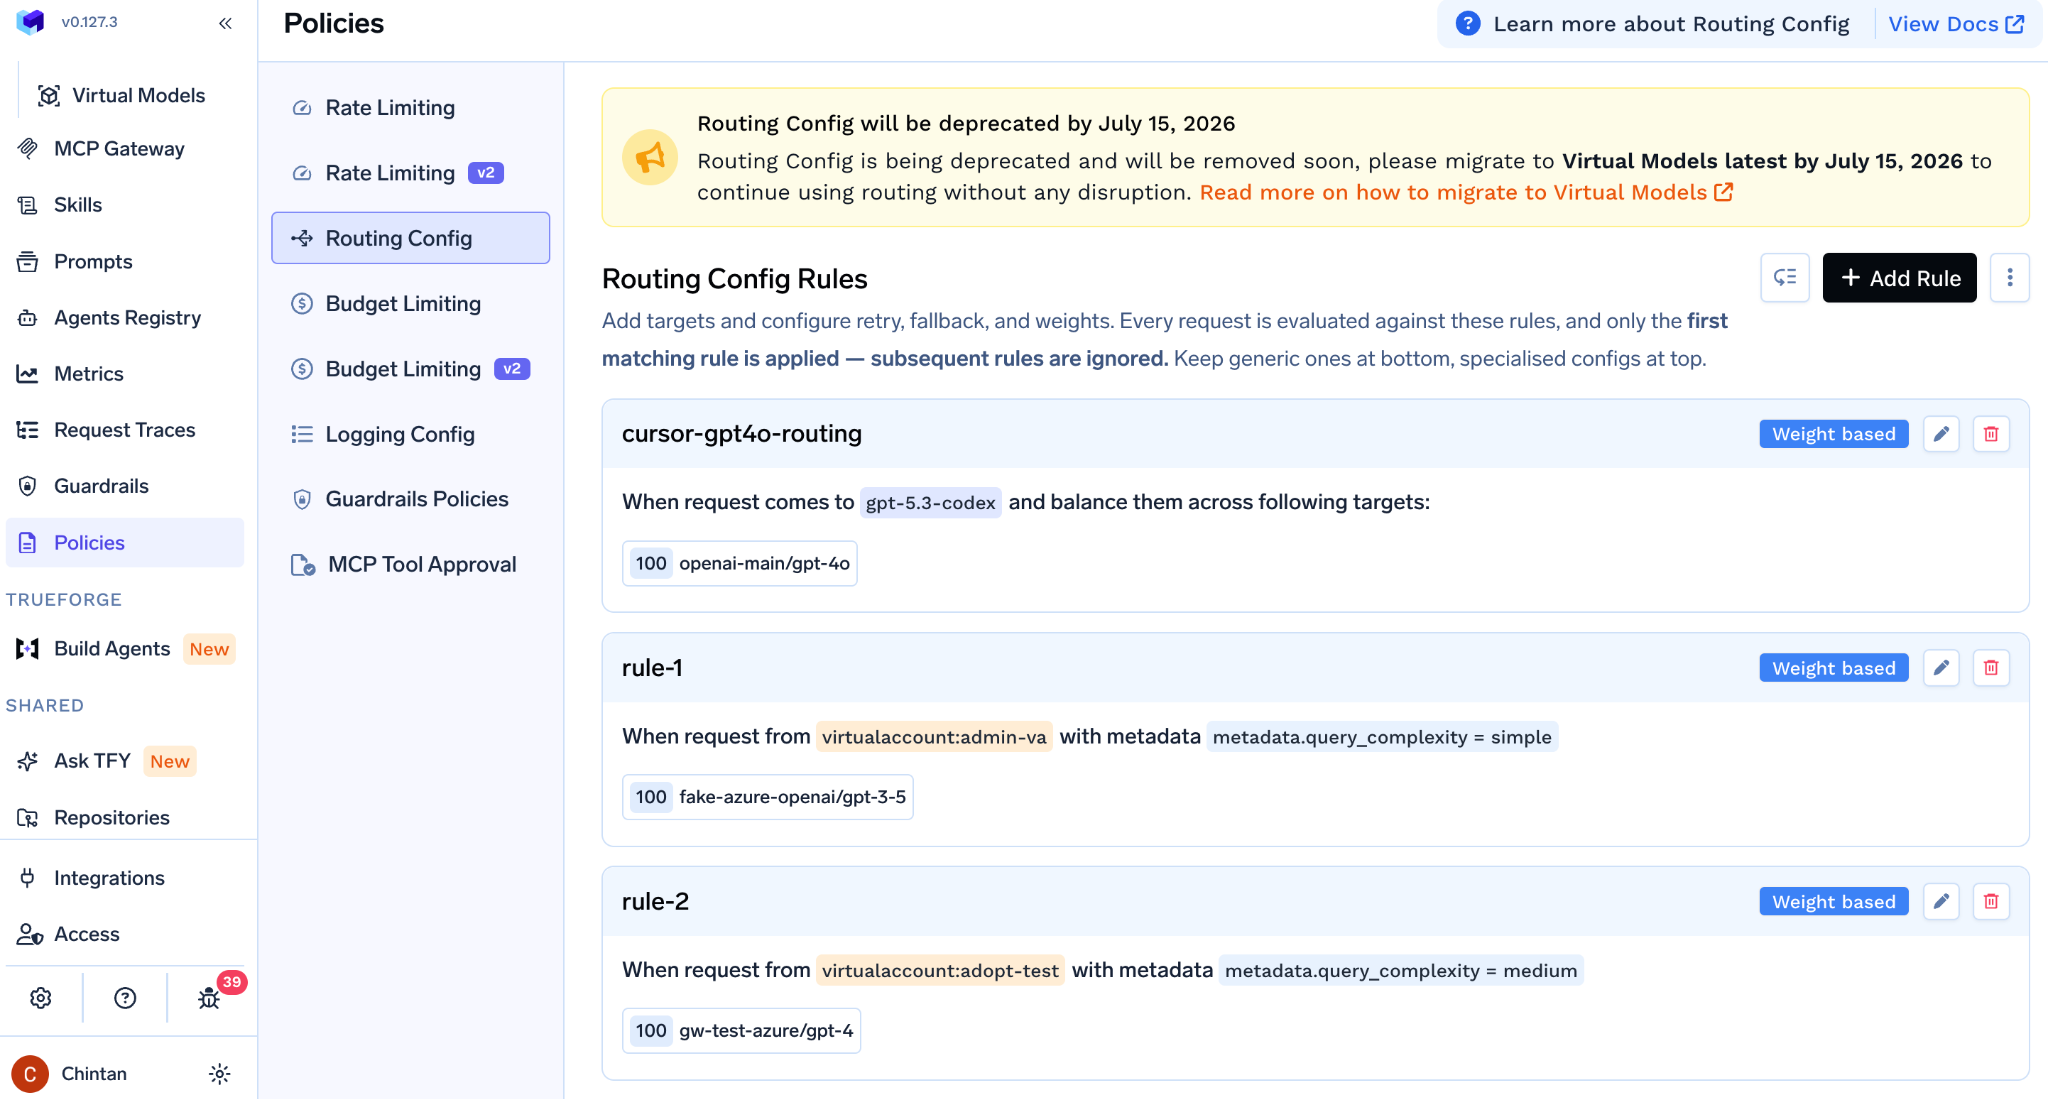
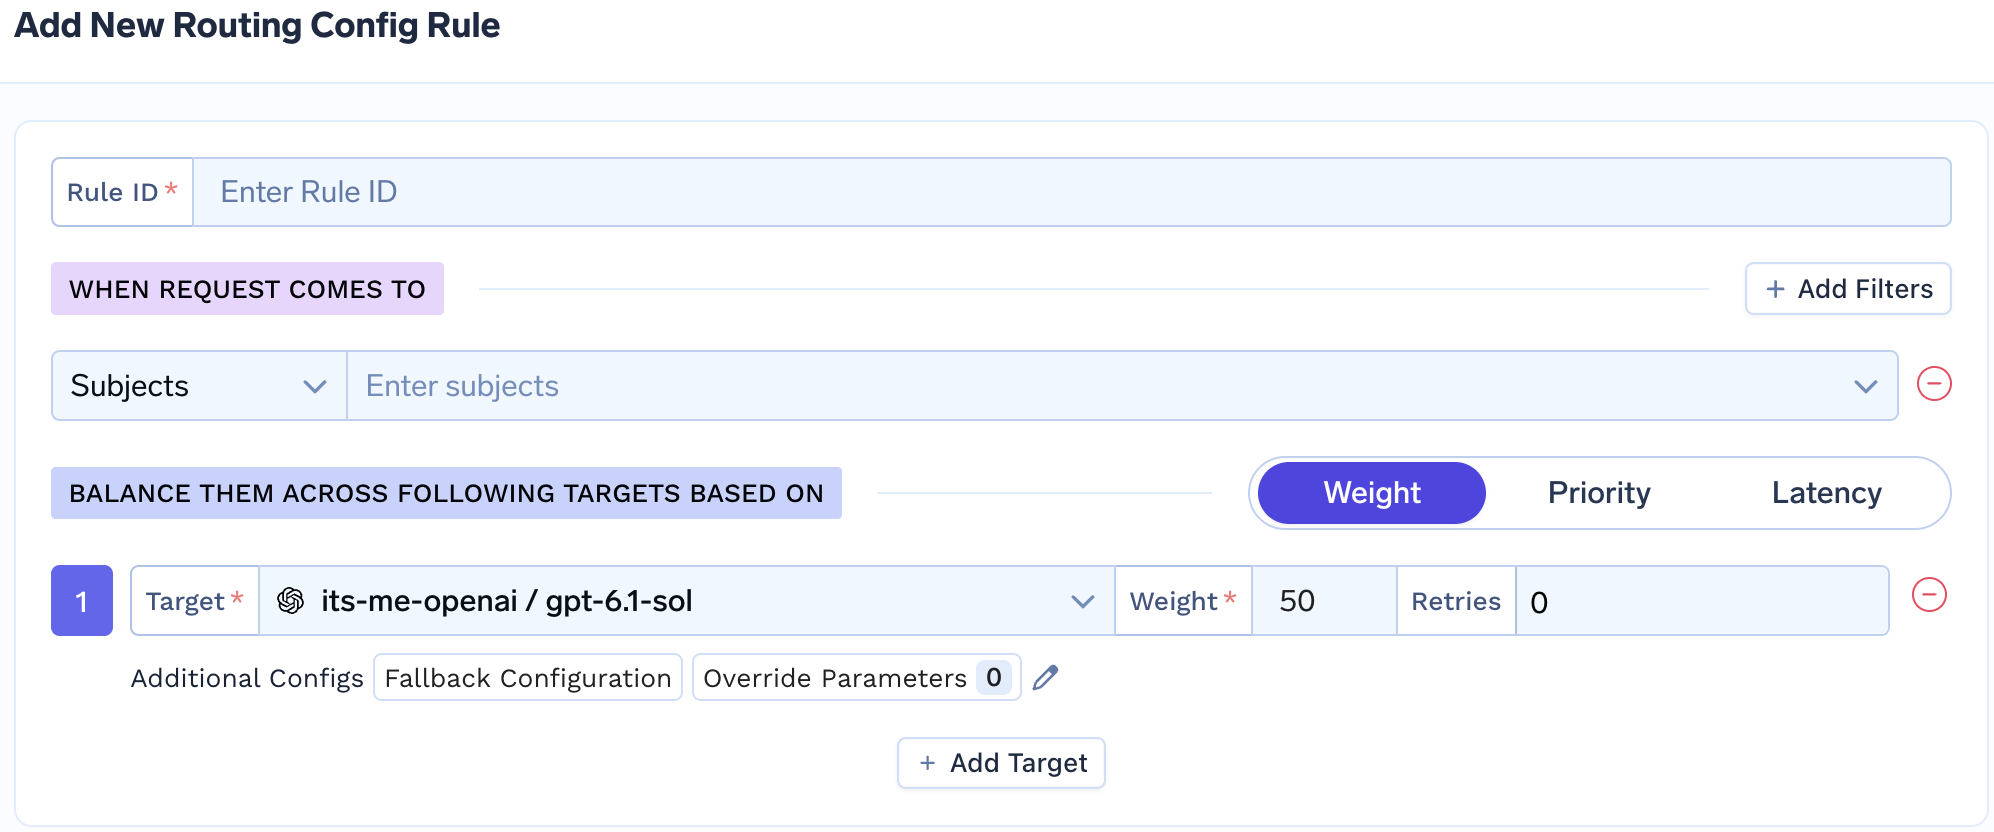
O TrueFoundry não faz arbitragem de provedores baseada em tabela de preços. O que fazemos é o roteamento baseado em complexidade: o gateway classifica cada requisição como simples, média ou complexa e a roteia para o modelo que você configurou para esse nível, com sessões fixas, de modo que você escolhe o modelo barato por nível e o gateway escolhe o nível (auto routing). Além disso, oferecemos balanceamento de carga baseado em peso, latência e prioridade entre os destinos, e uma cadeia de contingência de modelos virtuais que ignora qualquer destino cujo orçamento tenha sido excedido, funcionando como um disjuntor de custos. Os dados de preço vêm de um catálogo de código aberto somado a tarifas privadas para contratos negociados e modelos personalizados (cost tracking). Portanto, a explicação transparente vale para os dois lados: modelo aceitável mais barato, sim; provedor mais barato para este modelo específico, não. Como essas duas abordagens se encaixam em uma arquitetura de roteamento é algo explicado em nosso guia sobre roteador de LLM.
Governar os gastos começa por saber quem os realizou. O TrueFoundry atribui custos e tokens por usuário, equipe, conta virtual, modelo, conta do provedor e chaves de metadados arbitrárias; o cabeçalho X-TFY-METADATA é o mecanismo para chargeback, portanto, uma requisição etiquetada com um centro de custo ou ID de aplicação é relatada com essa identificação, painéis detalham os gastos em cada uma dessas dimensões, e as APIs de orçamento exibem o uso e uma lista dos maiores gastadores (cost tracking, budgets API). A mesma camada de gateway que impõe essas regras em memória mantém a sobrecarga em cerca de 3 a 4 ms e mais de 350 requisições por segundo por vCPU em mais de 1.000 LLMs, portanto a atribuição não é algo que você paga em perda de latência. Para a perspectiva voltada à equipe financeira, consulte nosso guia sobre solução de rastreamento de custos de LLM.
O OpenRouter faz a atribuição por chave (com rótulos descritivos), workspace, modelo e provedor; Atividade e Logs oferecem uma visão no nível da conta com filtragem opcional por workspace, a resposta via usage: {include: true} retorna o uso por requisição no próprio corpo, a Exportação de Atividade gera arquivos CSV ou PDF agrupados por modelo, chave ou membro, e um recurso de Rastreamento de Usuários aliado a Classificadores Personalizados adiciona dimensões por usuário e por categoria. O faturamento é emitido em uma única fatura unificada para todos os workspaces. A atribuição por aplicação ou por centro de custo é viável, seja nativamente via IDs de usuário personalizados e classificadores ou posteriormente via envio de metadados em Broadcast para sua plataforma de observabilidade.
Essa é a estrutura de otimização de custos de LLM em cada lado. Se o objetivo for reduzir custos de API de LLM para uma única aplicação, o roteamento do OpenRouter faz a parte mais pesada de forma automática. Se o objetivo for reduzidos para toda a organização, você precisa saber qual equipe está gastando, alertá-la antes que seja bloqueada e rotear as requisições simples para o modelo mais barato, que é a proposta do TrueFoundry.
As capacidades do TrueFoundry são baseadas em nossa documentação; as capacidades do OpenRouter refletem suas funcionalidades publicamente documentadas no momento da redação.
Nenhum dos fornecedores documenta previsão de gastos ou detecção automática de anomalias; o TrueFoundry lista alertas de anomalia como "em breve" no seu roadmap de governança de agentes, e o OpenRouter possui um recurso de Notificações cujos tipos de alerta não estão documentados. Planeje o uso de uma ferramenta de FinOps para qualquer um dos lados e consulte nosso guia de alternativas ao OpenRouter para conhecer o mercado em geral.
Os rate limits, orçamentos e caching do OpenRouter foram projetados para o desenvolvedor que gerencia uma única chave: limites que acompanham o saldo, orçamentos que interrompem o serviço em vez de avisar, um cache associado à chave e, em troca, a melhor arbitragem automática de provedores do mercado. Os controles de custo do TrueFoundry foram projetados para a equipe de plataforma que presta contas ao setor financeiro: limites por requisições e tokens, orçamentos que alertam antes de bloquear e se dividem por equipes, modelos e aplicações, cache semântico compartilhado entre todos os chamadores e chargeback nativo por centro de custo. Nenhum dos dois faz previsão ou detecção de anomalias, portanto planeje essa parte separadamente. A linha divisória prática é definir se a pessoa que analisa o relatório de orçamento é um desenvolvedor ou um parceiro da área financeira.
Para ver orçamentos, limites e caching configurados para uma implantação multiequipe, explore o TrueFoundry AI Gateway ou agende uma demonstração se estiver dimensionando os controles de custo para o seu ambiente de produção agora.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada


