



October 10, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Published: October 10, 2026
Blazingly fast way to build, track and deploy your models!
Gateways estão se tornando o plano de controle operacional dos sistemas GenAI. Eles unificam o tráfego para APIs de terceiros (OpenAI, Anthropic, Mistral, Bedrock) e modelos auto-hospedados, aplicam políticas e expõem um painel único para latência, erros, consumo de tokens e gastos. Esse mesmo ponto de gargalo é o local ideal para capturar rastreamentos, calcular análises em nível de modelo e de usuário, e acionar guardrails e alertas — sem adicionar latência ao caminho da requisição.
Organizações reais aprenderam isso da maneira mais difícil. Considere um copiloto de suporte atendendo a milhares de agentes. Uma tarde, uma atualização inócua de prompt aumenta o comprimento da saída em ~40%. A satisfação dos agentes cai à medida que as respostas atrasam; o financeiro percebe a conta. Com a observabilidade do gateway, você veria a latência p95 e os tokens de saída aumentando para a rota afetada, correlacionaria isso à implantação ou versão do prompt e reverteria — idealmente com um alerta automatizado configurado para detectá-lo na próxima vez.
Esta publicação recapitula o que é um AI Gateway, por que a observabilidade é crítica e as métricas concretas, painéis e fluxos de trabalho que as equipes devem implementar. Também mostraremos como o AI Gateway da TrueFoundry entrega a pilha de observabilidade pronta para uso: análises unificadas (latência, TTFT/ITL, erros), rastreamento de custos granular, detalhamentos em nível de cliente/usuário, visibilidade de roteamento saudável/falho e coleta escalável e de baixa sobrecarga integrada à arquitetura.
Um AI Gateway é uma camada fina e de alto desempenho que atua como proxy para requisições de aplicativos para um ou mais provedores de LLM ou modelos auto-hospedados. Ele unifica APIs, centraliza a autenticação e RBAC (Role Based Access Control) , aplica limites de taxa e guardrails, realiza balanceamento de carga e failover, e captura dados de observabilidade e custo para cada requisição. Pense nele como a camada de “ingress + política + telemetria” para GenAI.
Operacionalmente, gateways modernos suportam roteamento ponderado e baseado em latência, verificações de saúde e failovers automáticos quando um modelo ou região está com problemas — para que as requisições continuem mesmo durante interrupções do provedor. Como cada requisição passa pelo gateway, as equipes podem comparar provedores por latência e custo, tornando OpenRouter vs AI gateway uma avaliação prática ao decidir como gerenciar roteamento, observabilidade e controle em escala.
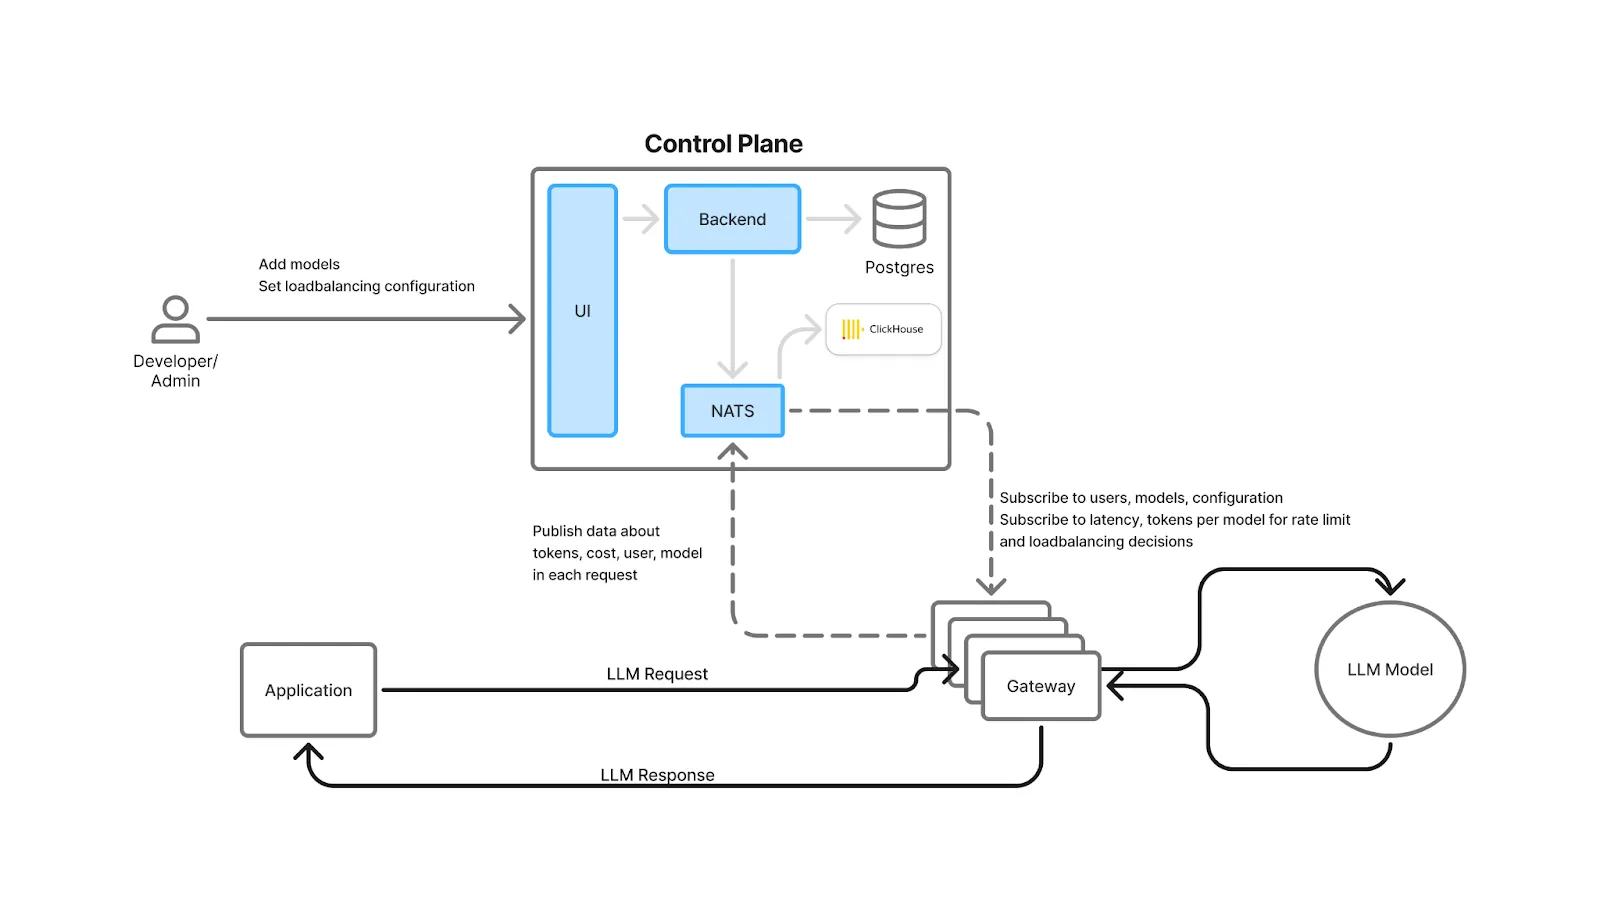
Da TrueFoundry a arquitetura é projetada para que esses controles e métricas adicionem sobrecarga mínima: verificações de autenticação, limitação de taxa, e o balanceamento de carga são feitos em memória; logs/métricas são gravados assincronamente em uma fila; e o caminho da requisição evita chamadas externas (a menos que você opte por cache). O gateway é escalável horizontalmente e limitado pela CPU, mantendo a sobrecarga de latência de ponta a ponta em milissegundos de um dígito.
A latência de LLM é multimodal: há o tempo para o primeiro token (TTFT), latência inter-token (ITL) para streaming, e latência total da requisição. Cada um afeta a UX percebida de forma diferente. Gateways que monitoram os três ajudam a diagnosticar se as lentidões vêm de filas de provedores, computação de modelo, rede ou comprimento do prompt — e a escolher a melhor estratégia de roteamento.
Tokens são os novos ciclos de CPU. Um único prompt pode se desdobrar em várias ferramentas ou etapas de recuperação, e os custos se acumulam entre os provedores. A observabilidade deve atribuir os gastos por modelo, provedor, ambiente, aplicação, locatário e usuário e manter-se atualizada com os preços públicos dos provedores para evitar planilhas manuais.
Aplicativos em produção precisam de salvaguardas contra interrupções de provedores, throttling e regressões de modelo. A observabilidade ligada a verificações de saúde, detalhamento de códigos 4xx/5xx, taxas de nova tentativa/fallback e utilização de limite de taxa permite que você imponha SLOs e faça failover automaticamente quando o desempenho se deteriorar.
Empresas precisam de rastros completos de requisição/resposta com controles de acesso e políticas de moderação de PII/conteúdo. Um gateway centraliza essa aplicação e registro para que as equipes possam provar quem chamou qual modelo, com quais dados e o que ele retornou — sem compartilhar amplamente as chaves de API do provedor.
A qualidade, preços e cotas dos modelos mudam frequentemente. Organizações que instrumentam gateways podem comparar provedores diretamente e redirecionar o tráfego com base em dados atualizados de latência/custo/erro — mantendo o desempenho e as margens à medida que o mercado evolui.
Orientações externas ecoam essas necessidades: líderes da indústria enfatizam a observabilidade de IA para resposta rápida a desvios, interrupções e picos de custo; OpenAI e Azure recomendam registro estruturado e backoff exponencial para limites de taxa, o que um gateway pode padronizar entre aplicativos.
Abaixo estão as capacidades que você deve esperar de um Gateway de IA de nível de produção — e que a TrueFoundry oferece nativamente.
Key Metrics for Evaluating Gateway
| Criteria | What should you evaluate ? | Priority | TrueFoundry |
|---|---|---|---|
| Latency | Adds <10ms p95 overhead for time-to-first-token? | Must Have | ✅ Supported |
| Data Residency | Keeps logs within your region (EU/US)? | Depends on use case | ✅ Supported |
| Latency-Based Routing | Automatically reroutes based on real-time latency/failures? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
Veja como a TrueFoundry integra a observabilidade no caminho principal da requisição e entrega uma pilha de análise completa pronta para uso — sem desacelerar o tráfego de produção.

O painel de Análises exibe: Latência da Requisição (p50/p95/p99), Tempo para o Primeiro Token (TTFT/TTFS), Latência Inter-Token (ITL), custo por modelo/provedor, tokens de entrada/saída, códigos de erro e atividade da política (limite de taxa, balanceamento de carga, fallbacks, guardrails, orçamentos). As visualizações podem ser segmentadas por modelo, usuário, equipe, ruleId e metadados personalizados; você também pode baixar CSVs brutos.
Ative o Custo Público para preencher automaticamente o preço por token a partir das taxas publicadas pelos provedores (OpenAI, Anthropic, Bedrock, etc.). Para modelos negociados ou ajustados, defina o Custo Privado com preços personalizados de tokens de entrada/saída. Ambos são incorporados às análises de custo por requisição e agregadas.
Anexe contexto de negócio (cliente, funcionalidade, ambiente) e analise tokens, latência e gastos por qualquer dimensão — ideal para rateio de custos, detecção de vizinhos barulhentos e priorização de otimizações.

Defina cotas por tokens ou requisições por minuto/hora/dia, com escopo para usuários, modelos ou segmentos identificados via metadados. Os painéis mostram a utilização e os estrangulamentos para que você possa dimensionar corretamente os limites e proteger a capacidade compartilhada.
Use divisões baseadas em peso para experimentos ou roteamento baseado em latência para o estado estável. Verificações de saúde marcam backends como não saudáveis em limites de erro/latência e os excluem automaticamente. Cadeias de fallback tentam novamente em caso de falha, com spans e métricas que mostram qual caminho foi seguido e seu impacto na latência/custo.
Centralize chaves de provedor, emita tokens de acesso com escopo, aplique RBAC e retenha logs imutáveis de requisição/resposta para conformidade — em LLMs e servidores MCP
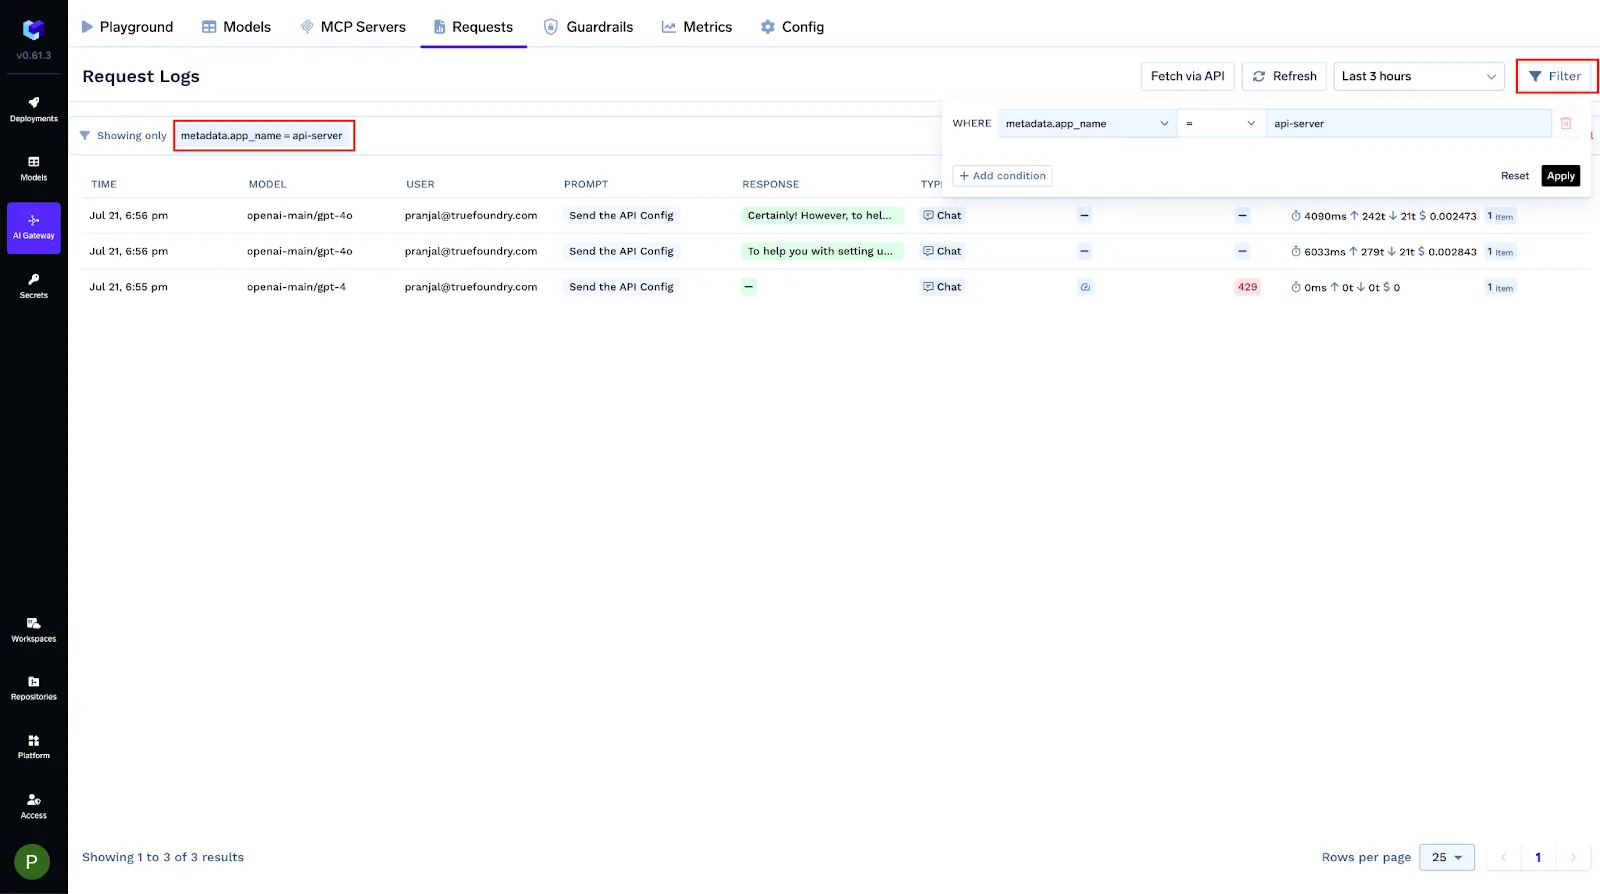
Você pode marcar cada requisição com metadados estruturados através do X-TFY-METADATA cabeçalho. As chaves registradas tornam-se filtros consultáveis, rótulos do Grafana e condições em configurações de gateway (limites de taxa, balanceamento de carga, fallbacks, guardrails). Os valores são strings (≤128 caracteres).
X-TFY-METADATA: {"tfy_log_request":"true","environment":"staging","feature":"countdown-bot","customer_id":"acme-42"}


Use this to isolate logs, group cost/latency by tenant or feature, and roll out policy changes safely to a subset of traffic.

Example — rate‑limit by metadata

name: ratelimiting-config
type: gateway-rate-limiting-config
rules:
  - id: openai-gpt4-dev-env
    when:
      models: ["openai-main/gpt4"]
      metadata:
        env: dev
    limit_to: 1000
    unit: requests_per_day
O mesmo padrão de metadados aplica-se a regras de balanceamento de carga e fallback
O gateway é compatível com OpenTelemetry. Ative a exportação OTLP e envie rastreamentos para qualquer backend (Tempo, Jaeger, Datadog/New Relic via Collector, TrueFoundry Tracing). Os spans incluem atributos genai — modelo, tokens, TTFT, ITL, parâmetros, chamadas de ferramenta, erros — e spans detalhados para limitação de taxa, balanceamento de carga, fallbacks e chamadas de servidor/ferramenta MCP, permitindo correlacionar o comportamento do provedor com spans de nível de aplicativo.
Habilitar rastreamento
ENABLE_OTEL_TRACING="true"
OTEL_SERVICE_NAME=<your_service>
OTEL_EXPORTER_OTLP_TRACES_ENDPOINT="https://<otel-collector>/v1/traces"
OTEL_EXPORTER_OTLP_TRACES_HEADERS="Authorization=Bearer <token>"
Spans representativos

Expose /metrics for Prometheus or push OTEL metrics by setting:

ENABLE_OTEL_METRICS="true"
OTEL_EXPORTER_OTLP_METRICS_ENDPOINT="https://<otlp-endpoint>/v1/metrics"
OTEL_EXPORTER_OTLP_METRICS_HEADERS="Authorization=Bearer <token>"
LLM_GATEWAY_METADATA_LOGGING_KEYS='["customer_id","request_type"]'

Metadata keys listed in LLM_GATEWAY_METADATA_LOGGING_KEYS become Prometheus labels llm_gateway_metadata_<key>, enabling per‑customer/per‑feature cost and latency charts. (Truefoundry Docs)
As chaves de metadados listadas em LLM_GATEWAY_METADATA_LOGGING_KEYS tornam-se rótulos Prometheus llm_gateway_metadata_<key>, permitindo gráficos de custo e latência por cliente/por recurso. (Documentação Truefoundry)
Famílias de métricas chave (subconjunto)
Tokens & cost: llm_gateway_input_tokens, llm_gateway_output_tokens, llm_gateway_request_cost.
Latency: llm_gateway_request_processing_ms, llm_gateway_first_token_latency_ms, llm_gateway_inter_token_latency_ms.
Errors: llm_gateway_request_model_inference_failure, llm_gateway_config_parsing_failures.
Policy activity: llm_gateway_rate_limit_requests_total, llm_gateway_load_balanced_requests_total, llm_gateway_fallback_requests_total, llm_gateway_budget_requests_total, llm_gateway_guardrails_requests_total.
Agent/MCP: llm_gateway_agent_request_duration_ms, llm_gateway_agent_llm_latency_ms, llm_gateway_agent_tool_latency_ms, llm_gateway_agent_tool_calls_total, llm_gateway_agent_mcp_connect_latency_ms, llm_gateway_agent_request_iteration_limit_reached_total.
A JSON de dashboard do Grafana pré-construído é publicado pela TrueFoundry, organizado em Modelo, Usuário, Configuração, e Invocação de MCP . Adicione variáveis para seus metadados personalizados, por exemplo:
label_values(llm_gateway_input_tokens, llm_gateway_metadata_customer_id)
O Protocolo de Contexto de Modelo (MCP) da Anthropic — anunciado em 25 de novembro de 2024 — padroniza a forma como os assistentes se conectam a ferramentas, prompts e recursos. O ecossistema acelerou ao longo de 2025 com muitos servidores pré-construídos (GitHub, Slack, Google Maps, Puppeteer, etc.).
A TrueFoundry integra o MCP nativamente:
Isso torna o gateway o plano de controle operacional para cargas de trabalho de agentes — unificando política, autenticação, roteamento e visibilidade de ponta a ponta tanto em chamadas LLM quanto em execuções de ferramentas.
Abaixo está uma lista de verificação prática. Cada métrica inclui o que ela informa, como usá-la e como a TrueFoundry a apresenta.
Uma alteração no prompt aumenta a verbosidade da saída para clientes empresariais. Sintomas: aumento de tokens de saída, maior latência p95 e gasto diário. Ação com TrueFoundry: A análise mostra um salto nos tokens de saída para o ambiente “support‑prod” e um aumento de custo para o modelo primário. Você compara um provedor alternativo que mostra TTFT mais baixo e tokens de saída mais baratos; você desvia 30% do tráfego via roteamento baseado em peso e define um alerta para “custo por conversa”.
Às 10:00 IST, as taxas de erro subiram para 429s. Ação com TrueFoundry: Os painéis de limite de taxa confirmam as limitações do upstream. As cadeias de fallback são ativadas, e o roteamento se desloca para um backend mais saudável. Você mantém a experiência do usuário estável e, posteriormente, ajusta as cotas de tokens e os parâmetros de backoff.
Os usuários relatam que “a resposta começa rápido, mas depois engasga”. Ação com TrueFoundry: O TTFT está bom, mas o ITL está elevado no modelo primário. O roteamento baseado em latência prefere automaticamente um provedor com melhor taxa de transferência de streaming; você também define um alerta para o ITL p95.
O trabalho em lote de um cliente monopoliza tokens e desacelera todos os outros. Ação com TrueFoundry: Limites de taxa baseados em tokens por cliente asseguram a partilha equitativa e protegem os SLOs; análises verificam a utilização e as contagens de rejeição para que possa oferecer quotas maiores.
As aplicações LLM são sistemas dinâmicos. Os modelos evoluem, os provedores alteram cotas e preços, os prompts se transformam e o comportamento do usuário surpreende. O melhor gateway de IA é onde você pode observar, controlar e otimizar tudo isso — se você coletar os sinais certos e transformá-los em ações.
O AI Gateway da TrueFoundry oferece esse centro de comando operacional. Ele captura latência (TTFT/ITL), tokens, custo e erros com baixa sobrecarga; aplica limites de taxa cientes de tokens, RBAC e guardrails; e fornece visibilidade de roteamento, saúde e fallback para que você possa manter as experiências rápidas, confiáveis e econômicas. Com análises granulares de clientes/usuários e atribuição de custos automatizada e atualizada, as equipes podem passar do combate reativo de problemas para a otimização proativa.
Se você está centralizando sua pilha GenAI — ou desembaraçando uma proliferação de integrações pontuais — comece roteando o tráfego pelo gateway, ative os painéis acima e configure alguns alertas alinhados com SLOs. Você obterá a visibilidade para entregar mais rápido, conter custos e manter seus agentes e usuários satisfeitos.
A observabilidade em um gateway de IA ajuda a rastrear raciocínios complexos de várias etapas e invocações de ferramentas que, de outra forma, seriam opacos. O monitoramento dos caminhos de execução do agente ajuda a detectar loops infinitos, alucinações e uso ineficiente de ferramentas em tempo real. Essa visibilidade garante que os agentes autônomos permaneçam confiáveis, previsíveis e dentro do orçamento ao interagir com diversos sistemas e APIs externos.
A observabilidade do gateway de IA otimiza o desempenho de LLMs fornecendo rastreamento em tempo real de latência, throughput e taxas de erro em diferentes provedores de modelos. Ao capturar métricas granulares como Tempo para o Primeiro Token (TTFT) e Latência Inter-Token (ITL), as equipes podem identificar gargalos específicos na cadeia de inferência. Esses insights permitem que os desenvolvedores comparem as velocidades dos modelos objetivamente e implementem roteamento inteligente para garantir um desempenho de alta velocidade para os usuários finais.
A observabilidade do gateway de IA reduz custos fornecendo visibilidade granular do consumo de tokens em modelos, equipes e usuários. O rastreamento de gastos por solicitação e espaço de trabalho permite que as equipes identifiquem prompts descontrolados ou fluxos de trabalho ineficientes imediatamente. Esses dados suportam estratégias automatizadas de economia de custos, como cache semântico, limitação de taxa ciente de tokens e roteamento de consultas para modelos mais acessíveis sem intervenção manual.
A observabilidade de gateways de IA apoia a auditoria de conformidade ao manter um log centralizado e imutável de cada requisição e resposta. Sistemas modernos registram trilhas de auditoria detalhadas, incluindo IDs de usuário, carimbos de data/hora e eventos de mascaramento de PII para proteger dados sensíveis. Esses logs garantem que as empresas atendam a padrões regulatórios como GDPR e SOC 2, fornecendo total transparência nas interações do modelo, frequentemente mantendo toda a telemetria dentro do ambiente de nuvem seguro da organização.
A TrueFoundry simplifica o gerenciamento da infraestrutura de IA unificando múltiplos provedores de modelos em um único plano de controle através da observabilidade em gateways de IA. A TrueFoundry correlaciona a telemetria em nível de requisição com a utilização de GPU e CPU para otimizar a alocação de recursos e reduzir o desperdício. Essa abordagem integrada permite que as equipes de plataforma gerenciem implantações, escalonamento e políticas de segurança em diversos ambientes, de forma nativa, dentro de suas contas AWS, GCP ou Azure.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada




















