



novembro 20, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: novembro 20, 2026

Blazingly fast way to build, track and deploy your models!
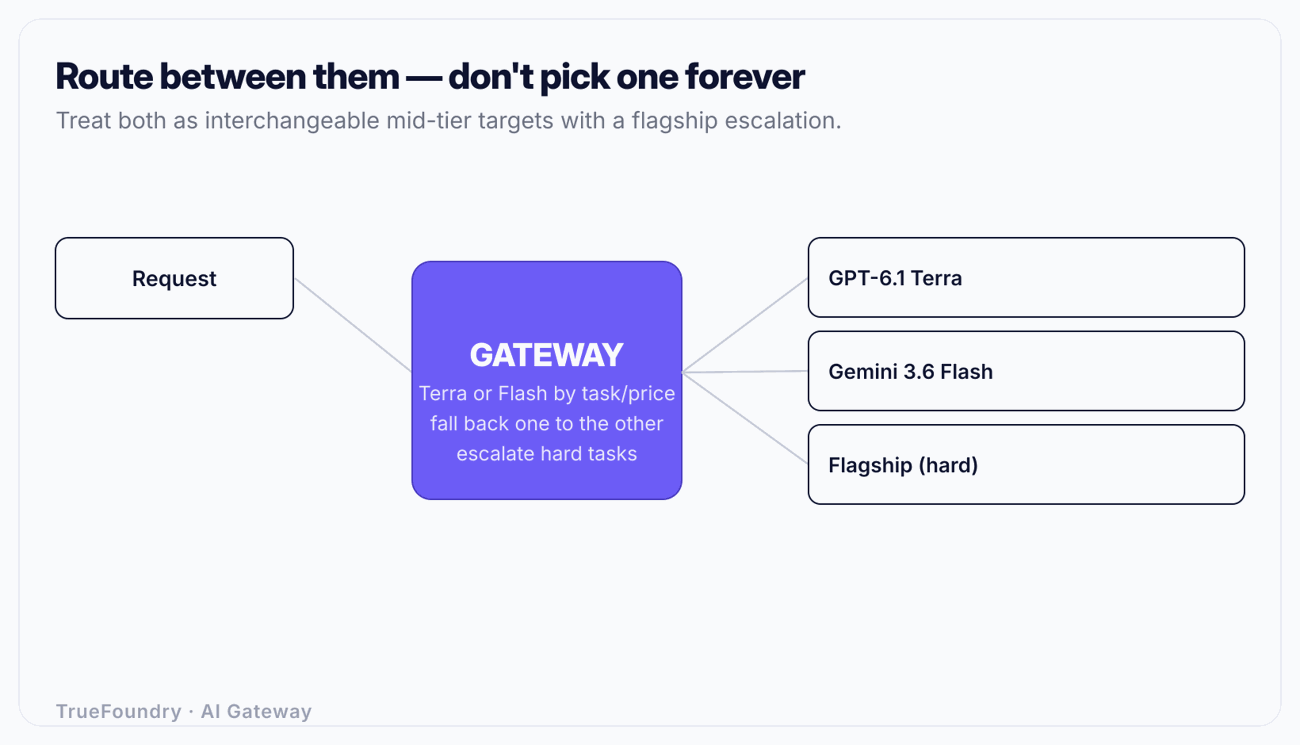
Comparações diretas de modelos costumam fazer a pergunta errada. "Terra ou Flash?" implica que você precisa se comprometer com um deles. No entanto, o GPT-6.1 Terra e o Gemini 3.6 Flash ocupam o mesmo degrau da escada: modelos intermediários, de grande contexto e fortes em código (embora não sejam flagships), com preços muito próximos. Quando dois modelos são tão parecidos e substituíveis, o erro caro é escolher um e codificá-lo de forma rígida (hard-coding). A estratégia barata e resiliente é rotear entre eles, usar cada um onde for melhor ou mais barato, e acionar o fallback para o outro quando um provedor passar por instabilidades.
Este artigo compara os dois nas dimensões que importam (preço, contexto, código e velocidade), com dados relatados e ponderados, para defender o ponto principal: trate-os como alvos intercambiáveis em uma política de roteamento, mantendo um modelo flagship acima deles para tarefas complexas.
Nota sobre precisão: com exceção dos dados do Claude usados como referência, todas as especificações abaixo vêm de relatórios de terceiros até novembro de 2026, e algumas fontes são conflitantes. Verifique as páginas oficiais da OpenAI e do Google antes de tomar decisões com base nesses números.
Quer rotear entre modelos intermediários por tarefa e preço, com fallback automático? Agende uma demonstração.
GPT-6.1 Terra foi relatado como lançado por volta de 26 de outubro de 2026, sendo o membro intermediário da linha GPT-6.1 da OpenAI. Perfil relatado: $1 por 1M de tokens de entrada, $5 por 1M de tokens de saída, janela de contexto de aproximadamente 1,05M e um Coding Index em torno de 48. Seu recurso de destaque é o preço: a $1 / $5 relatados, ele custa cerca da metade do custo por token do GPT-6.1 Sol ($2 / $10 relatados), mantendo uma grande parcela da capacidade de código do Sol.
Gemini 3.6 Flash foi relatado como lançado por volta de julho de 2026 como o modelo intermediário otimizado para velocidade do Google. Perfil relatado: $1,50 por 1M de tokens de entrada, $7,50 por 1M de tokens de saída, janela de contexto de 1M, throughput próximo a 280 tokens por segundo, um Intelligence Index perto de 50 e SWE-Bench Pro em torno de 58,7%. Seu recurso de destaque é a combinação de capacidade em código e velocidade a um preço intermediário.

Preços/benchmarks relatados até novembro de 2026; verifique a página oficial de preços de cada provedor antes de tomar decisões — as especificações dos modelos mudam frequentemente. As estatísticas do Claude, onde citadas, são os únicos números confirmados oficialmente.
Algumas ressalvas importantes sobre a leitura desta tabela:
A conclusão apontada pela tabela não é "o Terra vence" ou "o Flash vence". É que esses dois modelos são próximos o suficiente para serem substitutos, e substitutos são exatamente o tipo de recurso entre o qual você deve rotear.
Quando dois modelos são substituíveis, comprometer-se com apenas um não traz vantagens e custa duas coisas: você perde a capacidade de usar o modelo mais adequado para cada tarefa e assume o risco de dependência de um único provedor. O roteamento entre eles resolve ambos os problemas.
O preço menor relatado do Terra o torna a escolha padrão para tráfego focado em saída e sensível a custos: geração em lote, conversas longas e programação diária de alto volume. A vantagem relatada em código e velocidade do Flash o torna o destino preferido para requisições complexas de código ou caminhos sensíveis à latência onde ~280 tokens/seg fazem diferença. Você não precisa escolher de forma global; você escolhe por classe de tarefa. Isso é seleção de modelos consciente de custo e qualidade, e o mecanismo por trás disso é um LLM router.
Por serem substituíveis, cada um serve como fallback natural do outro. Configure o Terra como principal e o Flash como fallback (ou vice-versa) e qualquer erro de provedor, timeout ou rate limit em um deles será absorvido pelo outro. O usuário percebe apenas uma resposta ligeiramente mais lenta, em vez de uma falha. Este é o valor central do LLM fallback: dois modelos intermediários intercambiáveis oferecem redundância de provedor quase gratuitamente, pois você já utilizaria um deles de qualquer forma.
Nenhum dos dois é um flagship. Para tarefas de programação com agentes de longo alcance ou raciocínio complexo, ambos devem escalar para uma camada flagship (Claude Opus 5.5 é um padrão forte confirmado; GPT-6.1 Sol e Gemini 3.1 Pro são equivalentes relatados). A dupla intermediária lida com o volume principal; o modelo flagship resolve os casos complexos. O controle disso é feito por uma regra de roteamento.
Veja como a TrueFoundry trata modelos intercambiáveis em uma única política de roteamento. Agende uma demonstração.
Preços/benchmarks relatados até novembro de 2026; verifique a página oficial de preços de cada provedor antes de tomar decisões — as especificações dos modelos mudam frequentemente.
Observe que a maioria das linhas combina os dois modelos como principal e fallback, em vez de escolher um de forma exclusiva. Essa é a intenção do projeto: você não está escolhendo um vencedor, está atribuindo papéis que podem se alternar.
A política acima só é útil se for fácil de implementar e de alterar. Um AI gateway com uma API unificada e compatível com OpenAI oferece essa flexibilidade. Sua aplicação chama um alias estável; o gateway decide se a requisição vai para o Terra, para o Flash ou para um flagship, e o que fazer em caso de erro.
Como ambos os modelos usam aliases, o lançamento do GPT-6.2 ou Gemini 3.7, ou uma redução de preço em qualquer um deles, exige apenas uma edição de configuração. Sua política de roteamento se adapta sem alterar a aplicação.
Considere um produto de ferramentas para desenvolvedores que envia 4 milhões de requisições de código intermediárias por mês, com foco em saída: cerca de 600 tokens de entrada e 1.500 de saída por requisição (geração de código consome muitos tokens de saída).
A saída domina os custos aqui, portanto o preço de saída é o fator decisivo. No valor relatado do Terra de $5 / 1M de saída, 1.500 tokens de saída por requisição custam cerca de $0,0075. No valor relatado do Flash de $7,50 / 1M, a mesma requisição custa cerca de $0,01125 na saída — cerca de 50% a mais. Em 4 milhões de requisições, essa diferença é significativa.
No entanto, relata-se que o Flash programa um pouco melhor e roda mais rápido. Portanto, a política não deve ser "apenas Terra". O ideal é: rotear a maior parte da geração rotineira para o Terra para aproveitar o menor preço de saída, rotear as requisições de código mais complexas ou sensíveis à latência para o Flash, e configurar cada um como fallback do outro em caso de erro. Em seguida, acompanhe o custo e a qualidade por modelo na observabilidade e ajuste a divisão. Se a qualidade do Terra for suficiente para o seu tráfego, aumente o uso dele; se a capacidade do Flash reduzir o número de retentativas, a lógica muda. A única maneira de saber é medindo, razão pela qual o roteamento e a observabilidade devem funcionar como um único sistema.
As retentativas alteram esse cálculo de uma forma que as tabelas de preços não mostram. Se a saída do Terra for 33% mais barata, mas gerar uma resposta errada que exige uma segunda chamada 5% mais vezes do que o Flash, essa taxa de retentativa consome parte da vantagem de preço, pois uma requisição repetida paga o custo duas vezes. É por isso que uma comparação de preços simples pode ser enganosa e por que você deve medir o custo efetivo por resposta bem-sucedida, não o custo por chamada. Um modelo nominalmente mais barato, mas que exige mais retentativas, pode se tornar mais caro no tráfego real. A única forma de identificar isso é com observabilidade por modelo, rastreando o custo e a taxa de falhas nas suas próprias requisições.
Para evitar que o escalonamento para modelos superiores gere custos excessivos, limite a camada flagship com rate limit de tokens e orçamentos, garantindo que requisições fora do limite retornem HTTP 429 em vez de faturas inesperadas.
GPT-6.1 Terra e Gemini 3.6 Flash não disputam um duelo com um único vencedor. Eles são dois modelos intermediários intercambiáveis, com preços muito próximos, ambos com janela de contexto de ~1M e pequenas vantagens relatadas: o Terra em preço e o Flash em código e velocidade. Quando os modelos são tão próximos, a questão não é qual coroar, mas como utilizar ambos.
Roteie entre eles por tarefa e custo, use um como fallback do outro para obter redundância de provedor e escale para um modelo flagship apenas para casos complexos. Defina tudo isso como política no gateway por trás de uma única API compatível com OpenAI. Assim, o próximo lançamento ou redução de preço de qualquer um dos provedores se torna uma mudança de configuração, em vez de uma migração. É assim que você obtém o melhor de ambos sem comprometer sua arquitetura com nenhum deles.
Roteie entre Terra e Flash em vez de escolher apenas um. Agende uma demonstração.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada


