



novembro 20, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: novembro 20, 2026

Blazingly fast way to build, track and deploy your models!
A maioria das equipes não tem um problema com modelos flagship (de ponta). Elas têm um problema com o modelo padrão. O modelo que responde à requisição mediana, aquele que lida com a cauda longa de chat, sumarização, programação do dia a dia e respostas com geração aumentada por recuperação (RAG), é onde a conta realmente se acumula, porque é onde está o volume. O Gemini 3.6 Flash é interessante justamente porque foi construído para esse slot padrão: capaz o suficiente para que os usuários não notem uma perda de qualidade em relação a um flagship e barato o suficiente para que você possa direcionar o grande volume de requisições a ele.
Este post cobre o que é o Gemini 3.6 Flash (conforme reportado em novembro de 2026), onde ele se encaixa entre os pequenos modelos ultra-econômicos e os flagships, quando escolhê-lo (e quando não), e o padrão de gateway que permite torná-lo seu padrão enquanto ainda escala as requisições que realmente precisam de mais capacidade.
Uma nota de precisão antes de começar: com exceção dos números do Claude, as especificações abaixo vêm de relatórios de terceiros e fontes que às vezes entram em conflito. Trate-os como um ponto de partida e verifique nas páginas oficiais de modelos e preços do Google antes de desenvolver com base neles. As especificações dos modelos mudam com frequência.
Quer rotear a maior parte do tráfego para um modelo da classe Flash e escalar apenas as requisições difíceis? Agende uma demonstração.
Relata-se que o Gemini 3.6 Flash foi lançado por volta de julho de 2026 como o modelo de camada intermediária otimizado para velocidade na linha Gemini 3.x do Google. O perfil reportado inclui:
O resumo em uma linha: um modelo que oferece a maior parte da utilidade diária de um flagship, a um preço intermediário, com contexto de classe flagship e alto throughput. Essa combinação é exatamente o que um modelo padrão deve ser.
Preços/benchmarks conforme reportados em novembro de 2026; verifique a página oficial de preços de cada provedor antes de confiar neles — as especificações dos modelos mudam com frequência.
Se a sua conta ou região ainda não exibe o 3.6 Flash, a alternativa segura e disponível para todos é o Gemini 3.5 Flash. Trate o 3.6 como a meta e o 3.5 GA como a garantia até confirmar o 3.6 diretamente.
A maneira útil de pensar sobre o Flash é como o degrau intermediário de uma escada de três degraus. Abaixo dele está a camada ultra-econômica. Acima dele estão os flagships. Cada degrau tem uma função.
Camada ultra-econômica (cerca de $0,10 a $0,25 na entrada). O Claude Haiku 5.5 está confirmado a partir de $0,10 / $0,50. O GPT-6 Luna reportado fica em $0,10 / $0,50 e o Gemini 3.1 Flash-Lite perto de $0,25 / $1,50. Eles servem para classificação, extração, roteamento e outras tarefas curtas e inequívocas. No preço de entrada, são cerca de 15x mais baratos que o Flash. Eles não são tão capazes e não foram feitos para ser.
Modelo versátil da classe Flash (cerca de $1 a $2 na entrada). Gemini 3.6 Flash a um valor reportado de $1,50 / $7,50, ao lado de pares como Claude Sonnet 5.5 (confirmado $2 / $10) e o GPT-6.1 Terra reportado ($1 / $5). Esta é a camada padrão: chat, sumarização, respostas de RAG, programação do dia a dia, qualquer coisa que precise de competência real, mas não do raciocínio mais profundo.
Camada Flagship (cerca de $2 a $10 na entrada, saída alta). Gemini 3.1 Pro (reportado $2 / $12), Claude Opus 5.5 (confirmado $4 / $20), o GPT-6 Astra reportado ($10 / $50). Eles justificam seu preço apenas na fatia difícil: programação baseada em agentes de longo alcance, raciocínio profundo, análises complexas.

O ponto da escada é que cada degrau está separado por aproximadamente uma ordem de grandeza em preço ou capacidade. Portanto, mover uma requisição para o degrau errado é caro em uma direção e de baixa qualidade na outra. O Flash é o degrau onde a maior parte do seu tráfego deve estar.
O Flash é o padrão correto, mas não a resposta certa para tudo. Aqui está a tomada de decisão.
Preços/benchmarks conforme reportados em novembro de 2026; verifique a página oficial de preços de cada provedor antes de confiar neles — as especificações dos modelos mudam com frequência. Os números do Claude são confirmados pelo próprio provedor.
Veja como a TrueFoundry usa modelos baratos como padrão e realiza o fallback automaticamente. Agende uma demonstração.
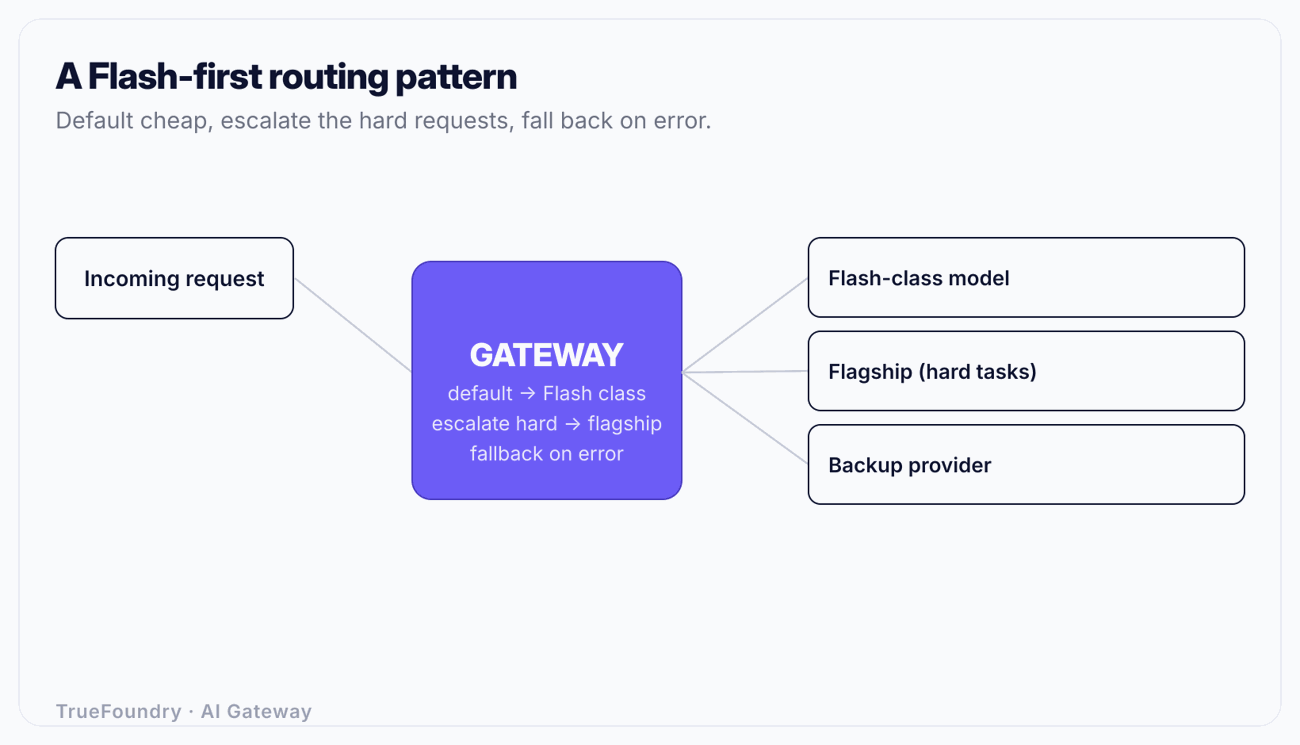
Saber que o Flash deve ser o seu padrão não é suficiente. Você precisa de um mecanismo que envie a maior parte do tráfego para o Flash, reconheça as requisições que precisam de mais capacidade, escale apenas essas e não falhe quando o Google tiver cinco minutos de instabilidade. Esse mecanismo é um AI gateway com uma API unificada e compatível com a OpenAI.
Aqui está o padrão em quatro passos.
1. Defina o Flash como a rota padrão. Aponte um alias de modelo (por exemplo, default-chat) para o Gemini 3.6 Flash na configuração do gateway. Sua aplicação chama default-chat; ela nunca insere "gemini-3.6-flash" diretamente no código. Quando você quiser testar o Sonnet 5.5 ou o Terra como padrão, basta alterar uma linha de configuração e redirecionar uma porcentagem do tráfego, sem precisar implantar código na aplicação. Isso é a seleção de modelos consciente de custo e qualidade (cost- and quality-aware model selection) na prática, e a ideia subjacente é o que faz um LLM router.
2. Escale requisições difíceis. Adicione tags às requisições que exigem mais (um sinal de complexidade vindo da sua aplicação, um endpoint específico, uma nova tentativa após uma resposta com baixa confiança) para que o gateway as roteie para um alias de flagship. A maior parte do tráfego permanece no Flash; apenas a pequena fatia difícil paga as tarifas de flagship. A regra de decisão é uma regra de roteamento, não uma ramificação de código espalhada pelos seus microsserviços.
3. Faça fallback em caso de erro. Configure o Flash para alternar para um segundo provedor quando o Google retornar um erro ou atingir o tempo limite. Uma requisição da classe Flash pode fazer fallback para o Claude Sonnet 5.5 ou GPT-6.1 Terra. Tentativas de reenvio na própria requisição e fallback entre provedores garantem que um incidente no provedor se torne apenas um pequeno aumento de latência, não uma interrupção do serviço. Veja o que é LLM fallback.
4. Use cache e meça o desempenho. O uso de cache exato e semântico impede que você pague ao Flash para responder à mesma pergunta duas vezes; veja semantic caching. Além disso, cada chamada é registrada com tokens, latência e custo atribuídos por usuário, equipe e modelo, para que você possa provar que o Flash está absorvendo o volume e que o flagship só está sendo acionado para a fatia difícil. Veja LLM observability tools.
Considere um produto que processa 5 milhões de requisições por mês, a maioria consistindo em chat e RAG, com uma cauda difícil de raciocínio complexo. Suponha que a distribuição seja 75% rotineira (adequada ao Flash), 20% trivial (adequada à camada ultra-econômica) e 5% difícil (adequada ao flagship), com média de 800 tokens de entrada e 400 de saída por requisição.
Se tudo rodar em um flagship a $2 / $12, você pagará a taxa de saída do flagship em todas as 5 milhões de requisições, incluindo as 3,75 milhões que o Flash responderia da mesma forma e 1 milhão que um modelo de $0,10 responderia de forma idêntica.
Em vez disso, faça o roteamento por camadas:
A fatia de 20% trivial reduz cerca de 15x no custo de entrada ao deixar o Flash e ir para a camada ultra-econômica. A fatia de 75% cotidiana cai do valor de saída do flagship ($12) para a saída do Flash ($7,50), reduzindo quase 40% do componente de custo dominante. A fatia de 5% difícil mantém o flagship. O efeito líquido na maioria das combinações reais de tokens é uma redução de mais de um terço na fatura, sem perda de qualidade em nenhuma camada, porque cada requisição ainda chega a um modelo dimensionado para ela. Você só pode confirmar esse número medindo o custo por camada, motivo pelo qual a observabilidade e a atribuição de custos importam tanto quanto o roteamento.
Para evitar que a camada de modelos superiores estoure o orçamento silenciosamente, estabeleça um limite usando limites de taxa de tokens e orçamentos: o gateway retorna HTTP 429 quando uma equipe ou modelo ultrapassa seu teto, impedindo que um caminho de escalonamento comprometa seus gastos.
O Gemini 3.6 Flash foi desenvolvido para o espaço onde a maior parte dos seus gastos realmente se concentra: a requisição mediana. Com valores reportados de $1,50 / $7,50, uma janela de contexto de 1M de tokens e alto throughput, ele oferece a maior parte da utilidade cotidiana de um flagship sem o preço correspondente, estando claramente um passo acima da camada ultra-econômica — que ainda deve cuidar das suas tarefas triviais. O modelo mental correto é uma escada, e o Flash é o degrau ao qual a maior parte do tráfego pertence.
Torne-o seu padrão em um gateway, escale apenas as requisições difíceis para um flagship, faça fallback para um segundo provedor quando o Google oscilar e meça o custo por modelo para comprovar que essa divisão está funcionando. Ao fazer isso, "usar o Gemini 3.6 Flash" deixa de ser uma decisão isolada e se torna uma política de roteamento ajustável assim que o próximo modelo ou a próxima redução de preço for lançada.
Roteie para o modelo mais barato que seja bom o suficiente. Agende uma demonstração.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada


