



novembro 20, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: novembro 20, 2026

Blazingly fast way to build, track and deploy your models!
"Qual é o melhor LLM para programação?" é a pergunta errada, porque não tem uma resposta estável. O modelo que escreve a função de 40 linhas mais limpa não é o mesmo que você deseja consumindo tokens em uma refatoração de 30 arquivos; e o modelo que resolve um bug complexo de concorrência é exagero para autocompletar um método getter. Os benchmarks mudam a cada poucas semanas. Uma equipe que insere um único modelo diretamente em suas ferramentas em janeiro estará reavaliando essa decisão em abril.
A pergunta melhor é: para esta classe de tarefa de programação, dentro deste orçamento, para qual modelo devo rotear — e como mantenho os custos e a segurança sob controle quando cem desenvolvedores respondem a essa pergunta de maneiras diferentes? Essa é a pergunta que este artigo responde. Analisamos os concorrentes com base no que eles realmente fazem bem, apresentamos uma estrutura de decisão por tarefa que dura mais que qualquer benchmark e abordamos a parte que a maioria das equipes pula: a camada de roteamento e governança que transforma a escolha do modelo em um valor de configuração, em vez de uma reescrita de código.
Uma observação inicial sobre precisão: os preços da família Claude da Anthropic mostrados abaixo foram verificados em novembro de 2026. Os números de benchmark dos concorrentes são valores relatados ou agregados; atribuímos fontes e datas a eles, e você deve reconfirmá-los com cada fornecedor antes de investir recursos.
Quer rastreamento de custos por desenvolvedor e guardrails em todos os modelos de programação? Agende uma demonstração.
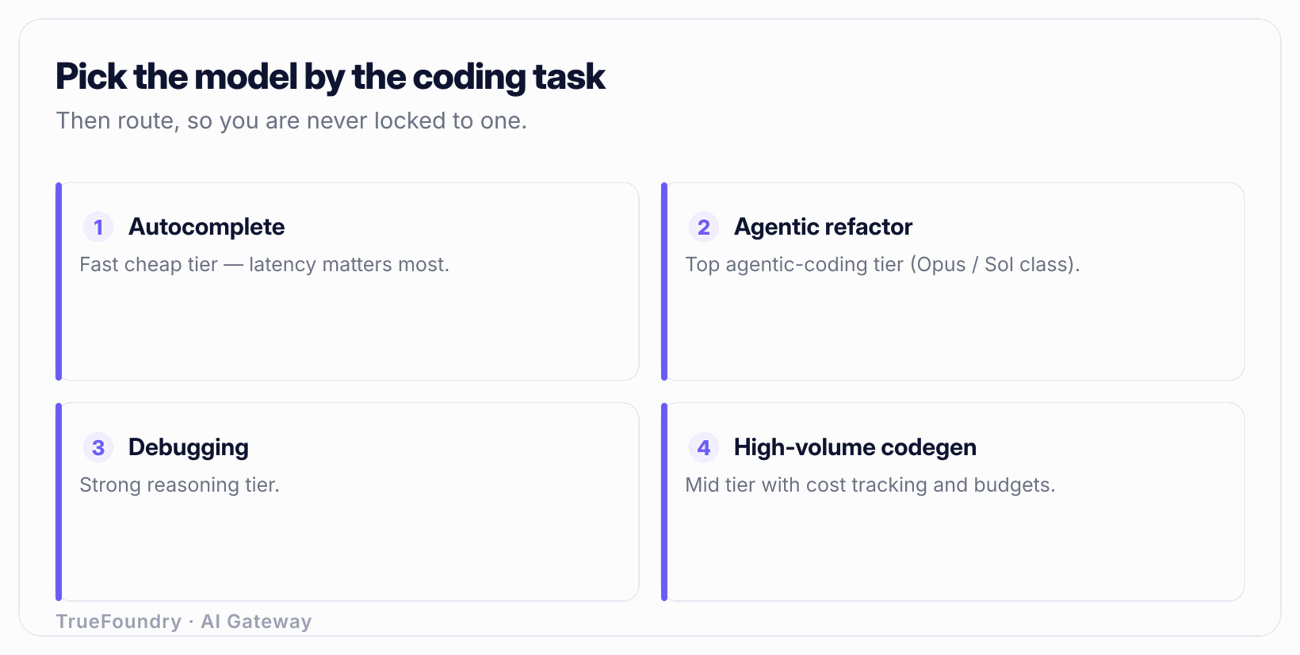
Antes de escolher um modelo, você precisa definir o trabalho. A maioria das comparações do "melhor LLM para programação" falha porque calcula médias de tarefas com requisitos opostos. Divida a programação em quatro formatos e a escolha ficará muito mais clara.
Autocompletar / conclusão em linha. O modelo prevê as próximas linhas enquanto você digita. A latência é fundamental — qualquer valor acima de 300-500 ms interrompe o fluxo. O contexto é pequeno (o arquivo atual e alguns vizinhos). Você realiza milhares dessas chamadas por desenvolvedor diariamente, portanto o custo unitário é o fator dominante. Você precisa de um modelo rápido e barato, não do mais inteligente.
Refatoração agente de múltiplos arquivos. O modelo planeja, lê vários arquivos, edita alguns, executa testes e itera — um ciclo que pode rodar por minutos e consumir centenas de milhares de tokens em uma única tarefa. É aqui que a profundidade de raciocínio, a coerência em contextos longos e a capacidade de manter o plano ao longo de muitas etapas trazem retorno. É também onde um modelo fraco sai mais caro, porque consome tokens sem sair do lugar e entrega um diff com erros.
Depuração profunda. Um problema difícil: uma race condition, um vazamento de memória, um bug intermitente que só aparece sob carga. O volume é baixo, mas o valor de acertar é alto. Você busca a máxima qualidade de raciocínio e está disposto a pagar por isso por incidente.
Geração de código em alto volume. Estruturação inicial (scaffolding), código boilerplate, stubs de teste, scripts de migração, docstrings — grandes quantidades de código simples. Os requisitos de qualidade são moderados; o throughput e o custo por geração são prioritários. Um modelo de camada intermediária geralmente vence no custo total de propriedade.
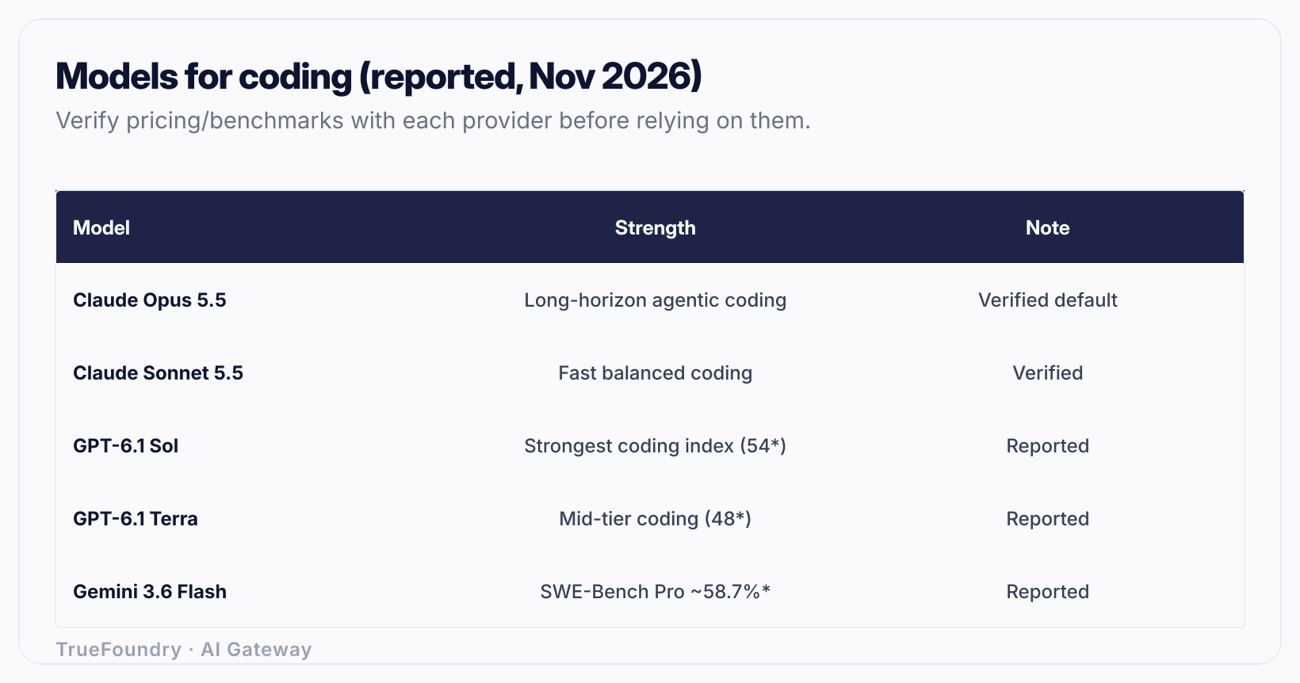
Esses quatro formatos raramente se alinham a um único modelo. O mesmo desenvolvedor, na mesma hora, precisa de um modelo rápido e barato para autocompletar, um modelo de raciocínio profundo para o bug em que está travado e um modelo agente forte para a refatoração iniciada em segundo plano. Esse é o motivo estrutural pelo qual a padronização em um único modelo falha.
Abaixo está o cenário real em novembro de 2026. Os preços do Claude estão verificados; os demais dados foram relatados e devem ser rechecados.
A geração 5.5 do Claude se divide claramente entre os formatos de tarefas descritos acima:
O padrão prático é uma estratégia de camadas dentro do próprio Claude — Haiku para autocompletar e volume, Sonnet para a maioria dos trabalhos com agentes, Opus para refatorações complexas e sessões de depuração travadas.
Em novembro de 2026, relatórios apontam o GPT-6.1 Sol no topo da capacidade geral de programação, com um "Coding Index" agregador em torno de 54, e o GPT-6.1 Terra um passo atrás, em cerca de 48. O Sol é posicionado como um modelo de ponta para programação; o Terra é uma camada mais rápida e barata. Trate os números de índices como direcionais — eles vêm de agregações de terceiros, não de um harness único padronizado. Os preços e nomes de camadas da OpenAI devem ser confirmados no site oficial antes do alocamento de orçamento.
O Gemini 3.6 Flash é relatado com cerca de 58,7% no SWE-Bench Pro, um benchmark que mede correções reais no estilo pull request em repositórios de produção. Se esse valor se mantiver, o Flash se mostra competitivo em tarefas práticas de engenharia de software em uma camada posicionada para velocidade e custo. Reiterando: dados relatados em novembro de 2026; verifique com o Google.
O SWE-Bench e os índices de programação medem a capacidade de um modelo de produzir uma correção adequada em problemas selecionados. Eles não medem como o modelo se comporta dentro do seu agente, no seu código-fonte, com as suas ferramentas e limites de contexto. Um modelo com pontuação dois pontos maior em um benchmark público pode ter um desempenho pior na prática se for mais lento, tiver uma janela de contexto efetiva menor ou lidar pior com sua linguagem e framework. Use os benchmarks para criar uma lista inicial e, em seguida, execute sua própria avaliação em tarefas que representem seu trabalho real.
Abaixo está o cenário relatado em uma tabela. Leia a observação abaixo dela antes de citar qualquer um desses números.
Ressalva: Os preços do Claude foram verificados em novembro de 2026. Todos os números dos concorrentes são valores relatados ou agregados de terceiros em novembro de 2026 e não são diretamente comparáveis entre diferentes harnesses — reconfirme especificações, disponibilidade e preços com cada fornecedor antes de tomá-los como base.
Em vez de escolher "o melhor modelo", defina um padrão por formato de tarefa e um caminho de escalonamento. Esta é a parte que permanece válida mesmo quando o ranking do próximo mês mudar.
A lógica: inicie cada tarefa na camada mais barata que apresente sucesso consistente e escalone apenas mediante um sinal concreto — falha nos testes, diff muito grande ou agente em loop. Uma refatoração que um modelo intermediário erraria em dez iterações caras sai mais barata em um modelo de ponta que a conclui em duas. Por outro lado, o autocompletar que um modelo de ponta executaria perfeitamente ainda é o lugar errado para gastar, porque você faz essa chamada dez mil vezes ao dia.
Note o que essa estrutura exige operacionalmente: a capacidade de enviar requisições diferentes para modelos diferentes com base no tipo de tarefa e sinais, sem reescrever a aplicação. Isso é roteamento, e é onde entra o gateway. Veja seleção de modelos consciente de custo e qualidade para entender como essa lógica é codificada e o que é um roteador LLM para ver a mecânica.
Veja como a TrueFoundry roteia o tráfego de programação e limita os gastos por desenvolvedor. Agende uma demonstração.
Imagine uma organização com 200 desenvolvedores. Alguns usam o Cursor, outros o Claude Code, alguns preferem o Copilot no VS Code, e a equipe de dados chama modelos diretamente de notebooks. Cada ferramenta adota modelos diferentes por padrão, e cada desenvolvedor tem suas preferências. Mesmo que você exija um único modelo hoje, um melhor será lançado em seis semanas e seus melhores engenheiros encontrarão formas de contornar a exigência.
Isso não é falta de disciplina. É o estado final correto. Tarefas diferentes exigem modelos diferentes, ferramentas distintas expõem modelos variados, e o estado da arte muda mensalmente. Lutar contra essa fragmentação é uma batalha perdida. A estratégia vencedora é parar de tentar padronizar o modelo e padronizar o ponto de controle à frente dos modelos.
Na prática, isso significa que cada agente de código na empresa — Claude Code, Cursor, Copilot, scripts internos — aponta para um único endpoint compatível com OpenAI em vez de conversar diretamente com a API de cada fornecedor. Atrás desse endpoint, você decide o roteamento, visualiza cada requisição e aplica as políticas. O modelo passa a ser um valor de configuração. Trocar o Sonnet por um modelo mais novo ou adicionar o GPT-6.1 Sol para escalonamento de depuração torna-se uma alteração de configuração, não uma migração de código em toda a infraestrutura.
Um AI gateway fica entre seus agentes de código e os provedores de modelos, expondo uma API unificada compatível com OpenAI. Para programação especificamente, quatro recursos são essenciais.
Atribuição de custos por desenvolvedor, equipe e modelo. Agentes de código consomem tokens de formas que surpreendem a área financeira. Uma refatoração agente pode queimar mais de 300.000 tokens em uma única tarefa. Sem atribuição, você recebe uma fatura única e genérica do provedor sem saber se o gasto veio das refatorações da equipe de plataforma ou do loop descontrolado de um único desenvolvedor. O gateway identifica cada requisição com usuário, equipe e modelo, permitindo responder "quem gastou quanto em qual modelo" até o nível da requisição. Essa é a base da atribuição de custos e orçamentos de equipe e do FinOps para IA em geral.
Orçamentos e limites de taxa por desenvolvedor ou equipe. Defina um orçamento mensal em dólares por equipe e um limite de taxa de requisições por desenvolvedor. Quando um limite é atingido, o gateway retorna HTTP 429 em vez de aumentar a conta silenciosamente. É isso que impede que um agente mal configurado em loop gere uma surpresa de cinco dígitos da noite para o dia. A mecânica é detalhada em limites de taxa de tokens e orçamentos.
Guardrails contra vazamento de segredos. Agentes de código leem seu código-fonte. O código contém credenciais inseridas diretamente, hostnames internos, dados de clientes em arquivos de teste e PII em arquivos de amostra. Qualquer um desses itens pode ser enviado a um provedor de modelo em um prompt. Um gateway pode escanear requisições de saída em busca de segredos e PII, bloqueando-os ou ocultando-os antes que saiam da sua rede. Para empresas reguladas, isso costuma ser a diferença entre o uso "aprovado" e "proibido". Veja guardrails de IA para conhecer os tipos de detecção.
Auditoria e observabilidade. Uma trilha única de cada requisição — quem fez, qual modelo, quantos tokens, latência, custo e aprovação nos guardrails. Quando a equipe de segurança perguntar "algum código nosso vazou para um modelo externo no último trimestre?", você terá uma resposta precisa. Combine o log do gateway com suas ferramentas de observabilidade de LLM para acompanhar latência e qualidade ao longo do tempo.
O AI gateway da TrueFoundry oferece exatamente esse plano de controle — uma API unificada compatível com OpenAI com roteamento por latência/peso/prioridade, fallback automático e novas tentativas na requisição, caching exato e semântico, orçamentos e limites de taxa por usuário/equipe/modelo, observabilidade completa por requisição e guardrails para PII/segredos/injeção de prompt. Ele pode ser implantado como SaaS, na sua VPC, on-premises ou air-gapped, garantindo que o plano de dados que carrega seu código-fonte permaneça dentro da sua rede.
Vamos para a prática. Três desenvolvedores, uma semana, trabalhos diferentes:
Três desenvolvedores, três formatos de tarefas, três camadas e um gasto semanal combinado de cerca de US$ 40 — com a refatoração profunda do Dev C custando cerca de 14 vezes mais do que as conclusões do Dev A. Agora imagine 200 desenvolvedores sem atribuição de custos: você vê uma fatura única e não consegue separar o uso legítimo de um erro descontrolado. Com o gateway, você percebe que a refatoração do Dev C foi cara e valeu a pena, que as conclusões do Dev A são eficientes e que, se o agente de um quarto desenvolvedor entrar em loop às 2h da manhã, o limite de orçamento o interromperá com um erro 429 antes que se torne um problema.
Os números acima usam os preços verificados do Claude e valores arredondados para fins de ilustração; seus volumes reais de tokens serão diferentes. O ponto central é a estrutura: o formato da tarefa determina a camada, a camada determina o custo, e a atribuição é o que transforma um gasto total preocupante em um item gerenciável.
Buscar sempre o topo do ranking. As equipes redefinem seu "modelo único de programação" toda vez que um benchmark é atualizado, alterando as ferramentas a cada mudança. A diferença no benchmark é quase sempre menor do que o custo dessa troca constante. Defina padrões por formato de tarefa, roteie o tráfego e deixe o gateway absorver as mudanças de modelos como simples configurações.
Rotear tudo para o modelo mais avançado. Usar o Opus 5.5 ou o GPT-6.1 Sol para autocompletar parece uma escolha segura, mas é silenciosamente prejudicial aos custos — você paga preços de ponta nas chamadas de maior volume e menor valor. Adapte a camada à tarefa. O modelo mais barato que resolve o problema com consistência é a escolha certa.
Falta de atribuição de custos até a chegada da fatura. Muitas equipes só descobrem os gastos com agentes de código quando o setor financeiro faz um alerta. A essa altura, é impossível saber qual equipe ou comportamento gerou o custo. A atribuição precisa estar ativa antes de expandir as licenças, e não depois.
Ignorar o vazamento de segredos e PII no código. O maior risco dos agentes de código não é gerar um código incorreto, mas sim vazar o código correto. Arquivos de código contêm credenciais e dados de clientes, e os agentes os enviam para modelos de terceiros. Se você não possui guardrails na saída, está exposto a vazamentos de segredos sem saber até que ocorra um incidente.
Tratar a escolha do modelo como uma decisão da aplicação. Inserir nomes de modelos e chaves de API diretamente em cada ferramenta e serviço significa que cada alteração exige um novo deploy. Coloque a escolha atrás de um endpoint de gateway e a seleção do modelo passa a ser uma decisão de política, tomada uma vez e aplicada em todos os lugares.
O "melhor LLM para programação" é um alvo em constante mudança. A estratégia sustentável é parar de tentar escolher um único modelo e passar a gerenciar um portfólio: uma camada rápida e barata para conclusões e volume, uma camada equilibrada para o trabalho diário com agentes e uma camada de ponta para refatorações complexas e depuração profunda — com um sinal claro de escalonamento entre elas. A divisão entre Opus, Sonnet e Haiku do Claude se encaixa quase perfeitamente nessa estrutura hoje, e os dados relatados do GPT-6.1 e do Gemini oferecem opções de escalonamento e comparação que você pode adicionar via configuração.
O que torna esse portfólio governável é a camada de controle posicionada à frente dele. Roteie todos os agentes de código por um único AI gateway e a escolha do modelo se tornará um valor de configuração, os custos serão atribuídos por desenvolvedor e equipe, os orçamentos evitarão gastos descontrolados via erro 429 e os guardrails protegerão os segredos do seu código-fonte. É assim que você se mantém na vanguarda tecnológica sem perder o controle dos custos ou da segurança.
Governe o uso de modelos dos seus agentes de código a partir de um único gateway. Agende uma demonstração.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada


