Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.
9,9
Gateway de IA: O Painel de Controle Central da Infraestrutura de IA Generativa Atual
No nosso webinar recente sobre o Gateway de IA, começamos por verificar onde a audiência se encontra atualmente na sua jornada de inteligência artificial generativa (genAI).
Curiosamente, mais de 50% partilharam que já têm genAI em produção, e outros 15% estão a escalá-la por várias equipes — sinais claros de forte adoção empresarial e crescente maturidade na implementação de aplicações genAI.
A Evolução do Gateway LLM como um Plano de Controle Central
Focamos em como o gateway de IA evoluiu nos últimos 6 a 9 meses — de uma camada básica de roteamento de modelos para se tornar um plano de controle central crítico dentro da stack de IA generativa moderna
Inicialmente, os LLMs eram usados principalmente para gerar respostas de turno único a prompts, vistos em grande parte como preditores avançados da próxima palavra.
Estado Atual dos Agentes: Avançando para 2025, agentes alimentados por LLM tornaram-se autônomos e orientados a objetivos, capazes de invocar múltiplas ferramentas e sistemas nos bastidores. Por exemplo, um agente de redefinição de senha pode autenticar um usuário, chamar APIs para redefinir senhas e enviar e-mails de confirmação — tudo sem intervenção humana.
Complexidade Organizacional: Empresas frequentemente executam dezenas de agentes complexos abrangendo múltiplas equipes, usando vários modelos de diferentes provedores, frameworks e infraestruturas (incluindo hiperescaladores e nuvens híbridas).
Desafios Sem Centralização: Essa descentralização causa problemas significativos de governança, incluindo inconsistências em APIs de modelo, capacidade de implantação, auditabilidade, gestão de custos e estratégias de failover.
O gateway LLM tornou-se indispensável como o gateway central que consolida esses diversos recursos e necessidades operacionais, permitindo governança, observabilidade, controle de custos e confiabilidade em escala.
Desafios Enfrentados por Empresas que Usam Múltiplos Provedores de LLM
Formatos de API Inconsistentes: Apesar das alegações gerais de compatibilidade com a API da OpenAI, os provedores diferem na sintaxe dos parâmetros (por exemplo, tokens máximos, faixas de temperatura, sequências de parada), complicando a capacidade de troca e a interoperabilidade.
Interrupções Frequentes: Os provedores de modelos são, eles próprios, startups, com frequentes inatividades que causam falhas nas aplicações; assim, as aplicações devem ser agnósticas ao modelo e capazes de fazer failover de forma graciosa.
Alta Variação de Latência: A latência entre os provedores flutua amplamente, tornando o desempenho da aplicação imprevisível. A latência impacta a experiência do usuário tão severamente quanto uma interrupção completa.
Limites de Taxa Complexos: Múltiplos limites de taxa por provedor exigem limitação (throttling) e controle de custos entre unidades de negócios e centros de custo. A aplicação centralizada é difícil, mas essencial.
Demandas de Infraestrutura Híbrida: Muitas empresas devem gerenciar limites de taxa e rotações de chaves entre provedores de nuvem e infraestrutura de GPU local (on-prem).
Consultas Repetidas Custosas: Aplicações de IA generativa frequentemente recebem muitas consultas idênticas ou semanticamente semelhantes (por exemplo, mensagens de saudação), aumentando o custo da IA generativa desnecessariamente, a menos que seja mitigado por cache semântico.
Barreiras de Proteção e Conformidade: As empresas exigem filtragem de entrada no nível do prompt (por exemplo, sem vazamento de PII) e validação de saída (filtragem de palavrões) entre várias equipes e modelos, necessitando de aplicação centralizada.
Requisitos de Governança e Auditoria: As solicitações podem abranger múltiplos provedores e fontes de dados dentro de uma única ação de UI, portanto, as empresas exigem observabilidade centralizada, registro de auditoria, explicabilidade e rastreabilidade para atender às necessidades de conformidade.
Esses desafios justificam o papel d os melhores gateways LLMcomo o plano de controle central em ecossistemas de IA generativa empresariais.
Funções Essenciais e Benefícios de um Gateway de IA
Um gateway de IA desempenha um papel fundamental na resolução desses desafios, oferecendo uma gama de capacidades técnicas projetadas para otimizar o acesso, a governança e a confiabilidade do modelo.
Principais Funcionalidades do Gateway:
Camada de API Unificada: Fornece uma interface de API única e consistente, abstraindo detalhes específicos do provedor e mecanismos de autenticação. Isso garante:
Sem dependência de fornecedor.
Troca contínua de provedores sem alterações no código.
Uso simplificado de SDK para desenvolvedores.
Gerenciamento Centralizado de Chaves: Gerencia diversos métodos de autenticação (funções AWS IAM, chaves de API OpenAI, identidades GCP) através de um sistema unificado. Os benefícios incluem:
Emissão de chaves de API em nível de usuário para rastreabilidade.
Contas de serviço ou chaves virtuais para aplicações.
Fácil rotação e gerenciamento de chaves.
Evita o compartilhamento generalizado de chaves de API e permite controles de permissão mais refinados.
Retentativas e Callbacks: Gerencia interrupções de provedores de forma elegante com políticas de failover automatizadas. O fallback configurável de um modelo para outro garante serviço ininterrupto sem impactar o código da aplicação.
Limitação de Taxa e Controles de Custo: Permite a aplicação precisa de políticas de uso da API por usuário, por aplicação ou por unidade de negócio. Exemplos incluem:
Limites diários de chamadas para desenvolvedores.
Níveis de usuário premium com cotas diferenciadas.
Proteção contra agentes descontrolados que invocam loops infinitos, prevenindo assim picos de faturamento inesperados.
Balanceamento de Carga: Automatiza o roteamento de requisições para o modelo mais rápido ou mais confiável em tempo real, realizando balanceamento de carga baseado em latência e verificações de integridade.
Lançamentos Canary para Novos Modelos: Facilita o lançamento gradual e controlado de novas versões de modelos, permitindo testes e comparação de desempenho antes da migração completa.
Diferentes Tipos de Balanceamento de Carga
Salvaguardas Centrais : Implementa filtros de prompt e resposta em toda a empresa, tais como:
Remoção de PII antes de enviar dados externamente.
Detecção e remoção de linguagem ofensiva ou conteúdo prejudicial nas respostas.
Capacidade de bloquear ou modificar prompts centralmente.
Integração transparente para que os desenvolvedores de aplicações não precisem gerenciar essas regras individualmente.
Cache Semântico: Mantém um cache de pares de prompt-resposta semanticamente semelhantes para reduzir chamadas de modelo, diminuindo a latência e os custos para consultas repetitivas.
Principais Benefícios
Governança central robusta para empresas.
Capacidade imediata de trocar modelos e provedores sem tempo de inatividade.
Acesso auditável e observável a todas as interações do modelo com métricas granulares.
Esforço de engenharia reduzido no gerenciamento da complexidade de múltiplos modelos.
Experiência do usuário aprimorada com otimizações de failover e latência.
Key Metrics for Evaluating Gateway
Criteria
What should you evaluate ?
Priority
TrueFoundry
Latency
Adds <10ms p95 overhead for time-to-first-token?
Must Have
✅ Supported
Data Residency
Keeps logs within your region (EU/US)?
Depends on use case
✅ Supported
Latency-Based Routing
Automatically reroutes based on real-time latency/failures?
Must Have
✅ Supported
Key Rotation & Revocation
Rotate or revoke keys without downtime?
Must Have
✅ Supported
Key Rotation & Revocation
Rotate or revoke keys without downtime?
Must Have
✅ Supported
Key Rotation & Revocation
Rotate or revoke keys without downtime?
Must Have
✅ Supported
Key Rotation & Revocation
Rotate or revoke keys without downtime?
Must Have
✅ Supported
Key Rotation & Revocation
Rotate or revoke keys without downtime?
Must Have
✅ Supported
Evaluating an AI Gateway?
A practical guide used by platform & infra teams
Visão Futura: Integração com Servidores MCP com AI Gateway
No futuro, o gateway LLM se estenderá além dos modelos para gerenciar ferramentas e agentes completos via protocolos MCP e A2A -
O que é um Servidor MCP?
Um servidor MCP expõe APIs de produtos (por exemplo, canais do Slack, mensagens, usuários) de uma forma que agentes baseados em LLM podem descobrir e consumir.
Exemplo: Um servidor MCP do Slack expõe APIs para ler canais, mensagens e enviar mensagens, tudo compreensível por um agente LLM.
Interação do Agente com Servidores MCP:
Agentes consultam o servidor MCP para identificar ferramentas disponíveis.
Com base em uma solicitação em linguagem natural, o agente planeja e chama autonomamente a sequência correta de ferramentas (por exemplo, recuperar mensagens, resumir, criar tarefas no Jira).
Integração do Gateway com MCP:
O gateway atuará como um ponto de acesso unificado para modelos LLM e servidores MCP dentro de uma organização.
Os usuários poderão emitir comandos em linguagem natural (por exemplo, “Criar tarefas no Jira com base nas minhas mensagens do Slack”) em ferramentas integradas sem necessidade de codificação.
A autenticação será gerenciada de forma contínua, federada através de provedores de identidade existentes como Okta ou Azure AD.
Esta integração capacita usuários não técnicos a automatizar processos de negócios facilmente.
Ponto de acesso unificado para modelos LLM e servidores MCP dentro de uma organização
Analisando e triando alertas combinando dados da API do Datadog e do GitHub.
Agendando fluxos de trabalho recorrentes utilizando múltiplas ferramentas de software empresarial.
Auditoria e governança centralizadas sobre todas as atividades de agentes e invocações de ferramentas.
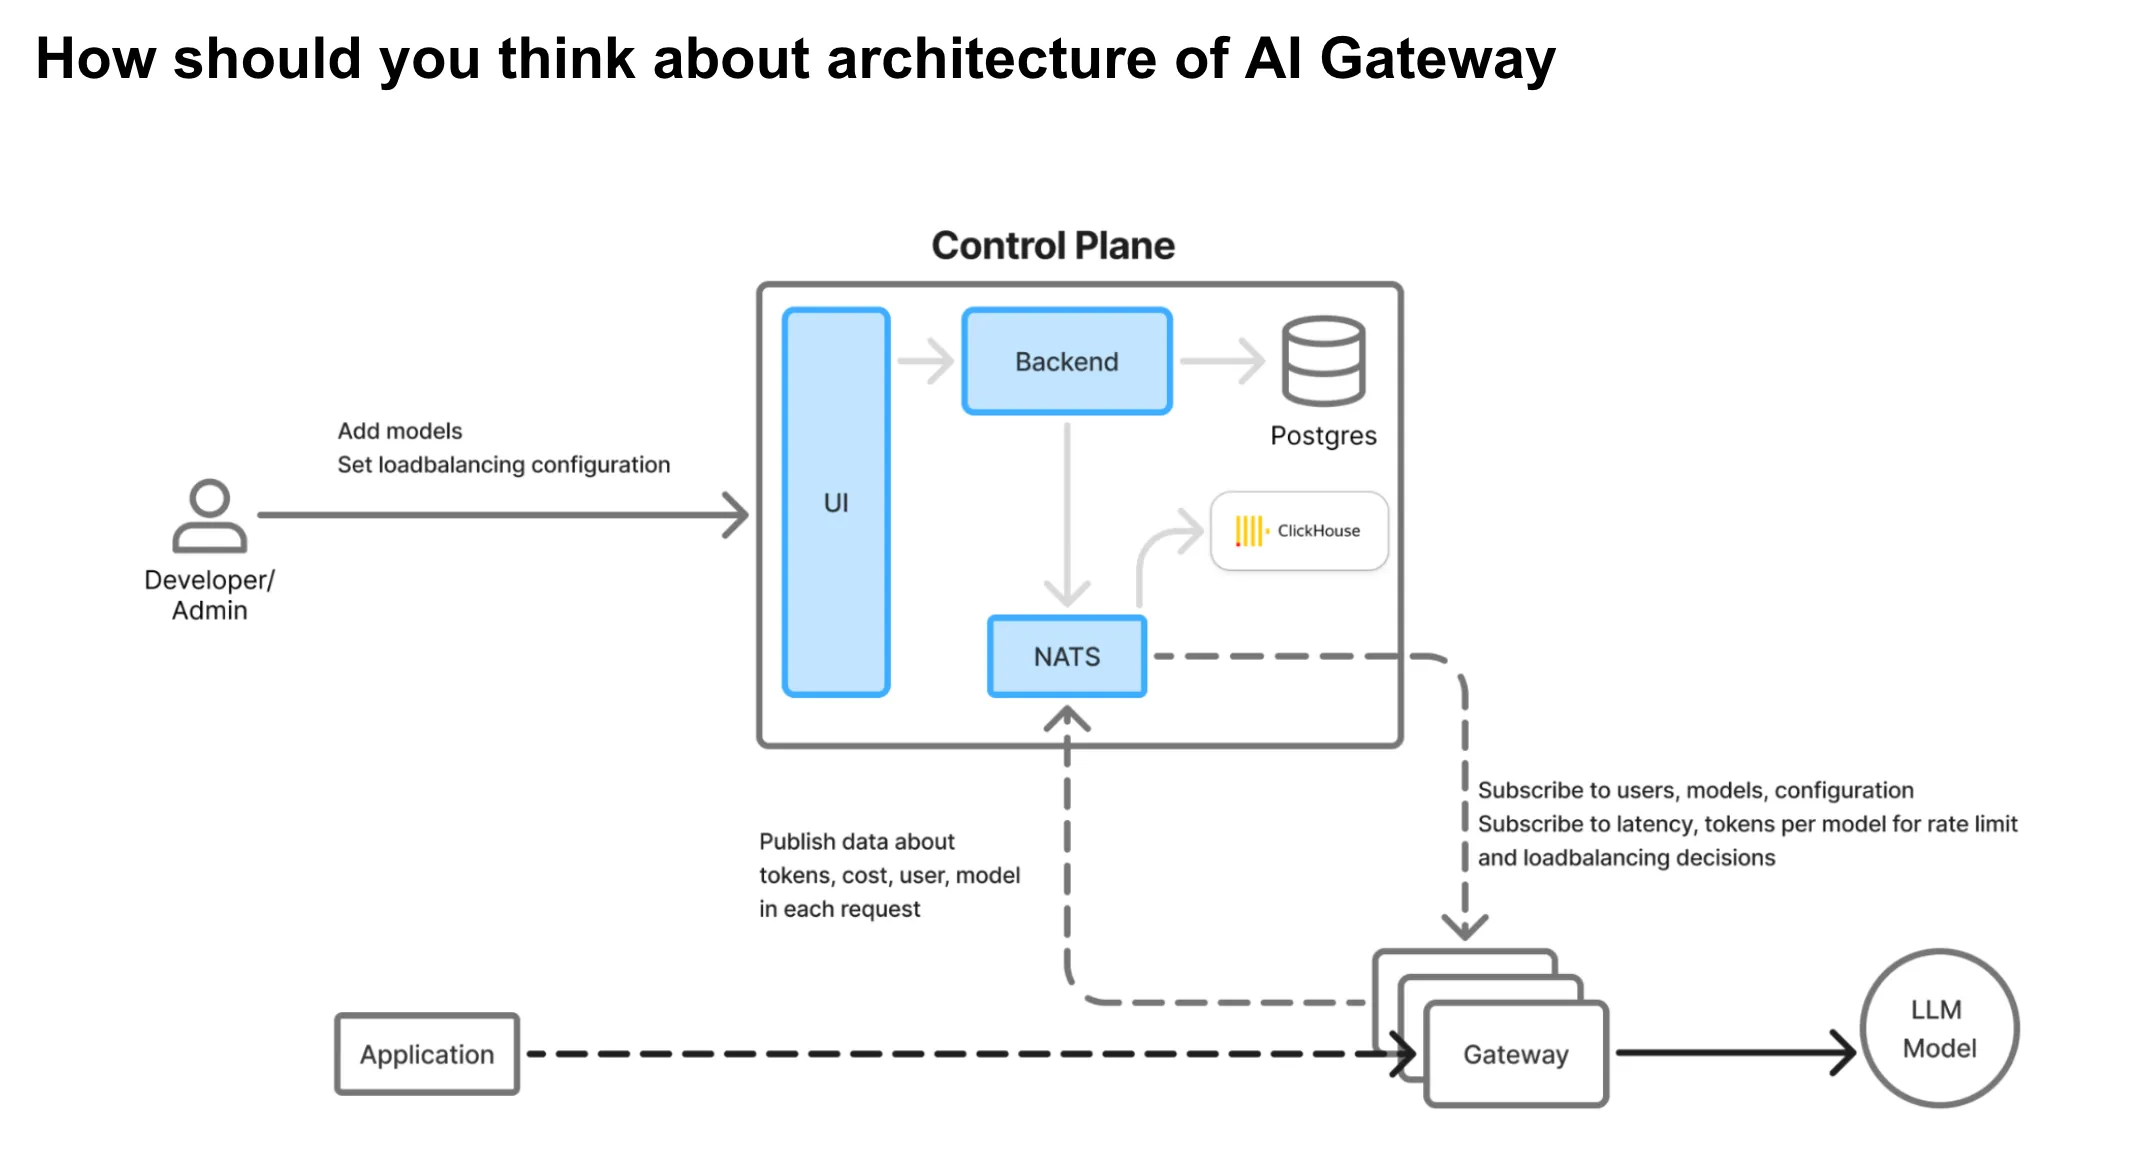
Arquitetura do AI Gateway
O AI Gateway funciona como a camada de proxy crítica entre aplicações e provedores de modelos de linguagem (LLM). Como o gateway se encontra no caminho crítico do tráfego de produção, ele deve ser projetado com os seguintes princípios fundamentais em mente:
Principais Prioridades Arquitetônicas:
Alta Disponibilidade: O gateway não deve se tornar um ponto único de falha. Mesmo diante de problemas de dependência (como interrupções de banco de dados ou filas), ele deve continuar a servir o tráfego de forma resiliente.
Baixa Latência: Como ele está em linha com cada solicitação de inferência, o gateway deve adicionar sobrecarga mínima para garantir uma experiência de usuário ágil.
Alta Vazão e Escalabilidade: O sistema deve escalar linearmente com a carga e ser capaz de lidar com milhares de requisições concorrentes com uso eficiente de recursos.
Sem Dependências Externas no Caminho Crítico: Quaisquer operações ligadas à rede ou ao disco devem ser descarregadas para sistemas assíncronos para evitar gargalos de desempenho.
Tomada de Decisão em Memória: Verificações críticas como limitação de taxa, balanceamento de carga, autenticação, e autorização devem ser todas realizadas em memória para máxima velocidade e confiabilidade.
Separação do Plano de Controle e do Plano de Proxy: Alterações de configuração e gestão do sistema devem ser desacopladas do roteamento de tráfego em tempo real, permitindo implantações globais com isolamento de falhas regional.
O AI Gateway da TrueFoundry incorpora todos os princípios de design acima, projetado especificamente para baixa latência, alta confiabilidade e escalabilidade contínua.
Arquitetura do AI Gateway da TrueFoundry
Construído sobre o Framework Hono: O gateway utiliza Hono, um framework minimalista e ultrarrápido otimizado para ambientes de borda. Isso garante uma sobrecarga mínima de tempo de execução e um processamento de requisições extremamente rápido.
Zero Chamadas Externas no Caminho da Requisição: Assim que uma requisição atinge o gateway, ela não aciona nenhuma chamada externa (a menos que o cache semântico esteja ativado). Toda a lógica operacional é tratada internamente, reduzindo riscos e aumentando a confiabilidade.
Aplicação em Memória: Todas as decisões de autenticação, autorização, limitação de taxa e balanceamento de carga são tomadas usando configurações em memória, garantindo tempos de resposta em submilisegundos.
Log Assíncrono: Logs e métricas de requisição são enviados para uma fila de mensagens de forma assíncrona, garantindo que a observabilidade dos dados não bloqueie ou retarde o caminho da requisição.
Comportamento à Prova de Falhas: Mesmo que a fila de log externa esteja inoperante, o gateway não falhará nenhuma requisição. Isso garante tempo de atividade e resiliência sob falhas parciais do sistema.
Escalável Horizontalmente: O gateway é limitado pela CPU e sem estado, o que facilita a sua expansão horizontal. Ele tem um desempenho eficiente sob alta concorrência e baixo uso de memória.
Gateway de IA da True Foundry
Suporte a Múltiplos Provedores: Adicione e gerencie facilmente modelos da AWS, GCP, OpenAI, Anthropic, DeepInfra e opções personalizadas/auto-hospedadas.
Playground Unificado: Teste e execute prompts em qualquer modelo através de uma única interface. Chaves de API e nomes de modelos são configuráveis sem a necessidade de alterações no código.
Gerenciamento de Prompts com Guardrails: Exibe a redação em tempo real de dados sensíveis durante o envio de prompts, integrado ao servidor centralizado de guardrails.
Métricas Detalhadas e Observabilidade:
Rastreamento em tempo real de quem está chamando qual modelo.
Estatísticas detalhadas de latência, incluindo “tempo para o primeiro token” e “latência inter-token” (crítico para o monitoramento de desempenho de LLMs).
Limitação de taxa, fallback e estatísticas de acionamento de guardrails.
Logs de auditoria de todos os pares de requisição-resposta, exportáveis para conformidade.
Configurações de Administração Configuráveis: Defina limites de taxa por desenvolvedor ou equipe, defina políticas de fallback, roteamento baseado em latência e gerencie guardrails centralmente.
Roteiro de Integração de Servidores MCP: Prévia das próximas funcionalidades que suportarão todos os servidores MCP internos para ferramentas como Gmail, Slack, Confluence, Jira, GitHub e APIs personalizadas.
Q&A ao Vivo: Abordando Perguntas sobre Escalabilidade, Integração e Questões Técnicas
A sessão é concluída com uma sessão de perguntas e respostas com a audiência, abordando:
Escalabilidade do Gateway: Projetado para ser escalável horizontalmente; testes de desempenho mostram que uma CPU pode lidar com 350 requisições por segundo (RPS), exigindo implantações de scale-out para taxas mais altas.
Latência e Estabilidade: O Gateway oferece mecanismos de callback e de nova tentativa para maior confiabilidade e alterna automaticamente os modelos quando os provedores enfrentam interrupções.
Limites de Tamanho de Entrada do Modelo: Os modelos não conseguem lidar com entradas extremamente grandes (por exemplo, 500 MB); recomenda-se usar sistemas de geração aumentada por recuperação (RAG).
Integrações de Frameworks: Compatível com os principais frameworks de construção de agentes, como LangChain, LangGraph, usando APIs padrão compatíveis com OpenAI, sem a necessidade de SDKs especiais.
Suporte a Linguagens de Programação: O Gateway é construído usando frameworks de alto desempenho e leves (Hono, semelhante aos usados em workers do Cloudflare) e é agnóstico em relação à linguagem para clientes de API (Python, JavaScript, Go, etc.).
Adaptação Rápida a Novas APIs de Modelo: Atualizações contínuas para suportar parâmetros específicos do fornecedor e entradas multimodais com documentação rigorosa.
Ferramentas de Governança e Auditoria: Capacidade de exportar dados detalhados de latência, uso e custo para auditorias alinhadas às necessidades de governança.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.