October 14, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Published: October 7, 2026
Blazingly fast way to build, track and deploy your models!
Novos provedores de inferência para modelos de pesos abertos parecem surgir a cada poucas semanas, cada um prometendo mais tokens por segundo na mesma lista de modelos que todos já utilizam. O problema para as equipes de engenharia raramente é se um provedor é rápido o suficiente. O problema é o que vem depois: uma nova URL base, uma nova chave de API, uma nova configuração de observabilidade e um conjunto de caminhos de código na aplicação que agora precisam ser testados contra mais um esquema. A chegada do Wafer ao TrueFoundry AI Gateway elimina esse segundo problema, deixando apenas a primeira questão: o modelo é rápido o suficiente para a carga de trabalho?
O TrueFoundry AI Gateway atua entre as aplicações e todos os modelos que elas chamam, expondo uma interface única compatível com OpenAI, independentemente de qual provedor esteja realmente atendendo à solicitação. Em vez de uma aplicação manter um cliente diferente, uma chave diferente e uma política de nova tentativa diferente para cada provedor, ela envia todas as solicitações para um único endpoint e deixa que o Gateway resolva para onde essa solicitação deve ser enviada.
Essa resolução ocorre por meio do que o TrueFoundry chama de Modelos Virtuais: identificadores lógicos de modelos que mapeiam para um ou mais provedores físicos, com o roteamento decidido por prioridade, peso ou latência. Novos provedores não exigem novo código de integração no lado da aplicação. Eles são adicionados como uma conta de provedor e um conjunto de modelos registrados, e qualquer aplicação já apontada para o Gateway pode começar a usá-los no momento em que forem ativados.
O Wafer é um provedor de inferência hospedado, criado especificamente para o serviço rápido de modelos de pesos abertos. Sua proposta não é um catálogo de modelos mais amplo, mas sim uma execução mais rápida dos modelos que as equipes já desejam rodar, alcançada pela otimização de toda a pilha de inferência para hardware específico, em vez de servir modelos em uma pilha genérica. Por meio do TrueFoundry, essa velocidade está disponível para o GLM 5.2, servido como um chat completion serverless com streaming e chamadas de ferramentas.
O Wafer também trata o manuseio de dados como uma opção de primeira classe, e não como um complemento corporativo. As solicitações podem ser marcadas para retenção zero de dados individualmente, e o Wafer isola o tráfego e oferece tempo de atividade garantido por SLA para cargas de trabalho que precisam dessas garantias, sem exigir um nível de contrato separado apenas para ativar a opção.
Conectar os dois é uma questão de registrar o Wafer como uma conta de provedor na seção de Modelos do Gateway. O formulário da conta solicita uma URL Base, que assume como padrão o endpoint pass.wafer.ai/v1 do próprio Wafer, uma chave de API e uma opção para retenção zero de dados, que é ativada por padrão. Ao ativá-la, o Gateway é instruído a anexar um cabeçalho Wafer-ZDR: required em cada solicitação enviada ao Wafer, para que o comportamento de retenção seja aplicado no nível da solicitação, em vez de depender de uma configuração de toda a conta.
Assim que a conta existe, os modelos de chat individuais são registrados pelo seu Nome de Exibição e pelo seu ID de Modelo Wafer exato, como glm-5.2. O que torna essa integração excepcionalmente leve é que a API do Wafer já utiliza nativamente o esquema de chat completions da OpenAI. O adaptador de provedor do Gateway, que normalmente traduz solicitações para o formato próprio de um parceiro, não tem nada para traduzir aqui. Ele encaminha a solicitação praticamente inalterada, que é a mesma razão pela qual clientes existentes compatíveis com OpenAI podem apontar diretamente para o Wafer, alterando apenas a URL base e a chave.
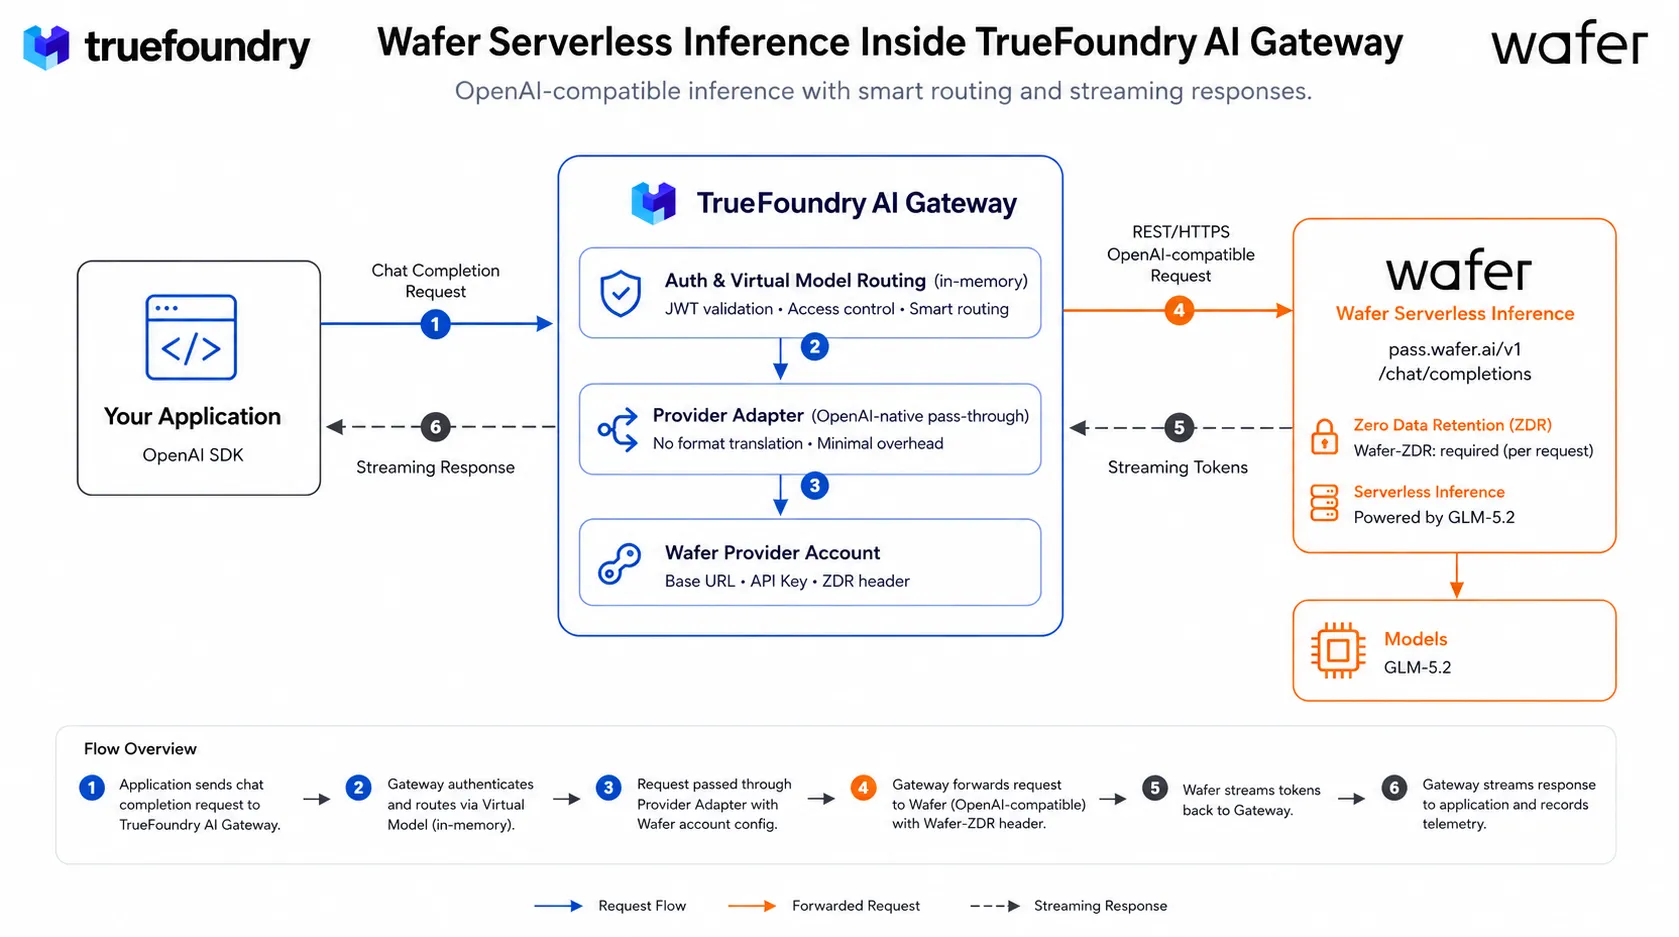
Uma solicitação direcionada a um modelo suportado pelo Wafer percorre o mesmo caminho de solicitação que qualquer outro modelo no Gateway:
1. Uma aplicação chama o endpoint de chat completions do Gateway com um identificador de modelo no formato sua-conta-wafer/glm-5.2, usando o SDK padrão da OpenAI.
2. O Gateway valida o JWT da solicitação contra chaves públicas em cache e verifica o acesso do chamador em um mapa de usuários para modelos em memória, ambos sem uma chamada externa.
3. O identificador do Modelo Virtual é resolvido para a conta de provedor Wafer registrada, incluindo sua URL Base, chave de API e configuração de retenção zero de dados.
4. A solicitação é encaminhada para pass.wafer.ai/v1/chat/completions via HTTPS. Como o Wafer já usa o esquema da OpenAI, o adaptador de provedor do Gateway não faz alterações de formato, apenas anexa o cabeçalho Wafer-ZDR quando a retenção está definida como obrigatória.
5. O Wafer executa a inferência no modelo GLM 5.2 solicitado e transmite os tokens de volta à medida que são gerados.
6. O Gateway transmite a resposta de volta para a aplicação e publica assincronamente a contagem de tokens, a latência e o custo em seu pipeline de telemetria, da mesma forma que faria para qualquer outro provedor.
Nenhuma dessas etapas é exclusiva do Wafer. Esse é o ponto principal: um novo provedor de inferência rápida torna-se um destino de roteamento em vez de uma nova superfície de integração, o que permite que uma conta do Gateway incorpore novos provedores à medida que eles se provam, sem que cada aplicação precise de uma alteração no código.
No painel do TrueFoundry, abra o AI Gateway, depois Models e selecione Wafer para adicionar uma conta e registrar seus modelos de chat. Chame-os através do Playground ou diretamente via cliente compatível com OpenAI, com o modelo definido como o nome da sua conta e o ID do modelo. As etapas completas de configuração e exemplos de código estão na documentação do TrueFoundry AI Gateway para o Wafer, juntamente com o guia de configuração de roteador do próprio Wafer.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada