November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De vraag "welk model is het beste?" is de verkeerde vraag en kost teams ongemerkt veel geld. Het eerlijke antwoord is dat een frontiermodel een hulpmiddel met een prijskaartje is, en het juiste hulpmiddel hangt af van wat u ermee wilt doen. Een classificatietaak voor productbeoordelingen naar een topmodel voor redeneren sturen, is als het huren van een hijskraan om een schilderij op te hangen. Het werkt. Maar het kost ook 40 keer meer dan nodig is en het is trager.
Tegen het einde van 2026 is de frontier opgesplitst in niveaus (tiers). Elke grote leverancier levert minstens drie modellen: een vlaggenschip dat is afgestemd op complex redeneren, een werkpaard uit het middensegment dat is afgestemd op prijs en doorvoer, en een klein model dat is gebouwd om snel en vrijwel gratis te zijn. De interessante beslissingen zijn niet langer "OpenAI of Anthropic". Ze zijn "welk niveau, voor welke request, tegen welke kosten, met welke fallback". Dat is een routeringsvraagstuk, en routeringsvraagstukken worden opgelost met beleid, niet met merkloyaliteit.
Dit artikel doet twee dingen. Ten eerste een overzicht per leverancier, georganiseerd rond de vraag waar elk model daadwerkelijk goed in is. Ten tweede een beslissingskader dat uw taaktypen koppelt aan een modelniveau en een kostenstrategie, en laat zien hoe een AI-gateway u helpt te handelen naar dat kader zonder uw app te herschrijven telkens wanneer een provider een nieuwe versie uitbrengt.
Wilt u elke request routeren naar het juiste model op basis van taak en kosten? Boek een demo.
Benchmarks meten een model op basis van een vaste test. Uw productieverkeer is geen vaste test. Het is een mix: een stroom van goedkope, repetitieve calls (factuurnummer extraheren, ticket classificeren, bepalen welke downstream prompt moet worden uitgevoerd) en een kleine stroom van echt complexe requests (een race condition in vijf bestanden debuggen, redeneren over een contract van 200 pagina's). Eén enkel "beste" model moet geprijsd en gedimensioneerd worden voor de complexe stroom, waardoor u te veel betaalt voor de grote massa eenvoudig verkeer.
Drie factoren maken het denken vanuit één model kostbaar:
De oplossing is om modelselectie te behandelen als configuratie. Bepaal het beleid één keer ("extractie gaat naar het goedkope niveau, codering gaat naar het middensegment, complex redeneren escaleert naar een vlaggenschip en alles valt bij fouten terug op een tweede provider"), leg dit vast in een gateway en wijzig het zonder code te releasen. Voor de technische uitwerking hiervan, zie wat is een LLM-router en kosten- en kwaliteitsbewuste modelselectie.
De enige onderstaande cijfers die door de leverancier zijn bevestigd, zijn die van Claude. Al het andere is verzameld uit rapportages van derden per november 2026 en moet worden geverifieerd op de eigen prijs- en modelpagina's van de provider voordat u er op vertrouwt. Modelspecificaties veranderen frequent.
Claude's aanbod voor eind 2026 draait op een context window van 1M tokens met 128K output en een trainingscutoff van juni 2026. De niveaus zijn helder:
Het nuttige patroon hier is de driedeling: een vrijwel gratis klein model, een gebalanceerd werkpaard en een premium agentic model. U kunt vrijwel elk routeringsbeleid opbouwen uit deze drie rollen.
De GPT-6-generatie van OpenAI volgt volgens rapportages dezelfde niveaustructuur. GPT-6 Astra wordt gerapporteerd op $ 10 / $ 50 en is gepositioneerd voor top-tier redeneren. GPT-6.1 Sol wordt gerapporteerd op $ 2 / $ 10 en wordt omschreven als het sterkste coderings- en onderzoeksmodel in de familie, met een gerapporteerde Coding Index van rond de 54. GPT-6.1 Terra, gerapporteerd op $ 1 / $ 5 en uitgebracht rond 26 oktober 2026, wordt omschreven met een context van ongeveer 1,05M en een gerapporteerde Coding Index van nabij de 48, waarmee het op ongeveer de helft van de prijs van Sol zit voor een groot deel van Sol's coderingscapaciteit. GPT-6 Luna, gerapporteerd op $ 0,10 / $ 0,50, is het model voor hoog-volume classificeren en routeren, met een gerapporteerde Coding Index van rond de 31.
Beschouw deze Coding Index-cijfers als indicatief en niet als exact. Ze zijn afkomstig uit aggregaties van derden en zullen veranderen.
Het aanbod van Google is het moeilijkst vast te stellen omdat rapportages elkaar tegenspreken. Gemini 3.1 Pro wordt gerapporteerd op $ 2 / $ 12 en is gericht op het zwaarste redeneerwerk. Gemini 3.6 Flash wordt gerapporteerd op $ 1,50 / $ 7,50, uitgebracht rond juli 2026, met een 1M context window, een Intelligence Index gerapporteerd rond de 50, SWE-Bench Pro gerapporteerd rond 58,7% en een doorvoer gerapporteerd van nabij 280 tokens per seconde, wat het positioneert als een krachtig maar goedkoop werkpaard voor codering. Gemini 3.1 Flash-Lite wordt gerapporteerd rond $ 0,25 / $ 1,50 voor het onderste niveau. Als u 3.6 Flash niet kunt bevestigen in uw account, is de algemeen beschikbare Gemini 3.5 Flash het veilige alternatief.
De versienummering van Grok is onzeker. Grok 4.3 op ongeveer $ 1,25 / $ 2,50 is de meest geciteerde configuratie, en de lage outputprijs is opvallend. Nieuwere Grok 4.6- en Grok 5-versies worden gerapporteerd maar zijn nog niet definitief. Behandel de versie als onzeker en verifieer rechtstreeks bij xAI voordat u productieverkeer hiernaartoe routeert.
Voor teams die zelf willen hosten of kosten tot een minimum willen beperken: Meta Llama 4 Maverick wordt gerapporteerd rond $ 0,20 / $ 0,60 en Scout rond $ 0,11 / $ 0,34, beide open-weight en geschikt voor self-hosting. DeepSeek V4 wordt gerapporteerd in een bereik van ongeveer $ 0,22 tot $ 0,66 en is gepositioneerd voor kostenefficiënt redeneren en coderen. Mistral Large 3 wordt gerapporteerd rond $ 0,50 / $ 1,50. Deze zijn vooral van belang wanneer datalokalisatie (data residency) of puur economische aspecten de beslissing bepalen.
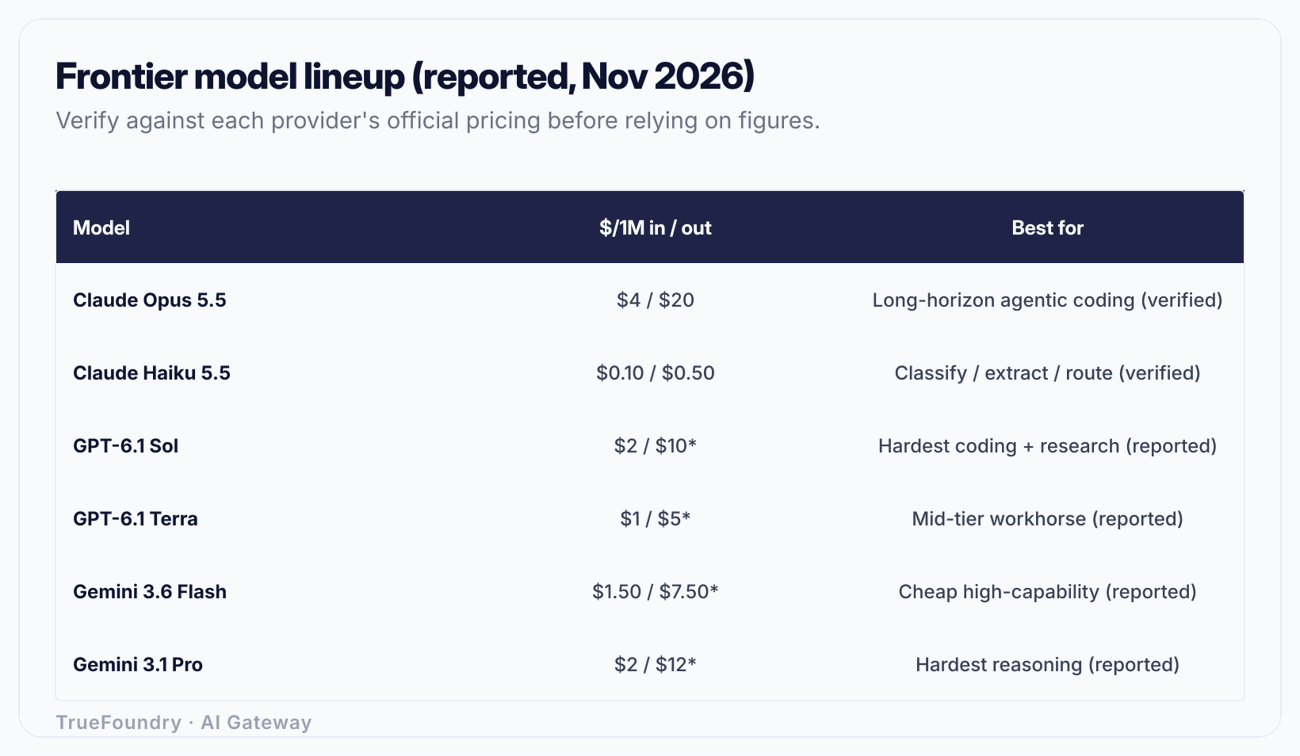
Prijzen/benchmarks zoals gerapporteerd per november 2026; verifieer deze op de officiële prijzenpagina van elke provider voordat u er op vertrouwt — modelspecificaties veranderen frequent.
Stop met het kiezen van één model. Begin met het classificeren van uw verkeer en koppel elke klasse vervolgens aan een niveau en een kostenstrategie. Vier categorieën dekken vrijwel alles af.
Dit zijn hoog-volume taken met lage ambiguïteit: een ticket labelen, een datum uit een document halen, bepalen welke prompt-branch moet worden uitgevoerd. Hiervoor is geen vlaggenschip nodig. Een klein model (Haiku 5.5, GPT-6 Luna, Gemini 3.1 Flash-Lite) van ongeveer $ 0,10 tot $ 0,25 per miljoen inputtokens verwerkt deze taken prima, en omdat de output kort is, zijn de kosten per request minuscuul. Kostenstrategie: minimaliseren. Dit is waar routering naar het goedkope niveau zichzelf terugbetaalt.
Chat voor gebruikers vereist een redelijke kwaliteit en lage latency, maar zelden het diepgaandste redeneerwerk. Een model uit het middensegment (Sonnet 5.5, GPT-6.1 Terra, Gemini 3.6 Flash) is hier de optimaal presterende keuze. Kostenstrategie: balanceren. Let vooral op de outputprijs, omdat chat veel tokens genereert.
Bij het coderen in meerdere stappen, waarbij het model plant, tools aanroept, bestanden leest en een doel over meerdere opeenvolgende stappen voor ogen houdt, worden capaciteitsverschillen zichtbaar. Voor het zwaarste agentic werk is Opus 5.5 de bevestigde sterke standaard; GPT-6.1 Sol wordt gerapporteerd als een vergelijkbaar alternatief. Voor alledaagse codering waarvoor geen lange horizon nodig is, is een model uit het middensegment (Terra, Gemini 3.6 Flash, Sonnet 5.5) meestal voor 90% even goed tegen een fractie van de kosten. Kostenstrategie: indelen naar moeilijkheidsgraad. Routeer routine-aanpassingen naar het middensegment en escaleer de complexe agentic runs.
Juridische analyses, onderzoekssynthese, redeneren over grote documenten. Dit is de enige plek waar het loont te betalen voor een vlaggenschip (Astra, Gemini 3.1 Pro, Opus 5.5 of Fable 5.1 voor het zwaarste werk). Kostenstrategie: betaal voor kwaliteit, maar doseer het. Slechts een klein deel van het verkeer mag dit niveau bereiken; de routeringsregel fungeert als poortwachter.
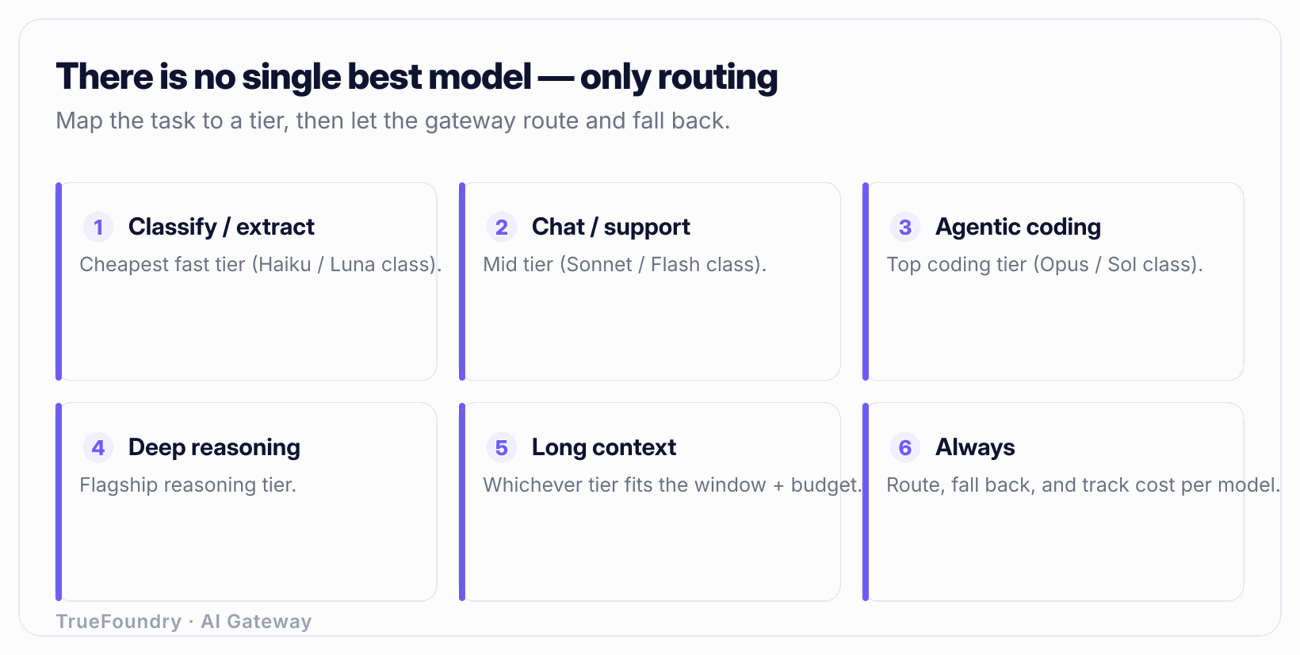
Prijzen/benchmarks zoals gerapporteerd per november 2026; verifieer deze op de officiële prijzenpagina van elke provider voordat u er op vertrouwt — modelspecificaties veranderen frequent.
Bekijk hoe TrueFoundry routeert, terugvalt bij fouten en kosten bijhoudt over elk model. Boek een demo.
Stel dat een product 10 miljoen modelrequests per maand verwerkt. Ga uit van een 80/15/5-verdeling: 80% eenvoudig (classificatie, extractie, routering), 15% chat en alledaagse codering, 5% complex redeneren en agentic coding. Neem een gemiddelde van 500 input- en 200 outputtokens per request voor de eenvoudige en chatniveaus, en meer voor het complexe niveau.
Als u alles naar één enkel vlaggenschip stuur op $ 4 / $ 20, betaalt u het vlaggenschiptarief voor alle 10M requests, inclusief de 8M die een model van $ 0,10 identiek zou hebben afgehandeld. Routeer in plaats daarvan op basis van de taak:
Het kleine niveau, dat het grootste deel van het volume uitmaakt, kost nu ongeveer 1/40e per inputtoken vergeleken met het vlaggenschip. Bij de meeste echte workloads verlaagt dit de totale rekening met ruimschoots meer dan de helft, terwijl de complexe requests precies op het model blijven dat ze nodig hebben. Het precieze bedrag hangt af van uw tokenmix, en dat is precies het punt: u meet het per niveau, wat inzicht vereist in de kosten per model. Zie LLM-kostentoewijzing en teambudgetten over hoe u teams hieraan kunt houden.
Het bovenstaande kader is alleen nuttig als u ernaar kunt handelen zonder bij elke wijziging opnieuw te hoeven deployen. Dat is waar een AI-gateway voor dient. Een gateway biedt één uniforme, OpenAI-compatibele API aan uw applicatie. Achter dat enkele endpoint configureert u naar welk daadwerkelijk model elke request gaat. De applicatie stuur elke keer dezelfde requeststructuur; de gateway bepaalt de bestemming.
Die ontkoppeling levert vier voordelen op die direct aansluiten op het kader:
Het punt van één enkele API is belangrijker dan het lijkt. Wanneer een nieuw model wordt uitgebracht (Terra verscheen eind oktober; er zal in december weer iets nieuws verschijnen), voegt u het toe als bestemming en verplaatst u het verkeer via een configuratiewijziging. De app merkt er niets van. Voor de onderliggende architectuur, zie wat is een LLM-proxy en hoe kiest u een AI-gateway.
De frontier eind 2026 is geen enkele piek met één duidelijke winnaar. Het is een reeks niveaus, en de teams die hun budget effectief besteden, zijn de teams die elk deel van hun verkeer koppelen aan het juiste niveau, in plaats van vlaggenschiptarieven te betalen voor eenvoudige classificatie. De namen van leveranciers zullen blijven veranderen, de prijzen blijven in beweging en de leaderboards verschuiven continu. Het beslissingskader blijft overeind: classificeer uw verkeer, koppel elke klasse aan een niveau en een kostenstrategie, en scherm het duurdere niveau af zodat alleen complexe requests het bereiken.
Zet dat kader om in een routeringsbeleid bij een gateway, en de vraag "welk model" is geen voortdurende discussie meer, maar een regel configuratie die u in enkele minuten aanpast. U routeert op basis van taak en kosten, valt terug als een provider hapert, catcht herhalingen en ziet precies wat elk model per request kost. Zo blijft u vooroplopen op de frontier zonder vast te zitten aan één specifiek punt daarop.
Stop met het vastpinnen op één model — routeer ertussen. Boek een demo.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.




Er is geen enkel beste LLM. Voor agentic coding op lange termijn is Opus 5.5 een bevestigde sterke standaardkeuze en wordt GPT-6.1 Sol gerapporteerd als sterke concurrent. Voor hoogvolume classificatie is een klein model zoals Haiku 5.5 of het gerapporteerde GPT-6 Luna beter, omdat het veel goedkoper en sneller is. Het beste model is het model dat past bij de taak en het budget, en daarom wint routeren het van kiezen.
Claude Opus 5.5 is door de eerste partij bevestigd als sterk voor agentic coding op lange termijn. GPT-6.1 Sol wordt gerapporteerd met een Coding Index rond 54 en GPT-6.1 Terra rond 48, beide uit aggregatie door derden per november 2026. Verifieer dit bij de officiele pagina's van OpenAI, en evalueer beide op uw eigen codebase voordat u zich vastlegt, aangezien benchmarkscores niet zuiver overdraagbaar zijn naar uw taken.
Dat hangt af van het niveau. Gemini 3.6 Flash wordt gerapporteerd op $1,50/$7,50, dicht bij Claude Sonnet 5.5 op een bevestigde $2/$10 voor input, maar met een hogere outputverhouding bij sommige workloads. Op het goedkoopste niveau is Claude Haiku 5.5 bevestigd vanaf $0,10/$0,50. Vergelijk op het niveau dat u daadwerkelijk zult gebruiken en bereken het tegen uw eigen input/output-verhouding.
Meerdere, gerouteerd op basis van de taak. één model gebruiken betekent te veel betalen voor eenvoudig verkeer en het risico dragen van een storing bij één provider. Een gateway stelt u in staat om meerdere modellen achter één API te gebruiken, zodat de complexiteit in de configuratie blijft en niet in uw applicatie.
Regelmatig. Nieuwe modelversies en prijsverlagingen verschijnen bij leveranciers ongeveer maandelijks. Elk niet-Claude-cijfer in dit bericht wordt gerapporteerd per november 2026 en moet bij de provider worden geverifieerd voordat u erop vertrouwt. Bouw voor verandering: plaats modelselectie achter een gateway, zodat een prijswijziging een configuratie-aanpassing is, geen herimplementatie.



Het laatste nieuws, artikelen en bronnen in je inbox