



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Een applicatie uit 2026 communiceert niet met één model — het communiceert met een heel menu aan modellen, variërend van frontier-, mid-tier-, goedkope tot zelfgehoste modellen. Routing is het beleid dat er per verzoek één kiest, terwijl het navigeert tussen drie doelen die elkaar tegenwerken: kosten, latency en kwaliteit. Deze post behandelt routingstrategieën van statische regels tot semantische routing en modelcascades, het moeilijke probleem van het meten van de kwaliteit waarop u wilt routeren, waarom routing geen failover is, en de instrumentatie die voorkomt dat een router u in het geheim verraadt.
Dinsdag bij Northwind. Omar, een platform engineer, was het kwartaal trots geweest op één getal: een daling van 41% in de LLM-rekening van het bedrijf. Hij had een router gebouwd. Eenvoudige classificatie- en intentie-detectie-aanroepen gingen naar een goedkoop model; alleen de echt moeilijke verzoeken — redenering in meerdere stappen, codegeneratie — bereikten het frontiermodel. Het werkte. Financiën merkte het op.
Toen kwam de rekening van de tweede week binnen, drie keer zo hoog als die van de eerste week, zonder toename in verkeer. Omar zocht het uit. Zijn cascade had een verifier — de output van het goedkope model werd op schema gecontroleerd, en bij een mislukte controle escaleerde het verzoek naar het frontiermodel. Een update aan de providerzijde hatte de outputformattering van het goedkope model subtiel veranderd, de schemacontrole begon bij de meeste antwoorden te mislukken, en de router had stilletjes ongeveer 90% van het verkeer geëscaleerd naar het duurste model. Niets gaf een foutmelding. Niets gaf een waarschuwing. De router deed precies wat hem was verteld; hij stopte alleen met doen wat Omar bedoelde. Het escalatiepercentage steeg al negen dagen, en niemand keek ernaar.
Routing is vaak een van de hefbomen met de hoogste impact op de kosten in een LLM-stack en een van de gemakkelijkste om ongemerkt verkeerd te doen. Deze post behandelt de strategieën, hun afwegingen en de instrumentatie die een router eerlijk houdt.
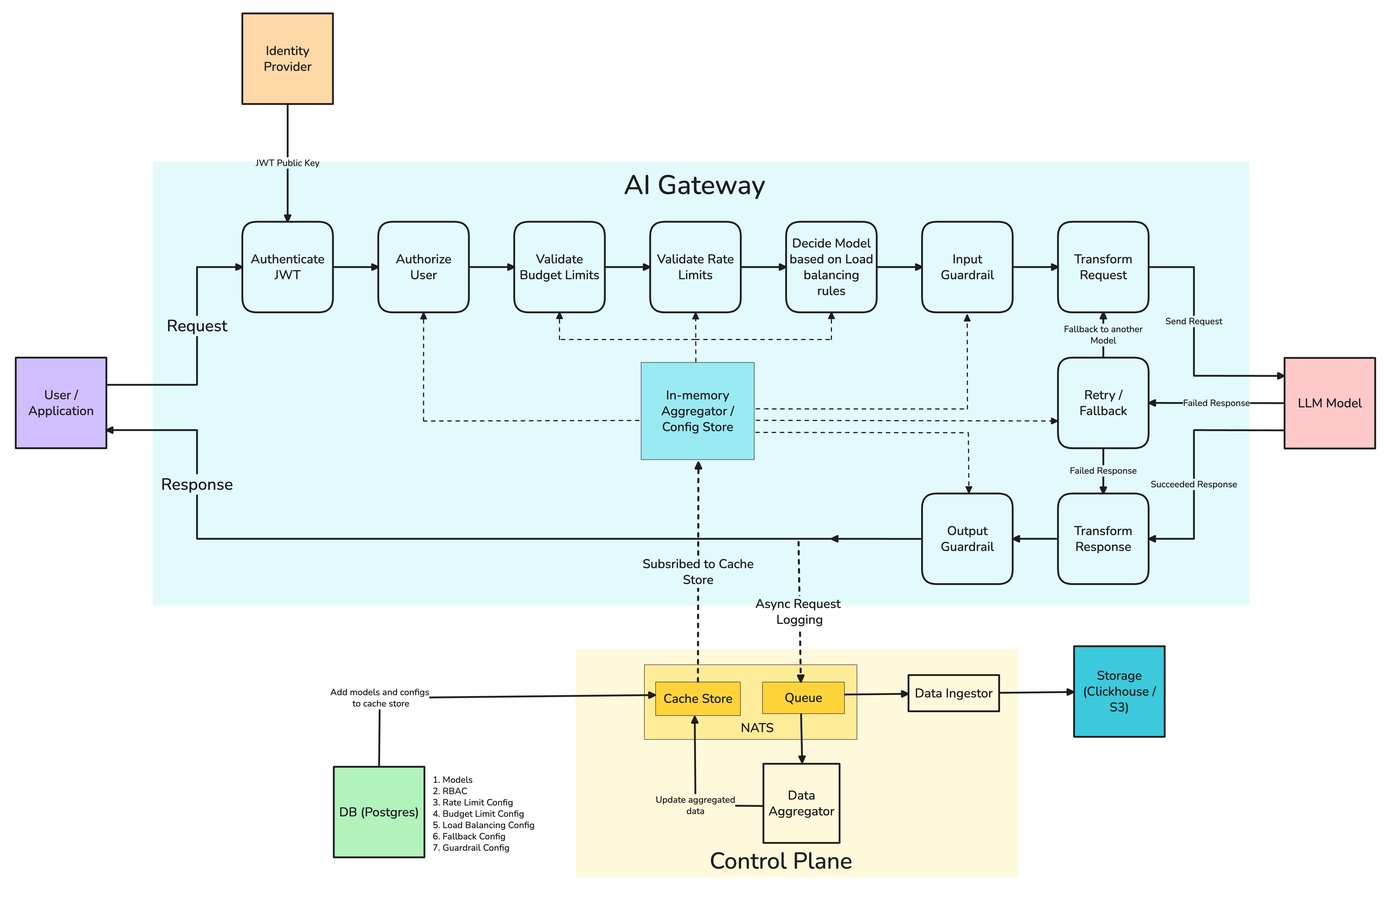
De routingstrategieën in deze post zijn geen abstracties — het is hoe TrueFoundry's AI Gateway is geconfigureerd. De routingconfiguratie matcht elk verzoek op model, op onderwerp (gebruiker, team of virtueel account) of op een X-TFY-METADATA-header, evalueert regels van boven naar beneden met "first-match-wins", en stuurt het verzoek naar een doelmodel — dit alles als YAML toegepast bij de gateway in plaats van vertakkingslogica in de app.
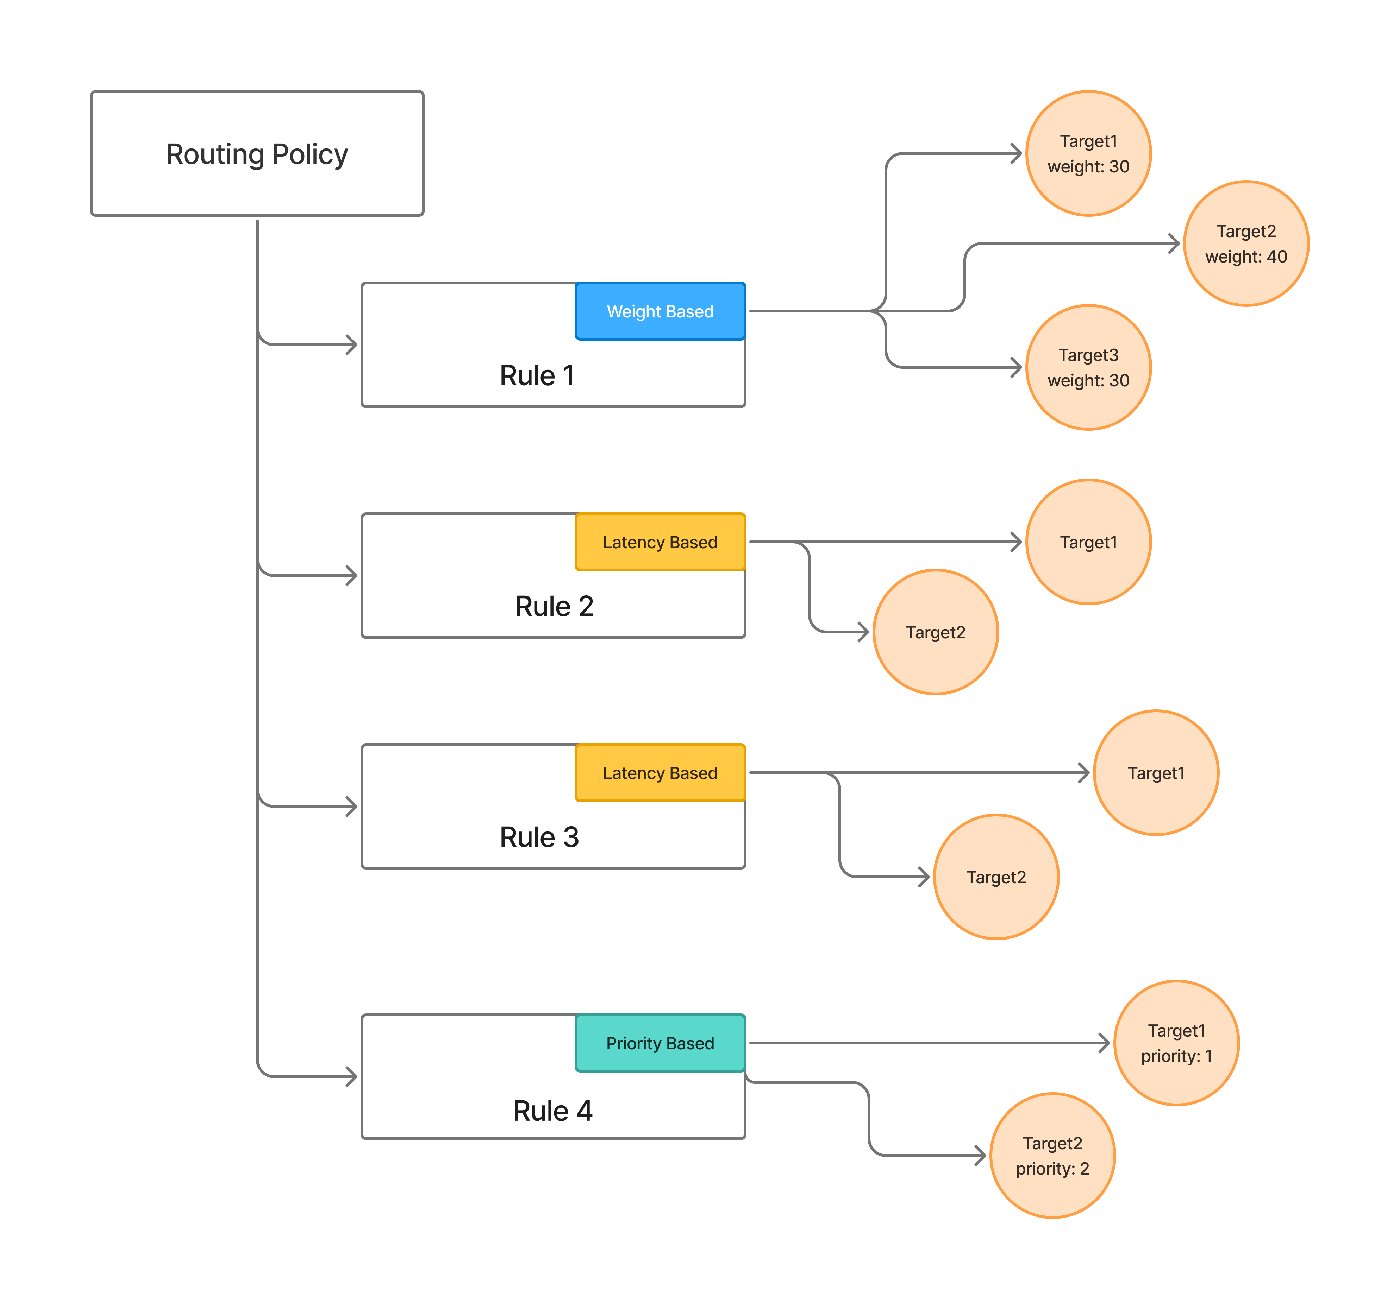
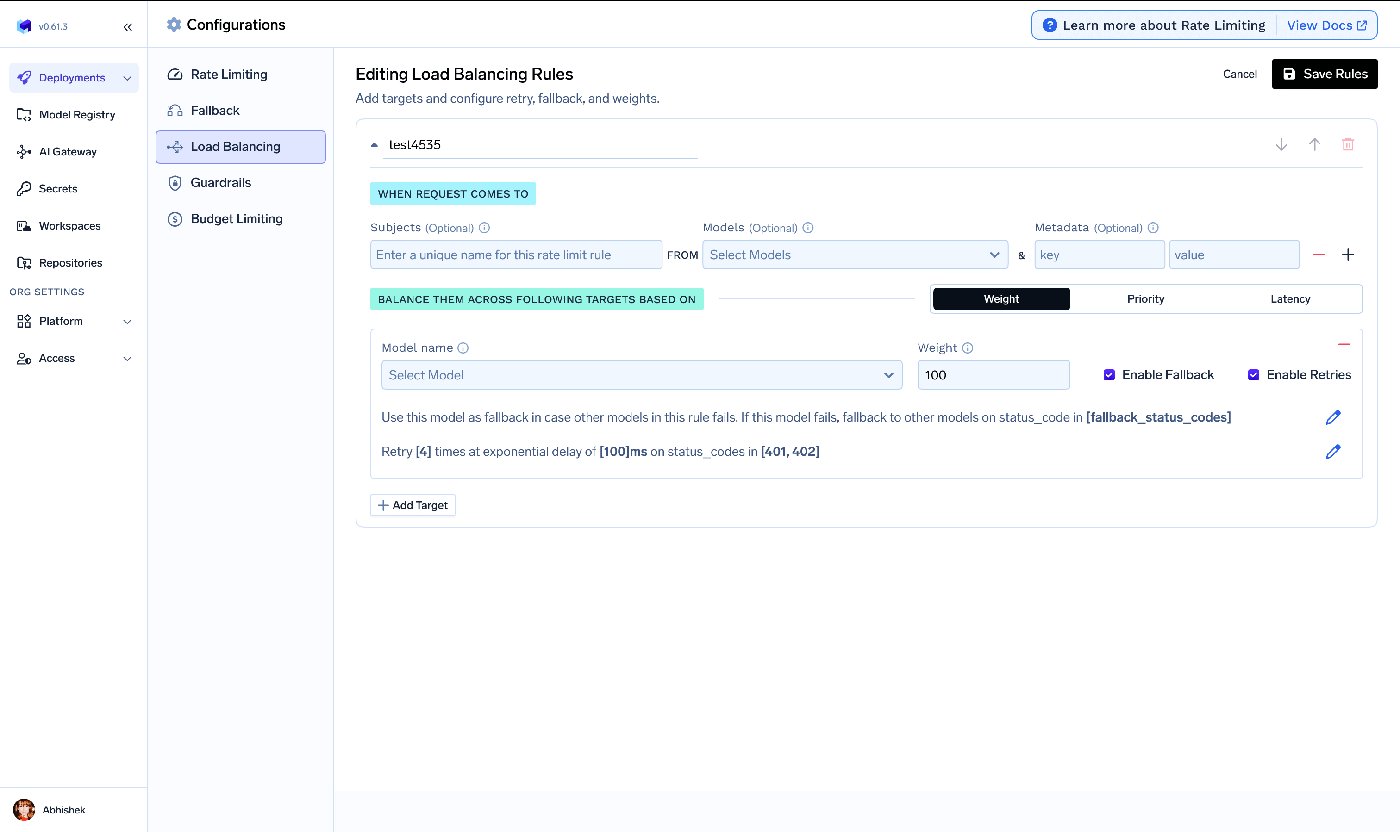
De drie strategieën komen overeen met de ladder in sectie 2: op gewicht gebaseerd voor verdelingen en canaries, op latency gebaseerd om het gezonde doel met de laagste latency te verkiezen, en op prioriteit gebaseerd voor een geordende voorkeur met fallback. Overrides per doel vangen ook het modelspecifieke prompt-probleem op dat in deze post wordt aangekaart — u kunt een verschillende prompt_version_fqn per doel toevoegen zodat elk model een prompt krijgt die ervoor is afgesteld — samen met retries en fallback per doel. (Voor nieuwe configuraties raden de documenten Virtual Models aan, die dezelfde strategieën, retries en fallbacks combineren met een duidelijker eigenaarschap en toegangsbeheer per model.)
Het aanroepen van de gateway vanuit een applicatie is een verandering van één regel voor alles wat al de OpenAI SDK gebruikt — dezelfde client, andere basis-URL en sleutel — en de routingbeslissing vindt plaats bij de gateway, niet in uw code. De applicatie kan ook een X-TFY-METADATA-header doorgeven, zodat de gateway routeert op taak, omgeving of tenant zonder voorwaardelijke codepaden:
De gateway aanroepen vanuit Python (OpenAI-compatibele API)
Een enterprise-app in 2026 heeft een menu aan modellen met zeer verschillende economische eigenschappen. Goedkope modellen (Claude Haiku 4.5 tegen ongeveer $ 1 per miljoen input-tokens) zijn meerdere keren goedkoper dan frontiermodellen bij de huidige standaardtarieven, en in de praktijk vaak sneller qua latency. Mid-tier modellen (Sonnet 4.6 tegen $ 3 per miljoen input-tokens) zitten daartussenin. Zelfgehoste open-weight modellen (Llama, Mistral) ruilen tarieven per token in voor vaste GPU-capaciteit en datacontrole — goedkoper bij aanhoudend hoge benutting, maar duur wanneer de benutting laag is. Elk model heeft ook een ander kwaliteitsprofiel per taak: een model dat uitstekend is in code, kan matig zijn in extractie, en vice versa.
Routing is het beleid dat elk inkomend verzoek koppelt aan een van deze modellen. De drie doelen werken elkaar tegen: het goedkoopste model is zelden het hoogste in kwaliteit, de snelste is niet altijd de goedkoopste, en het kwalitatief beste model voor een moeilijke taak is verspilling bij een eenvoudige taak. De naïeve standaard — alles naar het beste frontiermodel sturen — maximaliseert de kwaliteit, maar is de duurste optie en vaak de langzaamste, waarbij een model voor redenering in meerdere stappen wordt toegepast op verzoeken die een goedkoop model correct zou beantwoorden in een fractie van de tijd en kosten. Routing is waar die kosten/kwaliteit-grens wordt genavigeerd, verzoek voor verzoek.
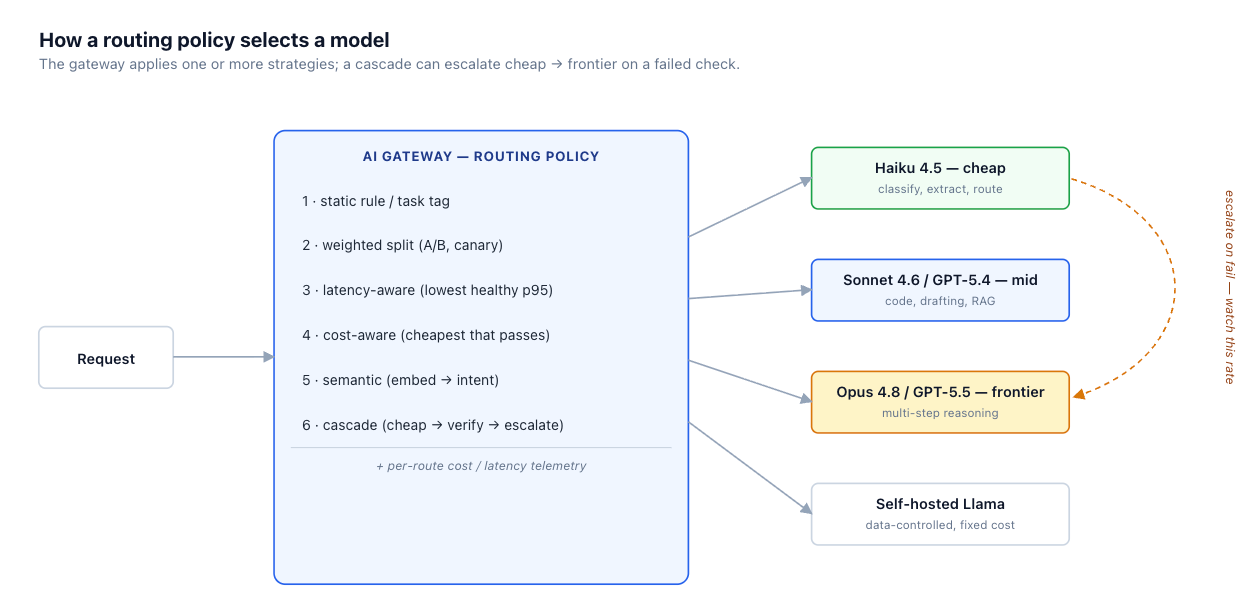
Routingstrategieën vormen een ladder. Elke trede voegt functionaliteit en kosten toe, en de juiste plek om te stoppen is waar het gemeten voordeel de toegevoegde complexiteit niet langer rechtvaardigt.
Statisch / op regels gebaseerd. Routeer op endpoint, header of een taaktag die de aanroeper instelt — classificatie gaat naar het goedkope model, codegeneratie naar de mid-tier. Sub-milliseconde, deterministisch en triviaal te debuggen. Dit werkt wanneer de aanroeper het taaktype al kent, wat vaker voorkomt dan teams denken.
Gewogen / load-balanced. Verdeel verkeer op basis van percentages over modellen. Dit is de basis voor het A/B-testen van een nieuw model en voor canary-rollouts — stuur 5% van het verkeer naar het nieuwe model, bekijk de metrieken en schaal op als ze standhouden.
Latency-bewust. Wanneer meerdere modellen acceptabel zijn voor een verzoek, routeer dan naar degene met de laagste gezonde p95 op dit moment. Handig voor latency-gevoelige paden waar elk van een paar modellen te gebruiken is.
Kostenbewust. Kies het goedkoopste model dat voldoet aan een kwaliteitsnorm voor de taak. Dit vereist kennis van de kwaliteitsnorm per taak (sectie 5), wat het moeilijke gedeelte is.
Wees voorzichtig met wat "goedkoopste" betekent: routeer op de totale kosten van het verzoek, niet op het nominale tarief per input-token. Het werkelijke cijfer is de verwachte input-tokens plus verwachte output-tokens, aangepast voor het cache-hitpercentage, de retry- en hedge-waarschijnlijkheid, de cascade-escalatiewaarschijnlijkheid en eventuele regionale, prioriteits- of snelheidsvermenigvuldigers. Tokenizers verschillen ook per familie — Anthropic merkt op dat Opus 4.7 en later tot 35% meer tokens kan uitstoten voor dezelfde tekst — dus een identieke prompt levert verschillende factureerbare aantallen op bij verschillende modellen. Schat de routekosten op basis van echte traces, niet door een tariefkaart in een statische tabel over te nemen.
De laatste twee treden — semantische routing en modelcascades — krijgen hun eigen secties. De meeste productierouters zijn een combinatie: statische regels voor bekende taaktags, een kosten- of latency-bewuste standaard voor al het andere, en een afzonderlijke fallback-lijst voor beschikbaarheid. De onderstaande configuratie is ter illustratie; het exacte schema is gateway-specifiek.
Illustratief routingbeleid (conceptueel — exact schema is gateway-specific)
Zo ziet de bovenstaande ladder eruit in TrueFoundry's AI Gateway, waar deze strategieën daadwerkelijk worden uitgevoerd. Routing is een YAML-gateway-load-balancing-config: elke regel matcht een deel van het verkeer — op model, team of een X-TFY-METADATA-header — en routeert over de doelen met behulp van weight-based-, latency-based- of priority-based-selectie. Het toevoegen van een model of het wijzigen van een verdeling is een configuratiewijziging, geen nieuwe uitrol:
Hoe TrueFoundry deze strategieën uitdrukt (gateway-load-balancing-config)
Elk doel kan ook retries, een fallback-lijst en zelfs een prompt per doel (prompt_version_fqn) bevatten, zodat elk model een prompt krijgt die ervoor is afgesteld. Omdat één bestand zowel het routingbeleid als de fallback-keten uitdrukt, blijven de twee gescheiden en afzonderlijk waarneembaar — de grens die sectie 6 trekt. Het volledige schema staat in de routing config docs.
Hetzelfde bestand verwerkt een canary-rollout — het patroon van gewogen verdeling dat in deze post wordt aanbevolen voor het A/B-testen van een nieuw model — zonder vertakkingen aan de app-zijde:
Canary-rollout met op gewicht gebaseerde routing (uit de documentatie)
Een paar specifieke TrueFoundry-functies die het vermelden waard zijn voor de routingbeslissingen in deze post: Virtual Models zijn de aanbevolen vervanging door de gateway voor de wereldwijde routingconfiguratie — ze bundelen dezelfde gewicht/latency/prioriteit-strategieën, retries en fallbacks achter één logische modelnaam met eigen toegangsbeheer, zodat een route kan worden gepromoveerd of gewijzigd zonder elke aanroeper aan te passen. Exacte en semantische caching bevinden zich vóór de routingbeslissing en retourneren een opgeslagen antwoord voor herhaalde query's, wat zowel de kosten als de tail-latency verlaagt bij leesintensieve workloads. En dezelfde routingconfiguratie matcht op X-TFY-METADATA, zodat één regelbestand dev/prod en routing per tenant kan bedienen — de routinglaag leest wat de client heeft gestuurd in plaats van dat de client de routekeuze codeert.
Statische tags gaan ervan uit dat de aanroeper de taak kent. Soms is dat niet zo — een algemene assistent biedt één endpoint en alles komt daar binnen. Semantische routing leidt de taak af uit het verzoek zelf: embed de prompt, vind het dichtstbijzijnde intentie-zwaartepunt (of voer een kleine classifier uit), en routeer op basis van de afgeleide intentie.
Semantische routing — embed het verzoek, routeer op basis van de dichtstbijzijnde intentie
De kosten bestaan uit een embedding-aanroep (ongeveer 5–20 ms en kleine kosten per token) plus een goedkope classifier-stap. Waar we eerlijk over moeten zijn, is wanneer dit zijn waarde bewijst: alleen wanneer de intentie nog niet bekend is op de plaats van aanroepen. Als de aanroepende code een header kan instellen zoals x-task=classify, is dat gratis, deterministisch en beter. Semantische routing hoort thuis bij de ingang van een algemene assistent waar verzoeken ongecategoriseerd zijn — niet vastgeplakt aan een interne pijplijn die al weet waar elke aanroep voor dient. De nadelen: zwaartepunten en classifiers veranderen naarmate de intenties van het product veranderen en hebben onderhoud nodig, en een verkeerde classificatie routeert naar het verkeerde model — dus een semantische router heeft nog steeds een verstandige standaardinstelling en een fallback nodig. Waar de embedding- en classificatiestap ook wordt uitgevoerd, de gateway is de natuurlijke plaats om de afgeleide intentie en het geselecteerde model vast te leggen in de trace, wat de zichtbaarheid per route is die TrueFoundry's AI Gateway al biedt voor de eenvoudigere strategieën — en wat een verkeerde routing omzet in iets dat te debuggen is in plaats van onzichtbaar blijft.
Een cascade probeert eerst een goedkoop model, controleert het resultaat en escaleert alleen naar een sterker model als de controle mislukt. De controle kan een schemacontrole zijn (ontleedt de output volgens de verwachte structuur?), een signaal van betrouwbaarheid of zelfconsistentie, of een judge-model.
Eerst-goedkoop cascade met schemacontrole
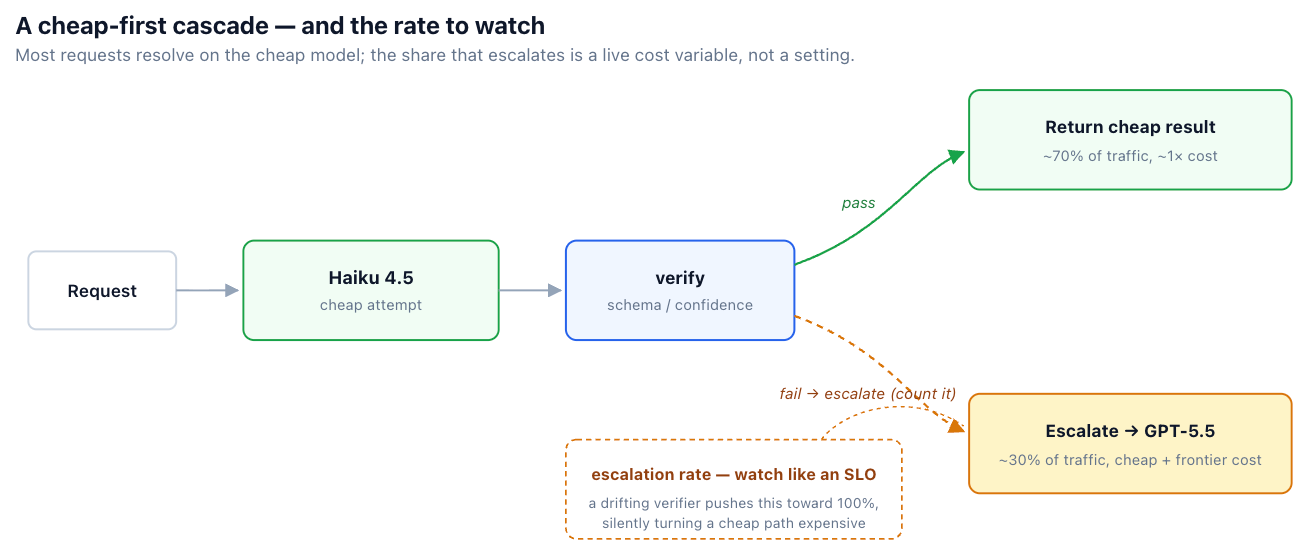
De economische voordelen kunnen overtuigend zijn. Als de goedkope tier de meeste verzoeken afhandelt, dalen de gemiddelde kosten in de richting van de prijs van de goedkope tier. Als illustratief model: bij het verschil van ongeveer 5× in het standaardtarief tussen Haiku en de genoemde frontiermodellen, brengt een afhandelingspercentage van 70% bij de goedkope tier de gemiddelde kosten op ongeveer de helft van overal-frontier — zelfs na het betalen van de goedkope poging voor de 30% die escaleert. (Vergroot het verschil naar 10×, zoals sommige premium-, pro- of prioriteitstiers doen, en dezelfde cascade komt dichter bij 40% uit.) De exacte besparingen hangen af van uw afhandelingspercentage en het werkelijke prijsverschil, dus meet ze in plaats van ze aan te nemen.
Een cascade voegt ook de latency van het goedkope model toe aan elk geëscaleerd verzoek — u betaalt de tijd van de goedkope aanroep, en vervolgens de tijd van de frontier-aanroep. Voor interactieve, latency-gevoelige paden kan die dubbele stap de verkeerde afweging zijn; cascades blinken uit bij doorvoergeoriënteerde of asynchrone workloads waar de winst in gemiddelde kosten opweegt tegen de tail-latency bij escalaties.
Routeren op kosten of latency is eenvoudig omdat beide rechtstreeks waarneembaar zijn. Routeren op kwaliteit is moeilijker, omdat kwaliteit moet worden gemeten voordat het kan worden geoptimaliseerd. Drie benaderingen, in opkomende volgorde van nauwkeurigheid en kosten:
Offline eval-sets. Een samengestelde, gelabelde set per taaktype. Voer elk kandidaatmodel hierop uit en bouw de routingtabel op uit de resultaten — dit model voor SQL, dat model voor samenvattingen. Goedkoop om herhaaldelijk uit te voeren, maar slechts zo representatief als de eval-set zelf.
Online LLM-as-judge. Neem steekproeven van productieverkeer en beoordeel antwoorden met een judge-model. Dichter bij de echte distributie, maar het voegt kosten en latency toe, en de judge is zelf ook niet onfeilbaar — een judge die de dode hoeken van de generator deelt, zal deze goedkeuren.
A/B-testen tegen bedrijfsstatistieken. De gouden standaard: routeer een deel van het verkeer naar een kandidaat en meet de metriek die u echt belangrijk vindt — afhandelingspercentage, duim omhoog, conversie verderop in het proces. Langzaam en arbeidsintensief, maar het meet het daadwerkelijke doel in plaats van een afgeleide waarde.
De waarschuwing die deze methoden verbindt: routeer niet op gevoel. Een goedkoop model dat "wel goed lijkt" in een demo kan een metriek verderop in de keten wekenlang ongemerkt verslechteren. Koppel elke routingwijziging aan een gemeten kwaliteitsgrens en onthoud dat kwaliteit taakspecifiek is — een enkele positie op een leaderboard is geen routingtabel, omdat het model dat bovenaan een algemene benchmark staat, matig kan zijn bij uw specifieke extractietaak. Het signalement uit de productie dat alle drie de methoden nodig hebben — welk model welk verzoek heeft afgehandeld en wat er daarna gebeurde — is wat de gateway al registreert; de traces per route van TrueFoundry zijn een natuurlijke bron voor de offline eval-sets en online steekproeven hierboven.
Eén ding waar alle drie de methoden rekening mee moeten houden: een productierouter ziet alleen het model dat hij heeft gekozen. Routeer een verzoek naar Haiku en u leert nooit of Sonnet, Opus of GPT-5.5 het beter zou hebben gedaan — het tegenovergestelde scenario is onzichtbaar. Om de routingtabel eerlijk te houden, neemt u steekproeven van verkeer voor schaduwevaluatie, speelt u echte verzoeken offline opnieuw af via de andere kandidaten, of voert u periodieke champion/challenger-tests uit. Zonder dat gebruikt een router ongemerkt een verouderd beleid en merkt niet meer op wanneer een ander model beter, goedkoper of veiliger is geworden voor een taak.
Routing en failover delen mechanismen — een lijst van kandidaatmodellen en een beleid om daartussen te kiezen — waardoor ze gemakkelijk te verwarren zijn. Het zijn verschillende doelen, en het samenvoegen ervan veroorzaakt incidenten.
Routing is optimalisatie: wanneer alle kandidaten gezond zijn, kies dan de beste op basis van kosten, latency of kwaliteit. Failover is beschikbaarheid: wanneer het gekozen model niet beschikbaar is of een timeout geeft, val dan terug op een ander model zodat het verzoek alsnog slaagt (het onderwerp van de volgende post in deze reeks). Het verschil is operationeel van belang. Een fallback naar een goedkoper model dat wordt geactiveerd door een storing kan de kwaliteit ongemerkt verslechteren, en u wilt dat dat wordt geregistreerd als "we zijn teruggevallen omdat het primaire model uitviel", niet verkeerd begrepen als een bewuste kostenbeslissing. Omgekeerd moet een tijdelijke 500-fout een failover activeren, geen permanente routingwijziging. Houd de twee beleidsregels gescheiden en afzonderlijk waarneembaar: "gerouteerd naar X vanwege kosten" en "teruggevallen op Y omdat X niet gezond was" zijn verschillende gebeurtenissen die er in uw traces anders uit moeten zien. Een gateway zoals die van TrueFoundry is waar beide naast elkaar bestaan zonder te vervagen — het routingbeleid en de fallback-keten worden geconfigureerd en getraced als afzonderlijke zaken.
Routinglogica kan in de applicatie zitten, maar de gateway is om twee redenen de meest logische plek. Ten eerste normaliseert het de provider-API's al, waardoor het wisselen van een route van het ene model naar het andere een configuratiewijziging is in plaats van een codewijziging — en overstappen van bijvoorbeeld een OpenAI-model naar een Anthropic-model betekent niet dat u de verzoeksopbouw opnieuw moet schrijven. Ten tweede bevat het al de kosten- en latency-telemetrie waarvan routingbeslissingen afhankelijk zijn; de gegevens die u nodig hebt om goed te routeren, zijn de gegevens die de gateway al verzamelt.
Het centraliseren van routing bij TrueFoundry's AI Gateway betekent één beleid dat op alle services wordt toegepast, één plek om een nieuw model A/B te testen, en één plek om de gemiddelde kosten en het escalatiepercentage van de cascade in de gaten te houden waar de inleiding over ging. De gateway biedt routingregels, gewogen load balancing en fallback-ketens voor zowel gehoste als zelfgehoste modellen via een uniforme, OpenAI-compatibele API, en de kosten en latency per route komen terecht in hetzelfde toewijzingsoverzicht uit de post over kostentoewijzing. De taakverdeling is helder: de gateway routeert en geeft u de cijfers; de applicatie blijft eigenaar van de definitie van kwaliteit en de eval-sets die bepalen welk model elke taak wint.
Routing is niet gratis, en de overhead verschilt per strategie. Een statische regel wordt geëvalueerd in ruim minder dan een milliseconde. Latency-bewuste routing heeft live p95-telemetrie nodig, wat goedkoop is om te lezen. Semantische routing voegt de embedding-aanroep toe — ongeveer 5–20 ms — plus een lichte classifier. Een cascade voegt de volledige latency van het goedkope model toe aan elk verzoek dat escaleert.
Het ontwerpprincipe is om de routingbeslissing goedkoop te houden ten opzichte van de modelaanroep die erop volgt. Een regel van minder dan een milliseconde is ruis vergeleken met een generatie van 500 ms of meer; een semantische stap is prima betaalbaar bij de ingang van een assistent; de dubbele latency van een cascade bij escalaties is de factor die op interactieve paden kritisch moet worden bekeken. En voeg niet aan elke route een judge-modelaanroep toe voor kwaliteitsmeting, tenzij de cascade of kwaliteitswinst het betalen voor een tweede modelaanroep per verzoek duidelijk rechtvaardigt — het nemen van steekproeven van een fractie van het verkeer voor online evaluatie geeft u meestal het signaal zonder de kosten per verzoek. Omdat de routingbeslissing en de modelaanroep op dezelfde trace zitten, is de overhead van de beslissing zelf meetbaar in plaats van aangenomen: TrueFoundry's AI Gateway registreert de latency per route, zodat u kunt controleren of de semantische stap of de cascade-stap daadwerkelijk zo goedkoop is als u verwacht.
Moet routing in de gateway of in de applicatie zitten?
De mechanica hoort thuis in de gateway — deze normaliseert provider-API's en beheert de kosten/latency-telemetrie, zodat routing een kwestie van configuratie wordt in plaats van code. De applicatie blijft eigenaar van de kwaliteitsdefinitie en de eval-sets die bepalen welk model het beste is per taak. Zie het zo: de gateway beslist waar het verzoek naartoe wordt gestuurd op basis van een policy; de app beslist wat die policy moet zijn.
Gaat het routen naar goedkopere modellen niet ten koste van de kwaliteit?
Alleen als je routeert op gevoel. Het hele punt van sectie 5 is dat een routingwijziging per taak een gemeten kwaliteitsgate moet passeren voordat deze live gaat. Een goedkoop model dat aan de norm voldoet voor classificatie is geen kwaliteitsachteruitgang; een goedkoop model waarvan zonder meting wordt aangenomen dat het "goed genoeg" is, is hoe een achteruitgang ontstaat.
Hoe kies ik een cascade verifier?
Schemavalidatie is de goedkoopste en meest betrouwbare verifier wanneer de output gestructureerd is — het is deterministisch en vereist geen extra model call. Voor open-ended outputs is een judge-model bekwamer, maar dit kost een tweede call en kan erin doorslaan. Welke je ook kiest, instrumenteer de escalation rate en stel alerts in, want een afwijkende verifier is een veelvoorkomende manier waarop een cascade ongemerkt een kostenprobleem wordt.
Voegt semantic routing te veel latency toe?
Het voegt ongeveer 5–20 ms toe voor de embedding plus een goedkope classificatiestap — meestal acceptabel vergeleken met een generatie van meerdere honderden milliseconden, hoewel het niet gratis is voor classificatie onder de 100 ms of interne paden met een hoge QPS. Meet het dus in je eigen pad in plaats van aan te nemen dat het verwaarloosbaar is. De echte vraag is niet latency, maar of je het überhaupt nodig hebt: als de caller de taak kan labelen met een header, is dat gratis en deterministisch, en verdient semantic routing pas zijn plek wanneer verzoeken ongelabeld binnenkomen.
Hoe verhoudt dit zich tot cost attribution en failover?
Routingbeslissingen en de daaruit voortvloeiende blended cost worden gekoppeld aan dezelfde attribution per trace die in de kosten-post is behandeld, zodat je kunt zien welke routes de uitgaven drijven. Failover is een ander vraagstuk — beschikbaarheid, geen optimalisatie — dat in de volgende post wordt behandeld; houd deze twee als afzonderlijke, apart gelogde gebeurtenissen, zodat een door een storing veroorzaakte fallback er nooit uitziet als een kostenbeslissing.
Omar's router was niet verkeerd; hij was niet-geobserveerd. De strategieën in deze post zijn alleen zo veilig als de cijfers die je erbij in de gaten houdt — de escalation rate, de blended cost per route, de kwaliteitsgate bij elke modelwijziging. Routeer agressief, maar instrumenteer eerst.
TrueFoundry's AI Gateway is een control plane op enterprise-niveau die zich bevindt tussen jouw applicaties en 1.600+ modellen — waaronder OpenAI, Anthropic, Google, AWS Bedrock, Azure OpenAI en je eigen self-hosted modellen — achter één enkele OpenAI-compatibele API. Het zet de routingstrategieën uit deze post om in configuratie in plaats van code: weight-based, latency-based en priority-based routing, model cascades, fallbacks en prompt overrides per target, allemaal uitgedrukt als YAML en toegepast per route.
Omdat de gateway elke provider al normaliseert en cost, latency en verzoek/routing-metadata per route registreert, is dit ook de plek waar routing meetbaar wordt — één centrale plek om een model te A/B-testen, de escalation rate van een cascade te monitoren en blended cost toe te wijzen. Combineer die traces met de eval- en feedbacksignalen die je elders verzamelt en hetzelfde overzicht wordt ook een kwaliteitsoverzicht. Het voegt exact en semantic caching, RBAC, budgetten, rate limits en guardrails toe, implementeert als SaaS, in je VPC, on-prem, of air-gapped met SOC 2-, HIPAA- en ITAR-compliance, en is erkend in Gartner's Market Guide voor AI Gateways. Bekijk de routing and load-balancing docs of het AI Gateway overview om er dieper in te duiken.
Northwind en Omar zijn ter illustratie. Modelnamen en prijzen per token weerspiegelen de openbare tarieven van de providers per juni 2026 en veranderen in de loop van de tijd. Kosten- en latencycijfers — het prijsverschil van ~5×, het voorbeeld van 70% goedkope afhandeling, de embedding-overhead van 5–20 ms — zijn representatieve aannames om de afwegingen te illustreren, geen metingen; benchmark routingstrategieën tegen je eigen verkeer en eval-sets voordat je productiepolicy vastlegt.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















