



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Multi-provider LLM-facturen zijn eenvoudig te betalen, maar lastig toe te wijzen. De console van Anthropic toont één bedrag per API key; die van OpenAI toont één bedrag per project. Die cijfers zijn exact. Ze geven alleen geen antwoord op de vraag wie het heeft uitgegeven, aan welke app, binnen welke functie en ten laste van wiens budget. Deze blogpost legt uit hoe een toewijzingslaag op gateway-niveau die kloof dicht — het metadata-taggingschema, de formule voor kosten per trace over verschillende providers heen, de aggregatiepipeline die miljarden spans omzet in een dagelijkse team-rollup, zachte en harde budgethandhaving met een reëel concurrency-model, en het chargeback-rapport dat daar uit voortvloeit.
Woensdagmiddag bij Northwind. Sarah, VP Platform, krijgt het Slack-bericht: "Ik heb de AI-kostengespecificeerd per team nodig voor de budgetvergadering van Q2 op vrijdag." Ze opent de Anthropic-console. Eén regel: $ 47.234,12 month-to-date, gefactureerd op sk-ant-prod-northwind-shared. Die key wordt gebruikt door ruim vijftig engineers, verdeeld over vier teams en tientallen applicaties. Het getal is exact. Maar het is ook nutteloos voor het gesprek dat ze op vrijdag moet voeren — welk team, welke applicatie, welke feature en welke klant verantwoordelijk is voor de factuur.
Sarah's opties zijn niet best. Ze kan de key in vieren splitsen, maar raakt daarmee de cross-provider routing van de gateway als nevenschade kwijt. Ze kan elke teamlead om een schatting vragen en dit handmatig afstemmen — een getal dat er zomaar dertig procent naast kan zitten. Of ze kan het antwoord halen uit de plek waar het werk al is vastgelegd: de trace store van de gateway. Deze blogpost legt uit hoe die derde optie werkt.
Het structurele probleem met provider-eigen facturering is dat het aggregeert op het niveau van de inloggegevens (credentials), niet op teamniveau. Anthropic groepeert uitgaven per API key en organisatie; OpenAI per project; Azure per deployment en resourcegroep; AWS Bedrock per IAM-rol en account. Geen van deze niveaus komt overeen met de operationele eenheid die je daadwerkelijk wilt belasten — team, applicatie, feature, klant.
De klassieke tijdelijke oplossing — één credential per team — werkt wel, maar doet de meerwaarde van een gateway teniet: de routinglogica die Anthropic kiest voor complexe requests en Haiku voor eenvoudige, die terugvalt op Azure wanneer Anthropic overbelast is, en die de belasting verdeelt over regionale deployments. Dit vereist allemaal dat de gateway credentials beheert voor elke provider. Keys per team dwingen providerrelaties per team af. Instrumentatie op applicatieniveau is het andere dooplopende spoor — het werkt prima in gloednieuwe codebases, maar niet voor een agent die drie providers aanroept via twee SDK-versies en een geforkte LangChain. Toewijzing hoort thuis bij de gateway, omdat elke provider-call daar sowieso doorheen routed.
Het patroon is overzichtelijk: elk request naar de gateway bevat een JSON-object dat beschrijft wat de aanroeper is, voor wie ze bellen en wat ze doen. De gateway slaat dit object op in de trace, samen met de gen_ai-attributen, en projecteert een geselecteerde subset van velden op de metric labels die worden gebruikt voor aggregatie.
HTTP — applicatie stelt de metadata-header in op elke gateway-call
De velden zijn bewust heterogeen. Velden met een lage cardinaliteit — team, app, feature, env — laten zich goed projecteren naar metric labels. Velden met een hoge cardinaliteit — user_id, pipeline_id — zouden de opslag van metrics laten exploderen als ze geprojecteerd worden, en blijven daarom alleen op de trace staan. De gateway moet het verschil kennen: velden voor tag-for-aggregation vormen een expliciete allow-list (een typische configuratie: team, app, feature, env, model_class) die deel uitmaakt van de dagelijkse rollup keyspace; al het andere is tag-for-audit, opgeslagen op de trace voor forensisch onderzoek en ad-hoc queries.
De applicatie stelt de metadata één keer in, bij de buitenste call. De gateway verspreidt deze over de gehele span-tree — inclusief over fallback-scenario's (een fallback naar een andere provider behoudt dezelfde metadata) en over agent-loops met meerdere slagen (elke tool-call bevat dezelfde metadata als de bovenliggende call). Overerving gebeurt automatisch; het team hoeft de metadata niet handmatig door te geven bij elke aanroep.
Kosten worden berekend bij het sluiten van de span, niet bij het opmaken van de factuur. De gateway beheert een prijsmatrix met versiebeheer per (provider, model)-paar en pas deze toe op de tokens die in de laatste response-chunk zijn gerapporteerd. De uitvoer wordt opgeslagen als gen_ai.usage.cost_usd op de provider-span en opgerold naar de root.
Python — kostenberekening bij het sluiten van de provider-span, volledige formule met meerdere posten
Twee details zijn belangrijk en worden snel over het hoofd gezien. Ten eerste heeft de prijsmatrix een datumstempel voor versiebeheer, omdat providers prijzen aanpassen en de factuur moet overeenkomen met de tarieven die gelden op het moment van het request — bereken historische traces nooit opnieuw met de tarieven van vandaag. Ten tweede worden audio- en afbeeldingsinputs geprijsd per minuut en per afbeelding, niet per token; deze moeten als afzonderlijke regels worden toegevoegd, anders mist de formule ze stilzwijgend.
De aftrek van cache-tokens (vers = input_tokens − cache_read − cache_write) is hetzelfde detail dat de OpenTelemetry GenAI-specificatie benadrukt: gen_ai.usage.input_tokens is gedefinieerd als het totaal inclusief beide cache-regels. Eén keer aftrekken voor cache_read maar niet voor cache_write — een veelvoorkomende bug — telt het cache-write-gedeelte dubbel: zowel tegen het tarief voor verse input als tegen het cache-write-tarief.
Een organisatie met 50 engineers die bij elke PR een agent laat draaien, genereert eenvoudig een miljoen provider-spans per dag. Het bevragen van die ruwe hoeveelheid data om antwoord te krijgen op de vraag "wat heeft het platformteam gisteren uitgegeven" is technisch mogelijk, maar operationeel rampzalig — volledige scans op een trace store kosten per query evenveel als de onderliggende inference. De oplossing is pre-aggregatie, uitgevoerd in drie lagen.
Aggregatiepipeline — minutentellers → uurlijkse rollups → dagelijkse MV
De kostendiscipline die dit betaalbaar maakt: aggregeer nooit door de trace store te bevragen. De trace store is bedoeld voor forensisch onderzoek. Aggregaties komen uit de rollup-tabellen. Op de schaal van Northwind (een miljoen spans per day) blijven de rollups binnen het gigabyte-bereik met query-responstijden van minder dan een seconde. De keuze voor de database-engine is een kwestie van voorkeur — ClickHouse is sneller bij grote aggregaties en biedt betere controle over cardinaliteit; TimescaleDB is toegankelijker voor teams die al Postgres gebruiken. Beide draaien deze werkbelasting op een enkele VM op opstart- tot middelgrote schaal. Boven de miljard spans per dag neemt ClickHouse de leiding.
Zodra je de teamuitgaven in vrijwel real-time kunt berekenen, volgen budgetten vanzelf. Het patroon bestaat uit twee niveaus.
Zachte limiet (80% van het budget). Triggert een melding naar de teameigenaar via PagerDuty of Slack. Er worden geen requests geblokkeerd. Het doel is om de trend zichtbaar te maken voordat het een probleem wordt. Sommige teams hanteren een driestaps zachte limiet van 60% / 80% / 95%.
Harde limiet (100% van het budget). De gateway retourneert HTTP 429 met een foutmelding die de oorzaak identificeert, en weigert de provider aan te roepen:
HTTP 429 — budget_exhausted respons-structuur
Het concurrency-probleem is reëel. Als team X op $ 24.997 van een budget van $ 25.000 zit en er komen tien gelijktijdige requests binnen, ziet elke worker bij een naïeve read-then-write-logica "onder budget" en worden ze alle tien verzonden. De oplossing is een atomische teller. Redis INCRBYFLOAT is hier de uitgelezen oplossing voor: elke worker verhoogt de teller met de verwachte kosten van het request vóór verzending (geschat op basis van de resterende tokenruimte en het goedkoopste mogelijke model dat het team mag gebruiken), controleert de waarde na verhoging met de limiet en breek af als deze is overschreden. De werkelijke kosten worden bij het sluiten van de span verrekend met de schatting; kleine correcties worden verwerkt in de dagelijkse rollup.
Dit patroon telt iets te veel bij afgebroken requests, maar telt nooit te weinig. Voor een budget-circuit breaker is dat de juiste asymmetrie: een paar cent te veel rekenen is beter dan duizend dollar te veel uitgeven.
Het meest kwetsbare onderdeel van een budgetsysteem is de abrupte stop bij 100%. In één stap van volledige kwaliteit naar 429 gaan levert een slechte gebruikerservaring op. Een beter patroon is gecontroleerde functievermindering (graceful degradation): naarmate het gebruik stijgt, wordt er doorgestuurd naar goedkopere modellen.
De integratie met de routinglaag van de gateway is een budgetbewust beleid dat de standaard modelselectie overschrijft. Een veelvoorkomende vorm:
YAML — fragment van routingbeleid met budgetbewuste overschrijvingen
Bij 80% wordt het team overgezet van Sonnet naar Haiku — een kostenreductie van 3x bij een kwaliteitsvermindering die de meeste niet-kritieke taken prima verdragen. Bij 95% wordt ook de maximale uitvoer beperkt, wat de maximale kosten per request begrenst. De teameigenaar wordt bij elke overgang op de hoogte gesteld. De pipeline stopt niet.
Deze afweging moet bewust per werkbelasting worden gemaakt. Code-reviews en het verwerken van tickets lenen zich goed voor functievermindering; het samenvatten van medische dossiers waarschijnlijk niet. Het routingbeleid bevindt zich naast de overige productieconfiguratie van de applicatie.
Het hulpmiddel dat de cirkel rondmaakt, is een maandelijks chargeback-rapport dat wordt geëxporteerd naar degene die verantwoordelijk is voor de kostentoewijzing — typisch een FinOps-team of financiële partner. Het schema is een kopie van de dagelijkse rollup, gefilterd op de maand en gegroepeerd met één regel per (team, app, model, provider).
De kolom cache_savings_usd is de regel die het grootste deel van de platforminvestering rechtvaardigt. Deze wordt berekend als (cache_read_tokens × fresh_input_rate − cache_read_tokens × cached_rate) / 1e6 — het verschil tussen wat die tokens kosten tegen het gecachete tarief en wat ze gekost zouden hebben bij verse input. Voor agents met een stabiele systeem-prompt over duizenden requests maakt dit bedrag vaak een derde tot twee derde van de totale uitgaven uit.
Het rapport wordt gegenereerd als CSV voor verwerking in de bestaande FinOps-tooling van de organisatie, en als een visueel dashboard voor de teameigenaren zelf. Het onderstaande voorbeeld toont een overzicht aan het einde van de maand.
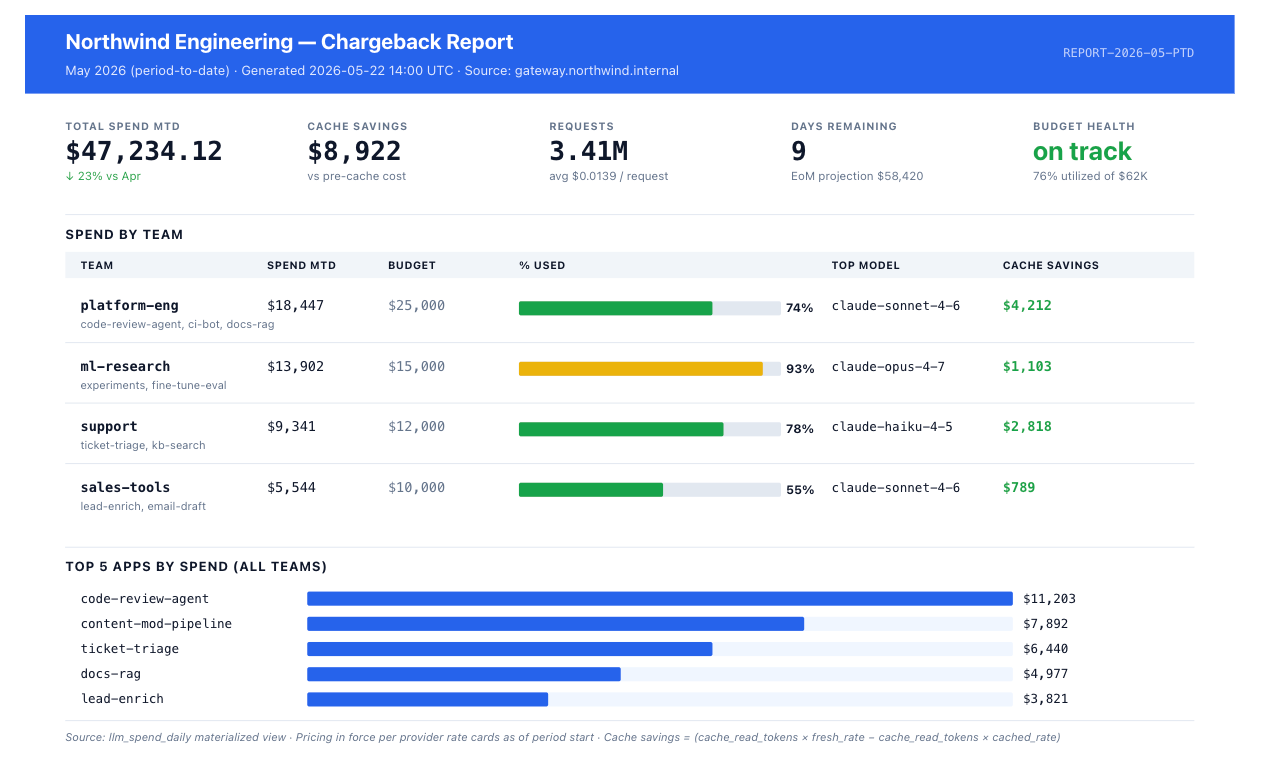
Concrete cijfers, gebaseerd op de prijzen van Claude Sonnet 4.6 per mei 2026: $ 3 input, $ 15 output, $ 0,30 cache read, $ 3,75 cache write per miljoen tokens.
De code-review agent van Northwind draait op elke pull request. Het profiel per PR: een systeem-prompt van 12.000 tokens (stijlgids, repo-conventies, checklist, few-shot voorbeelden); een diff van 1.500 tokens; ~800 tokens aan inline review-output. 50 engineers × 10 PR's/dag = 500 PR's/dag.
Zonder caching. Per PR: (12.000 + 1.500) × $ 3/1M + 800 × $ 15/1M = $ 0,0405 + $ 0,012 = $ 0,0525. Dagelijks: $ 26,25. Maandelijks: $ 787.
Met 5 minuten prompt-caching op de 12K systeem-prompt — cache miss op het koude pad, cache read op het warme pad, ~85% warm hit rate op een actieve repository:
Bij een organisatie met 500 engineers schaalt dezelfde berekening lineair naar $ 7.870/maand ongecachet en $ 3.940/maand met caching. Zonder toewijzing per trace is dit verschil onzichtbaar — het is slechts een onderdeel van een ongedifferentieerd totaal op een gedeelde key. Met toewijzing toont de chargeback-regel: platform-eng / code-review-agent / claude-sonnet-4-6 / anthropic — $ 394 uitgegeven, $ 393 aan cachebesparingen, 15.500 requests, 0,1% error rate. Het gesprek van vrijdag gaat niet langer over $ 47.234 op een gedeelde key.
Waarom gebruiken we niet gewoon één API key per team om het dashboard van de provider te bekijken?
Dat kan. Maar dat gaat ten koste van de waarde van de gateway: cross-provider routing, automatische fallback, load balancing, centrale rate limits en centrale key-rotatie. De meeste teams die zo beginnen, stappen binnen een kwartaal over op toewijzing op gateway-niveau, zodra ze ontdekken dat het splitsen van keys ze ook dwingt om het verkeersbeleid te splitsen. De methode met metadata-tags biedt toewijzing zonder die concessie.
Hoe houden we kostengegevens actueel? Een dagelijkse rollup is te traag voor real-time dashboards.
De architectuur met drie lagen is specifiek ontworpen om beide te bieden. De uurlijkse rollup is binnen enkele minuten bijgewerkt (de minutentellers worden er continu naar weggeschreven) en de dagelijkse rollup is de definitieve bron voor chargeback. Raadpleeg voor real-time dashboards de uurlijkse gegevens. Gebruik voor chargeback de dagelijkse gegevens.
Hoe zit het met niet-LLM-kosten — embeddings, vector stores, fine-tuning?
Embeddings hebben hetzelfde verbruiksprofiel als inference en de gateway wijst ze toe met dezelfde metadata. Vector stores en fine-tuning worden doorgaans buiten de gateway gefactureerd; het chargeback-rapport kan die externe kostenposten samenvoegen als je FinOps-pipeline deze verwerkt.
Hoe werkt dit bij streaming responses waarbij de uiteindelijke kosten pas bekend zijn als de stream sluit?
De provider-span blijft open gedurende de gehele stream en de kostenberekening vindt plaats bij het sluiten van de span, wanneer het laatste verbruiksblok in de afsluitende chunk binnenkomt. Budget-reservering vooraf bij de start van het request maakt gebruik van een verwachte bovengrens; de definitieve verrekening vindt plaats bij het sluiten van de span.
Wat gebeurt er met budgethandhaving bij een Redis-storing of netwerkonderbreking?
De atomische teller is de definitieve bron voor de handhaving van harde limieten. Als Redis niet bereikbaar is, heeft de gateway twee configureerbare modi: fail open (laat requests door, accepteer het risico op overschrijding) of fail closed (wijs requests af, accepteer de impact op beschikbaarheid). De juiste keuze hangt af van de werkbelasting, en de gateway biedt dit aan als een instelling per team. Meldingen voor zachte limieten werken op basis van best-effort.
Welke rol speelt TrueFoundry hierin?
De X-TFY-METADATA header, het beheer van de prijsmatrix, de streaming aggregatiepipeline en de budget-circuit breaker maken allemaal standaard deel uit van de TrueFoundry AI Gateway. Chargeback-exports draaien als geplande CSV/JSON/webhook-taken of als een interactief dashboard voor budgetbeheerders. Prijsmatrices volgen de tarieven van providers en historische traces blijven het tarief gebruiken dat gold op het moment van het request. Het opnieuw genereren van de chargeback van vorige maand levert dus exact hetzelfde bedrag op als vorige maand.
Als je LLM-werkbelasting vandaag de dag wordt gefactureerd op een gedeelde API key, is de meest effectieve eerste stap het toevoegen van de metadata-header bij elke call site, nog voordat je de volledige toewijzingspipeline uitrolt. De header is voorwaarts compatibel: de data verzamelt zich op de traces vanaf het moment dat deze is ingesteld, en het chargeback-rapport wordt waardevol op de dag dat de rollup-tabellen actief worden.
Northwind, Sarah en de specifieke bedragen in dit artikel dienen ter illustratie; het datamodel, het ontwerp van de X-TFY-METADATA header en de pipeline-architectuur tonen hoe een AI-gateway in productie, zoals die van TrueFoundry, uitgaven daadwerkelijk toewijst. De vermelde providerprijzen zijn actueel per mei 2026 volgens de openbare tarieven van de betreffende providers.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















