



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Applicaties die grote taalmodellen gebruiken, zijn voor elk inference-verzoek afhankelijk van AI-modelproviders. OpenAI, Anthropic en Google bieden diensten aan, maar geen enkele LLM-provider sluit rate limits, storingen of latency-pieken volledig uit. Een probleem bij een provider kan daarom LLM-applicaties en -workflows verstoren.
Zonder een fallback-pad kan een verzoek mislukken, de gewenste responstijd overschrijden of een inconsistente gebruikerservaring veroorzaken. Het patroon stuurt getroffen verzoeken via een ander model of een andere provider wanneer de initiële route niet aan de gedefinieerde vereisten voldoet. Het behoudt de continuïteit van de dienstverlening zonder infrastructuurfouten zichtbaar te maken voor eindgebruikers.
Betrouwbare implementatie is van belang zodra productiesystemen meerdere modellen, regio's of providers gebruiken. Een LLM Gateway kan routing, veerkracht en beleidshandhaving centraliseren achter één interface. Deze architectuur helpt productieteams te voorkomen dat ze provider-specifieke herstellogica in elke app afzonderlijk moeten inbouwen.
Dit betrouwbaarheidspatroon stuurt een verzoek automatisch door wanneer het primaire model niet voldoet aan de gedefinieerde vereisten voor beschikbaarheid, latency of kwaliteit. Triggers kunnen een HTTP 429-respons, een serverfout, een netwerkfout of een geconfigureerde timeout omvatten. Het verzoek beweegt zich vervolgens via een alternatieve route naar een geschikt fallback-model.
De betekenis van LLM fallback reikt verder dan geïsoleerd fout-herstel. Het vertegenwoordigt een veerkrachtlaag binnen de modeltoegangsarchitectuur. De aanpak vermindert de afhankelijkheid van één enkele LLM-provider en helpt applicaties beschikbaar te blijven tijdens instabiliteit bij een provider.
Fallbacks kunnen werken over providers, modellen, regio's of kwaliteitsdrempels heen. Een enkel model kan ook terugvallen op een andere deployment binnen dezelfde provider. Het gekozen ontwerp moet de compatibiliteit behouden tussen prompts, tokens, context windows, LLM tool-ondersteuning en responsformaten.
Het LLM fallback-mechanisme volgt een gecontroleerde volgorde na een mislukt verzoek. De router evalueert de trigger, leest de geconfigureerde fallback-keten en selecteert het volgende in aanmerking komende doel. De oorspronkelijke prompt, context en generatie-instellingen reizen vervolgens via de gekozen fallback-route.
Retries moeten kortstondige storingen aanpakken voordat er van provider wordt gewisseld. Begrensd beleid maakt gebruik van exponential backoff, jitter en respons-sturing voordat het verzoek wordt omgeleid. OpenAI raadt willekeurige backoff aan, terwijl Anthropic documentatie biedt over rate limits, timeouts en overbelaste responsen.

Fallback, failover en retries lossen gerelateerde problemen op binnen verschillende operationele scopes. Fallback verwerkt individuele verzoekfouten, terwijl failover breder verkeer omleidt tijdens langdurige prestatievermindering. Retries herhalen een verzoek tegen hetzelfde endpoint voordat een ander doel het ontvangt.
Deze veelvoorkomende patronen werken meestal samen binnen veerkrachtige architecturen. Beperkte retries kunnen kortstondige fouten oplossen zonder van provider te veranderen. LLM load balancing verdeelt normaal verkeer, terwijl failover de continuïteit beschermt tijdens langdurige storingen. Fallback verwerkt de resterende fouten op verzoekniveau.
Verschillende fallback-strategieën ondersteunen beschikbaarheid, kwaliteit, kosten en provider-onafhankelijkheid. Elke strategie vereist duidelijke trigger-voorwaarden en compatibele modelcapaciteiten. Teams moeten de verwachte latency, outputkwaliteit, contextlimieten en tool-ondersteuning vergelijken voordat ze routeprioriteiten bepalen.
Effectieve rate limiting moet worden afgestemd op elke strategie, in plaats van ongecontroleerde omleidingen te veroorzaken. Centrale rate-limit controls kunnen quota toepassen op gebruikers, modellen, applicaties en omgevingen. Google documenteert HTTP 429-responsen wanneer Gemini-workloads de toepasselijke quota overschrijden.
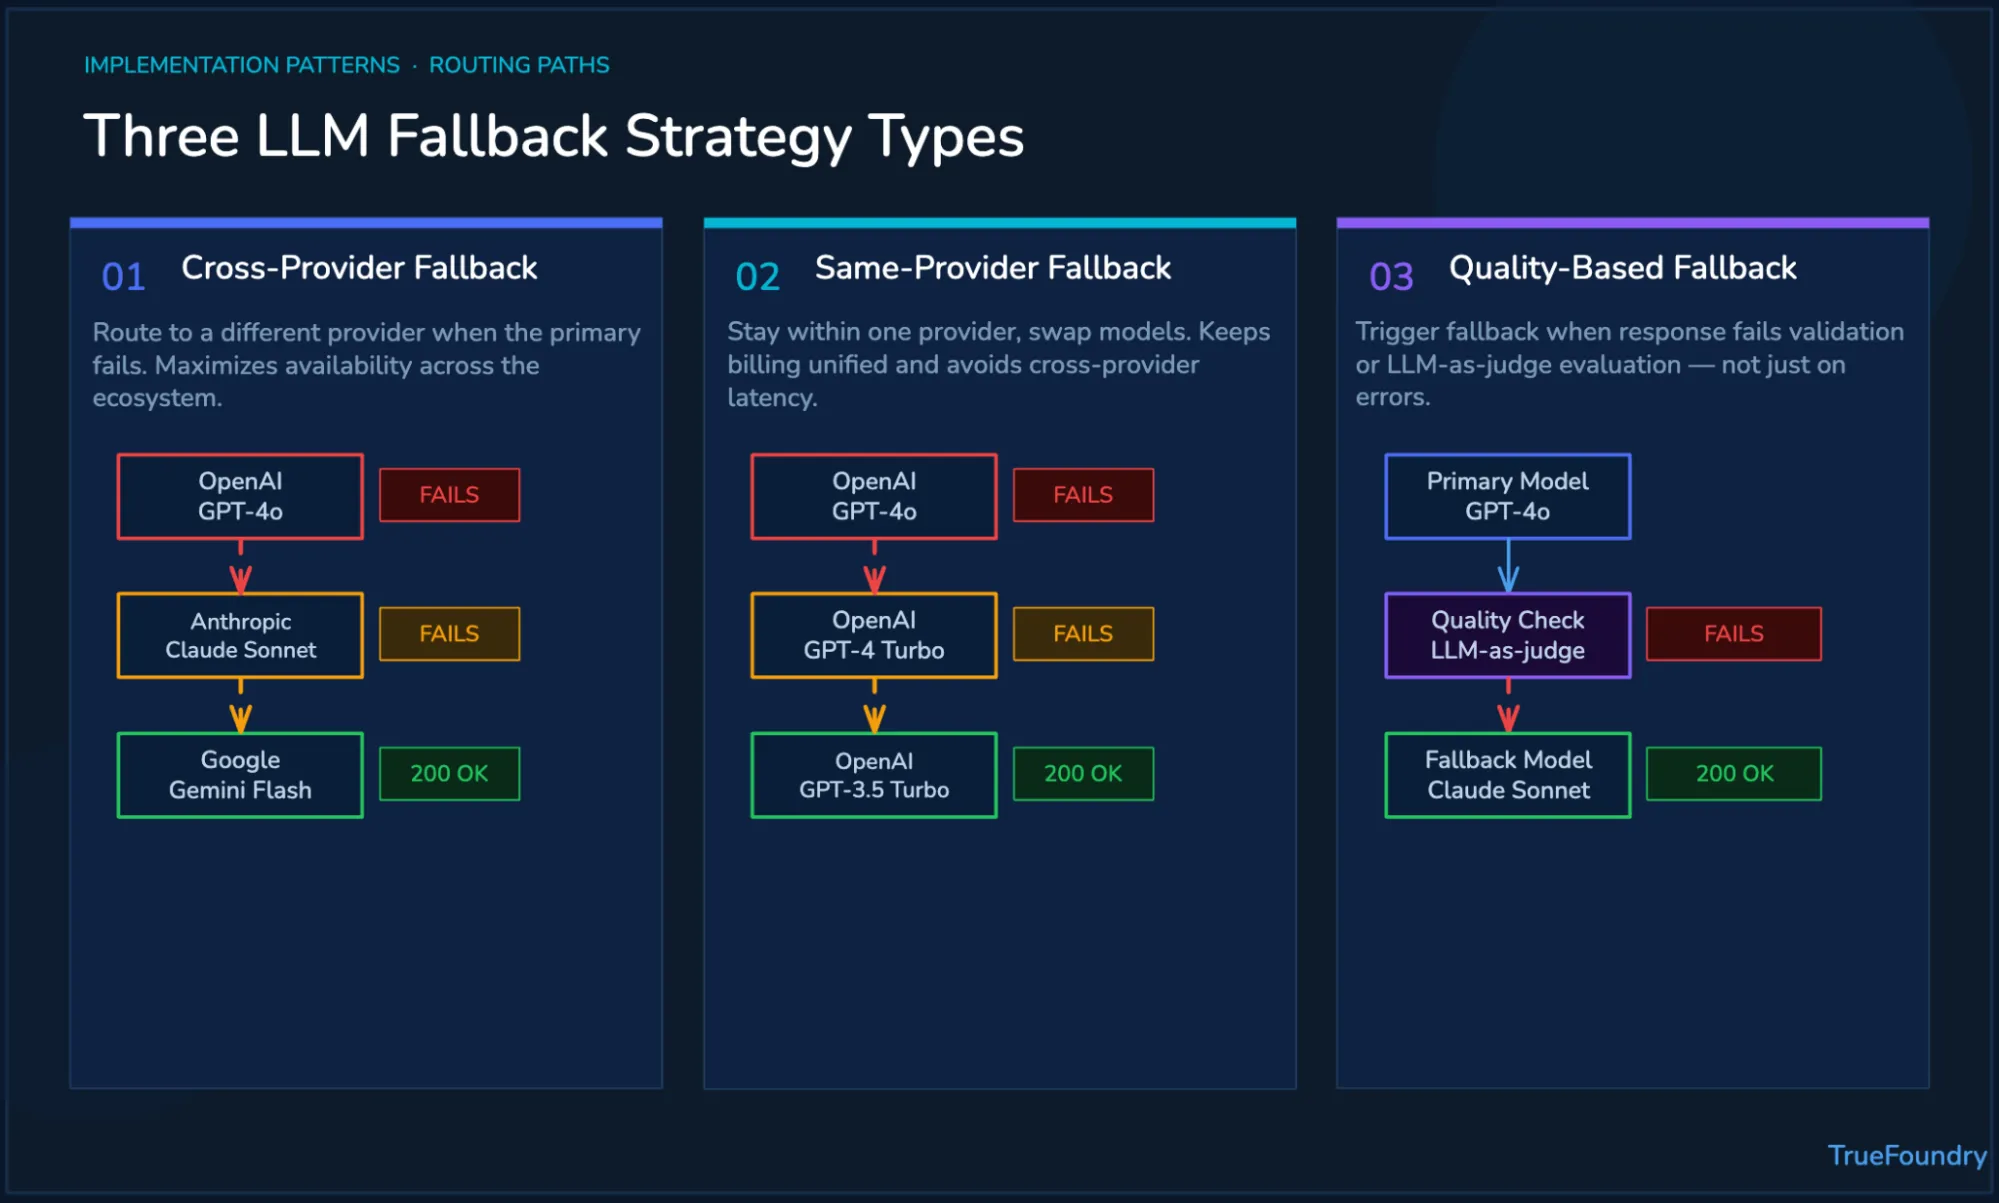
Het bouwen van fallback-logica binnen applicatiecode lijkt beheersbaar tijdens de vroege ontwikkeling. De complexiteit neemt toe wanneer de opzet meerdere providers, modelversies en omgevingen omvat. Elke SDK heeft verschillende fouten, standaardinstellingen, responsstructuren en retry-gedrag.
Teams kunnen Portkey, Bifrost of Vercel evalueren bij het vergelijken van gateway-opties. Welk platform ze ook kiezen, best practices vereisen begrensde retries, gezondheidsbewuste routing, veilige credentials en meetbaar herstel. Sterke LLM observability moet inzicht bieden in latency, fouten, fallback-frequentie en het uiteindelijke succespercentage.
De TrueFoundry AI Gateway centraliseert modeltoegang, routing, betrouwbaarheids-controls en observability. De globale routing-configuratie ondersteunt load balancing, fallback en retry-regels vanuit één centrale beheerlaag. Applicaties kunnen één API gebruiken zonder voor elke provider opnieuw herstellogica te hoeven bouwen.
Het platform ondersteunt ketens tussen een primaire provider en alternatieve doelen. Automatische retries verwerken tijdelijke providerfouten voordat er wordt omgeleid. Continue gezondheidsmonitoring vermindert vertraagd herstel tijdens storingen.
Voor AI-agents beheert de Agent Gateway uitvoering in meerdere stappen. De MCP Gateway regelt de toegang over verbonden enterprise-tools. Samen beschermen ze het gehele systeem wanneer één modelroute onbeschikbaar wordt.
Bouw veerkrachtige AI-applicaties met TrueFoundry's AI Gateway. Centraliseer routing, retries, observability en LLM fallback over verschillende providers heen. Boek vandaag nog een gratis demo om aan de slag te gaan.
LLM fallback is een architecturale vereiste voor betrouwbare applicaties die externe modellen gebruiken. Providers kunnen beperkingen opleggen of tijdelijke storingen ondervinden tijdens de uitvoering. Applicaties moeten deze omstandigheden opvangen zonder elke verstoring door te sturen naar gebruikers.
Implementatie op applicatieniveau blijft mogelijk, maar de complexiteit groeit binnen omgevingen met meerdere modellen. Een gateway kan retry-regels, fallback-volgorde, health checks, credentials en monitoring centraliseren. Deze aanpak verbetert de veerkracht en houdt de applicatiecode onafhankelijk van provider-specifiek gedrag.
Teams moeten triggers definiëren, modelcompatibiliteit valideren en elke route na deployment monitoren. Ze moeten ook uitputtende ketens en herstelgedrag testen voordat het productieverkeer toeneemt. TrueFoundry biedt één controle-element voor het beheren van keuzes rondom modeltoegang.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



A fallback in an LLM system redirects failed requests toward another model or provider. It activates after errors, timeouts, capacity limits, or quality failures. The process preserves availability without exposing recovery steps to users. Teams should define compatible targets, bounded retries, and clear exhaustion behavior before production deployment.
This mechanism detects a qualifying failure, selects the next approved target, forwards the request, and monitors its result. Routing may continue until one target returns an acceptable response. Health checks, timeout policies, retry limits, and circuit breakers prevent repeated requests toward unhealthy endpoints.
LLM-fallback begint wanneer een verzoek niet voldoet aan een vereiste rond beschikbaarheid, latentie, of kwaliteit. De gateway controleert zijn geconfigureerde keten en routeert het verzoek naar een ander doel. Dit gaat door totdat een geldige respons wordt ontvangen of er geen opties meer over zijn. Logs moeten elke poging, geselecteerde provider, latentie, en uitkomst vastleggen.
Failover shifts broader traffic away from a degraded provider or region. Fallback handles individual request failures and returns toward the preferred route after recovery. Retry logic first repeats the same request against one endpoint. Mature architectures combine these mechanisms while defining separate triggers, scopes, and recovery conditions.
An AI gateway sits between applications and model providers. Teams configure routing rules, fallback order, retry limits, and timeout policies within that shared layer. The gateway applies these controls to every request without changing each integration. This simplifies maintenance, provider switching, monitoring, and policy enforcement across production workloads.



Het laatste nieuws, artikelen en bronnen in je inbox



















