


August 26, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Large Language Models (LLMs) zijn de ruggengraat geworden van moderne AI-toepassingen. Ze drijven alles aan, van chatbots en virtuele assistenten tot onderzoekstools en enterprise-oplossingen. Niet alle LLMs zijn echter gelijk geschapen: elk model heeft unieke sterke punten, beperkingen en kostenfactoren. Sommige uitblinken in redeneren, terwijl andere beter zijn in creatief schrijven, coderen of het verwerken van gestructureerde query's. Dit is waar een LLM Router om de hoek komt kijken.
Een LLM Router werkt als een intelligente verkeersregelaar die prompts van gebruikers automatisch doorstuurt naar het meest geschikte model op basis van de specifieke taak. In plaats van te vertrouwen op één enkel model, kunnen bedrijven en ontwikkelaars prestaties, nauwkeurigheid en kosten optimaliseren door query's in real-time naar de juiste LLM te routeren. Naarmate AI-adoptie groeit, wordt LLM-routing een essentiële laag voor het bouwen van schaalbare, betrouwbare en efficiënte AI-systemen.
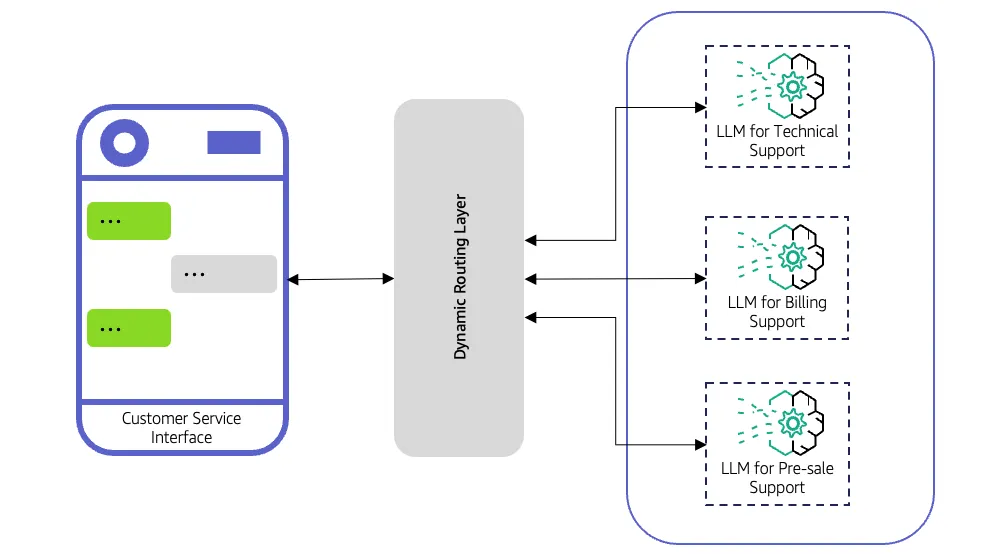
Een LLM Router beslist welk Large Language Model welk verzoek moet afhandelen. In plaats van elke query naar één enkel model te sturen, beoordeelt het de invoer, past het routinglogica toe en stuurt het deze door naar het meest geschikte model.
De router kan eenvoudige regels volgen, zoals het doorsturen van code-gerelateerde query's naar een op programmeren gericht model, of geavanceerde strategieën gebruiken zoals classifiers, embeddings of lichtgewicht voorspellingsmodellen om te bepalen welke LLM het beste antwoord zal leveren.
Hoe het werkt
Deze aanpak elimineert het "one-size-fits-all"-probleem. Lichtgewicht modellen handelen routinematige query's efficiënt af, terwijl complexe of redenatie-intensieve taken naar krachtigere LLMs gaan.
In de praktijk bevindt de router zich tussen toepassingen en meerdere LLMs, waardoor prestaties worden geoptimaliseerd, kosten worden verlaagd en de afhankelijkheid van één enkele provider wordt geminimaliseerd. Deze opzet zorgt ervoor dat elk verzoek het juiste model bereikt, terwijl AI-systemen betrouwbaar en flexibel blijven.

AI governance technologies operationalize an organization’s AI policies by providing oversight, risk management, compliance, observability and security across the AI life cycle. This Hype Cycle identifies the technologies that will help organizations implement AI governance responsibly and drive adoption at scale.
Bedrijven vertrouwen steeds meer op Large Language Models voor taken variërend van chatbots en virtuele assistenten tot het maken van content en data-analyse.
Het gebruik van één enkele LLM voor alle taken brengt echter uitdagingen met zich mee. Sommige modellen reageren snel maar missen diepgang, terwijl andere nauwkeurige resultaten leveren tegen hoge latency en kosten. Zonder een manier om deze verschillen te beheren, moeten teams voortdurend compromissen sluiten tussen prestaties, nauwkeurigheid en budget.
Een LLM Router lost dit op door verzoeken intelligent door te sturen naar het model dat het beste geschikt is voor de taak.
Onderzoek dit scenario -
Een klantenservicesysteem ontvangt twee typen query's.
Een eenvoudig verzoek zoals "Wat zijn jullie openingstijden?" heeft geen zeer geavanceerd model nodig, terwijl een complexe technische vraag over het oplossen van problemen met een product dat wel heeft. Zonder een LLM Router gaan alle query's mogelijk naar een krachtig, duur model. Dit verhoogt de kosten en vertraagt de responstijden. Met een router gaat de eenvoudige query naar een snel, lichtgewicht model, terwijl de complexe query wordt gerouteerd naar een krachtigere LLM, wat snelheid, kosten en nauwkeurigheid optimaliseert.
Voordelen voor bedrijven
Door query's intelligent te routeren, leveren bedrijven snellere, nauwkeurigere en kosteneffectievere AI-diensten. LLM Routers transformeren AI-implementatie van een "one-size-fits-all"-benadering naar een flexibel, betrouwbaar en efficiënt systeem, wat hen essentieel maakt voor moderne AI-infrastructuur.
Een LLM Router is meer dan een verkeersregelaar; het biedt verschillende kernfuncties die AI-systemen slimmer, sneller en betrouwbaarder maken. Het begrijpen van deze functies helpt organisaties bij het ontwerpen van AI-workflows die efficiënt schalen met behoud van kwaliteit.
Voordat er routering plaatsvindt, analyseert de router inkomende query's. Het onderzoekt metadata, tags, querytype, complexiteit en soms intentie of sentiment. Deze analyse biedt context zodat de router kan beslissen welk model het beste geschikt is om het verzoek af te handelen. Een klantvraag over facturering kan bijvoorbeeld worden gerouteerd naar een lichtgewicht LLM voor algemene doeleinden, terwijl een technische servicering naar een domeinspecifiek model wordt gestuurd.
De router selecteert het meest geschikte model op basis van meerdere criteria, waaronder:
Door rekening te houden met deze factoren, zorgt de router ervoor dat elk verzoek de beste balans krijgt tussen snelheid, nauwkeurigheid en kosten.
Wanneer meerdere modellen dezelfde taak kunnen afhandelen, verdeelt de router de verzoeken intelligent om overbelasting van één enkel model te voorkomen. Dit verbetert de algehele responstijd van het systeem en zorgt voor consistente prestaties tijdens piekgebruik.
Zelfs de beste modellen kunnen falen, een timeout krijgen of antwoorden met een lage betrouwbaarheid retourneren. De router implementeert fallback-mechanismen en leidt query's automatisch om naar backupmodellen. Dit garandeert continuïteit en betrouwbaarheid zonder dat de gebruiker hier hinder van ondervindt.
Geavanceerde routers volgen gebruikspatronen, modelprestaties en resultaten van query's. Deze inzichten helpen teams om routingstrategieën te optimaliseren, betere modellen te selecteren en op termijn de kosten te verlagen.
Een LLM Router fungeert als het besluitvormingscentrum van AI-systemen met meerdere modellen. Door verzoeken te analyseren, het juiste model te selecteren, de belasting te verdelen, storingen af te handelen en inzichten te bieden, zorgt het ervoor dat elke query efficiënt, nauwkeurig en betrouwbaar wordt verwerkt. Deze combinatie van functies maakt LLM Routers een cruciaal onderdeel bij het bouwen van robuuste, schaalbare en kosteneffectieve AI-oplossingen.
LLM Routers en AI Gateways worden vaak samen besproken omdat ze zich beide bevinden tussen AI-toepassingen en taalmodellen. Ze lossen echter verschillende problemen op en werken op verschillende lagen van de AI-stack.
Een LLM Router richt zich op het selecteren en sturen van verzoeken naar het meest geschikte taalmodel op basis van factoren zoals kosten, latency, prestaties, beschikbaarheid of taakvereisten. Het hoofddoel is het optimaliseren van modelgebruik en het verbeteren van de prestaties van toepassingen.
Een AI Gateway biedt een breder besturingsvlak voor AI-verkeer. Naast modelrouting bieden AI Gateways functionaliteiten zoals authenticatie, autorisatie, rate limiting, observabiliteit, governance, kostenbewaking en beveiligingscontroles. Ze helpen organisaties bij het beheren en beveiligen van AI-workloads over meerdere modellen, teams en omgevingen heen.
LLM routers gebruiken verschillende strategieën om query's efficiënt naar het meest geschikte taalmodel te sturen. Deze strategieën vallen over het algemeen in drie categorieën: statisch, dynamisch en hybride, waarbij geavanceerde systemen soms reinforcement learning integreren.
Statische routing vertrouwt op vooraf gedefinieerde regels om te beslissen welk model een query afhandelt. Het zorgt voor consistent routinggedrag en is eenvoudig te implementeren.
Dynamische routing past zich in real-time aan en selecteert modellen op basis van de huidige systeemprestaties en querycontext.
Hybride strategieën combineren statische en dynamische benaderingen voor meer flexibiliteit en efficiëntie.
Sommige geavanceerde systemen gebruiken reinforcement learning om routeringsbeslissingen continu te verbeteren. Deze routers leren van eerdere query's en modelprestaties, waardoor de routing in de loop van de tijd wordt geoptimaliseerd voor complexe of veranderende workloads.
Een LLM Router biedt verschillende belangrijke voordelen die AI-systemen efficiënter, betrouwbaarder en kosteneffectiever maken. Een van de belangrijkste voordelen is geoptimaliseerde prestaties.
Door elke query intelligent te routeren naar het model dat het beste geschikt is voor de taak, zorgt de router ervoor dat krachtige modellen met redeneervermogen complexe vragen afhandelen, terwijl lichtgewicht, snellere modellen eenvoudigere verzoeken verwerken. Deze aanpak balanceert snelheid en nauwkeurigheid, wat de algehele gebruikerservaring verbetert.
Een ander aanzienlijk voordeel is kostenefficiëntie. Zonder router voeren bedrijven mogelijk alle query's uit via krachtige modellen, wat de operationele kosten onnodig verhoogt. De router zorgt ervoor dat dure modellen worden bewaard voor hoogwaardige of complexe query's, terwijl routinematige of herhalende taken worden afgehandeld door minder resource-intensieve modellen, wat de rekenkosten verlaagt en de ROI maximaliseert.
Betrouwbaarheid verbetert ook met een LLM Router. Geavanceerde routers bevatten fallback-mechanismen die query's automatisch omleiden als een model faalt, een timeout krijgt of resultaten met een lage betrouwbaarheid levert. Dit garandeert consistente en betrouwbare prestaties en voorkomt onderbrekingen in real-time toepassingen zoals klantenservice of virtuele assistenten.
Daarnaast bieden LLM Routers flexibiliteit. Organisaties kunnen meerdere modellen van verschillende providers integreren en voor elke taak de beste kiezen.
Dit vermindert de afhankelijkheid van één enkele leverancier en stelt teams in staat om te experimenteren met verschillende modellen naarmate er nieuwe mogelijkheden ontstaan.
Tot slot ondersteunen routers schaalbaarheid. Naarmate het aantal query's groeit, verdeelt de router verzoeken intelligent over modellen, wat overbelasting voorkomt en de systeemprestaties soepel houdt.
Door geoptimaliseerde routing, kostenbesparingen, betrouwbaarheid, flexibiliteit en schaalbaarheid te combineren, transformeert een LLM Router AI-implementaties van een rigide aanpak met één model naar een dynamisch, efficiënt en veerkrachtig systeem.
LLM Routers worden toenemend gebruikt in ondernemingen om AI-prestaties, betrouwbaarheid en efficiëntie te optimaliseren. Ze maken intelligente query-routing mogelijk, waardoor het juiste model elke taak afhandelt op basis van complexiteit, domein en context.
Automatisering van klantenservice
Ondernemingen verwerken dagelijks duizenden klantvragen, van eenvoudige FAQ's tot complexe technische problemen. LLM Routers sturen routinevragen naar snelle, lichtgewicht modellen, terwijl ingewikkelde problemen naar krachtigere modellen worden gerouteerd. Dit zorgt voor snelle, nauwkeurige en consistente antwoorden, verhoogt de klanttevredenheid en vermindert de operationele druk.
Kennisbeheer en enterprise search
Bedrijven onderhouden grote opslagplaatsen van interne documenten, handleidingen en beleid. Routers analyseren query's en sturen ze naar modellen die zijn geoptimaliseerd voor redeneren, samenvatten of domeinspecifieke kennis. Werknemers ontvangen nauwkeurige, contextueel relevante informatie zonder dat dure modellen overbelast raken.
Workflow- en taakautomatisering
LLMs worden veel gebruikt voor het genereren van rapporten, data-analyse en besluitvormingsondersteunende taken. Routers wijzen complexe query's dynamisch toe aan krachtige modellen en routinetaken aan lichtere modellen, wat snelheid, nauwkeurigheid en rekenkosten in enterprise-workflows in balans brengt.
Orchestratie van meerdere modellen
Organisaties zetten vaak meerdere LLMs in bij verschillende providers of domeinen. Routers beheren modelselectie, load balancing en fallback-mechanismen, wat zorgt voor betrouwbaarheid, flexibiliteit en schaalbaarheid in grootschalige AI-systemen.
Productaanbevelingen en personalisatie
Voor e-commerce of SaaS-platforms kunnen LLM Routers personalisatietaken toewijzen aan modellen die zijn getraind op gebruikersgedrag en -context, terwijl generieke aanbevelingen worden gedelegeerd naar eenvoudigere modellen. Dit verbetert de nauwkeurigheid en prestaties van aanbevelingen terwijl de kosten onder controle blijven.
Compliance- en risicoanalyse
In de financiële sector, de juridische sector of de gezondheidszorg vereisen query's mogelijk een strikte naleving van regelgeving of domeinspecifieke richtlijnen. Routers kunnen gevoelige of cruciale query's sturen naar modellen met domeinexpertise, wat compliance garandeert terwijl algemene taken worden afgehandeld door standaardmodellen.
Contentgeneratie en samenvatting
Voor marketing, kennisdeling of documentatie kunnen LLM Routers complexe taken voor het maken van content toewijzen aan hoogwaardige modellen en eenvoudigere samenvattings- of opsteltaken aan snellere modellen, wat de efficiëntie optimaliseert zonder de kwaliteit van de uitvoer aan te tasten.
Door LLM Routers toe te passen op deze uiteenlopende scenario's, kunnen ondernemingen AI intelligent schalen, met behoud van prestaties, betrouwbaarheid en kosteneffectiviteit over meerdere workflows en toepassingen.
Na het verkennen van hoe LLM Routers een breed scala aan enterprise-toepassingen aandrijven, is het belangrijk om te begrijpen hoe ze verschillen van een ander belangrijk onderdeel in AI-systemen met meerdere modellen.
Een LLM Router is gericht op intelligente verzoekrouting. De primaire functie is het analyseren van inkomende query's, het evalueren van context, complexiteit en metadata, en vervolgens het doorsturen van elk verzoek naar het meest geschikte model. Routers maken vaak gebruik van geavanceerde strategieën zoals dynamische routing, contextbewuste besluitvorming en fallback-mechanismen om te optimaliseren op nauwkeurigheid, snelheid en kosten.
Ze zijn bijzonder cruciaal in omgevingen waar query's sterk variëren in type, domein of rekenvereisten, waardoor ondernemingen de belasting kunnen verdelen en hoge prestaties kunnen behouden.
Een LLM Gateway werkt daarentegen als een gecentraliseerd toegangspunt voor interactie met een of meerdere LLMs. De primaire rol is het vereenvoudigen van integratie, het bieden van gestandaardiseerde API's, het beheren van authenticatie, het afhandelen van rate-limiting en het monitoren van gebruik.
In tegenstelling tot routers nemen gateways doorgaans geen intelligente beslissingen over modelselectie; ze bieden uniforme toegang en operationele controles om implementaties met meerdere modellen te vergemakkelijken. Gateways richten zich meer op beheer op infrastructuurniveau, beveiliging en schaalbaarheid in plaats van optimalisatie op queryniveau.
Belangrijkste verschillen
Routers en gateways werken vaak samen in gelaagde architecturen. De gateway biedt een veilig, gestandaardiseerd toegangspunt voor toepassingen, terwijl de router erachter zit en intelligente beslissingen neemt over modelselectie. Deze combinatie stelt ondernemingen in staat om zowel operationele controle als geoptimaliseerde query-verwerking te bereiken.
Het begrijpen van het verschil tussen LLM Routers en LLM Gateways helpt organisaties om AI-systemen met meerdere modellen effectief te implementeren.
Routers zorgen voor intelligente, contextbewuste prestaties, terwijl gateways zorgen voor veilige, schaalbare en betrouwbare toegang, wat een robuuste basis vormt voor enterprise AI.
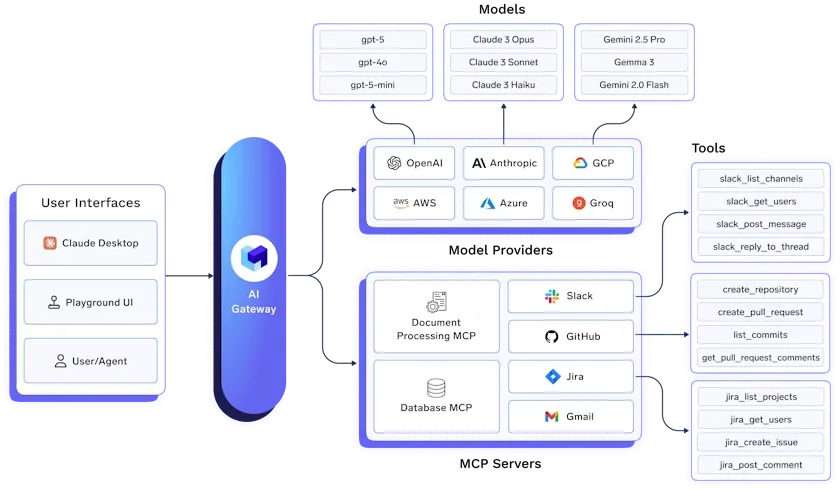
De TrueFoundry LLM Gateway is een enterprise-ready platform dat toegang tot alle belangrijke grote taalmodellen (LLMs) verenigd via één enkele, veilige en hoogwaardige API.
Het vereenvoudigt de GenAI-infrastructuur door meer dan 250 modellen te integreren, waaronder OpenAI, Anthropic Claude, Gemini, Groq, Mistral en open-source frameworks, zonder dat er code-wijzigingen nodig zijn. Teams kunnen één consistente API gebruiken voor chat-, completion-, embedding- en reranking-workloads, terwijl authenticatie en beheer van API-sleutels worden gecentraliseerd.
Belangrijkste functionaliteiten:
Naarmate enterprises toenemend vertrouwen op meerdere Large Language Models, zijn tools zoals LLM Routers en LLM Gateways onmisbaar geworden voor het beheren van AI op schaal. LLM Routers brengen intelligentie naar het systeem door elke query te analyseren en ervoor te zorgen dat deze het model bereikt dat het beste geschikt is voor de taak. Dit verbetert de prestaties, verlaagt de kosten en verhoogt de betrouwbaarheid, met name in complexe workflows met een hoog volume.
Gateways bieden ondertussen de ruggengraat voor veilige, gestandaardiseerde toegang tot modellen, waardoor integratie wordt vereenvoudigd, het gebruik wordt gemonitord en operationele controles worden gehandhaafd.
Samen vormen deze componenten een gelaagde AI-architectuur die intelligentie balanceert met operationele efficiëntie. Door de besluitvormingscapaciteiten van routers te combineren met de structurele betrouwbaarheid van gateways, kunnen organisaties de waarde van meerdere LLMs maximaliseren met behoud van schaalbaarheid en controle.
De adoptie van LLM Routers is niet langer optioneel; het is een noodzaak voor enterprises die ernaar streven snelle, nauwkeurige en kosteneffectieve AI-diensten te leveren. Het begrijpen van hun rol, samen met gateways, stelt teams in staat om robuuste AI-infrastructuren te ontwerpen die voldoen aan uiteenlopende zakelijke behoeften.
Naarmate AI-modellen blijven evolueren en zich vermenigvuldigen, zal het beheersen van intelligente routing en gestructureerde toegang cruciaal zijn voor enterprises die concurrerend willen blijven in het snel vorderende AI-landschap.
LLM routing werkt door inkomende verzoeken te evalueren op basis van vooraf gedefinieerde logica, semantische embeddings of classificatieregels. Het systeem stuurt verkeer op basis van context, vereiste nauwkeurigheid of latency van de upstream provider. Een gecentraliseerde gateway beheert deze complexe configuraties om modelselectie en failover te automatiseren zonder dat handmatige code-wijzigingen nodig zijn voor elke modelupdate.
LLM routing classificatie gebruikt een zeer efficiënt model om prompts te categoriseren voorafgaand aan de uitvoering van de inference. Deze stap identificeert de intentie, zoals eenvoudige begroetingen versus complexe codeertaken. Geautomatiseerde classificatie voorkomt overmatig gebruik van dwaze, dwaze, dure frontier-modellen door queries met een lage complexiteit te filteren naar kleinere, snellere en meer kosteneffectieve alternatieven.
TrueFoundry verenigt LLM routing en AI Gateway functionaliteiten door verkeersorchestratie te combineren met governance en beveiliging. Het platform beheert model-failover, rate limiting en kostenbewuste routing binnen één gecentraliseerd control plane. Deze infrastructuur zorgt ervoor dat enterprise AI-implementaties uiterst veerkrachtig en kosteneffectief zijn voor grootschalige productieomgevingen.
Topproducten voor LLM routers zijn onder meer TrueFoundry voor enterprise-grade orchestratie, LiteLLM voor een universele proxy-API en Martian voor geautomatiseerde modelselectie. Andere topopties in de industrie zijn Portkey voor geavanceerde guardrails, Helicone voor bliksemsnelle observability en OpenRouter voor eenvoudige toegang tot honderden open- en closed-source modellen.
LLM Routers onderzoeken de metadata, het type en de context van de query om een model te kiezen. Selectiefactoren omvatten domeinexpertise, redeneervermogen, latency en kosten. Eenvoudige queries gaan naar lichtgewicht modellen, complexe taken naar modellen met een hoge capaciteit. Geavanceerde routers kunnen gebruikmaken van embeddings of voorspellende classifiers voor real-time, intelligente modelrouting.
Kernfuncties van een LLM router omvatten verzoekanalyse, intelligente modelselectie, load balancing, afhandeling van fallbacks en monitoring. Routers verdelen queries over meerdere LLMs, sturen mislukte verzoeken opnieuw door en volgen de prestaties. Dit zorgt ervoor dat taken efficiënt worden verwerkt, modellen optimaal worden benut en het systeem betrouwbaar en schaalbaar blijft in enterprise AI-workflows.
Veelvoorkomende typen LLM routers omvatten rule-based routing, cost-based routing, performance-based routing en task-based routing. Rule-based routers volgen vooraf gedefinieerde voorwaarden, cost-based routers kiezen goedkopere modellen, performance-based routers selecteren modellen met betere nauwkeurigheid of snelheid, en task-based routers sturen verzoeken naar modellen die gespecialiseerd zijn in taken zoals coderen, chatten of samenvatten.
LLM routing wordt uitgevoerd door het gebruikersverzoek te analyseren en het naar het meest geschikte model te leiden. Ontwikkelaars definiëren regels of gebruiken algoritmen die rekening houden met factoren zoals taaktype, kosten, latency en modelcapaciteit. Een routinglaag evalueert de invoer en stuurt de query automatisch naar de juiste LLM.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox




















