



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Nu Large Language Models (LLM's) centraal staan in moderne AI-applicaties, is het waarborgen van hun betrouwbaarheid, prestaties en veiligheid in productie kritieker dan ooit. LLM-observabiliteit verwijst naar het vermogen om het gedrag van LLM's te monitoren, te tracen en te debuggen, waarbij prompts, latency, tokengebruik, gebruikerssessies en foutpatronen worden bijgehouden. Zonder robuuste observabiliteit lopen teams het risico op hallucinaties, kostenoverschrijdingen en onopgemerkte fouten. In dit artikel leggen we uit hoe LLM-observabiliteit werkt, wat de beste LLM-observabiliteitstools zijn en meer.
LLM-observabiliteit verwijst naar de praktijk van het monitoren, analyseren en begrijpen van het gedrag en de prestaties van Large Language Models (LLM's) in echte toepassingen. Omdat LLM's worden geïntegreerd in productiesystemen zoals chatbots, AI-agents en zoekmachines, is observabiliteit cruciaal voor het waarborgen van betrouwbaarheid, veiligheid en vertrouwen.
Het gaat verder dan basis-logging of metrieken. LLM-observabiliteit richt zich op het bijhouden van invoer, uitvoer, prompt-ketens, latency, tokengebruik, modelversiebeheer en foutsituaties. Het stelt ontwikkelaars en ML-teams in staat om hallucinaties, bias, toxische reacties, prompt-injectieaanvallen of onverwacht gedrag te detecteren. Het helpt ook te identificeren wanneer modeluitvoer afwijkt van verwachte normen, wat essentieel is voor het behoud van consistentie en compliance, vooral in gereguleerde industrieën.
Met observabiliteit kunnen teams realtime debugging uitvoeren, de oorzaak van fouten achterhalen, gebruikersinteracties monitoren en continu prompts of gefine-tunede modellen verbeteren. Tools zoals TrueFoundry, LangSmith, Arize, WhyLabs en PromptLayer komen op om DevOps-achtige monitoring naar LLM-systemen te brengen.
LLM-observabiliteit fungeert als de "ogen en oren" van uw GenAI-stack. Het maakt het veilig schalen van AI-applicaties mogelijk door zichtbaarheid en verantwoording te bieden, wat helpt de kloof tussen experimenteren en betrouwbare productie-implementatie te overbruggen.
Voor een diepe duik in de basisprincipes van LLM-observabiliteit leest u onze gedetailleerde gids: Wat is LLM-observabiliteit?
LLM-observabiliteit werkt door gedetailleerde telemetrie vast te leggen in elke fase van de levenscyclus van de LLM. Van het indienen van de prompt tot de uiteindelijke uitvoer biedt het inzicht in hoe het systeem presteert onder reële omstandigheden. Dit omvat doorgaans drie hoofdcomponenten: prompt-tracing, verzameling van metrieken en gedragsmonitoring.
Tracing op prompt-niveau: Elke interactie met de LLM wordt gelogd met rijke metadata, waaronder de ruwe prompt, gebruikerscontext, modelversie, tijdstempel en systeemrespons. Geavanceerde tools tracen meerstaps-workflows of agent-ketens, waarbij upstream- en downstream-operaties gekoppeld worden met behulp van correlatie-ID's. Hiermee kunnen teams problemen zoals hallucinaties, contextverlies of prestatieknelpunten debuggen door het gehele inferentieproces te traceren.
Prestatie- & tokenmetrieken: Observabiliteitsplatformen volgen latency, tokengebruik (invoer/uitvoer), doorvoer en foutpercentages in real time. Deze metrieken helpen vertragingen, overmatig tokengebruik of afwijkend gedrag te identificeren. Tracking op token-niveau is cruciaal voor kostenbeheer in API's zoals OpenAI, waar de prijsstelling gebonden is aan tokenverbruik.
Kwaliteit, guardrails en anomaliedetectie: Veel tools monitoren de uitvoer op kwaliteitsrisico's zoals bias, toxiciteit of hallucinaties met behulp van statistische modellen of regels. Ze detecteren ook schendingen van moderatiebeleid of veiligheidsdrempels en genereren waarschuwingen. Sommige platformen integreren analyse van embedding-drift om verschuivingen in semantisch gedrag in de loop van de tijd te monitoren.
Deze observabiliteitssignalen worden doorgaans gevisualiseerd in dashboards en kunnen waarschuwingen activeren, integreren met loggingsystemen of terugkoppelen naar CI/CD-pipelines. Door transparantie, ondersteuning bij debugging en inzicht in kosten te bieden, zorgen LLM-observabiliteitstools voor veilige, efficiënte en schaalbare GenAI-operaties.
Hier is een kort overzicht van de verschillende LLM-observabiliteitsplatformen:
Het kiezen van de juiste observabiliteitstool is essentieel om LLM-applicaties met vertrouwen te schalen. Van het tracen van prompts tot het monitoren van latency, de huidige platformen bieden diepgaande inzichten in elke fase van modelinferentie. In dit gedeelte belichten we de beste tools die uitblinken in betrouwbaarheid, governance en ontwikkelaarservaring. Of u nu in de cloud of on-premise draait, deze oplossingen helpen LLM's gereed te maken voor productie.

End-to-end prompt- en output-tracing: TrueFoundry legt elke fase van een LLM-interactie vast, van prompt-generatie en modelinferentie tot nabewerking—waarbij een volledige trace ontstaat met correlatie-ID's en OpenTelemetry-spans. Deze gedetailleerde tracking stelt ontwikkelaars in staat om precies aan te wijzen waar latency-pieken of fouten optreden, of het nu gaat om prompt-afhandeling, modelrespons of downstream-processen. Traces worden gevisualiseerd in de UI voor eenvoudig debuggen en opgeslagen voor compliance-audits, wat transparantie biedt in elk beslissingspunt in meerstaps-workflows.

Realtime analytics: Ingebouwde dashboards bieden live inzichten in modellatency, token-doorvoer, foutpercentages, rate-limit treffers en fallback-gebeurtenissen. Geaggregeerde analyses, zoals latency-heatmaps en gebruiksverdelingen, worden in real time ververst, waardoor teams snel problemen kunnen opsporen voordat ze invloed hebben op gebruikers. TrueFoundry ondersteunt waarschuwingen op drempelwaarden zoals latency-pieken of ongebruikelijke model-drift, wat zorgt voor proactieve respons en minimale downtime.

Gedetailleerde metadata en kostentoewijzing: Elke aanroep wordt verrijkt met metadata zoals model, gebruiker, team, omgeving of aangepaste tags, en bevat details over tokengebruik en kosten. Dit maakt het nauwkeurig bijhouden van uitgaven en gebruikstrends over afdelingen of functies mogelijk. Teams kunnen dashboards filteren en rapporten exporteren voor facturatietransparantie en ROI-analyse, waardoor engineering-, finance- en productteams volledig inzicht krijgen in wie wat gebruikt, wanneer en tegen welke kosten.

Langfuse is een open-source observabiliteitsplatform dat specifiek is gebouwd voor LLM-applicaties. Het biedt volledige prompt-respons tracing, inclusief invoermetadata, model-uitvoer, latency en tokengebruik. Langfuse integreert naadloos met LangChain, OpenAI-compatibele API's en andere LLM-stacks, waardoor het ideaal is voor ontwikkelaars die meerstaps- of agentic workflows bouwen. Het ondersteunt tracing over ketens heen, wat de visualisatie van geneste aanroepen, toolgebruik en redeneerpaden in real time mogelijk maakt.
Het platform logt gedetailleerde telemetrie voor elke gebruikerssessie, die gefilterd kan worden op project, gebruiker of model. Langfuse biedt ook ondersteuning voor het versiebepalen van prompts en het bijhouden van wijzigingen in de loop van de tijd, wat het eenvoudiger maakt om regressies te debuggen of te itereren op prompt engineering. Teams kunnen Langfuse zelf hosten of de beheerde cloudversie gebruiken, en observabiliteitsdata kan worden geëxporteerd voor externe analyses of compliance-rapportage. De intuïtieve UI en gedetailleerde controle over logs maken Langfuse een ontwikkelaarsvriendelijke keuze voor teams die transparantie en debugging in LLM-workflows prioriteit geven.
Teams die de diepte van observabiliteit en mogelijkheden op gateway-niveau evalueren, verkennen vaak vergelijkingen zoals langfuse vs portkey om verschillen in tracing, routing en kostentoewijzing te begrijpen voordat ze een productierijpe oplossing kiezen.
Confident AI is een AI-observabiliteitsplatform voor teams die LLM-applicaties in productie monitoren, evalueren en verbeteren. Het biedt volledige tracing over LLM-aanroepen, toolgebruik, agent-stappen en multi-agent workflows, waardoor het eenvoudiger wordt om fouten te debuggen en te begrijpen hoe AI-systemen presteren op echt verkeer.
De belangrijkste onderscheidende factor is eval-gestuurde observabiliteit. Buiten latency, kosten en fouten voert Confident AI online evals rechtstreeks uit op productietraces om hallucinaties, getrouwheid, antwoordrelevantie en andere foutpatronen te monitoren—waarbij problemen in real time worden gedetecteerd en precies wordt aangewezen welke prompts, agents of tools verminderde prestaties veroorzaken. Confident AI sluit ook de cirkel tussen monitoring en testen vóór de release: productietraces kunnen worden gecureerd tot evaluatiedatasets, klaargezet voor menselijke annotatie en hergebruikt voor regressietesten en prompt-verbetering.
Het meest geschikt voor teams die observabiliteit en evaluatie in één workflow willen. Enterprise-teams krijgen ook governance-besturingselementen, waarmee platformteams kwaliteitsnormen over verschillende producten heen kunnen afdwingen.
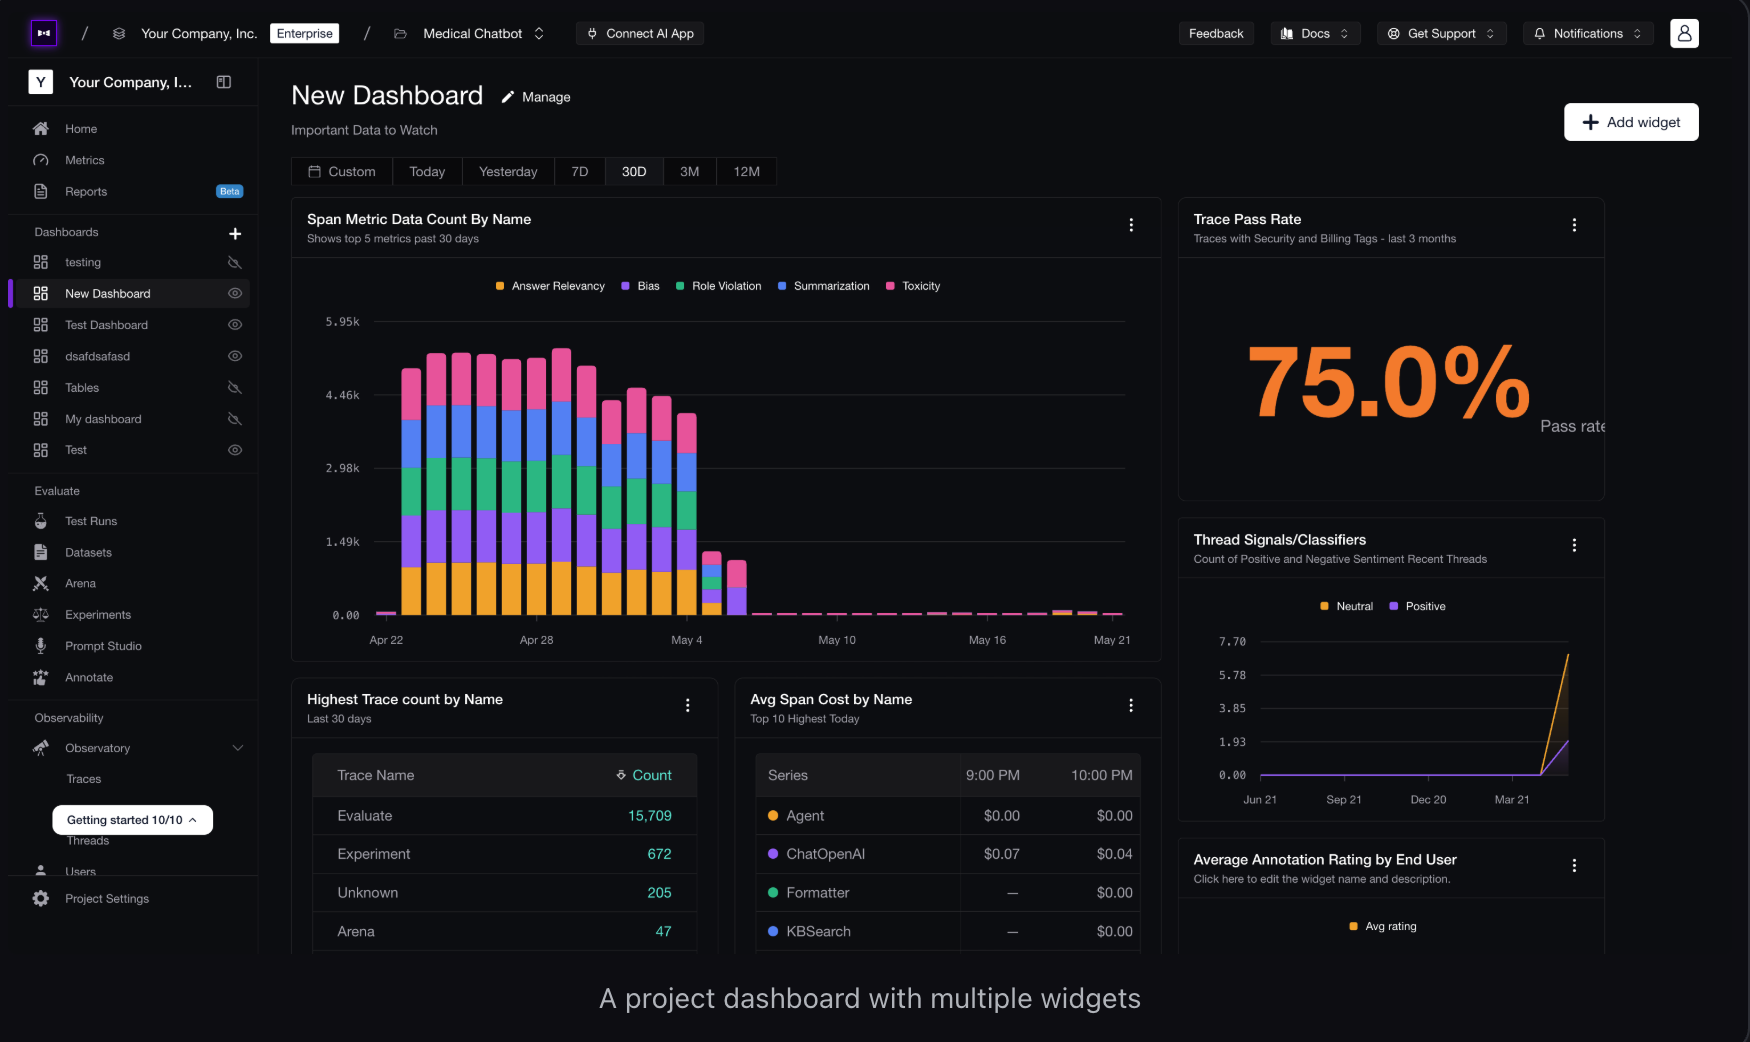

Helicone is een lichtgewicht observabiliteitslaag die speciaal is gebouwd voor OpenAI-compatibele API's. Het fungeert als een proxy die elke LLM API-request logt en monitort, waarbij gedetailleerde gegevens zoals prompt-inhoud, tokengebruik, latency, responstijd en foutcodes worden vastgelegd. Ontworpen voor eenvoud vereist Helicone minimale configuratie; ontwikkelaars kunnen het integreren door simpelweg hun API-endpoint te wijzigen.
Wat Helicone aantrekkelijk maakt, is de focus op kostentransparantie en inzichten op teamniveau. Het volgt het gebruik in verschillende omgevingen, ondersteunt virtuele API-sleutels en stelt teams in staat om kosten per gebruiker, model of route te specificeren. Het webdashboard biedt realtime inzicht in logs op prompt-niveau, verzoekvolumes en prestatietrends, wat teams helpt problemen op te vangen en budgetten te beheren.
Helicone ondersteunt waarschuwingen bij pieken in het gebruik of fouten en integreert met externe loggingtools. Het is open-source en zelf te hosten, wat het een flexibele optie maakt voor startups en dev-teams die snelle LLM-observabiliteit willen zonder zware infrastructuur te beheren of vast te zitten aan een specifieke leverancier.
Verken ook: Top 5 Helicone Alternatieven

PromptLayer is een speciaal gebouwd observabiliteits- en prompt-beheerplatform voor LLM-applicaties. Het helpt ontwikkelaars elk prompt-respons-paar in real time te volgen, in versie te beheren en te evalueren, waardoor het eenvoudiger wordt om model-uitvoer te debuggen en de prompt-kwaliteit te optimaliseren. Met native ondersteuning voor OpenAI en LangChain legt PromptLayer metadata zoals tijdstempels, latency, tokengebruik en succes/fout-status vast met minimale integratie-inspanning.
Een van de kernfuncties is versiebeheer voor prompts. Ontwikkelaars kunnen wijzigingen annoteren, uitvoer vergelijken en monitoren hoe prompt-aanpassingen de modelprestaties in de loop van de tijd beïnvloeden. Dit is met name handig voor teams die A/B-testen uitvoeren of snel itereren op gebruikersgerichte AI-functies. PromptLayer ondersteunt ook het taggen, groeperen en doorzoeken van logs over gebruikers, modellen en applicaties heen.
Het overzichtelijke dashboard maakt filteren op API-sleutel of omgeving mogelijk, wat teams een helder zicht geeft op de productieprestaties en de voortgang van de ontwikkeling. Of het nu wordt gebruikt voor debugging, compliance of experimenteren, PromptLayer brengt structuur en zichtbaarheid in de levenscyclus van prompt engineering.

WhyLabs LangKit is een gespecialiseerde observabiliteits- en monitoring-toolkit gericht op het detecteren van risico's in LLM-uitvoer zoals hallucinaties, bias en toxisch taalgebruik. Ontworpen voor teams die generatieve AI op schaal implementeren, integreert LangKit met model-inferentiepipelines en scant het de uitvoer continu op anomalieën met behulp van statistische en op regels gebaseerde technieken.
In tegenstelling tot traditionele tracingtools legt LangKit de nadruk op uitvoerkwaliteit en gedragsanalyse. Het monitort verschuivingen in embeddings, semantische drift en distributionele anomalieën die kunnen wijzen op opkomende problemen met modelbetrouwbaarheid of datainvoer. Het ondersteunt ook uitlegbaarheid door aan te tonen waarom bepaalde generaties worden gevlagd, wat teams helpt bij het verfijnen van prompts, modelkeuzes of guardrails.
LangKit werkt met zelf-gehoste of beheerde inferentiestacks en ondersteunt integratie met observabiliteits-backends zoals het WhyLabs Platform, OpenTelemetry of aangepaste dashboards. Het is bijzonder waardevol in gereguleerde omgevingen of klantgerichte applicaties, waar een slechte LLM-uitvoer echte consequenties kan hebben. Met LangKit krijgen teams proactieve kwaliteitsborging en vroege waarschuwingssignalen voordat fouten escaleren.

Arize AI biedt geavanceerde observabiliteits- en evaluatiefuncties die zijn afgestemd op productiewaardige LLM-implementaties. Oorspronkelijk gebouwd voor de monitoring van ML-modellen, heeft Arize zijn mogelijkheden uitgebreid om grote taalmodellen te ondersteunen, met de focus op analyses na implementatie, datadrift-detectie en de gezondheid van Retrieval-Augmented Generation (RAG).
Een van de sterkste punten van Arize is de monitoring van embedding-drift—het bijhouden van veranderingen in vectorrepresentaties in de loop van de tijd om semantische verschuivingen in gebruikersquery's of modelgedrag te signaleren. Het ondersteunt ook LLM-specifieke evaluaties zoals hallucinatiedetectie, relevantiescoring en de afstemming tussen prompt en uitvoer, wat teams helpt om de modelkwaliteit op schaal te benchmarken. RAG-pipelines profiteren van inzicht in retriever-latency, content-matchpercentages en kennislacunes.
Het platform integreert met OpenAI, Cohere, Hugging Face en aangepaste LLM's, en biedt gecentraliseerde dashboards en waarschuwingen. Met ondersteuning voor segmentatie op prompt-type, gebruikerssegmenten en feedbacklussen maakt Arize gedetailleerde modelanalyses en continue verbetering mogelijk. Het is een sterke keuze voor ondernemingen die kritieke LLM-applicaties draaien die observabiliteit vereisen die verder gaat dan eenvoudige logs op token-niveau.

Comet ML Observability breidt zijn suite voor ML-experimenten en tracking uit met uitgebreide ondersteuning voor LLM-applicaties. Ontworpen voor onderzoek- en productieteams maakt Comet gedetailleerde tracking mogelijk van prompts, reacties, token-aantallen, latency en interacties op gebruikersniveau in LLM-workflows. Het ondersteunt zowel vooraf gebouwde als aangepaste metrieken, waardoor het aanpasbaar is voor diverse toepassingen zoals prompt-tuning, modelevaluatie en A/B-testen.
Met de LLM-observabiliteitstools van Comet kunnen teams prompt-varianten vergelijken, prestaties in de loop van de tijd visualisereen en prompt-runs annoteren voor gezamenlijke debugging. Dankzij een nauwe integratie met modeltraining- en inferentiepipelines verenigd het de monitoring over de fasen van de modellevenscyclus, van fine-tuning tot implementatie. Teams kunnen experimenten taggen, schendingen van guardrails monitoren en waarschuwingen instellen voor afwijkend gedrag.
Het ondersteunt ook integratie met OpenAI, Hugging Face, LangChain en aangepaste endpoints, waardoor het geschikt is voor zowel gehoste als zelfbeheerde LLM's. Voor teams die Comet al gebruiken voor modelontwikkeling voegt deze uitbreiding waardevolle transparantie en governance toe aan LLM-gebruik.
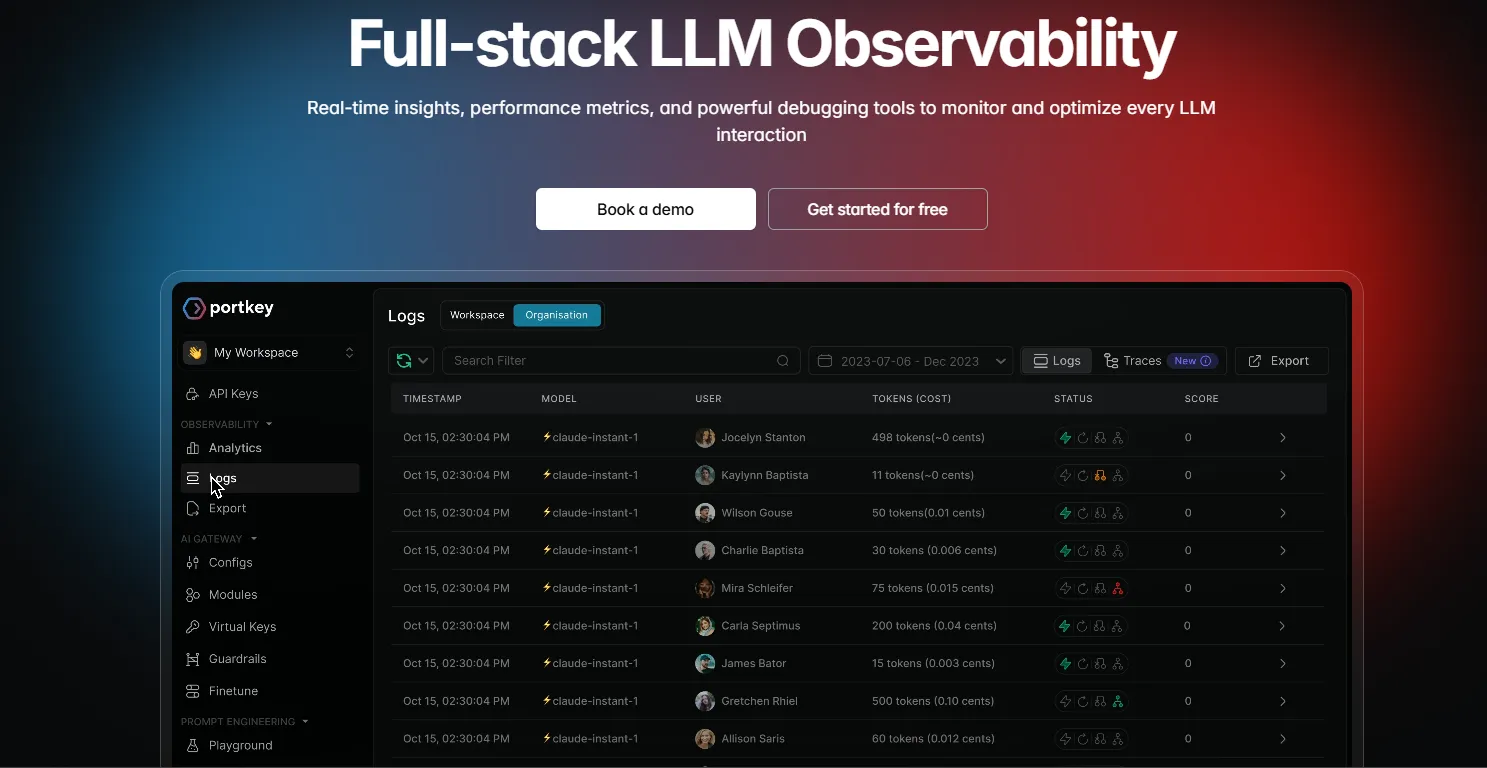
Portkey werd opgrote schaal bekend door zijn open-source LLM Gateway, die verenigde toegang biedt tot meer dan 100 LLM-providers via een enkele API. Het breidde zich later uit naar LLM-observabiliteit, wat teams helpt bij het monitoren en beheren van AI-applicaties op schaal.
Het platform werkt als een proxylaag tussen uw applicatie en LLM-providers, waardoor teams prompt-bibliotheken, routingregels, retries, temperatuurinstellingen en modelconfiguraties gecentraliseerd kunnen beheren. Portkey ondersteunt ook responscaching, load balancing en fallback-routing om de betrouwbaarheid te verbeteren en infrastructuurkosten te verlagen.
Voor observabiliteit legt Portkey request- en response-logs, tokengebruik, latency en modelanalytics vast. De nadruk ligt echter voornamelijk op het loggen van interacties in plaats van volledige workflow-tracing. De combinatie van gateway-beheer en monitoring maakt het een sterke keuze voor hoog-volume AI-implementaties met meerdere modellen.
LangSmith is een commercieel tracing- en observabiliteitsplatform ontwikkeld door LangChain, een van de snelst groeiende LLM-orchestratie-frameworks. Sinds de lancering in juli 2023 is het snel gegroeid samen met het LangChain-ecosysteem en zijn grote ontwikkelaarscommunity.
LangSmith is diep geïntegreerd met LangChain, waardoor ontwikkelaars automatisch traces kunnen vastleggen van prompts, modeluitvoer, tool-aanroepen, latency en uitvoeringsstromen zonder grote code-wijzigingen. Het ondersteunt ook workflows buiten LangChain, wat het nuttig maakt voor het debuggen van complexe LLM-applicaties en op agents gebaseerde systemen.
Het platform bevat evaluatietools waarmee teams handmatig uitvoer kunnen beoordelen of op LLM gebaseerde evaluatoren kunnen gebruiken voor geautomatiseerde scoring en benchmarking. LangSmith biedt ook analytics en beperkte kostenmonitoring, voornamelijk voor OpenAI-gebruik. Hoewel het in het standaardaanbod geen self-hosting biedt, blijft het een populaire keuze voor teams die gericht zijn op het tracen en debuggen van LLM-workflows.
Het selecteren van de juiste LLM-observabiliteitstool kan het verschil maken tussen het met vertrouwen schalen van AI-systemen en blind varen met onvoorspelbaar modelgedrag. Omdat LLM's diep geïntegreerd raken in klantgerichte applicaties waar veel op het spel staat, moet observabiliteit verder gaan dan eenvoudige logs en metrieken. Hier zijn de belangrijkste criteria om te evalueren bij het kiezen van de juiste oplossing:
Tracing en telemetrie op prompt-niveau
De kern van LLM-observabiliteit is het vermogen om elke prompt van begin tot eind te tracen. Een goede tool moet prompt-inhoud, invoermetadata, modelresponsen, tokengebruik (invoer en uitvoer), latency en downstream-systeemimpact vastleggen. Deze zichtbaarheid helpt bij het diagnosticeren van fouten, het optimaliseren van kosten en het monitoren van kwaliteit.
Ondersteuning voor meerdere LLM-providers en modellen
Aangezien moderne applicaties verschillende modellen kunnen gebruiken (OpenAI, Anthropic, Mistral, self-hosted via vLLM, enz.), moet het observabiliteitsplatform naadloos integreren met alle providers. Het moet verenigde weergaven bieden en het OpenAI-compatibele API-formaat ondersteunen voor eenvoudige adoptie.
Realtime monitoring en alarmering
Zoek naar systemen die realtime dashboards, latency-heatmaps en metrieken over tokenverbruik ondersteunen. Belangrijker nog: ze moeten waarschuwingen mogelijk maken bij ongebruikelijk gedrag, zoals een piek in foutpercentages, overmatige latency of mislukte prompts. Dit maakt snellere reactie en oplossing mogelijk tijdens productie-incidenten.
Schending van guardrails en beleidsauditing
Een tool op enterprise-niveau moet schendingen van guardrails bijhouden, evenals gevallen waarin invoer of uitvoer het moderatie- of veiligheidsbeleid overschrijdt. Dit is essentieel voor het behoud van compliance en het afstemmen van modelgedrag op de standaarden van de organisatie.
Kostentoewijzing en budgethandhaving
Geavanceerde observabiliteitsplatformen bieden gedetailleerde kostentracking tot op het niveau van de gebruiker, het model of de prompt. Krachtige mogelijkheden voor een LLM-kostenmonitoringoplossing stellen engineering- en financeteams in staat om het gebruik in real time te monitoren, budgetten te handhaven en onopgemerkte kostenoverschrijdingen in productie te voorkomen. Sommige bieden integratie met facturingsystemen of dwingen gebruikslimieten af via waarschuwingen en geautomatiseerde besturingselementen. Dit helpt engineering- en financeteams op één lijn te blijven.
Rolgebaseerde toegang en weergaven op teamniveau
Voor grote organisaties is het vermogen om gegevens te filteren op gebruiker, team of project essentieel. Observabiliteitstools moeten RBAC ondersteunen en afgebakende toegang bieden, zodat teams alleen relevante traces en logs zien.
Integratie met dev-tools en datalakes
Kies platformen die API's, exportfunctionaliteit en ondersteuning bieden voor data-sinks zoals ClickHouse, BigQuery of OpenTelemetry. Dit zorgt ervoor dat observabiliteitsdata kan worden uitgebreid naar analytics, compliance-audits of workflows voor het fine-tunen van modellen.
Een veelzijdige observabiliteitstool helpt u niet alleen de prestaties te monitoren, maar verbetert ook de model-governance, de debuggingsnelheid en de kostenbeheersing. Geef prioriteit aan flexibiliteit, beveiliging en realtime inzichten om uw LLM-stack toekomstbestendig te maken.
Voor meer informatie over hoe kostentoewijzing en budgettering werken, leest u onze diepgaande gids over: AI Cost Observability: Tracking and Controlling LLM Spend in Production
Naarmate op LLM gebaseerde applicaties van de experimenteerfase naar productie verhuizen, wordt observability essentieel voor betrouwbaarheid, veiligheid en schaalbaarheid. In tegenstelling tot traditionele softwaresystemen genereren LLM's probabilistische uitvoer, wat betekent dat dezelfde invoer verschillende antwoorden kan opleveren, afhankelijk van de context, het promptontwerp of de modelstatus. Zonder inzicht in hoe deze systemen zich gedragen, worden foutopsporing en optimalisatie uiterst moeilijk.
Een van de belangrijkste redenen waarom LLM observability van belang is, is de detectie van hallucinaties. Modellen kunnen vol zelfvertrouwen onnauwkeurige of misleidende antwoorden genereren, vooral in klantgerichte applicaties. Observability-tools helpen teams om prompts te traceren, uitvoer te inspecteren en te identificeren waar hallucinaties optreden, zodat ze prompts, retrieval pipelines of guardrails kunnen verbeteren.
Kostenbeheer is een ander belangrijk aandachtspunt. Omdat veel LLM API's kosten in rekening brengen op basis van tokenverbruik, kunnen zelfs kleine inefficiënties leiden tot grootschalige kostenoverschrijdingen. Observability-platformen volgen tokenverbruik, latency en doorvoer in realtime, waardoor teams prompts kunnen optimaliseren en onnodige API-uitgaven kunnen verminderen.
LLM observability verbetert ook de betrouwbaarheid en gebruikerservaring. Door latency-pieken, mislukte verzoeken of verslechterde uitvoerkwaliteit te monitoren, kunnen teams sneller reageren op incidenten en het prestatieniveau van de applicatie op peil houden. Dit is met name belangrijk voor AI-agents, copilots en RAG-pipelines die afhankelijk zijn van meerdere modelaanroepen en externe tools.
Beveiliging en compliance zijn even belangrijk. Observability helpt bij het detecteren van prompt injection-aanvallen, toxische uitvoer, beleidsschendingen en ongeautoriseerde blootstelling van gegevens. Voor ondernemingen die actief zijn in gereguleerde sectoren zoals de gezondheidszorg of de financiële sector, is dit inzicht cruciaal voor governance en auditeerbaarheid.
Uiteindelijk transformeert observability LLM-systemen van black boxes naar beheersbare, productieklare infrastructuur. Het stelt teams in staat om op schaal veiligere, efficiëntere en betrouwbaardere AI-applicaties te bouwen.
TrueFoundry onderscheidt zich als een van de meest complete platformen voor enterprise-grade LLM observability, omdat het diepgaande tracing, realtime analytics, governance en kosteninzicht combineert in één productieklare stack.
Een van de sterkste voordelen van TrueFoundry is de end-to-end tracing-architectuur. Elke LLM-interactie wordt vastgelegd in de gehele workflow, inclusief prompts, antwoorden, latency, modelmetadata, tool calls, fallback-gebeurtenissen en stroomafwaartse afhankelijkheden. Dit stelt teams in staat om complexe AI-systemen te debuggen met volledig inzicht in elke inferentiestap.
Het platform biedt ook geavanceerde realtime monitoringdashboards die het volgende bijhouden:
Deze inzichten helpen teams om snel knelpunten te identificeren voordat ze impact hebben op gebruikers of de infrastructuurkosten verhogen.
Een ander groot pluspunt is de gedetailleerde kostentoewijzing. TrueFoundry stelt organisaties in staat om tokenverbruik en uitgaven te volgen per:
Dit niveau van inzicht is uiterst waardevol voor ondernemingen die grootschalige GenAI-workloads uitvoeren over meerdere afdelingen.
In tegenstelling tot veel lichtgewicht observability-tools is TrueFoundry ontworpen voor productie-AI-operations. Het ondersteunt:
Dit maakt het bijzonder aantrekkelijk voor organisaties die gevoelige of gereguleerde gegevens verwerken.
TrueFoundry integreert bovendien naadloos met moderne LLM-ecosystemen, waaronder OpenAI-compatibele API's, LangChain-workflows, RAG-pipelines en custom inferentie-stacks. Teams kunnen observability invoeren zonder hun infrastructuur te hoeven herbouwen.
Voor ondernemingen die AI op een verantwoorde manier willen schalen en tegelijkertijd governance, betrouwbaarheid en kostenefficiëntie willen behouden, levert TrueFoundry een van de meest complete LLM observability-oplossingen die in 2026 beschikbaar zijn.
Nu LLM's een fundament vormen in moderne applicaties, is observability niet langer optioneel; het is essentieel. De juiste tools, zoals TrueFoundry LLM observability, helpen teams om promptgedrag te volgen, kosten te beheren, storingen te detecteren en te zorgen voor een verantwoorde implementatie van AI op schaal. Of u nu latency optimaliseert, beschermt tegen hallucinaties of tokenverbruik analyseert, deze tools bieden het inzicht dat nodig is om met vertrouwen te werken.
Platformen zoals TrueFoundry, Langfuse en Arize lopen voorop met enterprise-grade functionaliteiten, terwijl andere lichte opties bieden voor snelle integratie. Uiteindelijk hangt de beste tool af van uw stack, governance-behoeften en de schaal van uw operations. Investeren in observability vandaag garandeert veiligere, slimmere LLM-systemen morgen.
Krijg volledig inzicht in uw productietraces en optimaliseer kosten met TrueFoundry, het beste LLM observability-platform voor enterprise AI-workloads. Boek vandaag nog een demo om ervoor te zorgen dat uw modellen betrouwbaar, veilig en efficiënt zijn.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



The best LLM observability platform ensures reliable scaling of your AI applications. TrueFoundry stands out by offering seamless integration and robust performance monitoring for diverse models. It provides granular cost monitoring, making it an ideal choice for optimizing LLM apps while preventing expensive overruns and ensuring high response quality.
The top LLM observability tools for 2026 include TrueFoundry, LangSmith, Arize, WhyLabs, and PromptLayer. These platforms offer key features like prompt-level tracing and production traces. TrueFoundry excels with flexible deployment options, helping teams manage production workloads efficiently while meeting specific governance and data privacy needs.
When evaluating LLM observability tools, prioritize data privacy, low latency, and secure access control. The right observability platform must handle sensitive data safely while offering real-time performance tracking. TrueFoundry meets these criteria with seamless integration and comprehensive telemetry data, ensuring your production data remains secure.
Most modern LLM observability tools add very little latency, usually a few milliseconds per request. Platforms like TrueFoundry optimize telemetry collection using asynchronous logging and lightweight tracing, ensuring observability does not significantly impact production performance or user experience.
For enterprises that require data privacy and infrastructure control, self-hosted observability platforms are often preferred. TrueFoundry and Langfuse are among the strongest self-hosted options because they support secure deployments, flexible integrations, and complete visibility into production LLM workloads and telemetry data.
Als toonaangevend LLM-observabilityplatform legt TrueFoundry gedetailleerde telemetriedata vast over alle productieomgevingen heen. Het biedt inzichten met lage latentie en tokenkostentracking, wat teams helpt elke LLM-aanroep te optimaliseren. Met end-to-end tracing en gebruikersfeedbackloops stelt het ontwikkelaars in staat complexe AI-workloads effectief te debuggen.
While LLM observability tools vary, open source options often allow self-hosting for flexible deployment options. Commercial solutions typically provide managed infrastructure for reliable AI operations. TrueFoundry bridges these needs, offering an enterprise-grade observability solution that protects sensitive information while simplifying data collection and prompt versioning.



Het laatste nieuws, artikelen en bronnen in je inbox



















