



October 15, 2026
|
5 min read

Published: October 8, 2026
Blazingly fast way to build, track and deploy your models!
静かなアーキテクチャの転換が、すでに始まっています。
企業は当初、アプリケーションをOpenAI、Anthropic、Gemini、オープンソースモデル、そして社内モデルに接続することから始めました。APIキー、レート制限、プロバイダーのルーティング、利用状況の追跡のためにゲートウェイを追加しました。そして、エージェントが登場しました。
突然、スタックにはMCPサーバー、A2A通信、ツール認証、メモリ、コンテキスト管理、人間の承認、推論ルーティング、リトライ、評価、ポリシー適用が必要になりました。要件が増えるたびに、新たな製品、プロキシ、ライブラリ、あるいはチームが生まれていきました。
その結果はよくある光景です。優れたツールや制御ポイントはいくつもあるのに、業務全体を把握できる場所がどこにもないのです。
エージェントは、3つのモデルを呼び出し、5つのツールを実行し、サブエージェントに委任し、承認のために一時停止し、メモリから再開し、本番システムを更新します。コスト、リスク、レイテンシ、そしてビジネス価値は、ステップごとに変化します。
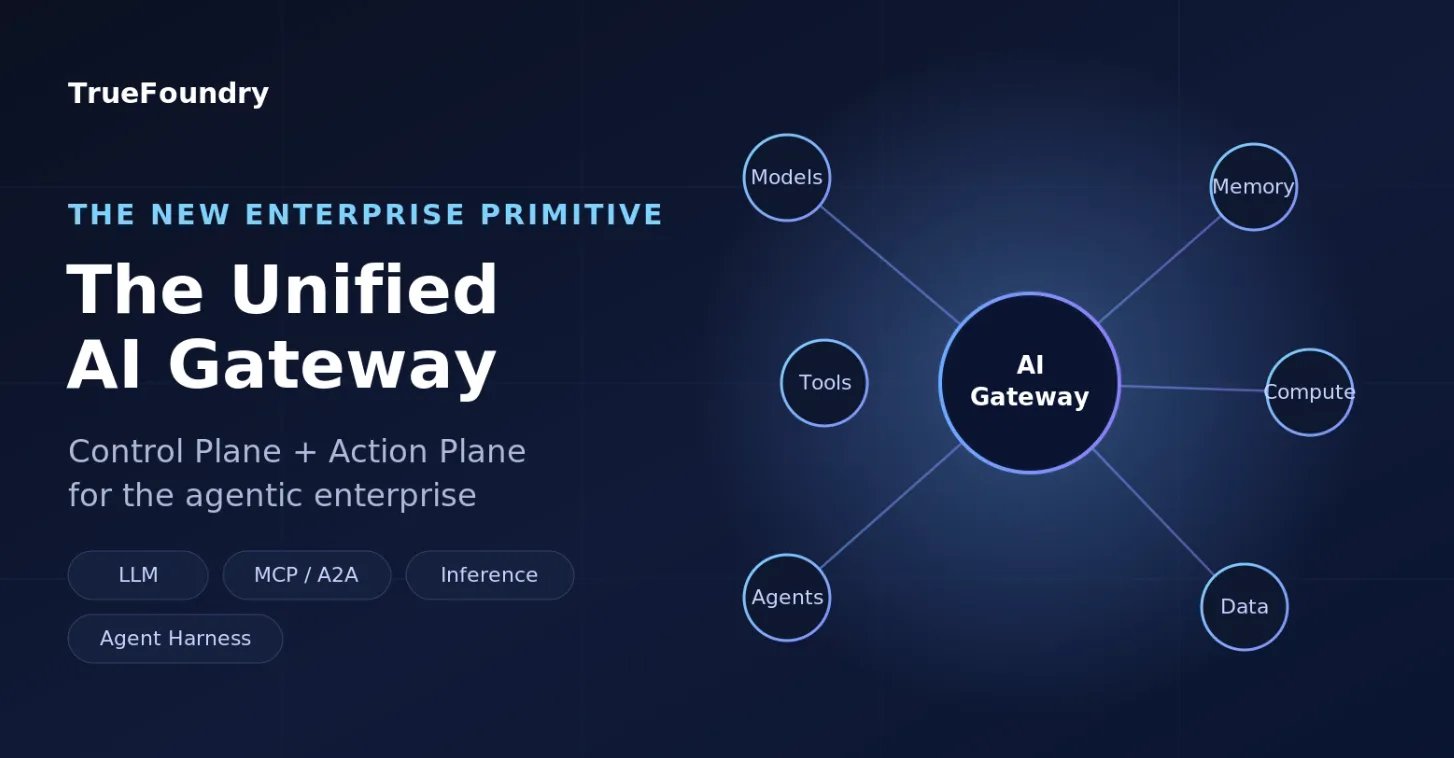
これこそが、ゲートウェイが以下へと進化している理由です。 モデル、ツール、エージェント、データ、コンピューティングを横断する「制御プレーン」および「実行プレーン」 モデル、ツール、エージェント、データ、コンピューティングを横断する。
私は、AIゲートウェイがトークンの最大化と価値の最大化の両面において、企業の基盤となるプリミティブになると考えています。
トークンの最大化とは、すべてのトークン、モデル呼び出し、GPUサイクル、そして支出単位から、より多くの有用な成果を引き出すことを意味します。
価値の最大化とは、各タスクに対して、最も優れたビジネス成果を生み出すモデル、ツール、ワークフロー、制御セットを組み合わせることを意味します。
文書分類タスクは、小規模な社内モデルで完璧に処理できるかもしれません。複雑な与信分析には、最先端のモデルが必要になるでしょう。カスタマーサービスエージェントは、検索には高速なモデルを、推論には強力なモデルを、そして最終的なトランザクションには決定論的なツールを使用するかもしれません。規制の厳しいワークフローでは、ソブリンモデル、プライベートエンドポイント、そして人間のチェックポイントが必要になるでしょう。
ゲートウェイは、それらの選択が行われる場所となります。
私の主張は単純です。AIゲートウェイは単なるルーティングを超えて進化し、エージェント型システムのオーケストレーションレイヤーとなります。コスト、レイテンシ、ガードレール、ガバナンス、データの機密性、タスク要件に基づいて、モデルを動的に選択・切り替えを行うようになるでしょう。
すべてのタスクには、異なる経済的およびリスクプロファイルが存在します。ゲートウェイは、その特性に合わせて処理を行うべきなのです。
エージェントの規模が拡大するにつれ、ワークロードを適切なモデルにインテリジェントに割り当てることが、コストとビジネス価値を最適化する鍵となります。企業が数千ものワークフロー全体でパフォーマンス、ガバナンス、経済性のバランスを取る中で、これは大きなチャンスを生み出しています。
従来のゲートウェイは、エンドポイント、リクエスト、レスポンス、およびサービスIDを中心に構築されていました。
エージェントの導入により、セッション、プラン、委任された権限、メモリ、ツール呼び出し、長時間実行される状態といった要素が加わりました。ゲートウェイには今や、誰がタスクを開始したのか、どのアージェントが動作しているのか、どのような権限が委任されたのか、どのデータにアクセスできるのか、どのツールを呼び出せるのか、予算はいくらか、どのステップにどのモデルが適しているのか、そしてどのような承認が必要なのかを把握することが求められています。
こうした問いかけにより、ゲートウェイは意思決定エンジンへと進化します。
支払いの照会と支払いの実行は、同じアプリケーションとプロトコルを使用するかもしれませんが、そのリスクプロファイルは劇的に異なります。ゲートウェイには、意図とアクションのレベルでのポリシーが必要です。
そこで重要になるのが「アクションプレーン」です。これは、エージェントが何を行えるか、どのように行うか、そしてアクションが記録システムに到達する前に何が必要かを制御します。
LLMゲートウェイはすでに、プロバイダーアクセス、フォールバック、レート制限、トークン予算、可観測性を処理しています。
次の役割はより深いものです。能力、価格、レイテンシ、コンテキスト長、データポリシー、ビジネス上の重要性に基づいて、各ステップに最適なモデルを選択することです。ルーティングは、静的なルールからワークロードを認識したオーケストレーションへと移行します。
MCPはエージェントをツール、データ、エンタープライズシステムに接続します。A2Aはエージェント同士の通信と委任を可能にします。
ゲートウェイは、委任チェーンの保持、ツールレベルの権限の強制、OAuthトークンの仲介、スコープの検証、テナントの分離、そしてすべてのアクションの記録を行わなければなりません。エージェントのIDは、最優先のセキュリティプリミティブとなります。
企業は、パブリックAPI、プライベートクラウド、オンプレミスクラスター、ソブリン環境、エッジインフラストラクチャなど、さまざまな環境でモデルを実行することになります。
推論ゲートウェイは、容量、局所性、データレジデンシー、GPUの可用性、コスト、パフォーマンスに基づいて、ワークロードの実行場所を決定します。これにより、アプリケーションの意図とインフラストラクチャの経済性の間に直接的な架け橋が築かれます。
エージェントハーネスは、ツールの使用、リトライ、エラー復旧、コンテキストの圧縮、メモリの永続化、状態のオフロード、サブエージェントの状態、ライフサイクルフック、権限、人間の承認、検証、テレメトリを管理します。
これらの機能がルーティングやポリシーと並んで配置されると、ゲートウェイとハーネスの境界線は消え始めます。
コントロールプレーンは、ID、ポリシー、ルーティング、予算、モデルの適格性、データの保存場所、ツールの権限、リスクしきい値、承認要件を定義します。
「どのような条件で、どのリソースを使用して、何を行うべきか」という問いに答えます。
アクションプレーンは、モデルの呼び出し、ツールの起動、セッション管理、エージェントの調整、リトライ処理、状態のチェックポイント保存、承認依頼、出力の検証、証跡の記録を行います。
「意図から成果まで、どのように安全に業務を進めるか」という問いに答えます。
これらの責任範囲を連携させることで、大きな利点が生まれます。モデルの停止時には安全なフォールバックを起動し、予算のしきい値を超えればより軽量なモデルへルーティングし、機密データはプライベートエンドポイントへ転送し、高リスクなアクションには人の承認を求めることができます。
ワークフローの柔軟性を保ちつつ、企業ポリシーの一貫性を維持します。
ゲートウェイは、ユーザーの意図、エージェントの計画、モデルの選択、コンテキストソース、ツール呼び出し、ポリシー決定、承認、コスト、レイテンシ、最終的な成果といった全軌跡をキャプチャする必要があります。
このトレースデータは、監査、インシデントレビュー、モデル比較、ポリシー調整、タスク完了あたりのコスト測定を支えます。
ゲートウェイは、会話の要約、状態のオフロード、サブエージェントのメモリ分離、モデルに返すコンテキストの制御を行います。検証プロセスでは、スキーマチェック、ビジネスルール、根拠の確認、決定論的検証、二次モデルによるレビュー、そして人の承認を経て、ループを完結させます。
ゲートウェイは、出力を信頼できるアクションへと変える場所となります。
エージェント群は、モデル、ツール、サブエージェント間で大規模なファンアウト(拡散)を引き起こします。1つのユーザーリクエストが数十もの下流呼び出しを誘発するため、ゲートウェイのレイテンシ、メモリ使用量、スループットは、コストと信頼性に直結する問題となります。
エージェントゲートウェイは、Rustを用いた第一原理アプローチを採用し、軽量なランタイム、高スループット、エージェントプロトコルへのネイティブ対応を実現しています。公開されているベンチマーク環境では、メモリ使用量約30MB、毎秒165,000リクエスト、レイテンシ0.09ミリ秒という数値を記録しています。
正確な数値はワークロードやインフラによって異なりますが、原則は明確です。わずか1ミリ秒の遅延やリトライ、メモリ割り当ての積み重ねが、数千のエージェント全体で増幅されます。エンタープライズ規模において、ゲートウェイのパフォーマンスは推論コストやユーザー体験に直接影響し、インフラがボトルネックとなる前にプラットフォームをどこまで拡張できるかを左右します。
統合されたゲートウェイにより、企業はモデル、ツール、エージェント、推論、ID、コスト、証跡を一元管理できるようになります。
チームはモデルのポータビリティを確保し、セキュリティチームはアクションレベルでの強制力を得られます。財務チームはワークフローに紐づいた予算管理が可能となり、プラットフォームチームはプロバイダーやプライベートインフラを横断したルーティングを実現します。リスク管理チームは、ユーザーの意図から最終的なアクションに至るまでのトレーサビリティを確保できます。
プラットフォームが複雑な処理を一度で完結させるため、プロダクトチームは開発スピードを向上させることができます。
新しいモデルを迅速に導入でき、既存のポリシーを新しいツールに継承させることが可能です。新しいエージェントは、ID、メモリ、可観測性、承認パターンを共通して利用できます。すべてのユースケースが同一の基盤の上に構築されます。
エンタープライズAIの次のフェーズは、オーケストレーションの品質によって定義されるでしょう。
モデルは進化し続け、プロトコルは成熟していきます。推論はクラウドやプライベートインフラ全体に分散し、エージェントはより自律的になり、基幹システムとより深く連携するようになります。
企業には、実行パス全体を可視化し、リアルタイムで制御できる単一のレイヤーが必要です。
それがAIゲートウェイです。
これは、ポリシー、ID、ルーティング、ガバナンス、経済性を管理するコントロールプレーンとして機能します。
これは、オーケストレーション、ツール、メモリ、検証、実行を担うアクションプレーンとして機能します。
優れたゲートウェイとは、適切なモデル、ツール、コンピューティングリソース、制御、そして人間による介入レベルを選択し、あらゆるステップでエージェントがより良い判断を下せるよう支援するものです。
それこそが、企業が単なるAIの活用から、真のビジネス価値の創出へと移行するための道筋です。
私が注目しているのは、TrueFoundryがモデルルーティング、MCPアクセス、エージェント実行、推論管理を一つのガバナンス下にあるプラットフォームに統合している点です。このゲートウェイは、ホスト型およびセルフマネージド型の両モデルにおいて、認証、レート制限、予算管理、ガードレール、可観測性、フェイルオーバーを処理します。そのMCPレイヤーは、制御されたツール検出、OAuth、トークン交換、ツールレベルのポリシーを追加し、Agent Hubはそれらの制御をサブエージェントのオーケストレーションと実行にまで拡張します。実務レベルで見れば、企業はモデル選択からツール利用、最終的なアクションまで、一貫したパスを得ることができます。これこそが、実用的なコントロール&アクションプレーンの理想的な姿です。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.
























