Built for Speed: ~10ms Latency, Even Under Load Blazingly fast way to build, track and deploy your models!
Handles 350+ RPS on just 1 vCPU — no tuning needed Production-ready with full enterprise support 機械学習(ML)および大規模言語モデル(LLM)のワークロードは、クラウド上での実行コストが非常に高いことで知られています。これは、膨大な計算能力、メモリ、ストレージが必要となるためです。しかし、拡張性や信頼性を犠牲にすることなく、ML/LLMワークロードのクラウドコストを削減する方法が存在します。
コストを削減するための主要な原則 DevOpsエンジニアおよびデベロッパーに対する可視性の向上: 複数のクラウドにわたって複数のコンポーネントがデプロイされている場合、クラウドコストの可視性を得ることは困難です。 TrueFoundryは、クラスター、ワークスペース、およびデプロイメントの各レベルでクラウドコストの可視性を提供し、DevOpsチームやデベロッパーがML/LLMのライフサイクル全体を通じてコスト削減の機会を特定し最適化できるようにします。リソース調整の容易さ: TrueFoundryにより、DevOpsチームとデベロッパーは得られたコスト可視性に基づいて即座に行動を起こすことができます。DevOpsチーム はプロジェクトレベルでリソース制限を設定でき、各チームのワークロードが予算を超えることなく必要なリソースにアクセスできるように保証します。デベロッパー も、得られたインサイトに基づいて外出先からでも簡単にリソースを調整できます。さらに、TrueFoundryを使用すると、非本番環境でアプリケーションやIDEを簡単にゼロにスケーリングできるため、アイドル状態のリソースコストを排除し、コスト削減のためのイテレーションサイクルをより効率的にすることができます。コストに向けたインフラストラクチャの最適化: TrueFoundryのKubernetesベースのアーキテクチャとインフラストラクチャの最適化は、クラウドコストを削減するように設計されています。 全体として、TrueFoundryのコスト削減機能は、DevOpsチームとデベロッパーに対して、ML/LLMライフサイクル全体でクラウドコストを削減するために必要な可視性、制御、および最適化機能を提供します。
AMIからDockerへの移行: 当社のプラットフォームは、多くの企業がAMIからDockerへ移行するのを支援しており、企業はすでに30〜40パーセントのコスト削減を経験しています。TrueFoundry: コストファーストなプラットフォーム TrueFoundryは、Kubernetesを中心に構築された「コストファースト」なプラットフォームであり、効率性、クラウドの拡張性 、およびコスト削減を最優先するアーキテクチャで設計されています。
信頼性と拡張性を最適化しながら、TrueFoundry独自のアーキテクチャがどのようにコスト削減を可能にするかを見ていきましょう。以下が本プラットフォームの階層構造です:
クラスター: AWS EKS、Azure AKS、GCP GKE、オンプレミスなど、すべてのクラスターをプラットフォームに接続します。これにより、すべてのクラスターを1つの場所でシームレスに統合できます。これらのクラスターは、広範なサービス、モデル、およびジョブをデプロイするための基盤となります。ワークスペース: クラスター内にワークスペースを導入することで、アクセス制御と分離を追加する合理的なアプローチを提供し、各プロジェクトや環境が独自の専用リソースを持ち、不正アクセスから保護されるようにします。デプロイメントのグループと考えてください。デプロイメント: これらのワークスペース内にはデプロイメントがあり、さまざまな種類のオブジェクトのデプロイをサポートします。TrueFoundryを使用すると、ML開発ライフサイクルのあらゆる側面を容易にカバーできます。インタラクティブ開発環境: 協調的な実験のためにJupyter NotebookおよびVS Codeをデプロイします。トレーニングおよびファインチューニングジョブ: ジョブとしてデプロイすることで、MLモデルのトレーニングやLLMモデルのファインチューニングを効率的に実行します。事前学習済みLLM: モデルカタログを使用して、特定の実用的なケース向けに事前学習済み大規模言語モデルを迅速にデプロイします。サービスとアプリ: モデルやWebアプリなど、さまざまなサービスやアプリケーションをデプロイします。アプリケーションカタログ: Label Studio、Redis、Qdrantなどの人気ソフトウェアを簡単にデプロイできます。クラスターレベルでのコスト削減 Kubernetesベースのインフラストラクチャ Kubernetesは、ビンパッキングを採用してリソース利用率を最適化し、コンテナを効率的に配置することでインフラストラクチャコストを削減します。
TrueFoundryがKubernetesをどのように活用しているかの詳細はこちら をご覧ください。 💡
EC2からKubernetesへの移行:
マルチクラウドサポート TrueFoundryのマルチクラウドアーキテクチャ により、異なるクラウドプロバイダーへの接続が容易になります。
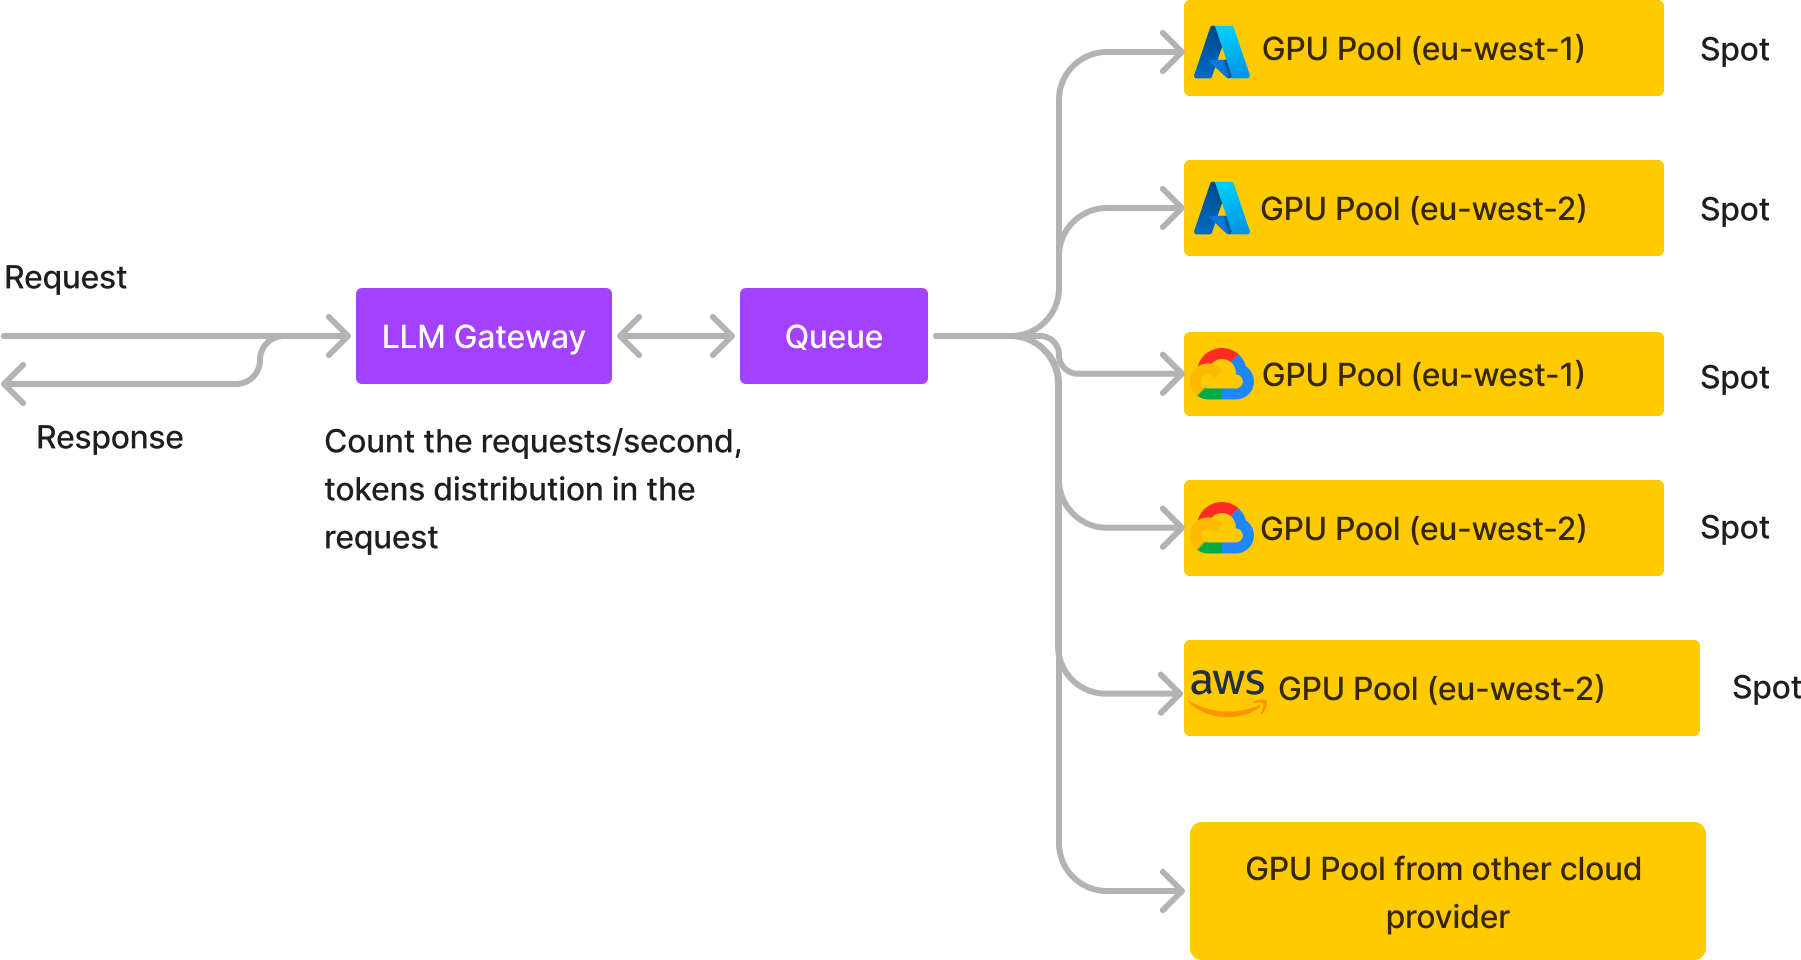
クラウド間を柔軟に切り替える機能 :クラウドおよび地域間でワークロードを分散 :高いインスタンスクォータの利用可能性 :複数のクラウドや地域にわたるLLMのスケーリング 💡
高アクセス(20+ RPSおよび1日あたり200万件以上のリクエスト)を抱える中規模の対話型AIチャットボットプロバイダーは、当社の非同期サービスを使用して、異なるクラウドおよび地域にまたがる5つのクラスター上で、分散スポットGPUインスタンスのみで完全に運用しています。これにより、信頼性とスループットを向上させながら、インフラストラクチャコストを60%削減しています。
可視性の強化 各クラスターにおいて、クラスター内で稼働しているノードの数を確認できます。また、次のようなノード固有の詳細に関するインサイトも得られます。
削減額の分析 :リソース割り当てのインサイト: キャパシティタイプのインサイト :ワークスペースレベルでのコスト削減 リソース制限 TrueFoundryでは、クラスター内に複数のワークスペースを作成できます。このセグメンテーションにより、異なるチームや環境ごとにデプロイメントを整理できます。
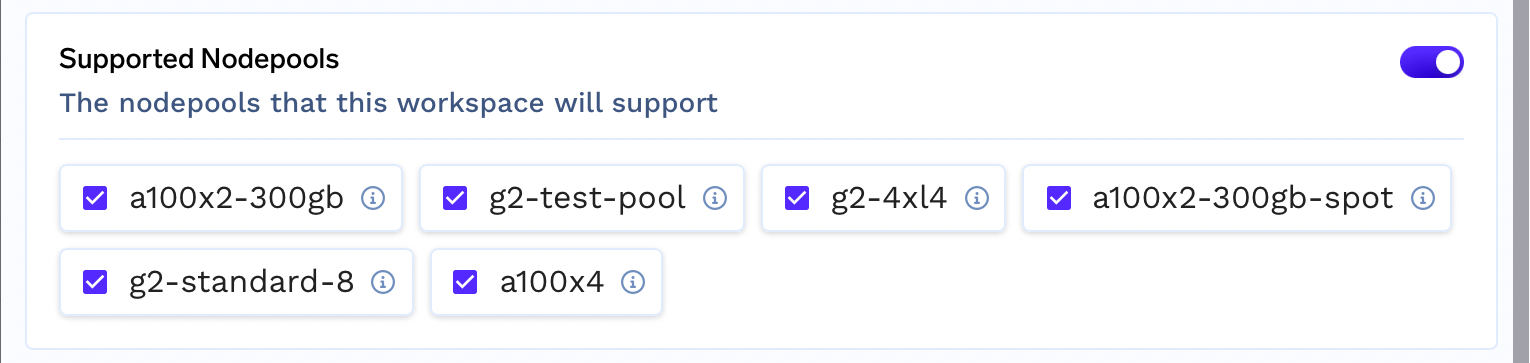
リソース制限 :サポートされるインスタンスファミリー :サポートされるノードプール :ワークスペースレベルのコスト追跡 また、過去の使用状況に基づいてワークスペースレベルのコストを追跡するための可視性も提供します。これにより、どのプロジェクトや環境が最も多くのリソースを使用しているか、どこでコスト削減が可能かを特定できます。
デプロイメントレベルでのコスト削減 大幅なコスト削減を実現するために、アプリケーションレベルで高度な機能を提供しています:
オンデマンドへのフォールバックを備えたスポットインスタンス : サービスの一時停止 :リソースの最適化 :リソースモニタリング :動的なリソース調整 :時間ベースのオートスケーリング :💡
当社のお客様の多くは、勤務時間外の自動シャットダウンをスケジューリングして週あたり128時間の計算使用量を削減することで、開発環境のクラウドコストを60%以上削減しています。
コードエディタレベルでのコスト削減 コードエディタ向けに特定の機能を提供しており、NotebookおよびVSCodeレベルで大幅なコスト削減を達成できます:
共有ボリューム :適応型リソース使用: 💡
動画生成分野で事業を展開し、非本番ワークロードのためにスポットインスタンス上で数百のJupyter Notebookを実行しているある生成AI企業は、必要なときだけGPUをオンに切り替えることで、クラウドコストを約50〜60%削減しました。
手動一時停止: 使用していないときはNotebook/VSCodeインスタンスを簡単に一時停止できます。コードとデータは保持されるため、必要なときにシームレスに再開できます。自動一時停止 :💡
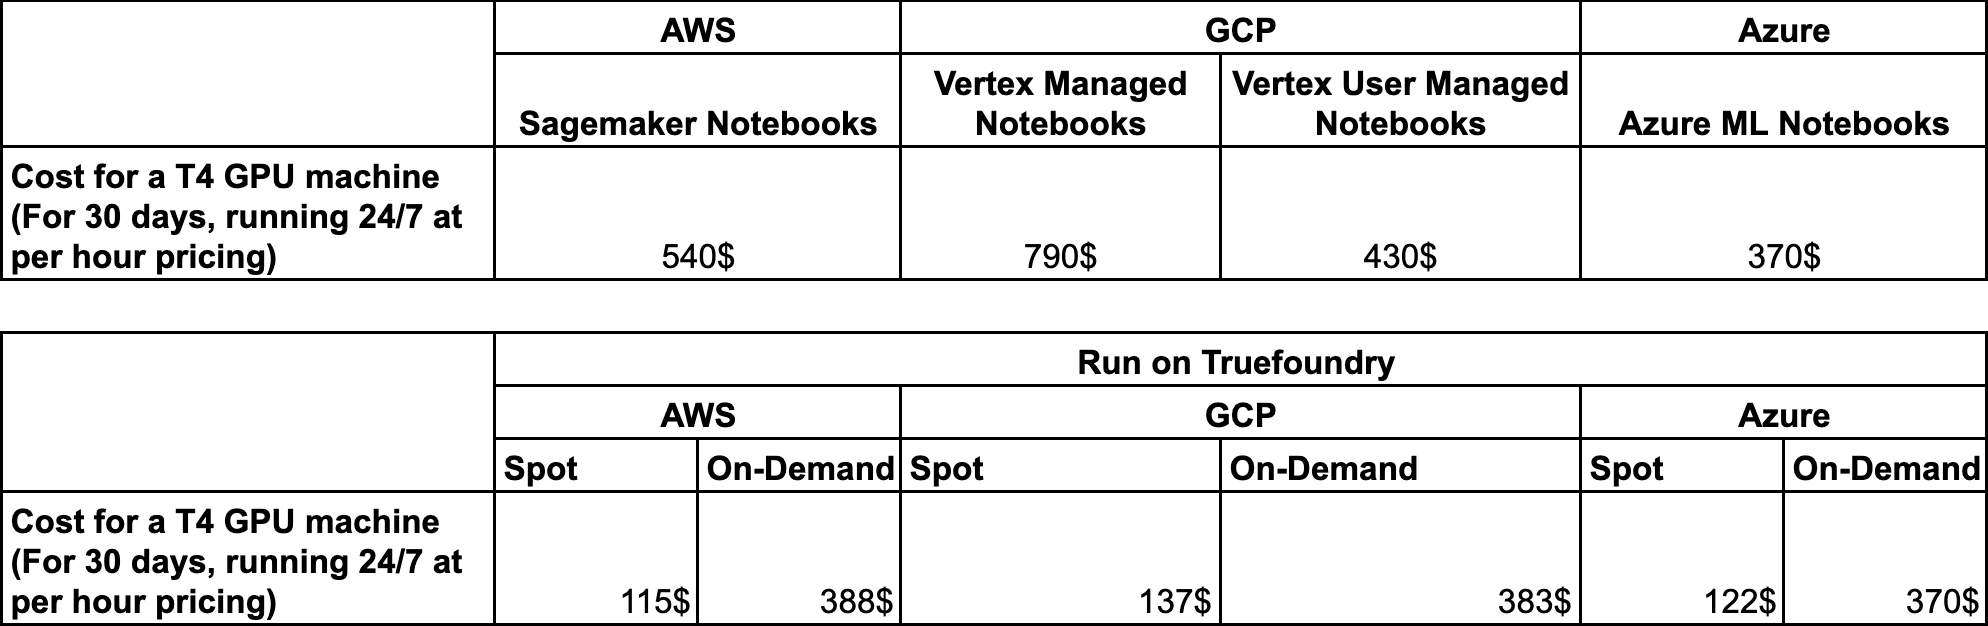
コストベンチマーク
Jupyter Notebookのコストベンチマーク
大規模言語モデル(LLM)のデプロイとファインチューニングにおけるコスト削減: 当社のモデルカタログは、よく知られた事前学習済みLLMのデプロイとファインチューニングを行うための便利なワンストップショップを提供します。これらのLLMのデプロイとファインチューニングを可能な限り費用対効果が高くなるよう、以下の対策を講じています:
最適化されたモデルサービング構成 :効率的なファインチューニング構成 :効率的なファインチューニング に関するブログはこちら:
非同期サポートによるスケーラブルなデプロイメント: 非同期サポートを備えた大規模なLLMのデプロイにより、3つのクラウドすべてでGPUクォータを活用し、ファインチューニングとデプロイに必要なGPUを確実に取得します。この追加された信頼性により、スポットインスタンスを使用できるようになり、費用を削減できます。詳細は非同期デプロイメントによる大規模なLLMのデプロイ 💡
ベンチマーク
💡
複数のFortune 100企業や中堅企業が、当社のプラットフォームを使用して大幅なコスト削減を実現しています。社内のSageMakerやクラウドプラットフォームを当社のシステムに置き換え、30〜40%のコストを削減した企業もあります。
また、一連の記事において、レイテンシ、コスト、および1秒あたりのリクエスト数の観点から、多くの一般的なオープンソースLLMのパフォーマンスをベンチマーク評価しました。これらはTrueFoundry Blogs で確認できます。
このブログで紹介したすべての機能のライブデモについては、こちらの動画もご覧いただけます:
VIDEO
TrueFoundry は、Kubernetes上のMLデプロイPaaSであり、インフラチームに完全なセキュリティとコントロールを保障しながら、モデルのテストとデプロイにおける完全な柔軟性を提供し、デベロッパーのワークフローを迅速化します。当社のプラットフォームを通じて、機械学習チームは100%の信頼性、拡張性、および数秒でのロールバック機能を備えて、15分でモデルをデプロイおよび監視 できるようになり、コストを削減してモデルをより迅速に本番環境へリリースし、リアルなビジネス価値の実現を可能にします。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.
Built for Speed: ~10ms Latency, Even Under Load