Blank white background with no objects or features visible.

EMEAの皆様へ。TrueFoundryは、ヨーロッパ、中東、アフリカ全域で事業を拡大しています。詳細はこちら →

True ML Talks #1 - Gongにおけるマシーンラーニングワークフロー

By TrueFoundry

Updated: November 3, 2026

Published: July 2, 2026

本日、TrueFoundryはMachine Learning Deep Dive Seriesを開始します。このシリーズでは、MLを活用している様々な企業のMLおよびData Scienceリーダーにお話を伺い、組織内におけるMLのユースケースやワークフローを深く掘り下げていきます。このシリーズの一環として、Gong、StichFix、SalesForce、Gusto、Simplなど、多くの企業のML Stackをホストし、詳しく探求していきます。

📌

本シリーズでは、Machine Learningの世界に足を踏み入れ、様々な業界におけるMLアプリケーションのスペクトラムとインフラストラクチャ構成を明らかにしていきます。

対話は主に以下の4つの主要テーマを中心に展開されます:
1. ビジネスにおけるMachine Learningのユースケース
2. TrainingおよびExperimentation Pipeline、DeploymentおよびServing、Monitoringを含むMachine Learning stackの構築方法、およびそれらのCost/Latencyの最適化手法
3. 業界特有の課題を伴うML stack構築における直面した課題
4. MLインフラストラクチャの構築およびスケーリングの過程で適用された最先端のイノベーションの概要

本シリーズの最初の議論を飾るため、GongのNoam Lotner氏にお話を伺いました。GongはRevenue Intelligenceプラットフォームです。収益チームの会話から顧客の実態を明らかにすることで、収益チームが最大の可能性を発揮できるように支援します。Gongは電話、Eメール、Webなどの顧客向けインタラクションを分析し、収益チームに最高のインサイトを提供することで、より多くの商談を成約に導くことができるようにします。 

Noam Lotner氏はGongのResearch Operations Team Leadを務めています。同氏はAI/MLリサーチグループ向けのオペレーショナルプラットフォームの構築を担当しており、モデルのリリースプロセス、実験管理、パフォーマンスプロセスの自動化、ラベリングおよびデータセット作成ツールの構築、本番データソースへのセキュアなアクセス環境の実現に取り組んでいます。

対話の内容は以下からご覧ください:

GongにおけるMachine Learningのユースケースとワークフロー 

セールスインテリジェンスプラットフォームであるGongにとってMLが重要な理由

Gongは、電話、Eメール、Webなどにわたる顧客向けのインタラクションを分析します。商談のやり取りを分析し、収益チームにインサイトを提供するためには、Machine Learningが不可欠となります。MLアルゴリズムは、ビデオ通話の分析、文字起こし、営業電話の分析など、以前は手動で行われていたタスクを自動化できます。これにより時間を節約し、営業プロセスの効率性を向上させることができます。

  1. ビデオ通話分析Pipeline → 通話を分析するために、チームはビデオを処理し、フレームを分類して、特定のタイプのビデオセグメントに対していくつかの処理を実行します。
  2. 音声文字起こし分析Pipeline → 音声は自動文字起こしされるとともに、音声の検出、どの話者がいつ話しているかの特定、会話内容の確認を行う複数のモデルで構成される別のパイプラインで処理されます。
  3. テキストNLPベースPipeline → スライドや商談メモから情報を抽出するためのパイプラインが存在します。Eメールに対しては、NLP処理、メッセージング、コメントのための異なるパイプラインが使用されます。

顧客全体でこれらのモデルはどのようにセグメント化されているか

これは当社がGongに尋ねた質問ですが、例外なくすべてのSaaS企業において以下の傾向が見られます:

  • すべての顧客に共通するモデル:音声の自動認識を行うASR Modelなどがこれに該当します。これらは標準化されたサービスを提供し、プラットフォーム全体で一貫性を維持するのに役立ちます。
  • 各顧客に固有のモデル:SaaSスタートアップの場合、特にGongのようなセールスインテリジェンスプラットフォームの場合、各モデルは固有である必要があります。これは、データのプライバシーとセキュリティを確保するとともに、顧客のデータセットでモデルをトレーニングしてカスタマイズやパーソナライズを提供するために行われます。これにはservingとデータプライバシーという2つの課題が伴います。Gongは顧客が自社のデータに基づいてモデルのトレーニングを行うことを許可しているため、プラットフォーム上にML Interfaceを公開する必要があり、その結果、顧客ごとのデータの隔離が課題となります。

📌

モデルの数:顧客数 X モデルのタイプ数 

📌

「私たちは全員に対して同じベースモデルを使用しています。また、顧客が自身のコンテンツに合わせて特定のモデルのトレーニングを行えるようにもしています。」

コストを最適化するために、Gongはインファレンス層でマルチモデルサービングを使用しています。別々のマシンで個別のモデルを実行すると、高コストなシステムになってしまうためです。

B2B営業におけるMLの活用について詳しく解説したGongの公式ブログはこちらです

‍

‍

GongにおけるMLシステムワークフロー

Gongでは、MLシステムはML組織の構造に合わせて構成されています。

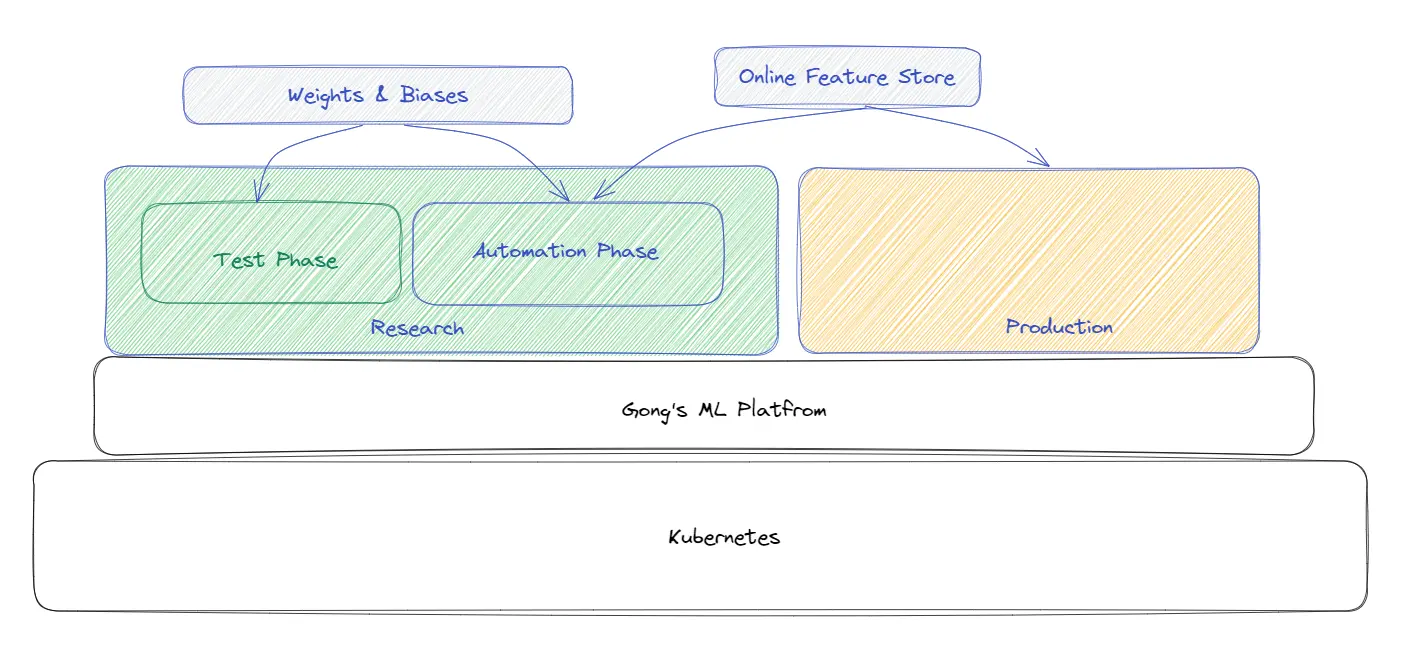
  • Research:リサーチ専用の独立した環境が存在します。チームは独立して作業を行い、データを取得し、トレーニングを行い、トレーニングを完了させてモデルをリリースします。その後、モデルはエンジニアリングチームが管理するデプロイメントパイプラインに送られます。
  • 本番デプロイメント(エンジニアリングの一部):トレーニングされたモデルは、エンジニアリングチームによって本番環境にデプロイされます。

このブログ(および対談シリーズ)では、Gongのリサーチ側インフラストラクチャにおける課題についてさらに深く掘り下げていきます。

GongにおけるMLリサーチャーのワークフローはどのように構築されているか?

Machine Learning System Workflow at Gong
GongにおけるMachine Learningシステムワークフロー
  • 基本テストフェーズ:リサーチャーはデータを取得し、本番環境から自身のマシンにデータを抽出して、ローカルマシンまたはVMを使用してトレーニングを行います。
  • 自動化フェーズ:モデルが確定したら、大量のデータをリサーチャーの手元に届けるためのデータ処理用自動パイプラインが作成されます。

リサーチャーがマシンを簡単に立ち上げられるようにするため、Research Infra のスタック全体が Kubernetes 上に構築されています。研究チームのほとんどのモデルは、オンライン機能を使用していません。

クラウド: インフラストラクチャの大部分は AWS 上にあり、他のクラウドベンダーもやや小規模な容量で併用しています。

インフラストラクチャの管理: パイプラインは実際には各顧客に特化してモデルを実行しています。マシンが立ち上がり、その会社のすべての呼び出しを処理します。

Gong において ML を複雑な問題にするその他の課題

  1. コスト: 上述の通り、モデルの学習および再学習のために膨大な量のデータが必要となるため、コストは Gong にとって大きな課題です。音声データセットは非常に大規模です(数百時間の音声が数百ギガバイトのデータに相当します)。NLP データセットはサイズ自体は小さいですが、多数の行で構成される場合があります。研究環境は本番環境から分離されているため、研究チームはモデル学習に使用するデータ量に関して柔軟に対応できます。研究チームは、学習に使用するデータ量を最適化するための取り組みを行っています。
  2. ML Platform のシンプル化: プロセスをシンプルにするための重要な側面の一つは、適切なアクセス制御を備えたツールによって、学習に使用するデータの種類を選択する複雑さを裏側に隠すことです。

    これはデータソースごとに異なる方法で行われます。多数のデータベース(それぞれが異なる種類の情報を保持し、アクセス方法も異なる)が存在する場合、安全なパイプラインを作成するために多くの作業が行われます。これにより、許可された担当者のみがデータを使用できるようにし、誰がどのような目的でデータにアクセスしたかのログを記録します。また、リサーチャーが異なるデータソースからの結果を組み合わせて調整できるようにすることも含まれます。
  3. データセキュリティ & プライバシー: Gong にとっての主な懸念事項の一つはセキュリティとプライバシーです。つまり、データ漏洩がないことを確認し、権限のない人物がデータにアクセスできないようにし、ある顧客のデータを別の顧客が取得できないようにすることです。これはデータ量が膨大であるため非常に複雑です。

    Gong による解決策: データを安全な場所に保存し、各データポイントに注釈(アノテーション)を付け、顧客のテナント ID に応じたアクセス権を設定します。アクセスは認証メカニズムによって制御され、自動化可能なものはすべて自動化されます。
  4. ある顧客のデータが別のモデルにフィードされないように確実にする - 大型言語モデル(LLM)を使用している際、ある顧客から何かを推論し、別の顧客がそのプライベート情報を取得してしまう可能性があります。これは考慮しなければならない点です。
  5. 自動再学習は容易ではない: 再学習は、すべてのパイプラインステージを実行する十分に洗練された手法が存在する場合にのみ行われます。これは非常にまれです。再学習の取り組みはモデルのタイプに依存します。例えば、特定言語の音声認識モデルの場合、新しいデータに対して同じパラメータで再学習を行うのは比較的分かりやすく簡単です。
    データのリフレッシュによってコンテンツの多くが変更されるため、新しいモデルが既存のモデルよりも実際に優れていることを確認するために、リサーチャーが再度研究を行うことが実際に必要になります。

Noam からの追加の考察

Kubernetes が最適な選択肢(the way to Go)

研究チームで行われているすべての取り組みは、現在 Kubernetes へと移行されています。Noam の仕事の一部は、彼のチームが Kubernetes クラウドからリソースに自動的にアクセスできるように支援することです。これは現在進行中の取り組みです。

📌

「これからこの分野に取り組むすべての人にお勧めしたいのは、ジャーニーの非常に初期段階で、スケールについて考え、チームがどのように連携して機能するかを考える必要があるということです」

「ほとんどの MLOps システムは、リソース管理のために Kubernetes を必要とすると考えています。将来、Kubernetes を使用せずに MLOps に関連することを行えるプラットフォームが登場するとは思えません」

注意すべき重要なポイント:

  1. Scale to Zero(ゼロへのスケールダウン)は、コスト管理において非常に重要です。起動したまま何もしていないマシンが存在することは、大きなコスト打撃となります。
  2. システムは、セキュリティおよびプライバシーの問題に効率的に対処できるアジリティを備えている必要があります。データは存在する場所にとどめ、そこにコードを持ち込む必要があります。

MLOps: 内製(Build)か購入(Buy)か

📌

「私視点では、Gong はこのプラットフォームを自社構築(Build)する必要がありました」

  • 構築する際は、拡張性と柔軟性に優れたプラットフォームである Kubernetes 上で始めてください。
  • テナント分離に対応し、GDPR の適用準備が整うよう、すべてのシステムを設定してください。また、誰かがデータの削除を希望した場合は、データを削除する必要があります。
  • 非常に早い段階でスケールについて考えることが極めて重要です。インフラストラクチャをアジャイルで柔軟なものにし、スケーリング機能を確実に備え、必要なときに必要な数だけマシンをデプロイして立ち上げられるようにしてください。ただし、アイドル状態になったらすぐに削除されるようにしてください。

セキュリティ、セキュリティ、セキュリティ

SaaS 企業にとって、セキュリティ以上に重要なものはありません。ML パイプラインは、顧客の機密データを扱う際のデータプライバシーのため、また不正アクセスを制御するために、セキュリティを最優先事項にする必要があります。

TrueML Talks の第 1 弾ブログシリーズが、ML チームを支援するための Machine Learning Research Infrastructure の構築方法について、価値あるインサイトを提供できたことを願っています。 #MLOps #MachineLearning #DataScience #DevOps #ModelOps #AIInfrastructure

シリーズの新しいブログを読む


Stitch の Platform Lead と対話した TrueML talks の第 2 エピソードをご覧ください。TrueML YouTube シリーズの視聴を続け、TrueML ブログシリーズの全エピソードをこちらでご確認ください -

‍

‍

TrueFoundry は、Kubernetes 上で動作する ML デプロイメント PaaS であり、インフラチームに完全なセキュリティと制御を確保しながら、モデルのテストとデプロイにおける完全な柔軟性を提供し、開発者のワークフローをスピードアップします。当社のプラットフォームを通じて、機械学習チームはモデルのデプロイとモニタリングを 15 分で行うことができ、100% の信頼性、拡張性、数秒でのロールバック機能を備えています。これにより、コストを削減し、本番環境へのモデルのリリースを高速化して、真のビジネス価値の実現を可能にします。 

Try now.

One gateway for all your models, MCP servers, and agents. No credit card needed.

Start free
Table of Contents

One Gateway for Every LLM, Agent and MCP Server

Book a 30-min with our AI expert

Book a Demo

The fastest way to build, govern and scale your AI

Book Demo
Summarize with
ChatGPT logo by OpenAI
Perplexity AI logo
Blurry red snowflake on white background, symmetrical frosty design with soft edges and abstract shape.

Discover More

October 26, 2023
|
5 min read

True ML Talks #23 - GitLabにおけるMLOpsとLLMアプリケーション

November 17, 2026
|
5 min read

Claude Codeの制限について解説(2026年版)

No items found.
Guide to Langgraph vs Langchain
November 16, 2026
|
5 min read

LangChain vs LangGraph:どちらが最適か?

比較
A detailed guide on Claude Fable 5
November 17, 2026
|
5 min read

Claude Fable 5: API、ベンチマーク、料金、使い方

エンジニアリングとプロダクト
openrouter vs litellm
November 16, 2026
|
5 min read

LiteLLMとOpenRouter:あなたに最適なのはどちらか?

比較
No items found.

Recent Blogs

Black left pointing arrow symbol on white background, directional indicator.
Take a quick product tour
Start Product Tour
Product Tour