


November 17, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
評価プラットフォームは、AI チームが直面する実質的な問題を解決します。プロンプトを変更したり、モデルを切り替えたり、検索(retrieval)を調整したりすると、品質が向上することもあれば低下することもあります。Braintrust のレビューが概ね高評価であるのは、ユーザーが影響を受ける前に、チームがその変化を測定できるよう支援するためです。
エンタープライズ企業が考慮すべき問題は、単なる出力評価にとどまりません。評価によって判明するのは、インフェレンス後に AI が何を生成したかということです。モデルを誰が呼び出せるか、チームの支出を抑制するか、ガバナンスツールを使用するか、あるいはプライベート環境内にプロンプトを保持するかといった決定は行われません。
この違いが重要なのは、Braintrust がインフェレンスの後流(ダウンストリーム)に位置しているためです。ガバナンス、アクセス制御、リクエストパスでのポリシー適用は、インフェレンスの前に発生します。Braintrust のレビューを読んでいるエンタープライズチームは、Braintrust を AI gateway と比較する前に、この境界線を理解しておく必要があります。
また、あらかじめ明確にしておくべき名称上の問題もあります。無関係な 2 つの企業が Braintrust という名称を使用しているため、公開されているレビューの多くは、AI 評価プラットフォームではなく採用プロダクトについて記述されています。本ガイドでは両者を区別し、Braintrust Dev がどのような位置づけにあるのかを解説します。
Braintrust Dev は、プロダクション環境で LLM アプリケーションを配信するエンジニアリングチーム向けの AI 評価および可観測性プラットフォームです。チームが evals を実行し、トレースを検査し、プロンプトを比較して、リリース前に品質低下(回帰)を検出するのを支援します。Braintrust は、2026 年に ICONIQ が主導するシリーズ B で 8,000 万ドルを調達しました。
Braintrust Dev は、相互に関連する 3 つのワークフローをカバーしています。
このプラットフォームは、トレース駆動の品質ワークフローを必要とするチームに役立ちます。開発者がプロジェクト管理、プロンプト更新、evals、リリース決定を連携させるのを支援します。ただし、評価に関する強みと、リクエストパスにおけるガバナンス要件は分けて考える必要があります。
Braintrust のレビューは、ある中心的なテーマについて肯定的な評価となっています。このプラットフォームは、トレース、evals、実験、プロンプト変更を連携させることで、AI 開発の計測を可能にします。ユーザーは、トレース UI、評価ワークフロー、プレイグラウンド、リリース前にモデルの動作を比較できる機能を高く評価しています。
Braintrust Dev に対する公開レビューの数は、会社の資金調達規模が示唆するほどには多くありません。その大きな理由は、Braintrust AIR との名称の重複です。「Braintrust レビュー」や「Braintrust AI gateway レビュー」といった検索を行うと、採用領域のフィードバックと AI 評価のリサーチが混ざってしまう可能性があります。
つまり、エンタープライズ企業の担当者はレビューデータを注意深く扱う必要があります。いくつかの肯定的なレビューは、Braintrust が evals に優れていることを証明できますが、インシデントサポート、複数チームにわたるガバナンス、プライベートデプロイメント、大規模なアクセス制御に関する懸念に完全に応えることはできません。
現実的な見解としてはバランスが取れています。Braintrust Dev は評価と可観測性において優れたプロダクト価値を持っています。ただし、gateway やセキュリティレイヤー、プロダクションインフェレンスガバナンスプラットフォームとして評価されるべきではありません。これらはその中核機能の外にあるためです。
ギャップについての議論は一度脇に置いておきましょう。Braintrust は評価レイヤーにおいてその評価を確固たるものにしているからです。その優れた機能は、プロダクションの変更と計測可能な出力品質を結びつけることに役立ちます。これらの強みは、ドキュメント、プロダクトのポジショニング、公開ユーザーフィードバックの至る所で見られます。
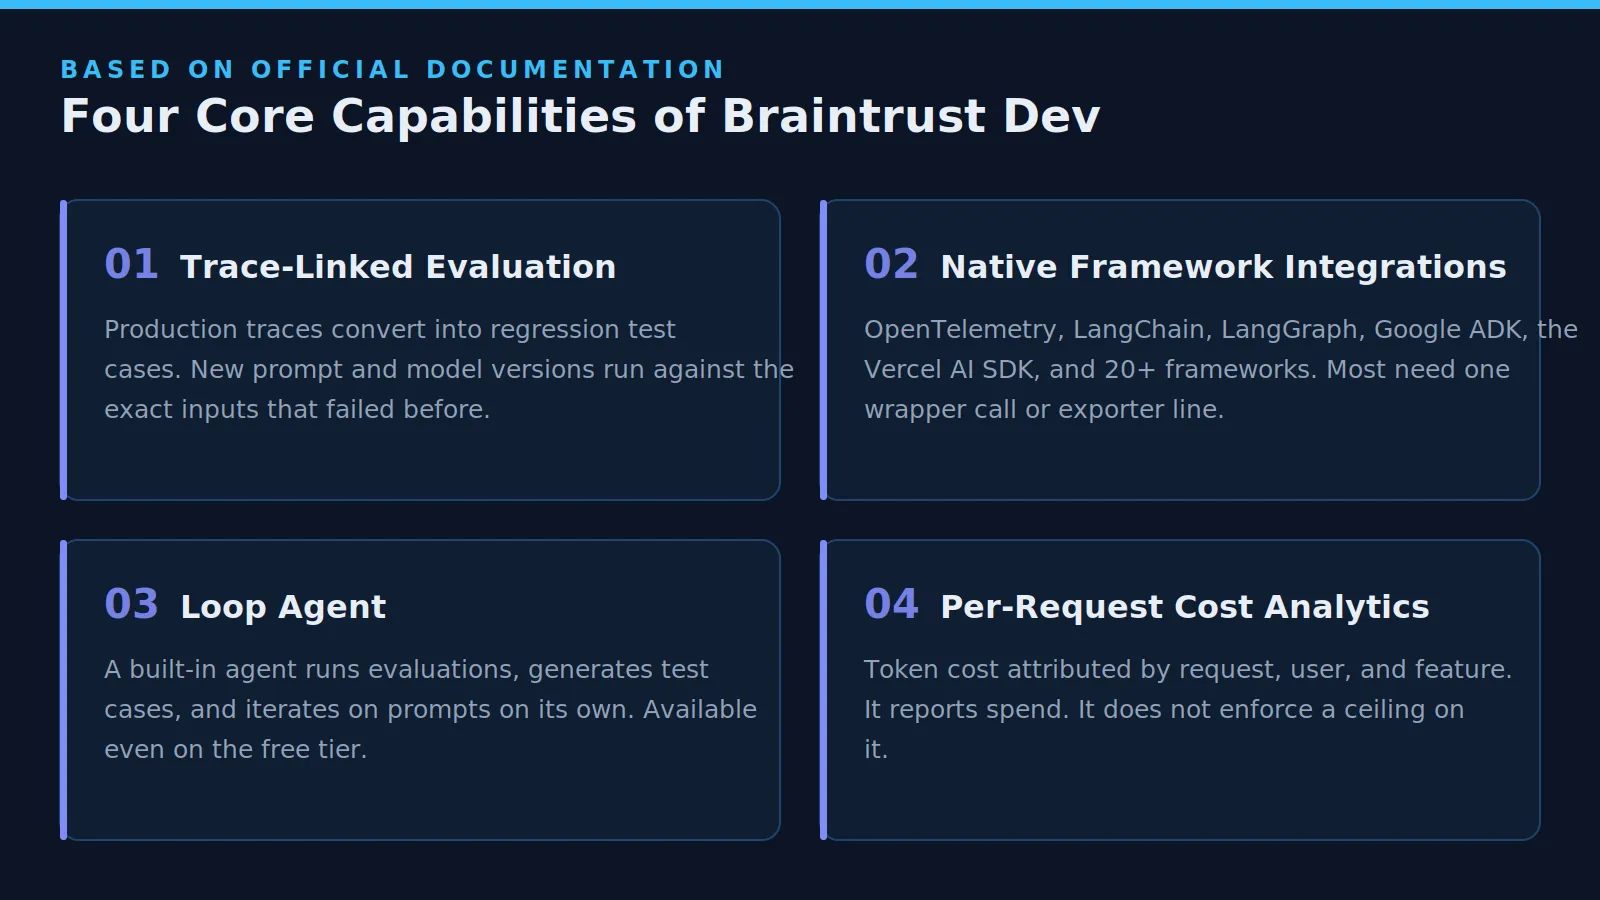
Braintrust を使用すると、プロダクションのトレースを評価テストケースに変換できます。これにより、作為的な例ではなく、実際の失敗事例から回帰テストスイートを拡張できるようになります。プロンプトやモデルが変更された場合、以前に問題が発生した入力に対してテストを実行できます。
テストでプロダクションに近いコンテキストが使用されるため、このワークフローによってリリースの信頼性が向上します。トレースは、オフラインの eval 実行とライブログ全般にわたって一貫性を保ちます。開発者は、修正をテストしたのと同じ UI 上で回帰のデバッグを行うことができます。
インストゥルメンテーション(計測処理)のためにアプリケーションの大幅な変更が必要になると、導入が停滞することがよくあります。Braintrust は、OpenTelemetry、Vercel AI SDK、OpenAI Agents SDK、LangChain、LangGraph、Google ADK、Mastra、Pydantic AI、および関連フレームワークとの統合により、この参入障壁を低くしています。
ほとんどの統合には、ラッパー呼び出しまたはエクスポーター構成のみが必要です。すでに OpenTelemetry を使用しているチームは、Braintrust を別のスパンエクスポーターとして追加できます。これによりセットアップの手間が軽減され、開発者が再現可能な評価ワークフローをより迅速に作成できるようになります。
Braintrust には、Loop と呼ばれるエージェントが組み込まれています。評価を実行し、テストケースを生成し、プロンプトを自動的に調整・反復できます。eval の設定を退屈だと感じるチームにとって、これは単なるログツールとの差別化を図る有用な機能です。
ただし、重要な注意事項があります。自律的な調整は、スコアリングルーブリック(評価基準)が明確である場合に最も効果的です。曖昧な目的からは曖昧な提案しか生まれないため、自動化に依存する前に規律ある基準を定める必要があります。
Braintrust は、リクエスト、ユーザー、機能レベルでトークンコストを紐付けます。独自で帰属割り当てパイプラインを構築することなく、どのワークフロー手順やユーザーセグメントが支出を増加させているかを把握できます。この可視性は AI プロダクトチームにとって価値があります。
ただし、その限界も同様に重要です。Braintrust はアクティビティが発生した「後」にコストを報告します。インフェレンス前にハード上限を適用することはないため、プロダクション環境の予算を管理するために gateway と組み合わせられることが多くなっています。
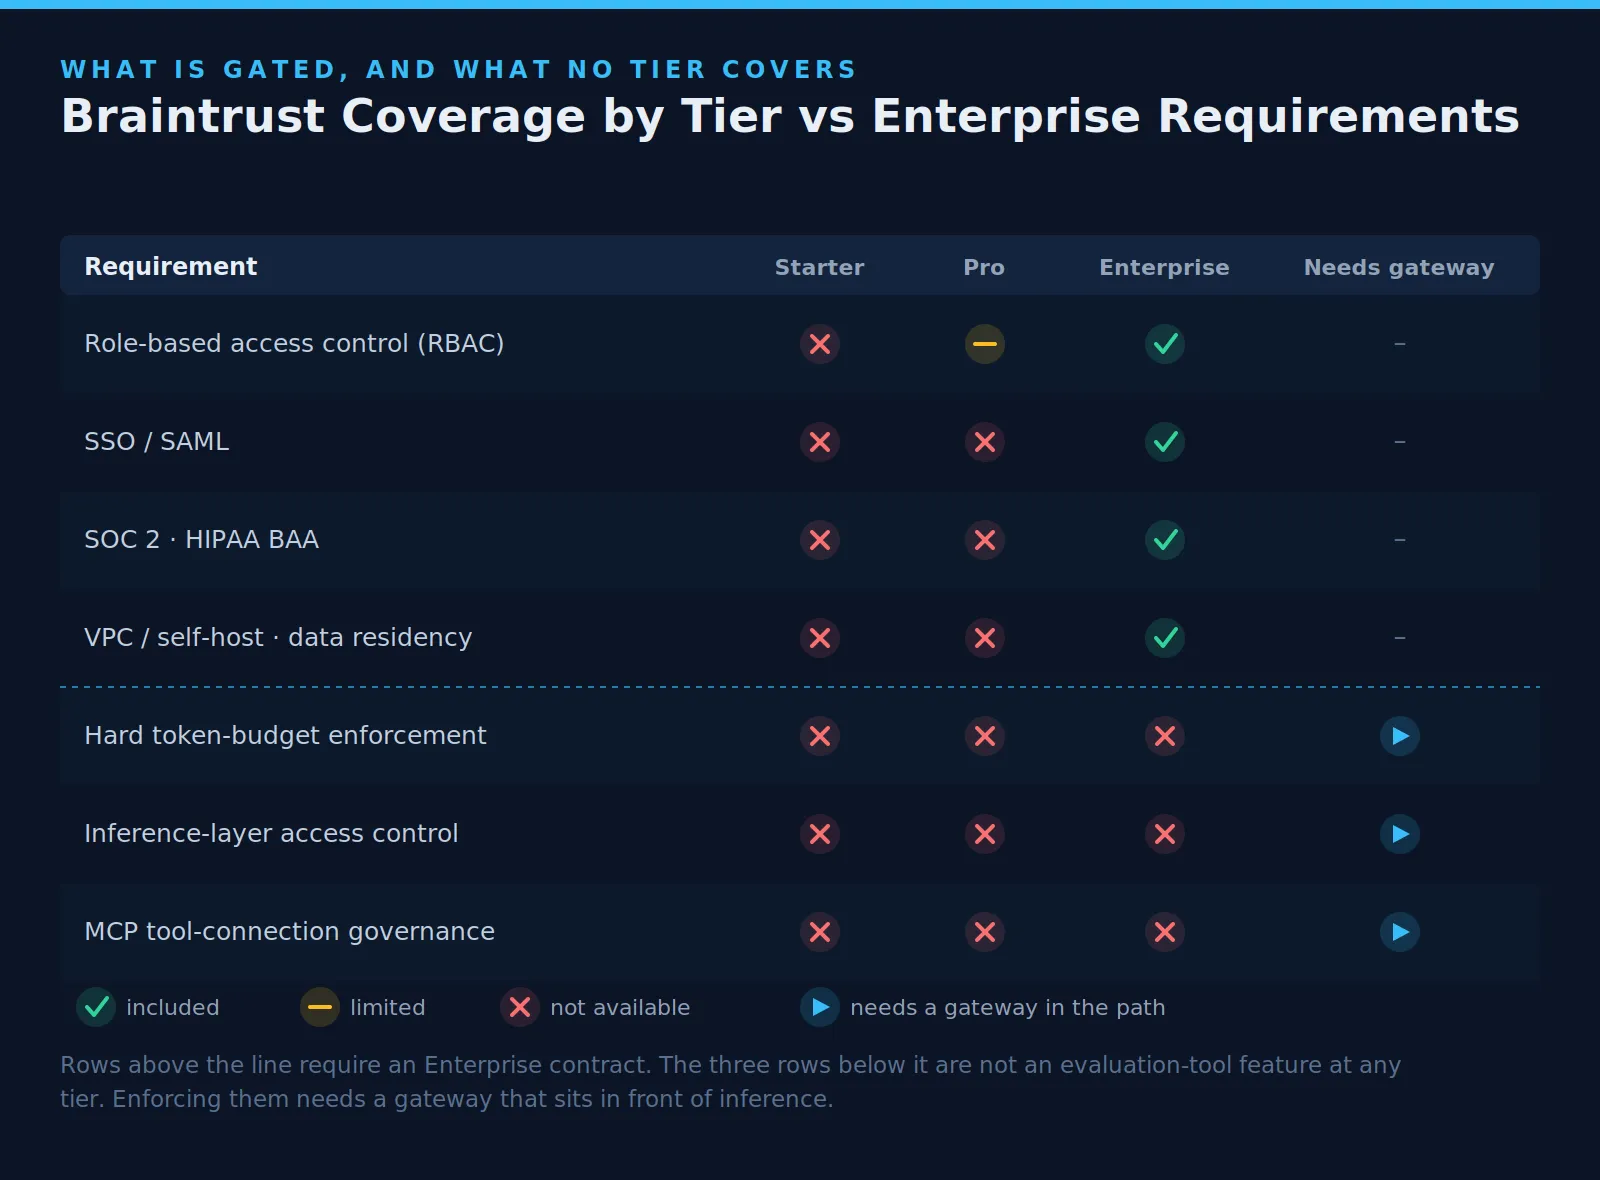
Braintrust のレビューを公平に読み解くには、評価内容と並行して価格設定とティアー制限を確認する必要があります。エンタープライズチームが必須と考えるいくつかの制御機能は、Enterprise プランに集約されています。肯定的なプロダクトレビューが、組織に必要なティアーと一致しない可能性があるため、これが評価に影響を与えます。
Braintrust は 2026 年 3 月に無料プランの名称を Starter に変更し、課金に処理済みデータ(processed data)を使用しています。処理済みデータには、プラットフォームに取り込まれた入力、出力、プロンプト、メタデータ、トレースが含まれます。1 ギガバイトの処理済みデータは、一般的なペイロードサイズでおよそ 100 万スパンに相当します。
付属上限を超える使用量は、超過料金として課金されます。これは、利用の多い月に強制停止されるのではなく、請求額が高くなることを意味します。価格設定の強みは、すべてのティアーでユーザー数、プロジェクト数、データセット数、プレイグラウンド数、実験数が無制限である点であり、規模の大きいチームがアカウントごとのコスト増額を回避するのに役立ちます。
主な制約は Enterprise プランにあります。カスタム RBAC、SAML SSO、HIPAA BAA、S3 エクスポート、カスタム保持期間、およびオンプレミスまたはホスティング環境へのデプロイには Enterprise プランが必要です。厳格なコンプライアンス、アイデンティティ管理、データ保持、またはデプロイに関する要件を持つチームは、検討時にこの点を考慮する必要があります。
これらのギャップは、Braintrust 本来の領域内における価値を損なうものではありません。これらはアーキテクチャ上の境界線です。Braintrust はインフェレンス「後」にデータを受け取って分析しますが、これは評価および可観測性としては正解です。ただし、リクエストがモデルに到達する「前」にポリシーを適用する場所としては適していません。
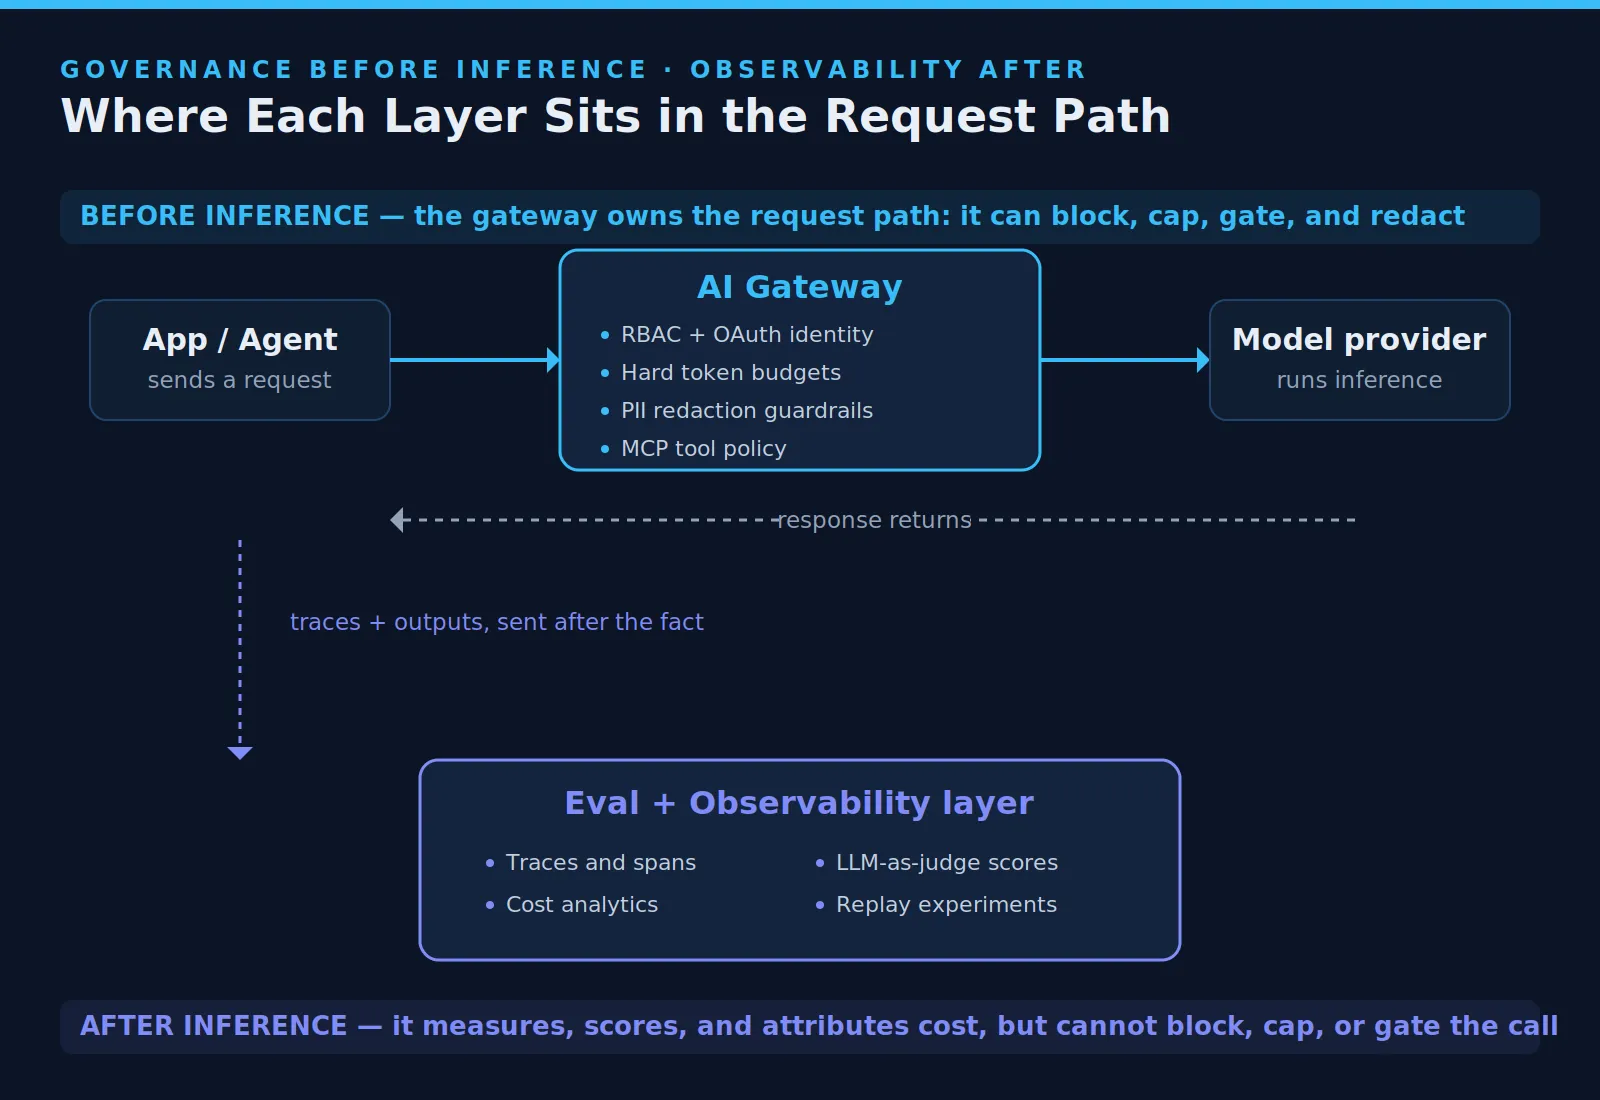
Braintrust は、アプリケーションからトレースデータを受信することで、モデル呼び出しによって生成されたものを観察します。また、単一の OpenAI 互換エンドポイントの背後で複数のプロバイダーを統合できるオプションのプロキシも提供しています。これにより、チームはアクセスを集中化し、レスポンスをキャッシュできます。
ただし、このプロキシはアイデンティティに対応したインフェレンスガバナンスの代わりにはなりません。社内のどのユーザー、サービス、またはエージェントがどのモデルにアクセスすべきかを決定することはありません。リクエストパスでのアクセス決定を必要とするチームには、そのチェックポイントを管理する別の AI gatewayが必要です。
コスト分析と予算制限の強制は異なる役割です。Braintrust はトレースごとのコストを追跡し、ユーザーや機能別の支出を明確にすることで前者を実行します。また、使用量が制限に近づいたときにチームにアラートを通知することもできます。
しかし、アラートによって支出が止まるわけではありません。暴走したエージェントループや設定ミスのバッチジョブは、ダッシュボードが事後に更新されている間も実行され続けます。上限を強制するには、リクエストがプロバイダーに到達する前にリクエストを拒否またはスロットリング(制限)する必要があります。
Starter および Pro プランでは、トレースデータは Braintrust のマネージドクラウドを介して処理されます。Enterprise 未満にはセルフホスティングのオプションはありません。GDPR、HIPAA、または業界基準に基づくデータレジデンシー要件を持つ組織にとって、これはティアーレベルの制限となります。
Braintrust 内での解決策は Enterprise プランであり、セルフホスティングや個別交渉が含まれます。これは一部の企業には適していますが、厳格なデータ管理を求める小規模なチームにとっては移行のハードルが高くなる可能性があります。
エージェントはModel Context Protocolを介して外部システムに接続することが増えています。この接続は、ツールがデータにアクセスし、システムを更新し、アクションをトリガーできるため、セキュリティ上の境界となります。Braintrust は何が起こったかを事後的に追跡することはできます。
しかし、ツールの呼び出しの前に位置して、承認、ブロック、フィルタリング、またはユーザーアイデンティティの適用を行うことはありません。エージェント型のワークロードが規制対象環境に入るにつれて、管理されていない MCP の領域は重大なセキュリティギャップになります。
評価および可観測性のカテゴリーにおいて、Braintrust が最も直接的に競合するのは Langfuse、Arize Phoenix、Helicone です。それぞれのプラットフォームは異なる需要に対応しています。適切な選択肢は、オープンソースの制御、ML モニタリングの幅広さ、低コストなトレース、またはより高度な eval ワークフローのどれをチームが重視するかによって決まります。
これらに対する Braintrust の優位性は、eval ワークフローの深さ、Loop エージェント、そして専用データベースである Brainstore にあります。同社によると、独自ベンチマークにおいて Brainstore は標準的なデータウェハウス単体と比較して AI トレースを 80 倍高速にクエリでき、数テラバイトのデータに対して中央値 1 秒未満のクエリ時間を実現していると報告されています。これをベンダーのベンチマーク数値(あくまで参考値)として捉えたとしても、アーキテクチャ上の観点は妥当です。AI のトレースはそれぞれ数メガバイトに肥大化しており、汎用の可観測性ストアではその処理に負荷がかかります。
ただし、これが Braintrust の属するレイヤーを変えるわけではありません。高速なトレースクエリは可観測性ツールとしては優れていますが、インフェレンス時のガバナンスを追加するものではありません。
TrueFoundry と Braintrust Dev は、AI スタックにおいて異なる課題を解決します。Braintrust は、インフェレンス後の出力を評価し、品質の低下を特定するのを支援します。TrueFoundry は、アクセス、予算、ルーティング、ツール呼び出し、監査ログなど、インフェレンス「前」に発生する事項を管理(ガバナンス)します。
両方のレイヤーを必要とするチームは、それらを組み合わせて運用できます。TrueFoundry は AI Gateway を通じてリクエストパスを制御し、Braintrust は後流(ダウンストリーム)で出力を評価します。これにより、実行前のガバナンスと、レスポンス受信後の評価の両方を備えることができます。
システム構成を最小限に抑えたいチームのために、TrueFoundry は可観測性機能も直接サポートしています。モデルの呼び出し、エージェントのアクション、使用状況、コストメタデータ、ポリシーの結果を記録します。これらのログは自社の VPC 内に保持し、既存のモニタリングツールと連携させることができます。
TrueFoundry は、チームが特に以下を必要とする場合に価値を発揮します。
主な目的が出力評価、スコア追跡、回帰分析である場合は、引き続き Braintrust Dev が有用です。チームがインフェレンスガバナンス、厳格な予算管理、ツール制御、プライベートデプロイメント、コンプライアンス対応の監査トレイルを必要とする場合は、TrueFoundry がより強力なレイヤーとなります。
TrueFoundry がインフェレンス、予算、アクセス、監査ログを安全に管理する仕組みについては、デモを予約してご確認ください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




Braintrust Devは、プロダクションLLMアプリケーションを構築するエンジニアリングチーム向けのAI評価・可観測性プラットフォームです。開発者がリリース前に、出力品質の測定、トレースの検査、プロンプト変更の比較、モデル動作の検証を行うのに役立ちます。評価ワークフローのために構築されており、リクエストパスのガバナンスやモデルアクセス制御のためではありません。
認証済みのBraintrustのレビューが限られているのは、無関係な2つの会社が同じ名前を共有しているためです。検索すると、採用プラットフォームであるBraintrust AIRと、Braintrust Devの両方が表示されます。Braintrust AIRのレビューは採用、スクリーニング、採用ワークフローについて言及しているのに対し、Braintrust DevのレビューはAI評価、可観測性、プロンプトの実験に焦点を当てています。
RBAC、SSO、SAML、HIPAA BAA、SOC 2、セルフホスティング、カスタム保持期間、エクスポートオプション、稼働時間SLAをご利用いただくには、Enterpriseプランが必要です。StarterおよびProプランは、Braintrustのマネージドクラウド上で動作します。VPCへの展開、高度なID管理、規制対象データの取り扱いが必要なチームには、通常Enterpriseプランが求められます。
いいえ。Braintrust Devは推論の実行後にその内容を監視するものであり、プロキシベースのルーティングには対応可能です。特定のモデルを呼び出せるユーザーやエージェントの制限、実行前の支出上限設定、MCPツール接続の管理といった機能は備えていません。これらの制御には、リクエスト経路上に配置されるゲートウェイが必要です。
Braintrust Devは、braintrust.devが提供するAI評価およびオブザーバビリティプラットフォームです。一方、Braintrust AIRは、usebraintrust.comが提供するAI採用・面接プロダクトです。これらは別々の会社による異なるプロダクトであるため、一方に対するレビューは、もう一方の信頼できる評価基準にはなりません。























