Blank white background with no objects or features visible.

EMEAの皆様へ。TrueFoundryは、ヨーロッパ、中東、アフリカ全域で事業を拡大しています。詳細はこちら →

Baseten vs Modal:料金、コールドスタート、そして料金表に隠された真実

By アシシュ・ドゥベイ

Updated: November 3, 2026

Published: September 28, 2026

⚡ 要約(TL;DR)
  • Basetenを選ぶべきケース: 自身のVPC内でのインファレンスが必要な場合、PHI(保護対象保健情報)を扱う場合、自作することなくTensorRT-LLMレベルの最適化を活用したい場合、または小型でリージョン指定されたGPUを運用する場合。
  • Modalを選ぶべきケース: モデルサーバー以上の機能を必要とする場合(信頼できないコードのためのサンドボックス、バッチ処理、ノートブック、強化学習環境など)。Modalによると、サンドボックス単体で収益の3分の1以上を占めており、Pythonにおける使いやすさは最高峰です。
  • TrueFoundryを選ぶべきケース: ワークロードを自社のクラウドアカウント内で実行する必要があり、セルフホスト型モデルと商用APIを一元管理する単一のコントロールプレーンを求めている場合。
  • 最大のトレーディングオフは「プラットフォームの実行場所」と「料金表が何をカウントしているか」です。 Modalの表面上のGPU料金は大規格カードで37〜40%安く見えます。しかし、BasetenがSKUにバンドルしているCPUとメモリを加算すると、実際のH100の差は約19%に縮まり、A100 80GBではほぼ同等、T4やA10ではBasetenの方が安くなります。

両者ともサーバーレスGPUプラットフォームであり、デフォルトでスケールトゥゼロ(ゼロへの縮小)に対応し、誰もが知る企業のプロダクションワークロードを支えています。公正な比較ではありますが、両者の形態は大きく異なります。Basetenはモデル提供専用のプラットフォームとして誕生し、それを拡張してきました。一方、Modalはインファレンスを6つの製品のうちの1つと位置づける汎用計算プラットフォームを構築しました。その違いはSDK、料金表のカウント方法、そして自社アカウント内で運用できるかどうかという点に表れています。

以下で最も価値があるのは「料金の計算手法」です。公開されているGPUの1時間あたりの料金は両者間で単純比較できず、その誤差は判断を逆転させるほど大きいからです。数値は2026年9月25日時点のものに基づきます。

Baseten:概要

Basetenは、オープンソース、カスタム、ファインチューニング済みモデル向けのプロダクションインファレンスを提供しており、Dedicated Deployments(専用デプロイ)、トークン単位のModel API、およびTraining(トレーニング)に対応しています(料金表)。

2019年にTuhin Srivastava(CEO)、Amir Haghighat(CTO)、Phil Howes、Pankaj Guptaによって設立されました。資金調達はシリーズB、C、D、さらに評価額50億ドルでの3億ドルのシリーズEを経て、2026年6月22日に評価額130億ドルで15億ドルのシリーズFに達しました(発表記事)。累計調達額は「20億ドル超」。売上高は前年比20倍に成長したと報じられています(ARRは非公開[要検証])。顧客にはCursor、Notion、Harvey、HubSpot、OpenEvidence、Vercelなどが含まれます。

注記すべき数字として、2026年9月下旬の報道(Axios 9/22、Bloomberg 9/23)では、報じられている260億ドル近い評価額でのさらに大規模なラウンドに関する協議が行われていると伝えられています。Basetenからは何も発表されていません。130億ドルが公式に確認された最後の数字であり、本記事で使用する値です。

[スクリーンショット:Baseten — 稼働中モデルのリプリカ状態、オートスケーリング設定、レイテンシパーセンタイルを示すDedicated Deploymentsダッシュボード]

  • 料金設定。 Basicは月額$0の従量課金制(pay-as-you-go)で、SOC 2 Type IIおよびHIPAAが含まれており、すべての公開プランでプラットフォーム利用料は$0です。ProおよびEnterpriseは見積もりベースで、EnterpriseにはSLA、セルフホストデプロイメント、データレジデンシー、高度なRBACが追加されます。課金は分単位で、アイドル状態の料金はかかりません。無料クレジットが存在しますが、額は非公開です[要検証]。また、Basetenはトークン単位の料金表も公開しています(例:GPT OSS 120Bは100万トークンあたり入力$0.10 / 出力$0.50)。
  • コールドスタート。 Baseten Delivery Network(BDN)は、ノードローカルのNVMe、クラスタ内ピアキャッシュ、ミラーリングされたオリジンの各階層に重みをキャッシュし、H100ノードに対して2 GB/s超の速度で2〜3倍高速なコールドスタートを実現します。商業的に重要なのは、「重みの転送が課金対象のGPU時間を消費しない」点です(BDNのポスト、2026年4月9日)。現在のドキュメントには秒単位の具体的レイテンシ値は記載されていません[要検証]。Basetenブログの「Last updated(最終更新日)」は編集日であり、公開日ではありません。
  • デプロイとSDK。 Trussパッケージング(config.yamlと、loadおよびpredictを備えたオプショナルなmodel/model.py、または自作Dockerイメージ)を使用し、ライブリロード開発用のbaseten model push --watchと、イミュータブルなプロダクション用のbaseten model pushを利用します。コンカレンシーは2段階で制御されます(オートスケーラー用のconcurrency_targetとコンテナ内部のpredict_concurrency)。また、InfiniBandを使用したマルチノードもサポートしています。
  • セルフホストおよびマルチクラウド — 最も明確な差別化要因。 Baseten Cloud、ワークロードプレーンを自身のVPC内に配置し「インファレンスリクエストがBasetenのインフラを経由せずにワークロードプレーンへ直接ルーティングされる」Self-hosted(セルフホスト)、およびスピルオーバーを備えたHybrid(ハイブリッド)の構成が可能です。その上には、「20以上のクラウドを単一のGPUプールとして管理する」と宣伝されているマルチクラウド容量管理機能があり、クロスリージョンフェイルオーバーにも対応しています。
  • オブザーバビリティとコンプライアンス。 レイテンシパーセンタイル、レプリカ状態、GPUメトリクスに加え、設定不要で自動検出されるvLLMおよびSGLangのエンジンネイティブなメトリクス、Prometheus、OTLP、OTelトレースをサポート。SOC 2 Type II、HIPAA、GDPRに対応し、同期インファレンスではデフォルトでデータ保持期間がゼロに設定されています。ISO 27001[要検証]。エグレス(データ転送)料金は未記載です[要検証]。

BasetenはBlaxelも買収しました。 BlaxelはエージェントサンドボックスおよびマイクロVMインフラ企業で、2026年9月10日に発表されました(条件は非開示、発表記事)。これはModalのサンドボックス領域への直接的な参入ですが、発表からわずか2週間であり、評価できるプロダクトはまだリリースされていません。

明確に優れている用途: 自身のVPC内でのインファレンスを必要とする規制対象の購入者(Modalには同等の機能がありません)、HIPAAが無料プランに含まれているためPHIを扱うチーム、自前で構築することなくTensorRT-LLMレベルの最適化を求めるチーム、および特定リージョンに固定されたワークロードや小型GPUワークロード。

Modal:概要

Modalは自らを「AIのために構築されたクラウド。単一目的のGPUクラウドではなく、適切なプリミティブを備えたプラットフォーム」と称しています(シリーズCのポスト)。提供製品:Inference、Sandboxes、Training、Notebooks、Batch、Core Platform。このリストこそが最大の主張であり、インファレンスはその機能の1つに過ぎません。

2021年にErik BernhardssonとAkshat Bubnaによって設立されました(設立年はTechCrunchによるもので、Modalのページによるものではありません[要検証])。チームは独自のファイルシステム、コンテナランタイム、スケジューラ、イメージビルダーを開発しており、それがコールドスタートの数値に現れています。資金調達はシード、シリーズA、評価額11億ドルでの8,700万ドルのシリーズBを経て、2026年5月21日に評価額46億5,000万ドルで3億5,500万ドルのシリーズCを達成しました(累計「4億6,600万ドル超」)。ModalはBasetenが公表していない数字、すなわち「年間換算収益(ARR)が3億ドルを突破した」こと、および「Sandboxesが既に収益の3分の1以上を占めている」ことを公開しています。顧客にはCognition、DoorDash、Suno、Rampなどが含まれます。

[スクリーンショット:Modal — デプロイされたFunctionのコンテナ数、GPU利用率、コールドスタート時間を示すアプリダッシュボード]

  • 料金設定。 Starterは月額$0+計算費用(月額$30相当の無料計算枠、ログ保持期間1日)。Teamは月額$250+計算費用(月額$100相当の無料計算枠、ログ保持30日)。Enterpriseはカスタム価格で、監査ログ、SAML SSO、HIPAA、RBACが追加されます。課金は秒単位ですが、ここに決定的な違いがあります。CPUとメモリはGPUとは別に課金されます。CPUは物理コア1時間あたり$0.04716、メモリは1 GiB時間あたり$0.007992です。SandboxおよびNotebookのCPU・メモリ料金はFunction料金の3倍になります。リージョン指定は広域で1.15倍、特定指定で1.75倍、プリエンプティブル不可(Dedicated)は3倍となります。トークン単位の料金表はありません。
  • コールドスタート。 コンテナは約1秒で起動します。Memory Snapshotsがその名称機能であり、CPUスナップショットはGA(一般提供)、GPUスナップショットはAlpha段階です。Modalのドキュメントには3〜10倍高速と記載されており、エンジニアリングブログの見出しには10倍(Parakeetで20秒から2秒へ短縮)と書かれています。ModalのシリーズCのポストでは「100倍」という言葉が使われましたが、自身のドキュメントやブログでは裏付けられていないため、引用すべき数値は3〜10倍です。 GPUスナップショットは「ストレージからのモデル読み込みを高速化しない」ばかりか「オーバーヘッドが追加されて悪化させる可能性すらある」ほか、マルチGPUコードと基本互換性がなく、7日後に有効期限が切れます。
  • デプロイとSDK。 デコレータベースのPython(@app.function()、@app.cls()、@modal.fastapi_endpoint())を使用し、DockerfileではなくPython内でのメソッドチェーンによってイメージを定義します。開発ループには modal run / modal deploy / modal serve を使用します。コンテナはgVisor上で実行され、JSおよびGo SDKはBeta段階です。リージョンは広域(us, eu, ap)または特定(us-west, jp)で厳格に固定され、マルチノードクラスタはBeta段階です。インフラをPythonとして記述することを好む場合、このカテゴリーで最も素晴らしい開発者体験(DX)を提供します。
  • セルフホストオプションなし。 BYOC(自社クラウド持ち込み)、オンプレミス、顧客VPCデプロイ機能はありません。Enterpriseプランにもデプロイ場所に関する記載はなく、cloud= オプションはModalがスケジューリングするクラウドを選択するものであり、顧客のアカウントではありません。llms.txt内にもBYOC、self-host、on-prem、VPCといった単語の出現回数はゼロです。データレジデンシーの制限として言及価値のある点:すべてのログ、すべての永続ストレージ、2 MiBを超えるFunctionペイロード、およびすべての非同期ペイロードは、コンテナのリージョンに関わらず米国に保存されます。
  • オブザーバビリティとコンプライアンス。 GPU利用率、電力、温度、メモリを監視できますが、Modal自身もこれらは「パフォーマンス問題の直接的なデバッグには使用できない」と但し書きを付けています。任意の場所へのOTLPエクスポートに対応。SOC 2 Type 2取得済み。HIPAAは限定的で、BAAが必要なうえEnterprise限定であり、Volumes v1、Images、Memory Snapshots、およびユーザーコードはBAAの適用範囲外となります。入出力データは最大7日間保持されます。ISO 27001[要検証] — 記載なし。

[スクリーンショット:Modal — GPUテーブルと独立したCPU・メモリの課金項目を並べて表示する料金ページ]

明確に優れている用途: モデルサーバー以外のすべての用途(サンドボックス、不可信コードの実行、強化学習環境、バッチ処理、ノートブック)。Pythonの使いやすさ。大規格GPU、リージョン未指定、スパイク状のワークロード。GPUのバリエーションの広さ(L40S、A100 40GB、B300はBasetenに同等品がありません)。そして重みのロードではなく、JITやインポートによって初期化処理が重くなっているコールドスタート。

アーキテクチャとデプロイの比較

項目 Baseten Modal
最新の確認済みラウンド 15億ドル シリーズF(評価額130億ドル、2026年6月22日) 3億5500万ドル シリーズC(評価額46億5000万ドル、2026年5月21日)
中核となる抽象化 モデルサーバー(Truss) Python関数(@app.function())
課金単位 分単位、オールインワンのインスタンスSKU 秒単位、GPU + CPU + メモリ個別課金
プラットフォーム利用料 全公開プランで$0 $0 / 月額$250 / カスタム
スケールトゥゼロ(ゼロ縮小) デフォルト(scale_down_delay 900秒) デフォルト(scaledown_window 60秒)
コンカレンシー(並列性) concurrency_target + predict_concurrency オプトインの @modal.concurrent(上限4,000)
推論エンジン vLLM、SGLang、TensorRT-LLM(独自4種) vLLM、SGLang(TensorRT-LLM、TGI非対応)
コールドスタート対策 重み配信:BDN 2〜3倍、課金対象外時間 プロセス状態:スナップショット 3〜10倍、GPU Alpha
セルフホスト / VPC 対応 — Cloud、Self-hosted、Hybrid 非対応 — ホスト型のみ
HIPAA 対応(無料プランから適用可) Enterprise限定、BAA要、適用範囲に除外あり
データレジデンシー制限 セルフホストの場合は自社VPC内 ログおよびストレージは常に米国に保存

コールドスタートに関する正直な枠組み:両者は同じ問題の異なる側面を解決しようとしています。Basetenは重みの転送に着目し、その時間を課金対象外にしています。Modalはスナップショットリストアによってプロセス状態に着目していますが、これは重みの読み込み自体を明示的に高速化するものではありません。コールドスタートの原因が140GBの重み読み込みにあるならBasetenのアプローチが有効であり、インポートやJIT、CUDAグラフキャプチャにあるならModalのアプローチが有効です。

GPU料金:表面上の料金と実際の料金

検証手法。 Basetenは固定のvCPUとRAMが同梱されたオールインワンのインスタンスSKUに対して分単位の料金を公開しています。ModalはGPUのみの料金を秒単位で公開しており、CPUとメモリは別途課金されます。公平に比較するため、両者を1時間あたりに換算(Basetenは60倍、Modalは3600倍)した上で、Modalの計算値に対して、Basetenがバンドルしていると同等のCPUとメモリをModal自身の単価(物理コア1時間あたり$0.04716[1コア=2 vCPU]、1 GiB時間あたり$0.007992)で加算します。リージョン固定やプリエンプティブル不可の倍率は除外しています。これらを加算するとModalはさらに高くなります。出典:baseten.co/pricing、docs.baseten.co/deployment/resources、modal.com/pricing。

公表されている表面上の料金

GPU Baseten $/時間 Baseten バンドル vCPU / RAM Modal $/時間(GPUのみ) 表面上の差
H100 80GB SXM $6.4998 16 / 118 GiB $3.9492 Modalが-39.2%安い
A100 80GB $4.0002 12 / 144 GiB $2.4984 Modalが-37.5%安い
A100 40GB 未掲載 — $2.0988 Modalのみ
L40S 48GB 未掲載 — $1.9512 Modalのみ
A10 / A10G 24GB $1.2072 4 / 16 GiB $1.1016 Modalが-8.7%安い
T4 16GB $0.6312 4 / 16 GiB $0.5904 Modalが-6.5%安い

調整後 — BasetenのバンドルCPU・RAMと同条件に合わせたModalの料金

構成 Baseten オールイン Modal GPU + CPU + RAM Modal 合計 実際の差
H100 80GB + 16 vCPU + 118 GiB $6.4998 $3.9492 $0.3773 $0.9431 $5.2696 Modalが-18.9%安い
A100 80GB + 12 vCPU + 144 GiB $4.0002 $2.4984 $0.2830 $1.1508 $3.9322 Modalが-1.7%安い(ほぼ同等)
A10 + 4 vCPU + 16 GiB $1.2072 $1.1016 $0.0943 $0.1279 $1.3238 Basetenが-8.8%安い
T4 + 4 vCPU + 16 GiB $0.6312 $0.5904 $0.0943 $0.1279 $0.8126 Basetenが-22.3%安い

L40SおよびA100 40GBには調整比較対象となるBasetenのSKUがありません。

結論: 同等のCPUとメモリを揃えると、「Modalの方がH100で40%安い」という見解は実質約19%まで縮小し、A100 80GBではほぼ同等となり、小型GPUでは立場が逆転してBasetenの方が9〜22%安くなります。さらにリージョン指定や3倍のプリエンプティブル不可倍率を加算すれば、常時稼働型のワークロードにおいては完全にBasetenが勝利します。

ベンチマークを行う際の落とし穴:Modalで単に gpu="A100" と指定すると暗黙的に80GBにアップグレードされる場合があり、gpu="H100" がH200に割り当てられることもあります。厳密に比較したい場合は gpu="H100!" のように固定してください。

チームが陥りがちな落とし穴

1. 料金表が請求額そのものとは限らない。 GPUの1時間あたり単価から予算を試算したチームが、後からCPU、メモリ、ボリューム、リージョン倍率、そして3倍のサンドボックス料金の存在に気づくことがあります。Basetenのバンドル方式は予測が容易であり、Modalの個装細分化方式は実際の消費量により忠実です。上記の算術を行わない限り、両者をそのまま比較することはできません。

2. リージョン選択はデータレジデンシーを意味しない。 Modalでコンテナを eu-west に固定した場合でも、ログ、永続ストレージ、2 MiBを超えるペイロードは米国内に保存されます。規制当局から追及された際、コンテナのリージョン指定だけでは回答になりません。

3. モデルサーバーはシステムの一部に過ぎない。 実際の運用では、商用モデルAPI、認証、コスト帰属、レート制限、ガードレール、監査ログなども必要になります。どちらのプラットフォームもそのレイヤーそのものを提供するわけではないため、どちらを採用するにしてもそれらの構築・管理は自力で行う必要があります。

複数のプラットフォームでインファレンスを実行していませんか?
セルフホスト型モデルと商用APIの前面にゲートウェイを導入することで、コスト、レイテンシ、アクセス制御を1か所で一元管理できます。

TrueFoundryの立ち位置:異なるアプローチ

人工的な三つ巴の競合として描くのではなく、素直な回答を提供します。BasetenとModalはホスト型のインファレンスクラウドです。TrueFoundryは顧客自身のクラウドアカウント内で動作します。 ターゲットとなる購入者も、解決する課題も異なります。

彼らは「GPUを自前運用せずにこのモデルを提供するにあたってどうすればよいか」に答えます。TrueFoundryは「既にGPU容量、コミットメント(年間契約)、または規制要件があり、自身のインフラ上にプラットフォームを必要としている」という状況に答えます。前者の問いを抱えている場合はどちらかのサービスを購入してください。Basetenのセルフホストモードが最も近い選択肢となります。

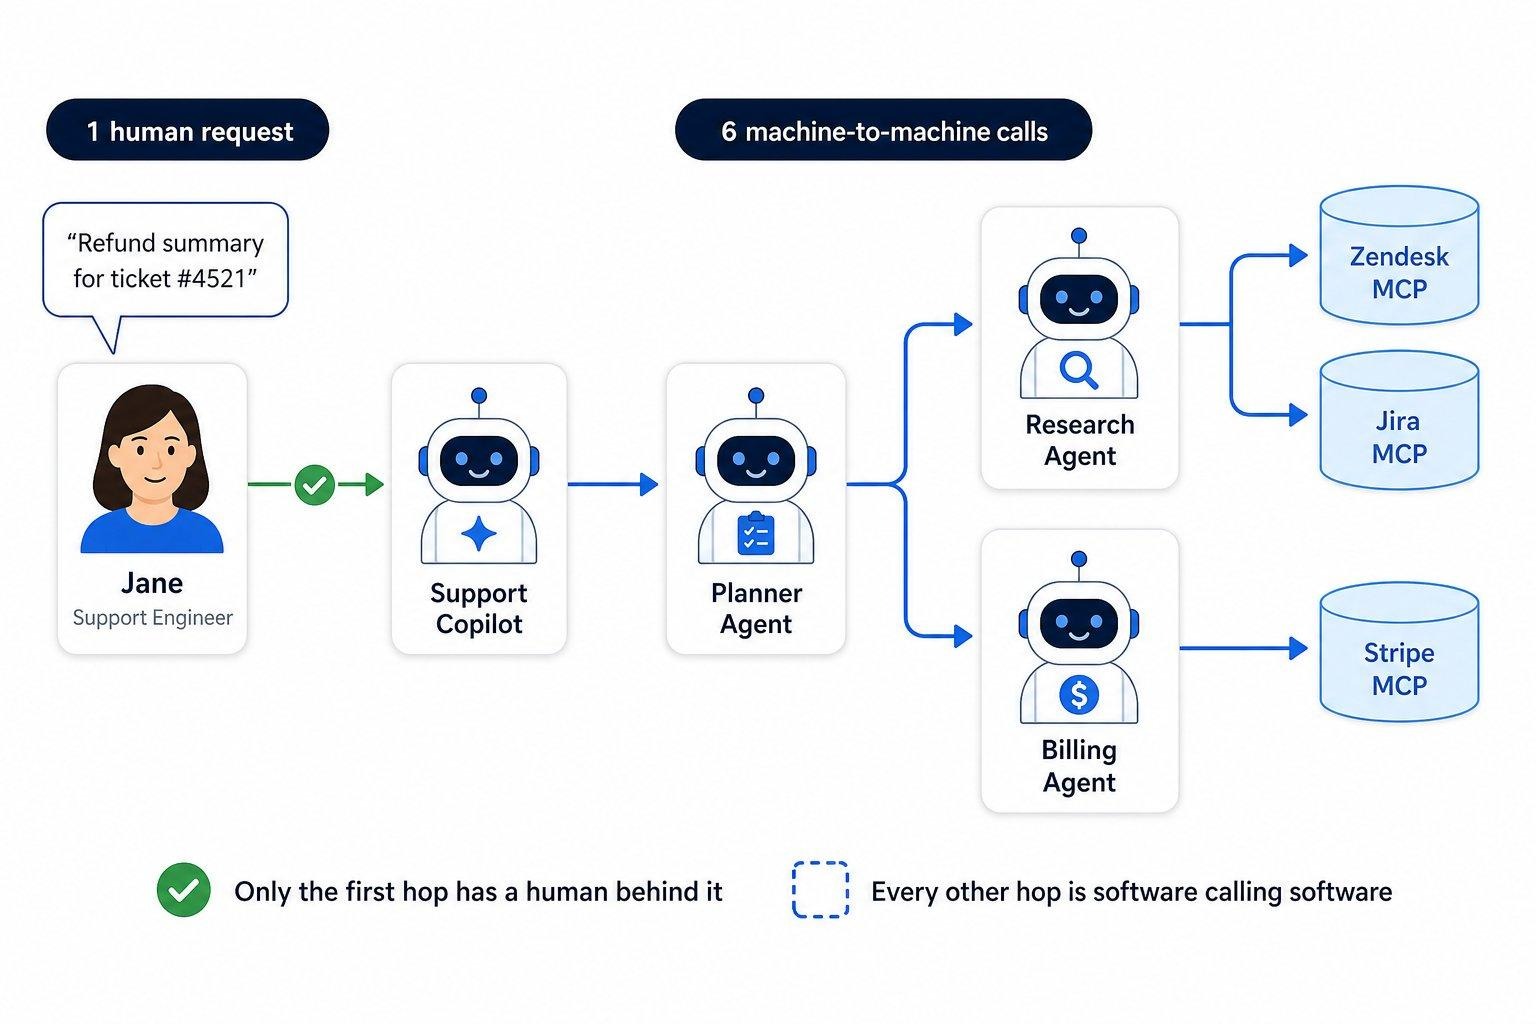
The control plane path for AI traffic
AIトラフィックのためのコントロールプレーンのパス

TrueFoundryは、3つの主要クラウドの12以上のリージョンにわたるSaaSとしてデプロイできるほか、HelmおよびOpenTofu/Terraformを介したVPC内でのセルフホスト、オンプレミス、あるいはエアギャップ環境(閉域網)でのデプロイが可能です。セルフホスト環境では、すべてのLLMトラフィックは顧客のインフラ内に留まり、TrueFoundryがライブのデータパスに入ることはありません。モデルサービング機能としては、vLLM、SGLang、Triton、TorchServe、MLflow、LitServeをカバーし、モデルレジストリ、CPU・RPS・Cronに基づくオートスケーリング、さらにタイムスライシングやMIGによるGPUの分割利用(フラクショナルGPU)をサポートします。これはハードウェアを所有しており、小型モデルごとにH100を1基丸ごと割り当てるのが無駄になる場合に極めて重要です。

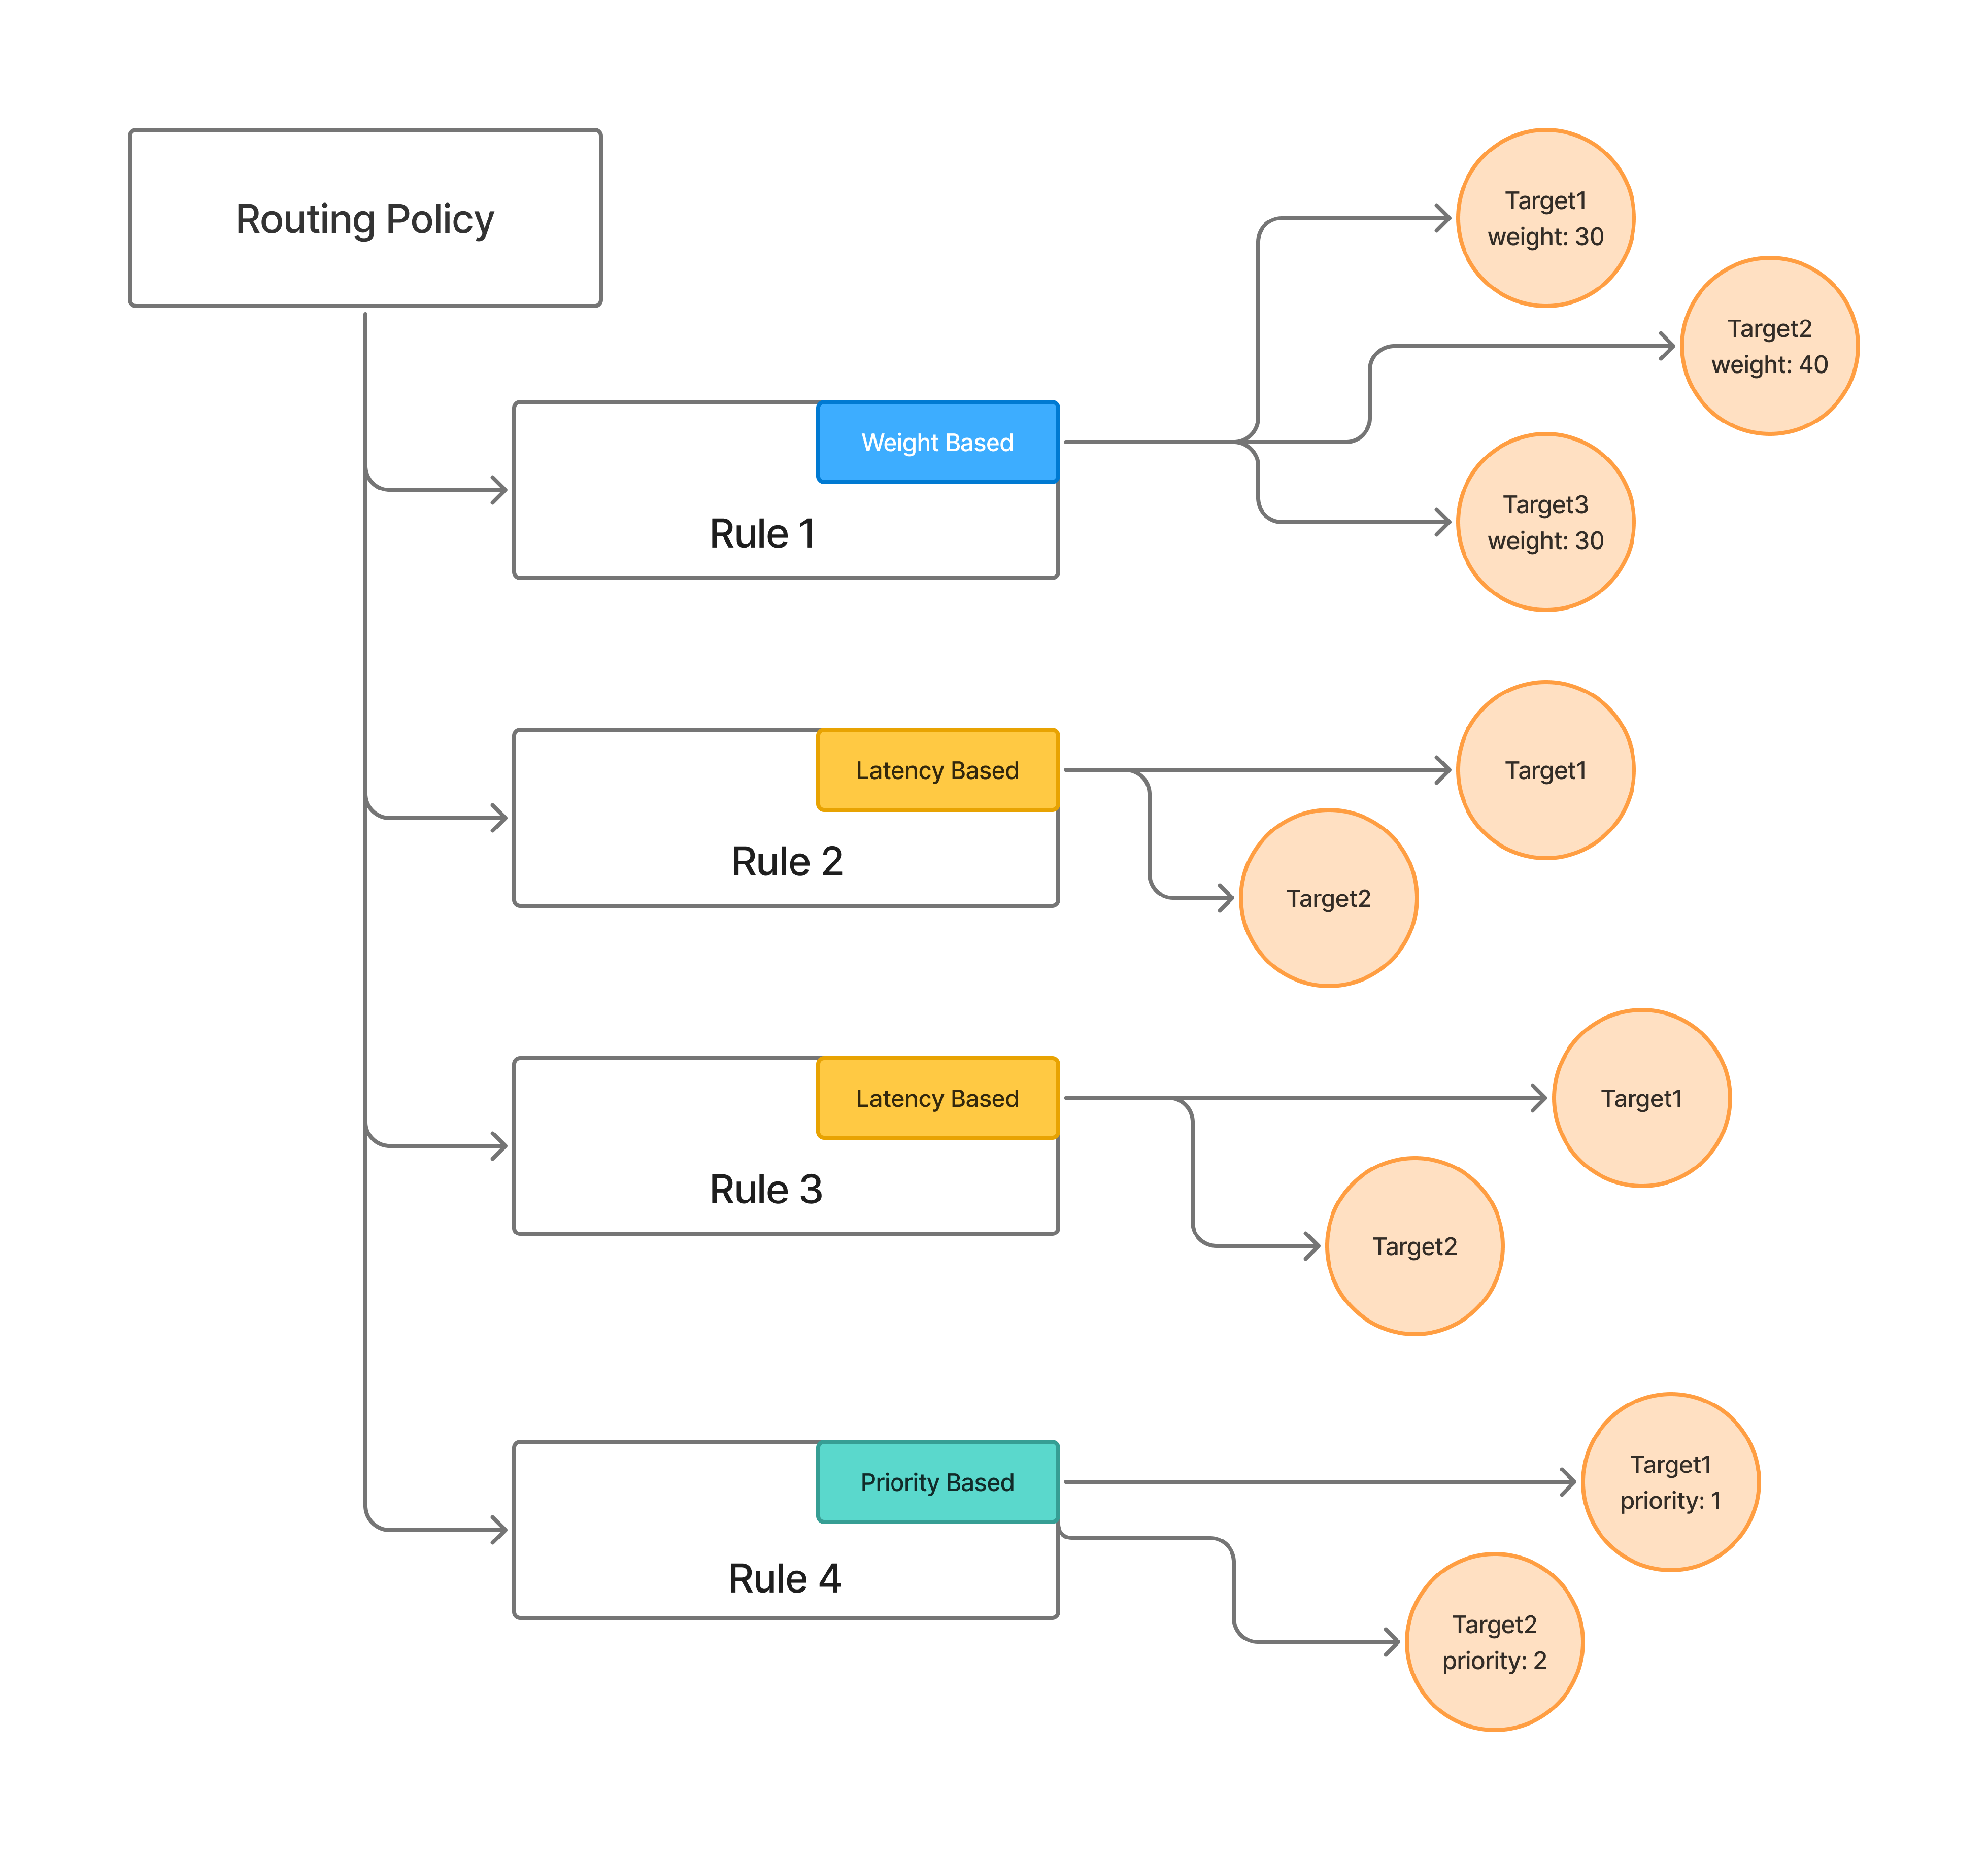
Routing configuration in the AI Gateway
AI Gatewayにおけるルーティング設定

もう一つの核心はAI Gatewayです。これを利用することで、セルフホスト型とホスト型のインファレンスが別々の問題ではなくなります。OpenAI互換の単一APIの背後で1,000以上のLLMを束ね、追加レイテンシを約3〜4 msに抑えつつ、1 vCPUあたり350以上のRPSを処理します。これにより、Basetenのエンドポイント、Modalのエンドポイント、OpenAIのAPIキーを同一のインターフェース配下に集約し、コスト帰属、レート制限、監査ログを一元管理できるようになります。Auto Routing(自動ルーティング)は強力なコスト削減レバーです。550個のプロンプトを用いた検証において、複雑さに応じたルーティングを行うことで、出力クオリティの98%を維持しながらコストを69%削減し、平均レイテンシを7.6秒から4.0秒へ短縮しました。

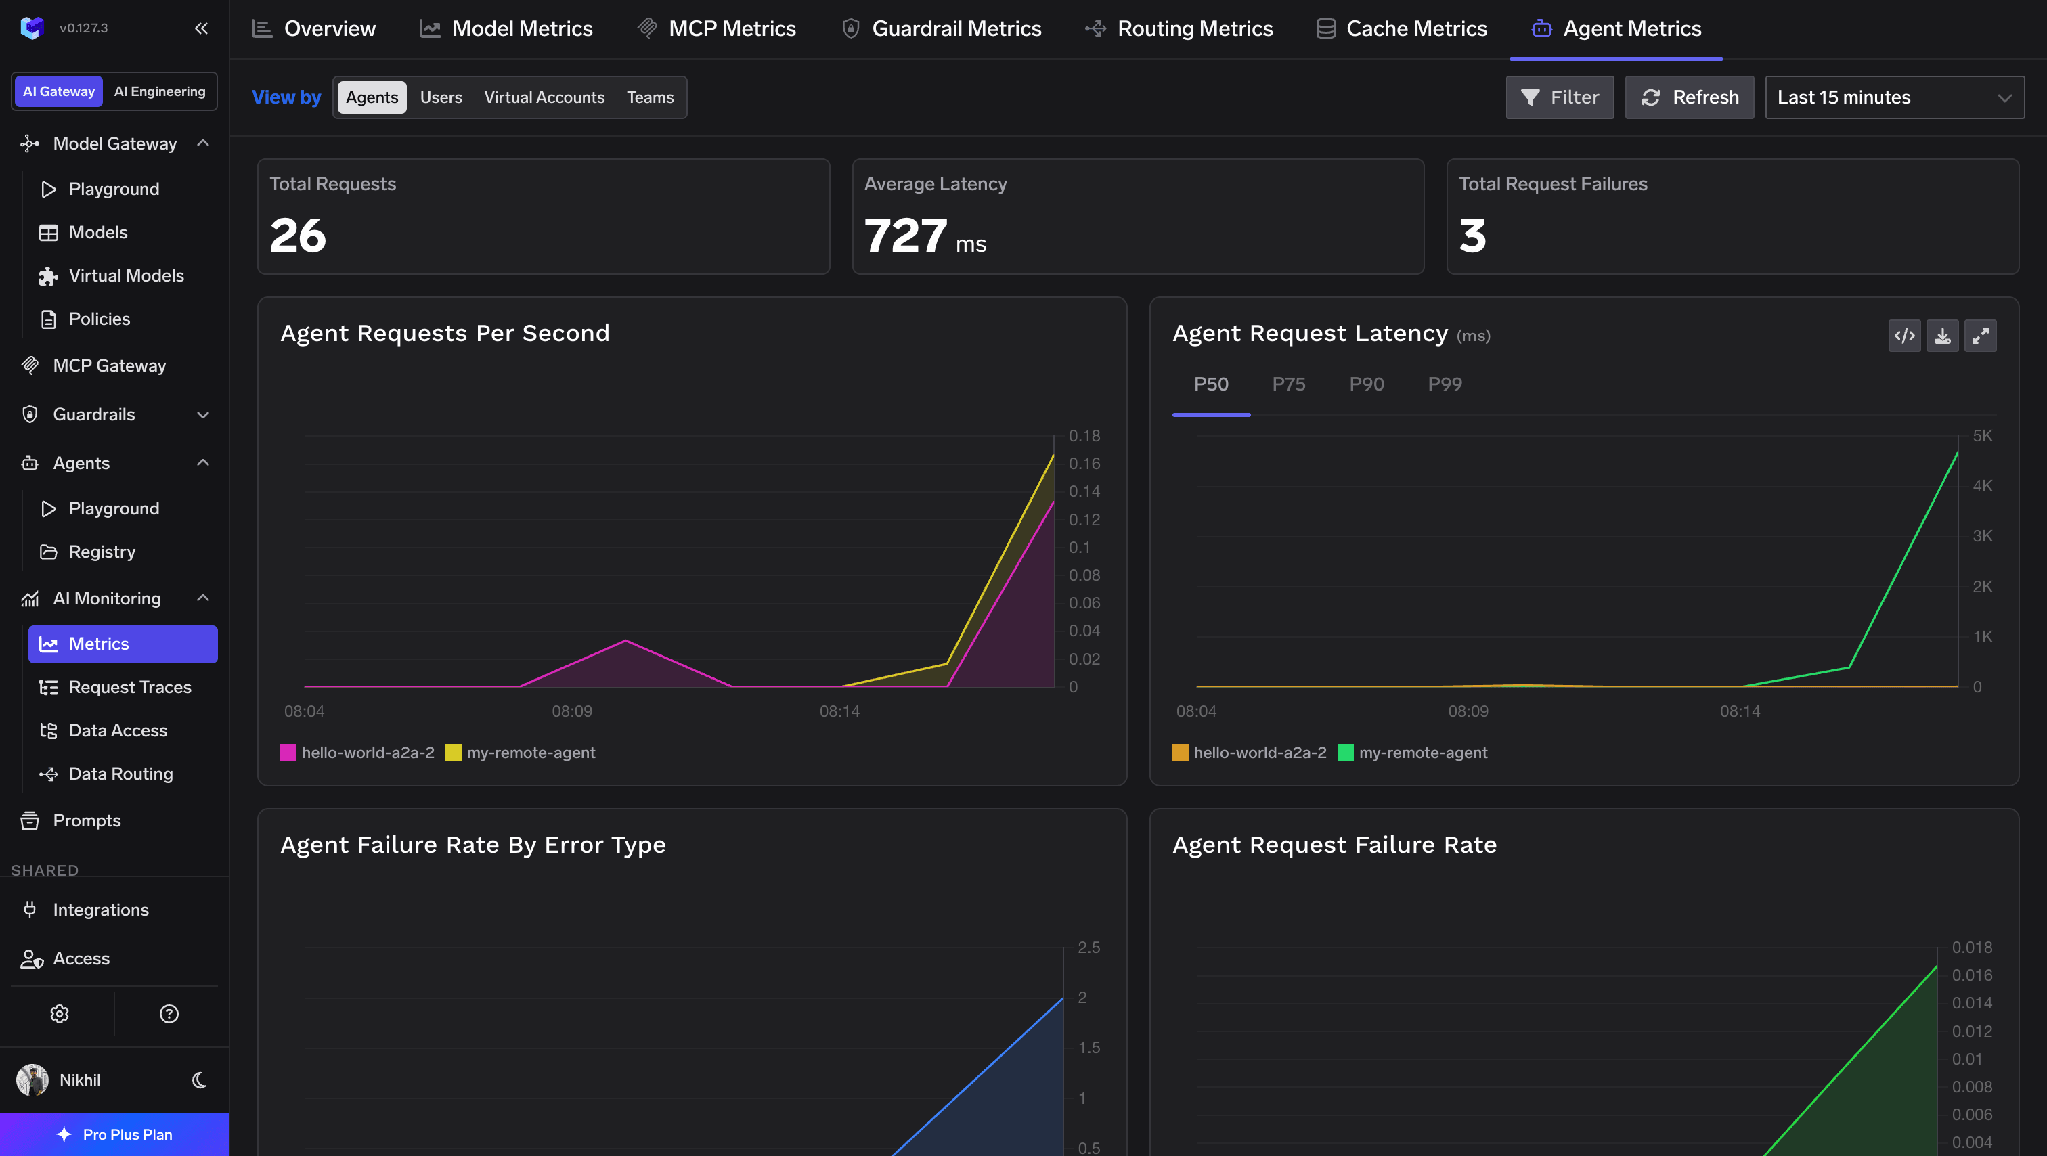
Model and traffic metrics in one place
モデルとトラフィックのメトリクスを一元確認

正直な制約事項:TrueFoundryはサーバーレスGPUマーケットプレイスではないため、コンピュート容量は自前で用意する必要があります。GPUを所有しておらず、調達する意向もない場合は、BasetenかModalを選択してください。

既にクラウドの契約枠や自社GPUをお持ちですか?
自社アカウント内の単一のコントロールプレーンから、モデルの実行と商用APIのルーティングを行えます。

直接比較

機能・特性 Baseten Modal TrueFoundry
カテゴリ ホスト型インファレンスクラウド ホスト型汎用AI計算基盤 自社クラウド内のコントロールプレーン
自社アカウント内での実行 可能(Self-hosted / Hybrid) 不可 可能(VPC、オンプレミス、エアギャップ)
商用LLMルーティング 非対応 非対応 1,000+モデル、単一API
GPU価格構造 バンドルSKU、分単位 GPU + CPU + メモリ別課金、秒単位 利用クラウドの契約レート
コスト帰属管理 Baseten内部のみ Modal内部のみ セルフホストおよび商用モデルを一元管理
最も適した用途 規制業界、VPC必須、TensorRT-LLM、小型GPU サンドボックス、Python DX、大規格GPU 自社クラウドを保有するチーム

関連資料

まとめ

BasetenとModalはいずれも優れています。人々が最初に確認する軸(価格)においては僅差ですが、調達決定を左右する軸においては全く異なる性質を持っています。

ワークロードを独自のVPC内で実行する必要がある場合、PHIを扱う場合、エンジンの構築作業なしでTensorRT-LLMを活用したい場合、あるいは小型かつリージョン固定のGPUを運用する場合は、Basetenが回答となります。インファレンスと並行してサンドボックス、バッチ、ノートブックが必要な場合や、Pythonの使いやすさを何よりも重視する場合は、Modalが回答となります。

避けるべきなのは、表面上のGPU料金だけで選択することです。両者間でそのまま比較することはできず、正しく補正すると、一見40%に見えた優位性が19%まで縮小したり、同等になったり、逆のベンダーに軍配が上がったりします。

本当の制約が「ワークロードを既に所有・所有契約しているインフラ内に留めなければならない」ことである場合、どちらのホスト型プラットフォームも回答にはなりません。それはコントロールプレーンの課題であり、まさに私たちが解決のために構築しているプロダクトです。

TrueFoundryを無料で試す

Try now.

One gateway for all your models, MCP servers, and agents. No credit card needed.

Start free
Table of Contents

One Gateway for Every LLM, Agent and MCP Server

Book a 30-min with our AI expert

Book a Demo

The fastest way to build, govern and scale your AI

Book Demo
Summarize with
ChatGPT logo by OpenAI
Perplexity AI logo
Blurry red snowflake on white background, symmetrical frosty design with soft edges and abstract shape.

Discover More

No items found.
November 10, 2026
|
5 min read

Taking TrueFoundry Global: Expanding Enterprise AI Infrastructure Across EMEA

No items found.
November 6, 2026
|
5 min read

Guardrails for Claude: PII Redaction and Prompt-Injection Defense

No items found.
November 6, 2026
|
5 min read

Claude Prompt Caching:実際の費用計算と投資対効果

No items found.
November 6, 2026
|
5 min read

エンタープライズにおけるClaude vs ChatGPT: セキュリティ、コスト、コントロール

No items found.
No items found.

Recent Blogs

Black left pointing arrow symbol on white background, directional indicator.

Frequently asked questions

BasetenとModal、どちらが安いですか?

GPUによって異なり、公開されている単価は誤解を招きます。表示価格では、H100とA100 80GBでModalのほうが37〜40%安く見えます。しかし、Basetenが含めているCPUとメモリを加えると、H100の差は約19%に縮まり、A100 80GBは同等になり、T4とA10ではBasetenのほうが9〜22%安くなります。Modalのピン留めとプリエンプトなしキャパシティの倍率はさらにBasetenに有利に働き、月額250ドルのTeam料金はBasetenにはない固定費です。

Modalの料金は、正確にはどうなっていますか?

Starterは月額0ドルで月30ドル分の無料コンピュート付き、Teamは月額250ドルで月100ドル分の無料コンピュート付き、Enterpriseは個別見積もりです。コンピュートは秒単位で、項目別に課金されます。GPUは個別の単価、CPUは物理コア時間あたり0.04716ドル、メモリはGiB時間あたり0.007992ドルです。SandboxとNotebookのコンピュートはFunctionの3倍の単価で、ピン留めとプリエンプトなしのキャパシティには倍率がかかります。

Basetenの料金は、正確にはどうなっていますか?

Basicは月額0ドルの従量課金でプラットフォーム料金はなく、SOC 2 Type IIとHIPAAが含まれます。ProとEnterpriseは見積もり制です。GPUコンピュートは、vCPUとRAMを含むオールインのインスタンスSKUに基づいて分単位で課金され、H100 80GBは1時間あたり6.4998ドルです。Model APIのトークン単価は公開されていますが、無料クレジットの金額は公開されていません。

Modalのコールドスタートはどのくらい速いですか?

コンテナはおよそ1秒で起動し、Modalのドキュメントによれば、Memory Snapshotsを使うと復元が3〜10倍高速になります。ModalのシリーズCに関する投稿にある「100x」という数字は同社のドキュメントでは裏付けられていないため、3〜10倍を前提に計画してください。GPUスナップショットはAlpha段階であり、ストレージからの重みの読み込みは高速化されません。

Basetenの評価額は260億ドルですか?

確認されていません。Basetenが公表している直近の評価額は130億ドルで、2026年6月22日の15億ドルのシリーズFによるものです。2026年9月下旬の報道では、より大規模なラウンドに関する協議が伝えられていますが、交渉段階の報道であり、同社は何も公表していません。


Take a quick product tour
Start Product Tour
Product Tour