November 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Les techniques d'ingénierie de prompt aident les équipes à rédiger de meilleures instructions pour les modèles de langage, à améliorer la qualité des sorties et à réduire les erreurs évitables. OpenAI décrit l'ingénierie de prompt comme la rédaction d'instructions efficaces permettant aux modèles de produire un contenu conforme aux exigences. Anthropic souligne que l'ingénierie de prompt fonctionne au mieux lorsque les critères de réussite sont contrôlables par le prompting.
Pour les équipes entreprise, l'ingénierie de prompt n'est plus une simple compétence de productivité personnelle. Elle influe désormais sur le coût du modèle, la latence, la fiabilité, la conformité et l'expérience utilisateur. Un prompt qui ajoute trois phrases de raisonnement peut doubler la consommation de tokens sur un mois à un million de requêtes. Un prompt qui accorde à un agent un accès non sécurisé à des outils peut constituer un incident de contrôle d'accès.
Ce guide détaille les méthodes d'ingénierie de prompt les plus utiles, le moment idéal pour les appliquer et les points d'articulation indispensables entre la discipline au niveau du prompt et la gouvernance de la passerelle IA. Il explique également comment TrueFoundry aide les équipes à gouverner les prompts, les modèles, les outils MCP, les budgets et les agents en production.
L'ingénierie de prompt est la pratique consistant à concevoir des prompts LLM pour produire des sorties d'IA fiables, précises et correctement formatées. C'est l'interface principale entre l'intention humaine et le comportement du modèle d'IA. La qualité de cette interface affecte directement la fiabilité, le coût, la sécurité et l'utilité de l'application sur différentes tâches.
Cette discipline a évolué : elle ne consiste plus seulement à rédiger des instructions concises pour une simple question, mais à construire des architectures de prompts pour des flux de travail agentiques. Un prompt moderne peut inclure des variables d'entrée, des règles de sortie structurée, du contexte supplémentaire, des paramètres de modèle, des guardrails et des exigences de politique pour une utilisation en production.
L'implication pratique est claire. Les équipes qui traitent les prompts comme du texte jetable déploient souvent des applications IA de moindre qualité. Les équipes qui appliquent des techniques d'ingénierie de prompt systématiques avec du versionnement, de l'évaluation et de la gouvernance disposent d'une trajectoire plus solide vers des réponses précises et de meilleurs résultats.
La fonctionnalité Prompt Management de TrueFoundry reflète ce changement. Un prompt enregistré stocke le message système, le message utilisateur, les variables d'entrée, les guardrails et la configuration de sortie structurée dans un unique objet versionné. Les applications peuvent le référencer par son nom pleinement qualifié plutôt que d'intégrer le texte du prompt en dur.
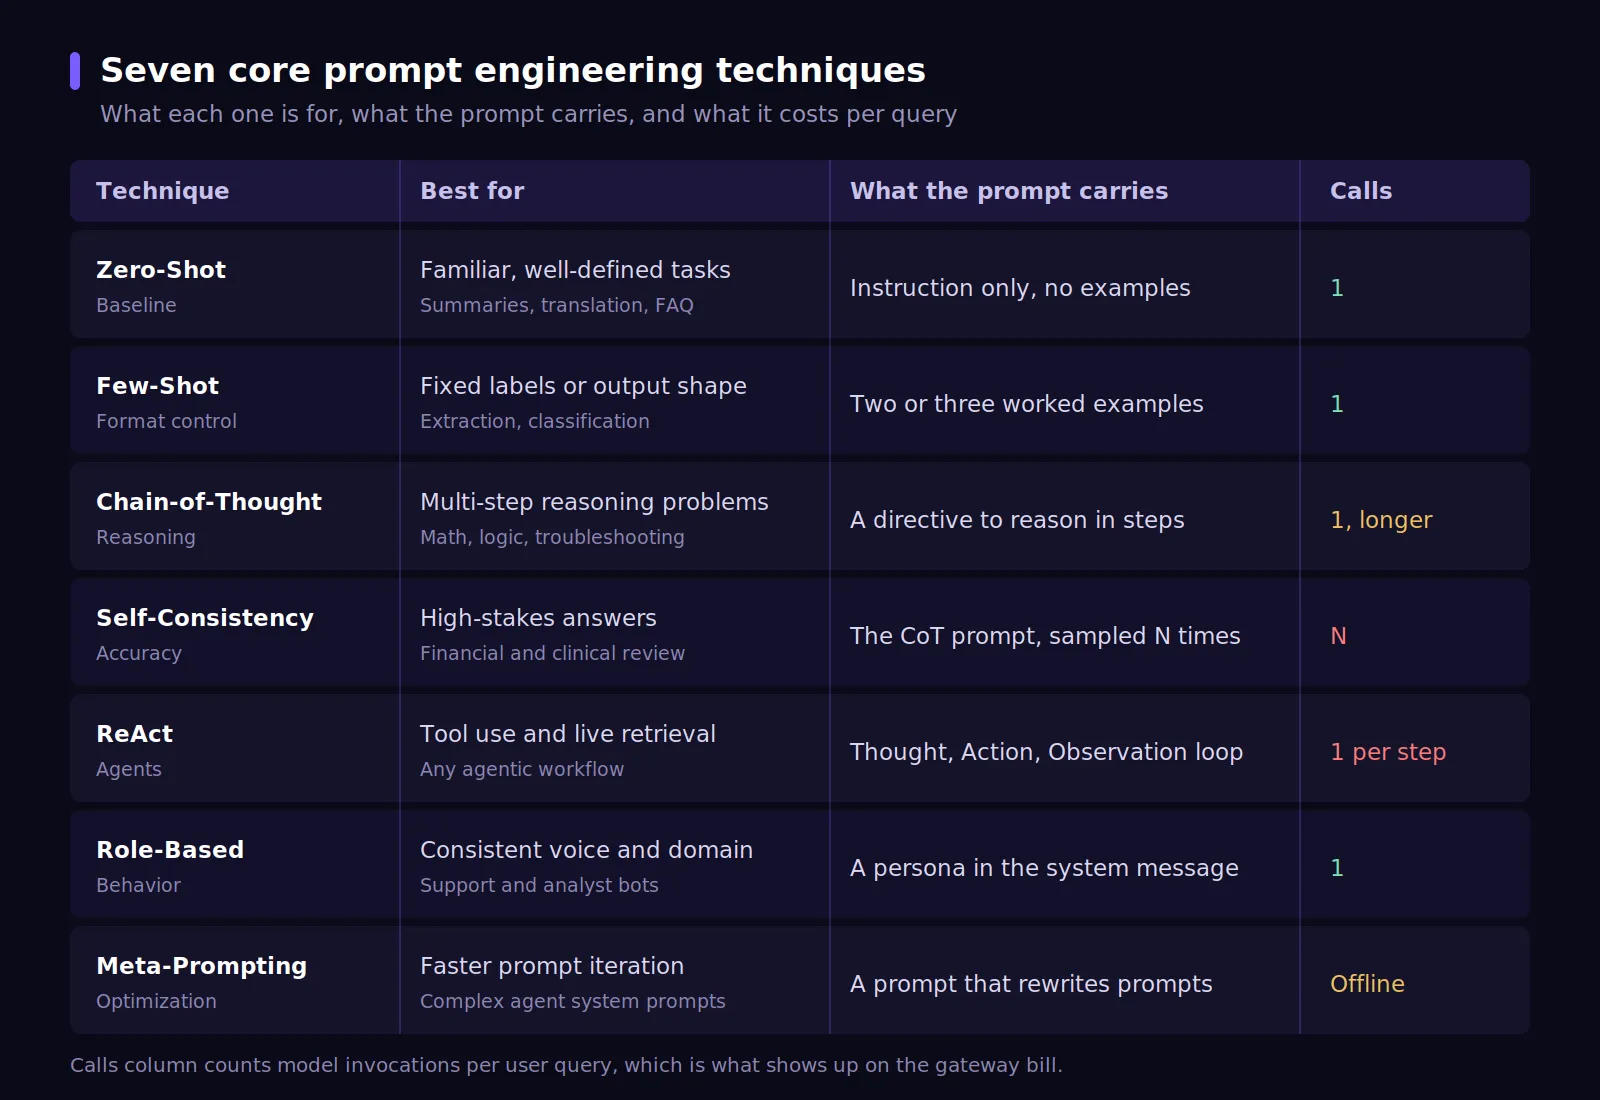
Sept techniques clés d'ingénierie de prompt couvrent la majorité des travaux en production. Abordez-les de manière progressive. Chacune apporte un gain de précision, de structure ou de contrôle. Chacune facturera également les équipes en tokens, en latence, en effort de maintenance ou en complexité de gouvernance.
Le prompting zero-shot demande au grand modèle de langage d'effectuer une tâche spécifique sans lui fournir d'exemples. Le modèle s'appuie sur ses données d'entraînement et son sens commun pour déduire le format de réponse, le contenu et le ton adéquats à partir de la seule instruction.
Idéal pour : Les tâches bien définies où le modèle comprend déjà le schéma. Les exemples incluent le résumé, la traduction, la classification simple, la réponse aux FAQ et l'extraction de faits pertinents à partir de saisies courtes.
Limitation : La fiabilité du zero-shot chute lorsque la tâche demandée exige un formatage strict ou un comportement spécifique à un domaine. La défaillance est souvent silencieuse. Un classificateur zero-shot renvoie un label plausible plutôt qu'une erreur, de sorte que le défaut n'apparaît plus tard que sous la forme de statistiques médiocres ou d'une baisse de satisfaction utilisateur.
Le prompting few-shot fournit un ou plusieurs exemples d'entrée-sortie avant la requête réelle. Ces exemples détaillés offrent au modèle un modèle concret à suivre, en particulier lorsque la sortie souhaitée exige un ton, un schéma, un jeu de labels ou une structure rédactionnelle spécifiques.
Idéal pour : Les tâches où la forme de la sortie importe. Utilisez-le pour la classification avec des labels fixes, l'extraction de données structurées, l'alignement de style, le ton spécifique au domaine et les exigences de format répétables.
Nombre d'exemples : Deux ou trois exemples donnent souvent de très bons résultats pour de nombreuses tâches de production. Davantage d'exemples peuvent améliorer la qualité du prompt, même si chaque requête paie pour ces tokens supplémentaires. Les équipes doivent mesurer cet arbitrage avant d'utiliser des prompts plus longs sur des endpoints à fort volume.
Le prompting chain-of-thought demande au modèle de détailler ses étapes de raisonnement intermédiaires avant de produire la réponse finale. Cela peut améliorer les performances sur un problème mathématique, une tâche logique, un processus de dépannage ou un problème de code où le raisonnement intermédiaire conditionne le résultat.
Idéal pour : Le raisonnement complexe, les arbres de décision, le diagnostic technique, l'analyse financière et les tâches de raisonnement élaborees. Il fonctionne le mieux lorsque le prompt demande une résolution réfléchie plutôt qu'une réponse courte.
CoT Zero-shot : Ajouter une instruction de raisonnement étape par étape peut activer le comportement chain-of-thought sans fournir de chaînes de raisonnement en exemple. Cela reste un moyen simple d'améliorer le raisonnement sur des tâches complexes.
Combinaison avec le few-shot : Les exemples few-shot intégrant des chemins de raisonnement peuvent améliorer les performances sur des flux de travail spécifiques au domaine. Les équipes doivent garder la réponse affichée concise lorsque les utilisateurs n'ont besoin que du résultat final.
Une réserve opérationnelle essentielle s'applique ici. La sortie chain-of-thought est longue, et les sorties longues sont précisément ce que les équipes diffusent en streaming pour maintenir une latence perçue faible. La documentation des guardrails de TrueFoundry indique que les guardrails de sortie sont ignorés lorsqu'une requête définit `stream: true`, car il n'y a pas de réponse complète à évaluer. Un raisonnement diffusé en streaming est un raisonnement qu'aucune politique de sortie ne peut inspecter.
La self-consistency étend le prompting chain-of-thought en générant plusieurs chaînes de raisonnement indépendantes pour la même question. Le système sélectionne ensuite la réponse finale la plus cohérente parmi l'ensemble des échantillons.
Idéal pour : Le raisonnement à haut risque où la précision de la réponse compte plus que le coût d'inférence. Les exemples incluent l'évaluation des risques, le support au raisonnement juridique, l'analyse financière, les études de cas et les recommandations sensibles pour la sécurité.
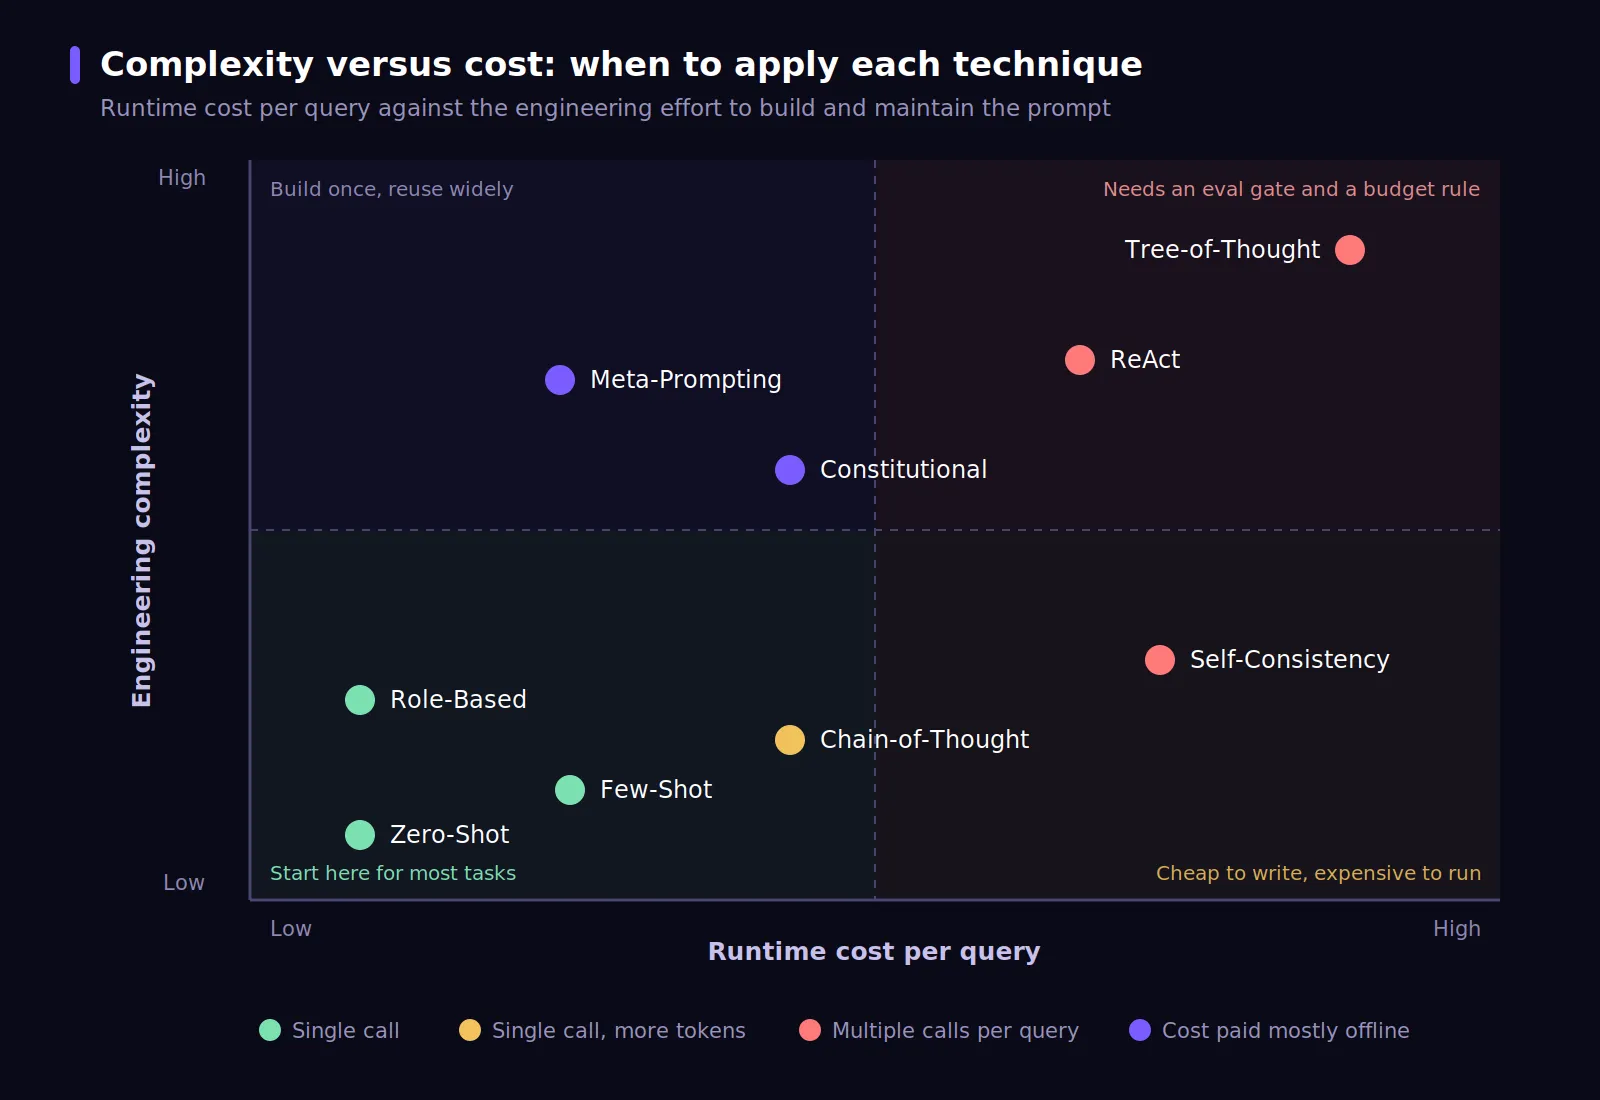
Arbitrage de coût : La self-consistency exige plusieurs appels au modèle par requête. Cinq chaînes échantillonnées transforment une requête facturable en cinq requêtes. L'application d'un budget par équipe via une AI Gateway est essentielle lorsque les équipes appliquent cette méthode à grande échelle.
Le prompting ReAct combine raisonnement (Reasoning) et action (Acting). Le modèle alterne entre une étape de pensée (Thought), une étape d'action (Action) et une étape d'observation (Observation). Ce schéma permet au modèle de raisonner, d'appeler des outils externes, de lire le résultat et de continuer jusqu'à ce que la tâche soit accomplie.
Idéal pour : Les flux de travail agentiques nécessitant de la recherche d'information, de l'exécution d'outils, du contexte en temps réel ou la réalisation de tâches en plusieurs étapes. ReAct est utile lorsqu'un assistant IA doit interagir avec des bases de données, des API, des outils SaaS ou des systèmes internes.
ReAct fait évoluer la question de la sécurité. Le prompt ne façonne plus seulement le texte. Il influe également sur la sélection des outils et l'ordonnancement des actions. Lorsque les outils interagissent avec des systèmes métier, la passerelle MCP Gateway sert de couche d'application pour les permissions, la validation et les journaux d'audit.
Le prompting basé sur les rôles attribue au modèle une persona, un domaine d'expertise ou un contexte comportemental spécifique au niveau du prompt système. « Vous êtes un analyste financier senior qui examine le portefeuille d'un client » produit des schémas de raisonnement et des styles de sortie différents de la même question posée sans attribution de rôle.
Idéal pour : Les applications spécifiques à un domaine, les agents de service client avec des personas définies, les bots de support technique et toute application où la constance de la voix et du contexte comportemental est importante à travers toutes les interactions.
Application en entreprise : Les prompts système basés sur les rôles constituent le mécanisme principal pour appliquer des guardrails comportementaux au niveau de l'application, avant que le filtrage des sorties ne soit exécuté sur la couche d'infrastructure.
Remarquez une limite qui surprend la plupart des équipes. La documentation des guardrails de TrueFoundry confirme que les prompts système sont exclus par défaut de l'évaluation des guardrails. La définition du rôle elle-même n'est donc jamais inspectée, bloquée ou caviardée. Les instructions de persona façonnent le comportement, mais elles n'agissent pas comme une politique vérifiée par l'infrastructure.
Le meta-prompting utilise le LLM pour analyser, critiquer et améliorer les prompts plutôt que d'exécuter directement les tâches de l'utilisateur final. Un ingénieur de prompt peut l'utiliser pour générer des candidats, comparer des schémas courants et affiner les instructions en moins de temps.
Idéal pour : Les équipes qui itèrent fréquemment sur la conception des prompts et souhaitent accélérer l'optimisation. Il est utile pour les activités complexes, la planification stratégique et les prompts système d'agents comportant de nombreux éléments clés.
Note pour la production : Le meta-prompting génère des prompts candidats qui nécessitent toujours une évaluation par rapport à un jeu de test avant d'être promus en production. Il accélère l'étape de génération de candidats, pas l'étape de validation.
Un flux de travail rigoureux d'amélioration des prompts préserve la sincérité de cette distinction en évaluant les candidats par rapport à un jeu d'évaluation fixe plutôt qu'à la simple impression d'un réviseur.
Les techniques avancées ci-dessous échangent davantage de calcul ou d'effort de conception contre des gains sur des problèmes que les techniques plus simples gèrent mal. Utilisez-les lorsqu'un jeu d'évaluation prouve que la méthode la plus simple a atteint ses limites.
Le Tree-of-Thought étend le prompting linéaire chain-of-thought vers une structure en arborescence. Le modèle explore plusieurs chemins de raisonnement, évalue des solutions potentielles et sélectionne la branche la plus prometteuse pour continuer.
Idéal pour : Les problèmes où le chemin de résolution n'est pas évident dès l'énoncé initial. Les exemples incluent la synthèse de recherche, le travail créatif tel qu'une nouvelle, le développement stratégique, le débogage complexe et la planification ouverte.
Le Tree-of-Thought peut améliorer les résultats sur des tâches de raisonnement difficiles. Il augmente également les coûts proportionnellement au facteur de ramification et à la profondeur. Cela rend les plafonds budgétaires essentiels avant que la technique n'atteigne les endpoints accessibles aux clients.
Le prompting constitutionnel intègre un ensemble de principes directement dans le prompt système. Le modèle utilise ces principes pour s'auto-évaluer et réviser sa propre réponse avant de renvoyer un résultat.
Idéal pour : Les applications IA où un alignement constant avec les valeurs de l'entreprise, les règles de sécurité ou les normes de conformité est essentiel. Il peut aider à guider le comportement avant l'exécution du filtrage post-génération.
Traitez la constitution comme un contrôle qualité et non comme un contrôle d'audit. Les principes résident dans le prompt système. Les preuves de conformité doivent provenir de guardrails, de traces, de résultats de politiques et de journaux que le modèle ne peut pas influencer.
Le prompting à stimulus directionnel ajoute un indice bref, un mot-clé ou un signal directeur pour orienter le modèle vers l'information la plus pertinente. Cela peut aider lorsque le prompt de base est clair mais que le modèle a besoin d'un signal plus fort sur ce qui importe.
Idéal pour : Les tâches de classification, de résumé et d'extraction où un petit indice directionnel améliore la focalisation. Par exemple, un résumé sur le changement climatique peut utiliser un stimulus tel que « impacts politiques » pour guider l'attention.
Il s'agit d'une technique avancée car de petits indices peuvent modifier la réponse de manière inattendue. Les équipes doivent comparer les performances à une base de référence et confirmer que le stimulus améliore la sortie visée sans altérer les autres cas.
Les différentes méthodes d'ingénierie de prompt fonctionnent différemment dans des tests contrôlés et dans des environnements de production avec de vrais utilisateurs. Plusieurs réalités opérationnelles dictent quelles techniques restent viables une fois que le trafic, le coût, le risque et la gouvernance augmentent.
Le guardrail d'injection de prompt intégré de TrueFoundry s'exécute uniquement en mode validation, et analyse le prompt utilisateur ainsi que tout contenu de document ou de contexte comme deux surfaces distinctes. Cette séparation de l'analyse est cruciale car l'injection indirecte se produit au sein des documents récupérés et non dans le propre message de l'utilisateur.
Les techniques d'ingénierie de prompt déterminent dans quelle mesure un LLM comprend et exécute une tâche. La couche de gouvernance détermine si cette exécution se produit en toute sécurité, dans le respect des limites de coût, et avec les contrôles d'accès et les preuves d'audit requis en production d'entreprise.
L'AI Gateway de TrueFoundry applique un filtrage des entrées avant que les prompts n'atteignent un modèle, interceptant les tentatives d'injection de prompt quelle que soit la sophistication des méthodes d'ingénierie de prompt du système. Les guardrails de sortie appliquent la politique de contenu avant que les réponses ne soient renvoyées aux applications, complétant ainsi le prompting constitutionnel au niveau du modèle plutôt que de le remplacer.
Le modèle d'exécution mérite une lecture attentive. Les guardrails de validation d'entrée s'exécutent en parallèle de la requête au modèle, et lorsqu'une validation échoue en cours de route, la passerelle annule la requête au modèle afin que le prompt bloqué ne soit jamais facturé. Les guardrails de mutation d'entrée, tels que la caviardage de PII, s'exécutent au contraire avant la requête, car ils réécrivent la charge utile que reçoit le modèle.
Chaque guardrail figure sur la trace de la requête comme sa propre travée (span) avec la latence, le verdict, la portée et l'entié à laquelle il s'est appliqué. Le déploiement suit les faits : démarrez les règles en mode Audit, passez en Enforce, But Ignore On Error, puis passez en Enforce dès que les résultats sont satisfaisants.
Les guardrails peuvent être rattachés par requête via l'en-tête `X-TFY-GUARDRAILS`, ou de manière centralisée sous forme de politiques dans AI Gateway → Controls → Guardrails pour une application à l'échelle de l'organisation.
Les budgets de tokens par équipe appliqués via la passerelle LLM gateway évitent les dépassements de coûts que les techniques de self-consistency et de tree-of-thought génèrent à l'échelle en l'absence de gouvernance budgétaire. Les règles de limitation de débit acceptent les unités de tokens tout comme les unités de requêtes, et `rate_limit_applies_per` crée un compteur indépendant par utilisateur, par modèle ou par clé de métadonnées.
Les règles budgétaires ajoutent des plafonds financiers en dollars par utilisateur, équipe, modèle, compte virtuel ou clé de métadonnées. Les alertes de palier et le mode d'audit aident les équipes à calibrer les seuils avant que l'application ne bloque le trafic.
Les applications peuvent appeler un prompt gouverné par son FQN de version au lieu de déployer du texte avec l'application. Cela maintient la modification des prompts hors du cycle de mise en production. La passerelle génère le modèle et exécute l'appel.
Deux détails de cet appel ont leur importance. Le verrouillage de version signifie qu'un rollback de prompt ne nécessite jamais de redéploiement, et l'en-tête `X-TFY-METADATA` permet de rattacher les budgets par service, les limites de débit et l'attribution des coûts à un propriétaire réel.
La passerelle Agent Gateway gouverne chaque appel d'outil effectué par des agents basés sur ReAct, de sorte que les étapes de raisonnement et d'exécution restent gouvernées de façon indépendante, et que chaque invocation d'outil porte le contexte d'identité de l'utilisateur dans son journal.
La passerelle MCP Gateway fournit les crochets pre-invocation et post-invocation qui l'appliquent, et les guardrails évaluent chaque appel d'outil séparément plutôt qu'une seule fois par conversation. Un agent qui appelle cinq outils dans une séquence obtient cinq séries de vérifications.
Les crochets pre-invocation interrompent l'action avant qu'elle ne s'exécute, couvrant la validation des paramètres, l'assainissement SQL et les vérifications de permissions rédigées sous forme de politiques Cedar ou OPA. Les crochets post-invocation inspectent la sortie de l'outil, capturant les injections indirectes et les fuites de secrets avant que l'étape d'observation ne les réinjecte dans le contexte du modèle.
Créez des flux de travail de prompts qui restent gouvernés en production. Réservez une démo pour découvrir comment TrueFoundry relie le registre de prompts, les guardrails, le contrôle budgétaire et les journaux d'audit au sein de votre passerelle IA.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception