



November 6, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Hay un momento en la mayoría de los programas empresariales de AI en el que aparece una carga de trabajo que no puede enviar sus datos a una API de terceros: un conjunto de datos regulado, un requisito de soberanía o una curva de costes que se ha vuelto atemorizante a gran escala. La respuesta es un modelo de pesos abiertos que ejecuta usted mismo. El motivo por el cual los equipos lo temen no es el modelo; es que el autoalojamiento suele implicar una segunda pila diferente —una API ajena a OpenAI, una capa de servicio, operaciones de GPU— acoplada a una plataforma construida alrededor de API comerciales. Este artículo explica cómo una gateway colapsa esa duplicidad, haciendo que un modelo Llama o Mistral autoalojado sea un reemplazo directo junto a los modelos comerciales a los que ya llama.
Ravi, un ingeniero de plataformas de ML, recibió la solicitud que estaba esperando: una nueva carga de trabajo procesaría registros que, por política, no podían salir de la nube de la empresa. Ninguna API comercial era una opción. Un modelo de pesos abiertos ejecutándose en su propia VPC era la respuesta evidente, y a Ravi se le cayó un poco el alma a los pies, porque la aplicación que lo necesitaba estaba escrita para la API de OpenAI, el equipo no tenía una pila de servicio y ya podía imaginarse el universo paralelo de un segundo SDK, un segundo conjunto de paneles de control y un problema de autoescalado de GPU que nadie había resuelto. El modelo era la decisión fácil. La pila a su alrededor era lo que infundía temor.
Lo que cambió la semana de Ravi fue darse cuenta de que el modelo autoalojado no tenía por qué ser una pila diferente en absoluto. Si se situaba detrás de la misma gateway que los modelos comerciales, hablando la misma API compatible con OpenAI, para la aplicación era simplemente otro nombre de modelo, y para la plataforma era un punto de enlace más gobernado por las mismas reglas. El requisito de soberanía se cumplió sin bifurcar la arquitectura. En este artículo se explica cómo funciona esto y dónde reside la verdadera ingeniería.
El autoalojamiento de un modelo de pesos abiertos raras veces se trata de calidad: las API punteras son excelentes y están mejorando. Se trata de otras cuatro cosas. Soberanía: algunos datos legalmente o por contrato no pueden salir de su entorno, algo que un modelo ejecutado en su VPC o en sus instalaciones satisface por diseño. Coste a escala: a partir de un cierto volumen constante, las GPU amortizadas pueden reducir el precio por token, especialmente para cargas de trabajo de alto rendimiento y predecibles. Control: usted elige la versión del modelo, puede realizar un ajuste fino con datos propietarios y no está sujeto a que un proveedor retire o modifique un modelo sin su consentimiento. Disponibilidad: su ruta de inferencia ya no está vinculada directamente al tiempo de actividad de la API de un proveedor de modelos, aunque ahora depende de su propia infraestructura y cadena de suministro de despliegue.
El contrapeso honesto es que ahora usted es el propietario de las operaciones de inferencia: la capacidad de las GPU, la pila de servicio, el escalado y la fiabilidad, un trabajo que una API comercial oculta por completo. El autoalojamiento vale la pena cuando uno de esos cuatro factores es real y el coste operacional está contenido. La mayoría de las empresas terminan siendo híbridas: API comerciales para el tráfico general y modelos autoalojados para los fragmentos soberanos o de gran volumen. El objetivo no es reemplazar uno por otro, sino ejecutar ambos sin duplicar toda la infraestructura.
La personalización merece ser extraída de esa lista, porque a menudo es el factor que inclina a un equipo específicamente hacia los pesos abiertos. Una API comercial le proporciona un modelo entrenado por otra persona para todo el mundo; un modelo de pesos abiertos lo puede adaptar a su dominio, sus formatos, su tono y sus casos límite mediante un ajuste fino sobre datos que no puede o no quiere enviar a ninguna parte. Para tareas estrechas y repetitivas, un modelo abierto más pequeño ajustado puede igualar o superar a uno general mucho más grande a una fracción del coste de servicio, lo que vuelve a conectar la personalización con el factor coste. La trampa es que el ajuste fino es su propia canalización: preparación de datos, ejecuciones de entrenamiento, evaluación, versionado y, luego, servir el resultado como cualquier otro modelo. TrueFoundry admite tanto el ajuste fino sin código como con código completo junto a su pila de servicio, de modo que un modelo ajustado aterriza detrás del mismo punto de enlace de la gateway que todo lo demás, en lugar de convertirse en un artefacto separado que deba operacionalizar manualmente. El punto no es que el ajuste fino siempre valga la pena (con frecuencia no es así, y un buen modelo base con peticiones sólidas suele ganar), pero cuando lo vale, ser propietario de los pesos es lo que lo hace posible en absoluto.
Cabe añadir una advertencia en esta decisión, no después de ella: los pesos abiertos no significan libertad de obligaciones. Antes de autoalojar o realizar un ajuste fino, verifique la licencia del modelo, la política de uso aceptable, los términos de redistribución, los requisitos de atribución y cualquier restricción en el uso regulado o comercial; algunos modelos populares de pesos abiertos incluyen umbrales de uso o límites de campo de aplicación que importan a escala empresarial. Trate la revisión de la licencia como parte de la lista de verificación de despliegue, no como una nota al pie descubierta después de que el modelo ya esté en producción.
El temor de Ravi tenía un buen fundamento, porque la forma ingenua de autoalojar produce exactamente esa segunda pila. El modelo de pesos abiertos expone su propia forma de API, por lo que la aplicación necesita una ruta de código para ella. Necesita un motor de servicio, que es su propia superficie operacional. Necesita autoescalado de GPU, que no se comporta en absoluto como el escalado de un servicio web sin estado. Y necesita su propia observabilidad, porque los paneles de control de las API comerciales no la ven. Multiplique eso por unos pocos modelos y tendrá una plataforma paralela cuyo único trabajo es ser diferente de la que ya ejecuta.
La idea que desactiva esto es que casi nada de esa diferencia necesita llegar a la aplicación ni a la superficie de control de la plataforma. El motor de servicio y el escalado de GPU son reales e inevitables: son el trabajo auténtico del autoalojamiento. Pero la forma de la API, el enrutamiento, la gobernanza y la observabilidad se pueden hacer idénticos a la ruta comercial colocando la misma gateway por delante. El resto de este artículo separa la diferencia que es esencial (servicio, GPU) de la diferencia que es accidental (todo lo que la gateway puede absorber).
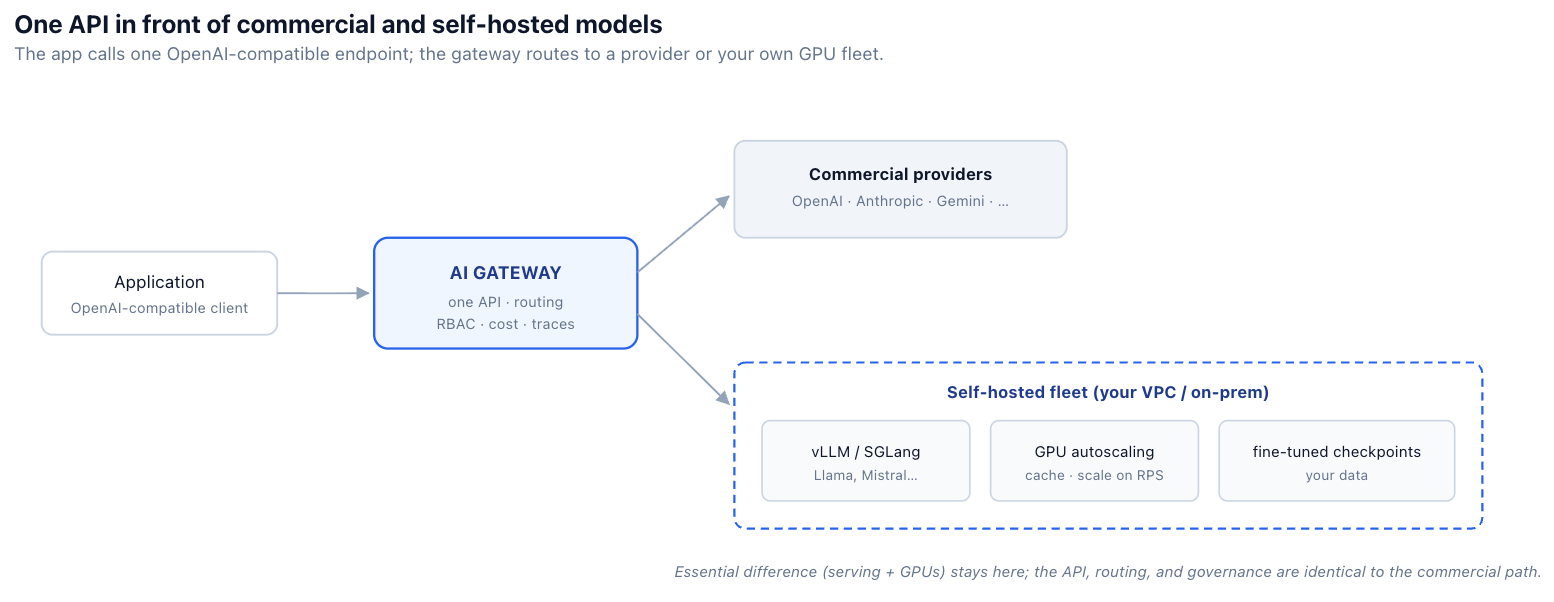
El paso que hace que el autoalojamiento sea sencillo es exponer el modelo autoalojado a través de la misma API compatible con OpenAI que la aplicación ya habla. Cuando un Llama autoalojado responde a la misma estructura de solicitud que un modelo comercial, cambiar entre ellos es un cambio de configuración, no un cambio de código, y el enrutamiento, la conmutación por error, el RBAC, los presupuestos y la trazabilidad se aplican de forma uniforme porque, desde la perspectiva de la gateway, es simplemente otro modelo detrás de la misma interfaz.
Mismo cliente, misma llamada: solo cambia el nombre del modelo (ilustrativo)
Esta es la misma unificación que cubre nuestro artículo de enrutamiento, aplicada al caso autoalojado: la aplicación se desvincula de dónde se ejecuta físicamente un modelo. La carga de trabajo regulada de Ravi apunta a un nombre de modelo autoalojado; todo lo demás en su plataforma sigue funcionando sin cambios. La AI Gateway de TrueFoundry está diseñada para ser exactamente esta interfaz central tanto para modelos autoalojados como de terceros.
Esta es la diferencia de la que realmente debe hacerse cargo. Un modelo de pesos abiertos no se sirve a sí mismo; se ejecuta dentro de un motor de inferencia, y el motor que elija afecta de forma sustancial al rendimiento, la latencia y la eficiencia de la memoria. vLLM popularizó el procesamiento por lotes continuo (continuous batching) y la atención paginada (paged attention) para un alto rendimiento; SGLang es fuerte en cargas de trabajo estructuradas y de alta concurrencia; TGI es un servidor maduro y ampliamente desplegado; y TRT-LLM (Triton) exprime el rendimiento específico del hardware en GPU NVIDIA. Ninguno es universalmente el mejor.
La disciplina que importa es la realización de pruebas de rendimiento (benchmarking): ejecute su modelo real, con sus longitudes de secuencia y concurrencia reales, en los motores y GPU candidatos, y elija en función de los números en lugar de la reputación. La documentación de despliegue de LLM de TrueFoundry enumera vLLM, SGLang y TRT-LLM como servidores de modelos compatibles (TGI y Triton aparecen entre los backends autoalojados de la gateway), y la plataforma tiene como objetivo seleccionar una configuración de GPU sensata para un modelo dado de forma automática, lo que transforma la duda sobre «qué motor y cuántas GPU» de un proyecto de investigación en una elección que usted valida contra sus propias pruebas. El motor es una complejidad esencial; el objetivo es hacer que su selección y operación sea algo rutinario.
Autoescalar un LLM autoalojado no es como autoescalar un servicio web, por una obstinada razón: los pesos son gigantescos, oscilando desde unos pocos gigabytes hasta bastante más de cien. Un escalador ingenuo que descargue un modelo de 100 GB cada vez que añada una réplica pasará minutos y un coste de red serio antes de que el nuevo pod sirva un solo token, lo que hace que escalar durante un pico de tráfico sea casi inútil. El arranque en frío es el problema operacional que define la inferencia autoalojada.
Las soluciones son poco glamurosas pero decisivas. El almacenamiento en caché de modelos descarga los pesos una vez y los monta en cada pod, de modo que una nueva réplica se inicia desde una copia local en lugar de una descarga nueva. El streaming de imágenes descarga la imagen de servicio mucho más rápido que un despliegue en frío. Los volúmenes de modelos compartidos mantienen los pesos completamente fuera de cada imagen. Juntos, estos elementos pueden mover un arranque en frío de «descargar todo desde cero» a una ruta de escalado lo suficientemente rápida para que el autoescalado basado en RPS siga la demanda, aunque el tiempo de inicio real todavía depende del tamaño del modelo, la clase de almacenamiento, la ubicación del registro, el estado térmico del nodo y la programación de las GPU. La documentación de TrueFoundry describe el almacenamiento en caché de modelos (los pesos se descargan una vez y se montan en cada pod), el streaming de imágenes para descargas de imágenes vLLM y SGLang marcadamente más rápidas y los volúmenes compartidos precisamente por esta razón; es la diferencia entre un autoescalado que funciona y un autoescalado que es teórico.
El autoalojamiento también acerca la responsabilidad de la cadena de suministro a usted. Los pesos, la imagen de servicio y sus dependencias son ahora artefactos de los que es propietario y que debe distribuir. Fije las versiones del modelo y de la imagen en lugar de seguir una etiqueta en movimiento, verifique las sumas de comprobación o firmas donde la fuente las proporcione, controle quién puede publicar puntos de control (checkpoints) del modelo e imágenes de servicio en su registro, escanee esas imágenes como cualquier otro contenedor de producción y mantenga una ruta de reversión tanto para el motor como para los pesos. La gateway gobierna quién puede llamar al modelo; esta es la disciplina que gobierna lo que realmente está ejecutando detrás de ella.
Un modelo autoalojado como un despliegue gobernado (configuración ilustrativa)
El autoalojamiento desbloquea una optimización que las API comerciales le ocultan en gran medida: el control sobre cómo se mapean las solicitudes a las GPU. Cuando un modelo procesa una secuencia, construye una caché de clave-valor (KV-cache) de sus cálculos de atención. Si la siguiente solicitud comparte un prefijo (la misma petición del sistema, la misma conversación hasta el momento), enrutarla a la misma instancia de GPU permite que el motor reutilice ese cálculo almacenado en caché en lugar de volver a calcularlo, lo que reduce la latencia de forma significativa en el tráfico denso en prefijos.
Capturar ese beneficio requiere un enrutamiento persistente consciente de prefijos: la gateway enruta solicitudes con un prefijo compartido a la misma instancia en lugar de distribuirlas mediante round-robin. La documentación de TrueFoundry describe exactamente esto: enrutamiento persistente que envía solicitudes con el mismo prefijo a la misma máquina GPU para aprovechar la optimización del KV-cache, el equivalente a nivel de GPU y autoalojado del almacenamiento en caché semántico a nivel de gateway de nuestro artículo sobre almacenamiento en caché. Uno reutiliza el cálculo dentro del motor de servicio; el otro reutiliza respuestas completas en la gateway. En cargas de trabajo conversacionales o con peticiones del sistema compartidas, ambos se potencian mutuamente.
Una vez que los modelos autoalojados y comerciales viven detrás de una sola API, el mecanismo de enrutamiento y fiabilidad de entregas anteriores de la serie se aplica a toda la flota a la vez. Puede enrutar una carga de trabajo soberana al modelo autoalojado por política, enviar el tráfico general a una API comercial y, de forma crucial, realizar una conmutación por error cruzando el límite: si la flota autoalojada se satura durante un pico, derivar a un modelo comercial en lugar de hacer cola, y si un proveedor sufre una caída, conmutar al modelo autoalojado.
Enrutamiento que trata lo autoalojado y lo comercial como una sola flota (ilustrativo)
Este es el enrutamiento y la conmutación por error de los artículos 11 y 12, abarcando ahora la unión entre lo comercial y lo autoalojado, con una restricción importante explicitada en la política: una ruta regulada no debe hacer una conmutación por error a un proveedor comercial, porque la disponibilidad nunca invalida a la soberanía. Codificar eso como una regla, en lugar de confiar en que todo el mundo lo recuerde, es el tipo de barrera de protección para la que existe la gateway.
El hilo conductor es que el autoalojamiento se divide claramente en dos tipos de trabajo. El tipo esencial —el motor de servicio y las GPU— es real, y el próximo artículo de esta pareja trata sobre su economía. El tipo accidental —una API diferente, enrutamiento separado, gobernanza separada, observabilidad separada— es lo que la gateway absorbe al ser la unión única entre sus aplicaciones y cada modelo, independientemente de dónde se ejecute.
Coloque la gateway ahí y un modelo autoalojado dejará de ser una plataforma paralela para convertirse en un punto de enlace gobernado más: misma API compatible con OpenAI, mismas reglas de enrutamiento y conmutación por error, mismo RBAC y presupuestos, mismas trazas. TrueFoundry está construido exactamente alrededor de esta división: servicio de alto rendimiento en vLLM, SGLang, TGI y TRT-LLM con la maquinaria de GPU y almacenamiento en caché para hacerlo operable, anteponiendo una AI Gateway que hace que el resultado sea indistinguible de un modelo comercial para todo lo que esté aguas arriba. Para Ravi, esa es la diferencia entre cumplir un requisito de soberanía y rediseñar su plataforma para lograrlo.
¿Es el autoalojamiento más barato que una API comercial?
A veces, a partir de un cierto umbral. Para un tráfico constante, de gran volumen y predecible, las GPU amortizadas (especialmente con uso compartido fraccionado y capacidad spot) pueden reducir el precio por token; para un tráfico con picos o de bajo volumen, una API comercial suele ser más barata porque no se paga por GPU inactivas. La respuesta honesta es modelar su propio volumen, que es el tema del artículo de economía de GPU que hace pareja con este. El coste es una de las cuatro razones para el autoalojamiento, no la única.
¿Tengo que reescribir mi aplicación para usar un modelo autoalojado?
No si el modelo está precedido por una gateway compatible con OpenAI. La aplicación sigue llamando a la misma API y solo cambia el nombre del modelo; la gateway resuelve ese nombre a su flota de GPU y aplica el mismo enrutamiento, RBAC y trazabilidad que para los modelos comerciales. El punto principal es que la aplicación no sabe ni le importa dónde se ejecuta el modelo.
¿Qué motor de servicio debo usar?
Haga pruebas de rendimiento para decidir: no hay un ganador universal. Los backends documentados (vLLM, SGLang, TRT-LLM, además de KServe y Triton) difieren en rendimiento, latencia, eficiencia de memoria y compatibilidad de funciones, y la elección correcta depende de su modelo, longitudes de secuencia y concurrencia. Ejecute su carga de trabajo real en las opciones candidatas y elija en función de las cifras medidas. Una plataforma que admita todos ellos le permite cambiar sin volver a diseñar la arquitectura.
¿Cuál es la parte operacional más difícil?
Los arranques en frío. Los pesos de los LLM son grandes, por lo que un escalador automático que vuelva a descargar el modelo por réplica es demasiado lento para seguir la demanda. El almacenamiento en caché de modelos, el streaming de imágenes y los volúmenes compartidos son lo que hace práctico el escalado: convierten un arranque en frío de varios minutos en algo lo suficientemente rápido para que el autoescalado basado en RPS y las políticas de inactividad con escalado a cero realmente funcionen.
¿Puedo mezclar modelos autoalojados y comerciales?
Ese es el estado final habitual y es el punto fuerte de anteponer una sola gateway a ambos. Enrute el tráfico soberano o de gran volumen a modelos autoalojados, el tráfico general a API comerciales y realice conmutaciones por error a través del límite bajo carga o caída del servicio (con la excepción explícita de que las rutas reguladas no deben conmutar a un proveedor comercial). Una flota, un conjunto de reglas, dos tipos de backend.
El problema de soberanía de Ravi nunca requirió una segunda plataforma; requería que un modelo se ejecutara en un lugar específico y que todo lo demás permaneciera igual. Eso es lo que le aporta una gateway: la libertad de colocar un modelo donde la soberanía, el coste, el control o la disponibilidad lo exijan, mientras la aplicación y la plataforma ven una superficie consistente. Asuma el servicio y las GPU (son el trabajo real) y deje que la gateway absorba el resto.
Ravi es un personaje ilustrativo. Las capacidades de servicio y gateway de TrueFoundry (motores de inferencia compatibles, almacenamiento en caché de modelos, streaming de imágenes, enrutamiento persistente consciente de prefijos y autoescalado) se resumen a partir de la documentación pública del producto a mediados de 2026 y evolucionarán; verifique los detalles específicos en la documentación actual. Las comparaciones de costes entre modelos autoalojados y comerciales dependen completamente de su propio volumen y hardware, y deben modelarse directamente. Los ejemplos de código y configuración son ilustrativos de los patrones documentados, no copiados de una implementación de referencia.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















